
Azure Synapse Analyticsのシステム開発は、全体を6段階に分けて進みます。要件整理から定着まで順に進めると、業務KPIの改善につながります。
開発の全体像は、完全ガイドの記事もご覧ください。
▼全体ガイドの記事
・Azure Synapse Analyticsのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analyticsのシステム開発の全体像
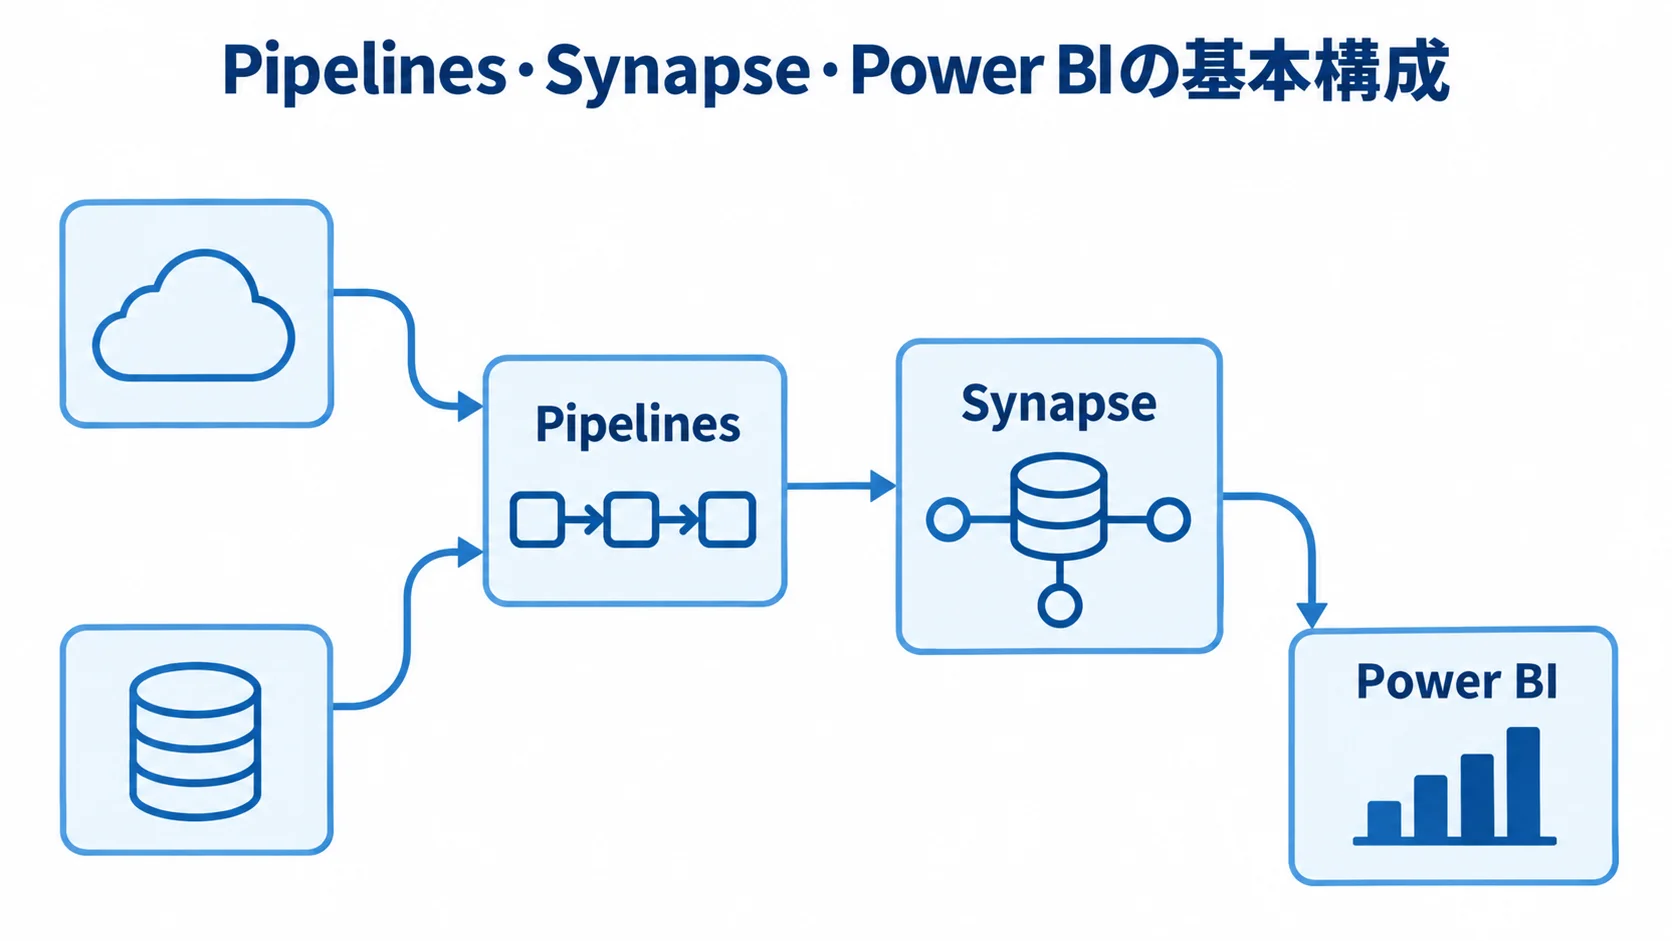
Azure Synapse Analyticsは、エンタープライズDWH向けのSQLを備えたAzureの分析サービスです(出典: Microsoft Learn「Azure Synapse Analyticsとは」、2026年8月確認)。Apache Spark、データ統合用のPipelines、Synapse Studioなどもまとめて扱えます。
開発の対象は、ワークスペースを含むデータ活用基盤全体です。データの入口と蓄積場所、変換ルールを含め、提供先、セキュリティ、監視も対象に入ります。
業務画面ではなくデータ活用基盤という位置づけ
Azure Synapse Analyticsは、受発注や在庫を登録する業務アプリケーションとは役割が異なります。
- データを整える:業務システムから取り込み、ADLS Gen2などへ蓄積する段階です。
- 分析用に加工する:名寄せやクレンジングを行い、データモデルに整えます。
- 利用先へ届ける:整えたデータを、Power BIやAPIなどの提供先へ届けます。
営業部門と経理部門で売上の定義が異なると、データをコピーしただけでは数字の不一致は解消されません。そのため、売上計上日や返品の扱い、顧客コードなどを先に決めておきます。また、「Synapseを導入する」ことが目的になると、機能の追加そのものがゴールになりがちです。
目的は、改善する意思決定と期限として書きます。たとえば、月次の経営会議で手作業の集計をなくす、在庫差異を翌日までに把握する、製造ラインの異常を担当者へ通知する、といった形です。
目的と利用者、データ鮮度は、セットで決めておきます。正確性と提供方法も一緒に決めると、構成と費用を比べやすくなります。
専用SQL・サーバーレスSQL・Sparkの目的別の使い分け
SQLプールやSparkの役割は、処理の目的と利用頻度に応じて決めます。
- 専用SQLプール:定型集計を多数へ安定提供し、性能を予測したい場合
- サーバーレスSQL:ParquetやCSVをコピーせず探索したい場合
- Spark:大量データの加工、ノートブック、機械学習、複雑な処理
サーバーレスSQLは予約したクラスターを持たず、クエリが処理したデータ量に応じて課金されます(出典: Microsoft Learn「Azure Synapse AnalyticsのサーバーレスSQLプール」、2026年8月確認)。
専用SQLとサーバーレスSQLは、併せて使うこともできます。PoCではADLS Gen2とサーバーレスSQLで構造と処理量を確かめ、利用頻度と性能が固まってから専用SQLや集計テーブルを追加します。
基本形は、Pipelinesで基幹DBやSaaSから取り込み、Synapseでモデル化して、Power BIで可視化する構成です。
Microsoft Learnによると、Pipelinesは90以上のデータソースからの取り込みに対応します。また、ノートブック、Sparkジョブ、SQLスクリプトもパイプラインから調整できます(出典: Microsoft Learn「Azure Synapse Analyticsとは」、2026年8月確認)。
Azure Synapse Analyticsのシステム開発の進め方
Azure Synapse Analyticsのシステム開発は、全体を6フェーズに分けて進みます。最初の要件整理、選定、設計・開発で方針を固め、そのあとのフェーズは下の見出しで順に見ていきます。
各段階で何を決めるか、次へ進む終了条件は何かを先に決めておくと、後工程の作り直しを抑えられます。分析基盤では、画面仕様より先にデータの意味と更新頻度を決めます。品質責任者や利用権限も、画面の設計より前に定めておきます。
1. 要件整理:目的・KPI・対象データの決定
業務目的とKPIは、最初に1〜2個へ絞ります。経営ダッシュボードでも、全指標を一度には完成させません。
売上や粗利、在庫回転などの候補から、意思決定を変える指標を選びます。受注残も候補に含めます。
- KPIの定義:計算式、基準日時、更新頻度、目標値、責任部門を決めます。
- データの洗い出し:対象と所有者、接続、主キーを押さえます。保存期間や品質、個人情報、移行範囲も一覧にします。
- 取り込み条件:抽出時間、差分キー、失敗時の再実行、削除・訂正の反映方法の4点です。
部署によって同じ用語の意味が違うときは、KPIの定義を用語集に記録しておきます。終了条件は、対象範囲と成功KPI、利用者が合意されていることです。データ分類、概算予算、PoCの合否基準も合意に含めます。
分析基盤では、利用部門と品質を直す部門を分けずに関わらせることが大切です。IT部門だけでは、顧客コードの統合や返品処理は判断できません。
会議体には、業務部門とデータ管理者を含めます。セキュリティ担当と運用担当も加えます。判断は、議事録とデータ辞書に残しておきます。
2. 選定:構成・データ配置・代替案の比較
構成は、要件に対して過不足がないかを基準に評価します。
- 専用SQL:毎朝の定型レポートと安定した応答
- サーバーレスSQL:利用頻度が読めない探索や小規模PoC
- Spark:複雑な加工や機械学習
リアルタイム性の高いログ分析や業務トランザクションでは、Azure Data ExplorerやAzure SQLも比較します。機械学習の運用では、DatabricksやMicrosoft Fabricも候補です。
Azure Data Factory、Power BI、Dataverseを利用中なら、既存資産を残す段階導入が可能です。Azure Machine LearningやEntra IDも、活用できる既存資産です。
新規DWHであれば、Fabricも選択肢に入ります。Microsoftの移行ガイドには、専用SQLプールからFabric Data Warehouseへの移行支援や、Spark・パイプラインの移行方法があります(出典: Microsoft Learn「Microsoft Fabric migration overview」、最終更新2026年4月、2026年8月確認)。
こうした情報は、SQLやデータモデル、パイプラインを再利用できる設計にするための判断材料です。Synapseを避ける理由として見るものではありません。
候補構成ごとに、実データで処理時間や処理量、費用を測ります。権限や障害時の再実行も、同じ条件で確かめます。
データ所在地や個人情報、接続を確認します。SLAや鮮度、同時利用者数も見ます。ピーク処理量、予算上限、監視担当も対象です。
パンフレットの性能値は参考にとどめ、代表クエリが基準を満たすかをPoCで確かめます。
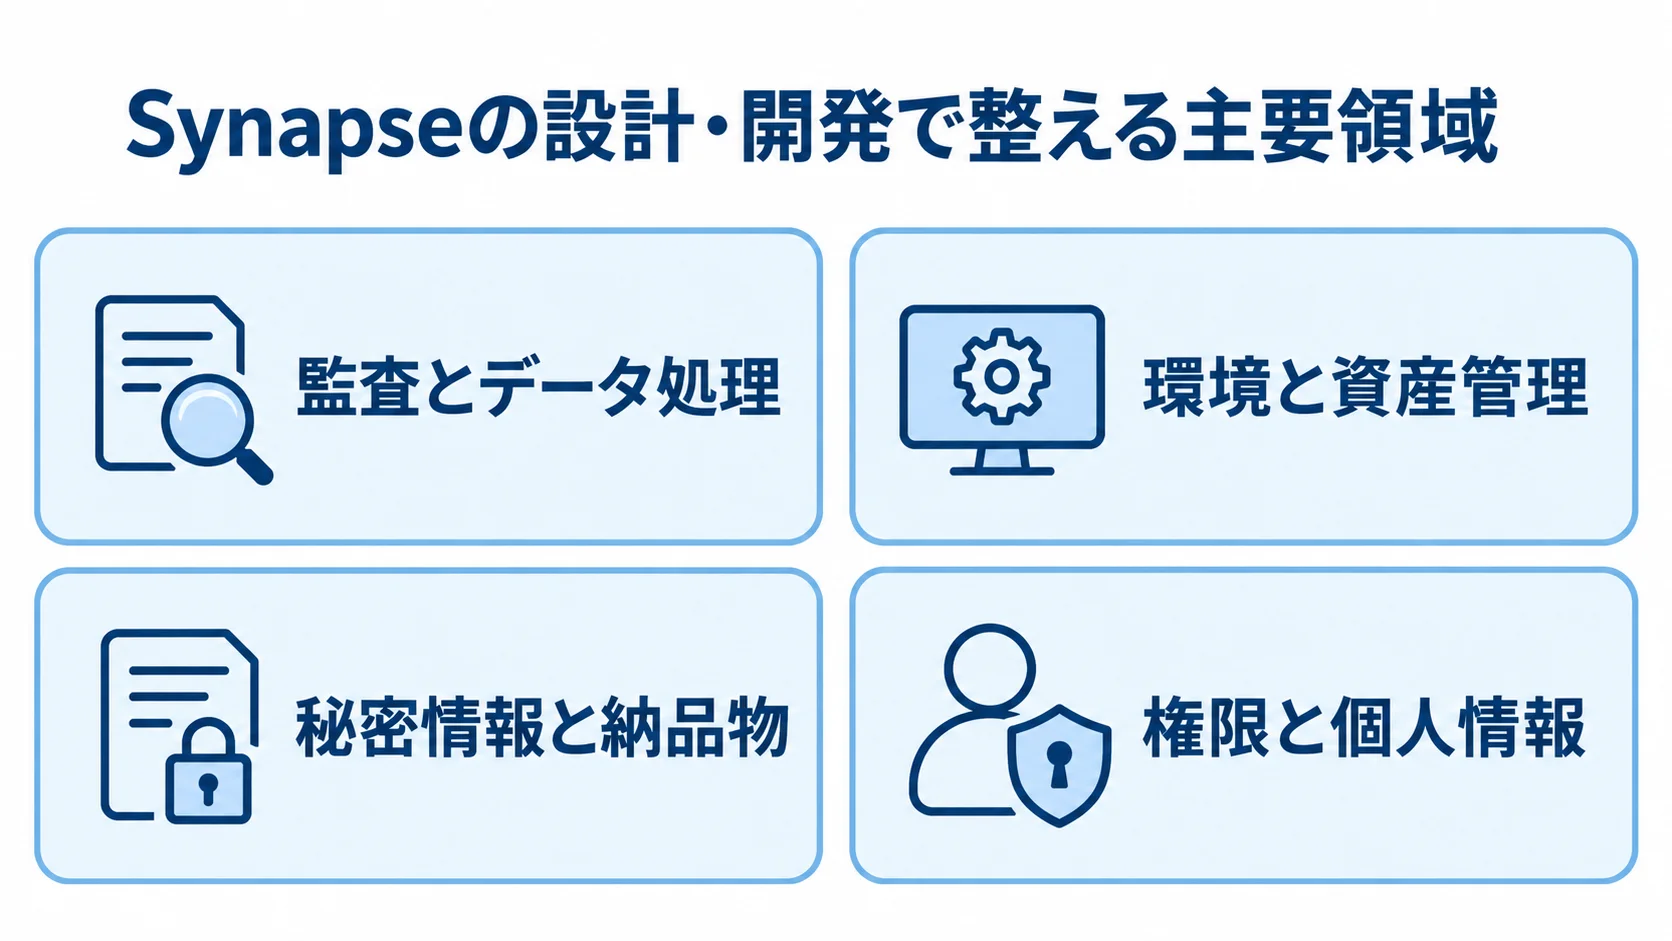
3. 設計・開発:データモデルと安全な実行基盤の作成
データレイクでは、RawやCleansed、Curatedなどの層を決めます。元データを残すかどうか、加工データをどの粒度で提供するかも定めておきます。
- 監査とデータ処理:記録項目とデータ処理のルールを設計します。
- 環境と資産管理:開発・検証・本番を分けたうえで、GitとCI/CDによりSQLや設定を管理する。
- 秘密情報と納品物:認証情報を安全に扱い、納品物は契約で定めます。
- 権限と個人情報:Entra IDやSynapse RBACの権限を整理し、個人情報の制御も要件に入れる。
外注時は、SQLやノートブック、パイプライン定義を納品物に明記します。IaCやデータ辞書、テスト結果、運用手順も、納品物として含めます。
監査項目には、取り込み日時や元システム、ファイル名を含めます。処理件数、エラー理由、再処理番号も残します。名寄せと履歴のほか、論理削除や遅延データも設計します。
パイプラインやノートブックも、管理対象に含めます。構成を再現するうえでは、BicepやTerraformなどのInfrastructure as Codeが役立ちます。
秘密情報は、コードやノートブックに直接書かず、Managed IdentityやKey Vaultで扱います。接続先は、環境別の安全な変数で切り替えます。
Microsoft Entra IDのグループを基に、役割を分けます。管理者、データエンジニア、開発者、分析者、閲覧者などが対象です。
Synapse RBAC、SQL権限、ADLSのアクセス制御を重ねる場合は、誰がどの層を読めるかを一覧にしたうえで、過剰権限をなくします。
個人情報がある場合は、列や行の制御、マスキング、監査ログを非機能要件に含めます。保存期間や削除手順も、同じ要件に入れます。
機密性が高い場合は、Private LinkやManaged Virtual Networkを検討します。なお、ワークスペース作成時には、専用SQLとサーバーレスSQL向けのマネージドプライベートエンドポイントが作成されます。エンドポイント自体には課金されません(出典: Microsoft Learn「マネージドプライベートエンドポイント」、2026年8月確認)。
4. テスト:受入条件によるデータ品質・性能・権限の確認
パイプラインが正常に終わるだけでなく、業務部門が正しいと判断できる品質基準を設定します。
- データ品質:件数、合計金額、重複、欠損、日付、文字コード、タイムゾーン、更新遅延
- 性能と費用:通常時・ピーク時の処理時間、データ量、失敗率、処理量
- セキュリティ:役割別の閲覧範囲、接続、監査ログ、権限の解除
元システムとCurated層の集計値を比べ、差があれば仕様差、取り込み漏れ、名寄せ誤りを切り分けます。
性能テストでは、通常時と月末・締め日などのピーク時を分けて測ります。測定時は、利用者数や同時実行クエリ、データ量を記録します。処理時間、失敗率、処理量も併せて残します。
専用SQLのサイズやファイル形式を見直します。パーティションとクエリの書き方も対象です。
サーバーレスSQLで必要列とパーティションだけを読まないと、処理量が増えます。費用テストも、性能テストと同時に行います。
退職者や異動者の権限解除を確かめます。Private Link接続と監査ログの取得も、確認項目に入ります。
移行時は、全量移行の前にサンプル移行とリハーサルを行います。失敗時に戻せる手順も、実際に実行します。
重大なデータ欠陥がなく、担当者が復旧でき、利用部門が受入条件に合意したら、リリースを判定します。
5. 稼働:計画どおりの切り替えと監視
稼働前にカットオーバー計画を作ります。担当者と所要時間を決め、作業を時系列に並べます。
- データの抽出と最終取り込み
- 件数の照合と権限の反映
- Power BIの接続先の変更と利用者への告知
- 監視の開始と判定会議
業務停止が難しいときは、段階稼働や並行稼働を検討します。旧基盤をいつまで参照できるかも、あわせて決めておきます。
本番では、Pipelinesの失敗、取り込み遅延、処理件数を監視します。品質エラーやSQL稼働、Sparkジョブ、ストレージ、予算超過も対象です。
障害時の対応では、誰が何分以内に確認するかを決めておきます。再実行や原因調査、利用者への通知、エスカレーションも、担当を含めて決めます。
障害対応は記録に残し、同じ失敗を防ぐためにパイプラインや品質ルールに反映します。
専用SQLを夜間や休日に停止できるかを決めます。サーバーレスSQLには、処理量の上限や予算アラートを置くかも決めます。Sparkの自動停止も、運用手順に含めます。
予約容量を1年または3年契約で購入すると、データウェアハウスの計算料金を従量課金と比べて最大65%節約できる場合があります。ただし、節約幅は利用状況と契約条件で変わり、ストレージやネットワーク費用までなくなるわけではありません(出典: Microsoft Azure「Azure Synapse Analyticsの価格」、2026年8月確認)。
6. 定着:利用率と業務成果の測定と展開
稼働後は月次で成果を測り、利用状況と運用方法を見直します。
- 業務成果:意思決定や集計時間、品質エラー、レポート更新遅延の変化を測る。
- 利用状況:閲覧回数のほか、会議で使う指標や改善件数、問い合わせから活用度を確かめます。
- 利用者支援:指標の定義や更新時刻、問い合わせ先、誤りの連絡方法の周知。
- 社内育成:SQLやモデル、再実行、権限申請、費用確認の演習。
- 外部委託:月次レビューと設計書更新を契約に含めます。
Microsoftのクラレ事例では、Azure Data FactoryからADLS Gen2へ集約し、名寄せ後にSynapseのモデルへ統合しています。その基盤は、Power BIで約700名が利用しています。
PoCでは、開発リードタイムやアクセス制御、データカタログを評価しました。多様なデータソースも、評価の対象でした。
その結果、段階展開と内製化にもつなげています(出典: Microsoft Customer Stories「Azure Synapse AnalyticsとPower BIでデータ活用基盤を確立」、2024年3月、2026年8月確認)。
自社でも、一つのKPIを使える状態にしてから部門を広げると、利用定着と費用対効果を確かめやすくなります。
Azure Synapse Analyticsのシステム開発費用相場
国内案件を横断したAzure Synapse Analytics受託開発費の公的な相場統計は確認できません。
次の金額は、リサーチノートにある業務システムの一般的な費用情報をもとにしています。Synapse、ADLS Gen2、Pipelines、Power BIの構成から作った、2025〜2026年時点の企画用レンジです。
企画用のレンジであり、データ量や接続先、性能によって金額は変わります。移行や権限、運用時間でも変わります。
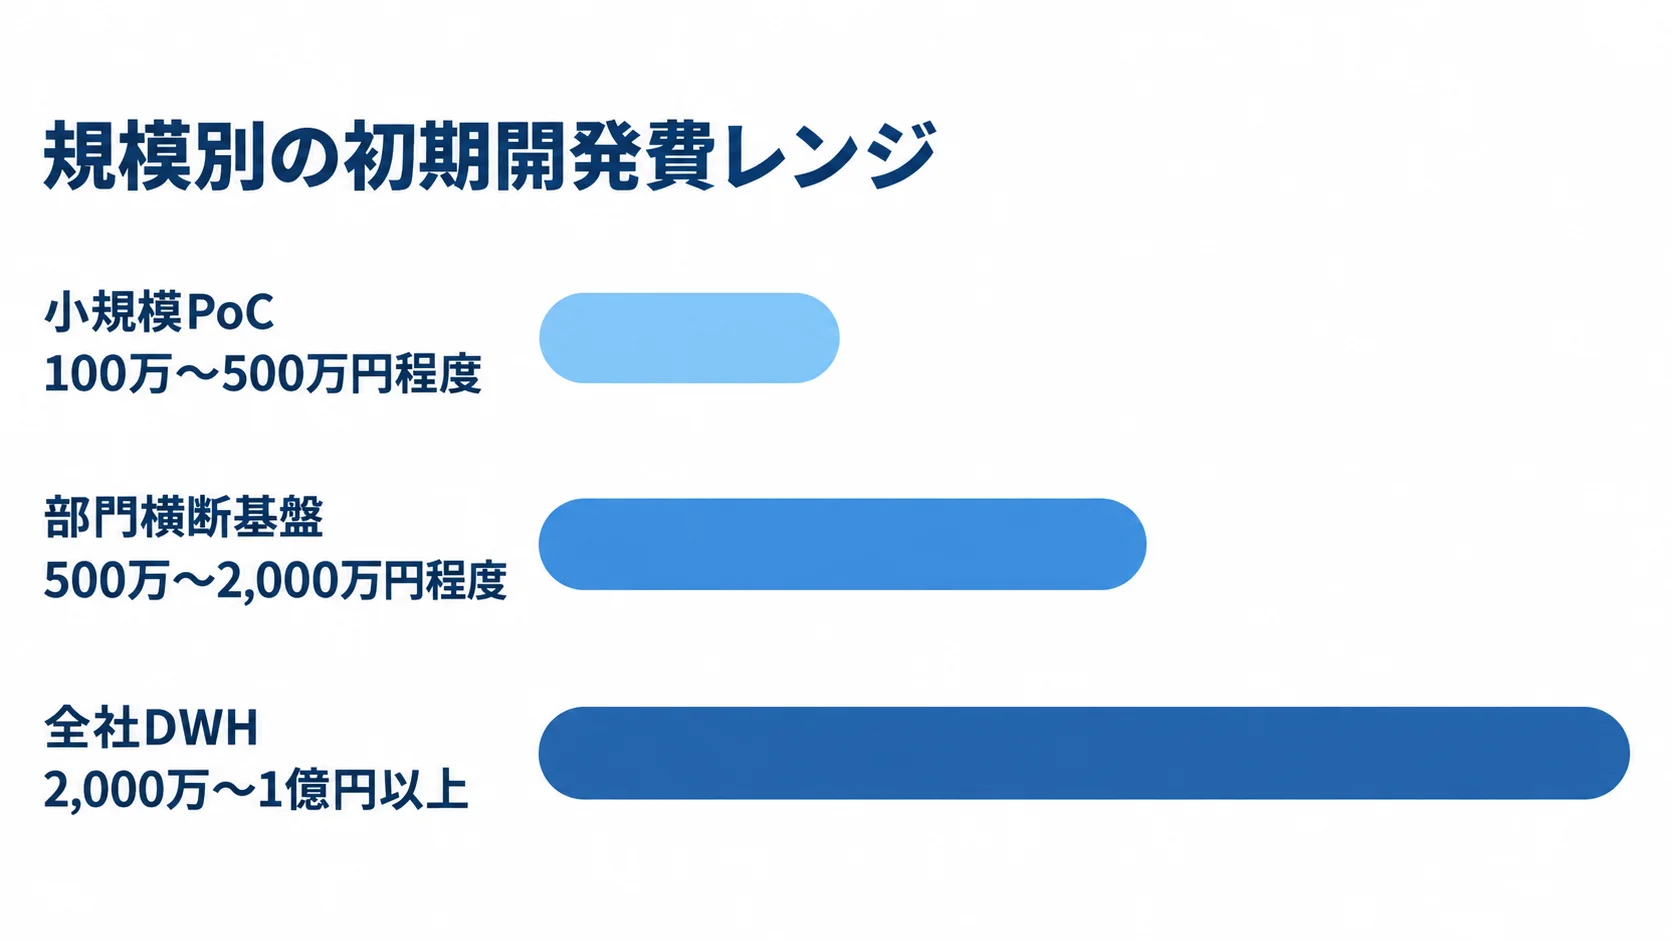
初期開発費の目安(PoCは100万〜500万円程度)
企画段階では、小規模PoCで処理時間や品質、権限、月間のAzure利用量を測ります。
- 小規模PoC:100万〜500万円程度。データソース1〜3個、ADLS Gen2、サーバーレスSQL、少数のPower BIレポートが対象です。
- 部門横断基盤:500万〜2,000万円程度が目安です。
- 全社DWH:複数の基幹システム、ERP、CRM、生産データをつなぐ場合、2,000万〜1億円以上が目安です。
全社ネットワークや個人情報の匿名化を含む場合、小規模PoCのレンジだけでは判断できません。既存DWHの全量移行や複雑な名寄せがあれば、さらに条件が増えます。
高度なリアルタイム処理や複数リージョン、厳格なSLAを組み合わせると、1億円を超える可能性もあります。機械学習や大規模移行を重ねた場合も、同様に高額になる可能性があります。
類似案件から推定した一般的なレンジで、Synapse単体のライセンス価格ではありません(出典: NotebookLM Q&A「業務システム全般_17」から抽出した業務システム費用の整理、2026年)。
Azure利用料:リソースごとの従量課金の切り分け
Azure利用料は、リソースごとに分けて見積もります。開発会社への初期費用と混ぜないようにします。
- 計算・処理:専用SQLの計算資源と稼働時間、サーバーレスSQLの処理量、Sparkのノード時間
- データ・連携:ADLS Gen2の保存量、Pipelinesの処理やデータ移動
- 周辺費用:Power BI、Private Link、バックアップ、ネットワーク転送
利用量が増えた原因を追えるように、見積書では初期開発費とAzure利用料を分けます。保守運用費とライセンス費も、別に示します。
Azure利用料は、小規模PoCで月1万〜30万円程度、部門横断基盤で月10万〜100万円程度、全社基盤で月50万〜500万円程度を仮置きできます。
これは構成別の推定レンジで、特定の契約やリージョンの料金を保証しません。データ量や実行回数、稼働時間で変わります。同時利用や為替、契約割引でも変わります。
Azure Pricing Calculatorに前提を入れ、通常月、繁忙月、データ増加後の3ケースで確認します。
保守運用費の目安:初期開発費の年15〜25%程度
リサーチノートにある業務システムの一般的な目安では、保守費は初期開発費の年15〜25%程度です。
- 日常保守:パイプライン失敗、品質エラー、権限追加、軽微なSQL・モデル変更
- 運用支援:監視、コスト確認、Azure仕様変更への対応
- 追加範囲:24時間365日監視、SLA、月次データ追加、Power BI改修、請求代行、セキュリティ監査
費用は、含める作業によって変わります。定額範囲と追加見積もりの作業を、契約前に分けておきます。
目的を絞ったPoCで実データとクエリを測ると、費用を抑えやすくなります。最初から大きな専用SQLや複雑なSpark基盤は用意しません。
さらに、サーバーレスSQLで探索し、Parquet化やパーティションを施します。安定した性能が必要な処理だけを専用SQLへ移す方法も候補です。
将来の利用者やデータ量、再処理のしやすさ、運用担当者の負担を含めて比べます。
Azure Synapse Analyticsの見積もりを取る際のポイント
見積もりは、同じ前提でそろえ、初期費用と運用費を分けて比べます。ワークスペースの構築費は、その一部にすぎません。
データソース数や品質、更新頻度、保持期間を確認します。利用者や権限、移行、BIも対象です。ネットワークや監視、教育、成果物も見ます。
金額の安さだけでなく、後から追加費用になる作業が明記されているかを見ます。
RFPに書く項目:データ量・更新頻度・受入条件
RFPには、対象データの条件と接続方法を具体的に記載します。
- データ量:種類・件数、1日または1か月の増加量、保持年数
- 利用条件:更新頻度、許容遅延、利用者数、同時利用者数、レポート数
- 接続・移行:SQL Server、SAP、Salesforce、ファイル、API、IoTなどの方式と差分抽出の可否
- 受信条件:削除・訂正の受信とテストデータ提供の可否
- 非機能要件:復旧時間・時点、稼働・通知時間、ログ保存、ネットワーク、所在地、マスキング、承認者、上限
受入条件は、測定できる形で書きます。例として、毎日午前8時までに前日データが反映され、売上合計が元システムと許容差の範囲で一致する状態などが挙げられます。
開発会社の選び方:Azureだけでなく業務・データ・運用の実績
候補会社については、業務・データ・運用の実績を、案件内容と提案の両面から見ます。
- 対応経験:Azure、データモデリング、名寄せ、Power BI、権限、監視、FinOps、内製化支援
- 類似案件:データソース数・量、利用者数、更新頻度、PoC期間、運用、障害対応、納品物
- 技術選定:専用SQL、サーバーレスSQL、Spark、Fabric、Databricksの採用理由
- PoC条件:検証項目、データ持ち出し、性能測定、利用料の根拠、データ増加への対応
Microsoftの公式パートナー掲載は、候補を探す際の材料になります。ただし、掲載だけで品質や価格が保証されるわけではありません。
担当者と実績の範囲は、会社ごとに個別に確認します。複数案の差分と採用理由を説明できる会社なら、長期の判断をしやすくなります。
契約での成果物・改修権・Azure費用の責任分界
受託開発では、支払いをしても全資産を自由に改修できるとは限りません。契約で権利と責任を明確にします。
- 納品物:SQL、Spark、Pipelines、IaC、モデル、テスト、手順、監視、ダッシュボード、API仕様
- 権利条件:利用許諾、改修、再委託、契約終了時の引き渡し
- 責任分界:開発会社、Azureの提供元、自社の責任範囲
- 追加費用:追加作業が定額保守に含まれるか、追加見積もりになるかを契約で定める
データ仕様やレポートの追加、過去データの再加工は、定額保守に含めるか追加見積もりにするかを決めます。法改正やセキュリティ要件の変更も、同じ扱いの対象です。
一方で、自社はデータ品質の確認と権限申請を担います。Azure利用料の契約者や、予算超過時の通知担当、障害時の連絡先も決めておきます。
テンプレートや第三者ライブラリの権利関係は、法務と確かめます。
見積もりは、同じ期間と範囲でそろえて比べます。要件定義や移行、テストは別料金になる場合があります。教育や監視、最適化も、別料金になる場合があります。
月額にAzure利用料を含むのか、保守人件費だけなのかを確かめます。通常月と繁忙月は、分けて考えます。
前提条件がない見積もりは、金額が低くても比較材料として不十分です。
よくある質問(FAQ)
導入前の疑問に、費用と進め方の前提を含めて答えます。選択は、データ量のほか頻度や性能も踏まえて行います。品質や権限、運用体制も判断材料です。
Azure Synapse Analyticsのシステム開発は何か月かかりますか?
企画上の目安は、小規模PoCで1〜3か月、部門横断の実用基盤で3〜6か月です。
複数の基幹システムを含む全社DWHは、6〜18か月程度です。品質修正や名寄せ、既存DWH移行が増えると、期間は延びます。ネットワークや個人情報の要件が加わると、さらに延びます。
一つのKPIでPoCを行い、その結果から本番範囲を決めると、計画を立てやすくなります。
専用SQLプールとサーバーレスSQLはどちらを選べばよいですか?
定型集計を予測可能な性能で継続提供するなら、専用SQLプールが候補です。
データレイク探索や不定期クエリ、PoCには、サーバーレスSQLが候補です。処理したデータ量に応じて課金されます。
高頻度処理や全量スキャンの場合は、専用SQLや集計テーブル、ファイル最適化と比べます。実データで時間と費用を測り、そのうえで決めます。
2026年時点でAzure Synapse Analyticsを選んでも問題ありませんか?
Synapseは、既存Azure環境でSQL、Spark、Pipelines、Power BIを組み合わせられる分析基盤です。
Microsoftは、Fabric Data WarehouseやSynapseからFabricへの移行方法も案内しています。新規案件では、Fabricと比べたうえで、将来の移行可能性を設計に含めます。
プレビュー機能に本番を依存させず、管理可能な資産を残します。資産には、データモデルやSQL、パイプライン、ノートブックを含めます。
データ品質は開発会社へ任せられますか?
技術的な品質チェックやパイプライン実装は、委託できます。一方で、売上や顧客の定義、名寄せ、例外処理の業務判断は社内で担います。
社内でデータ所有者と品質責任者を決めたうえで、開発会社と辞書や受入基準、エラー対応を合意します。
契約には、品質確認や検証データ提供、修正回数を記載します。追加データの扱いも、あわせて書いておきます。
Azure Synapse Analyticsの開発会社は何を基準に選べばよいですか?
Azure構築だけでなく、業務要件やデータモデル、名寄せを確認します。Power BI、セキュリティ、運用、FinOps、内製化までを確認範囲に含めます。
類似案件のデータソース数や利用者数、PoC項目を確かめます。担当者の経験や成果物、保守範囲、利用料の試算根拠も見ます。
要件に沿ってSynapse、Fabric、Databricksを比べ、追加費用や不利な前提も説明できる会社が望ましいです。
まとめ
6フェーズを通じて、KPIに基づく分析基盤を作り、現場で使われる状態へ定着させます。最初に業務KPIとデータの意味を決め、専用SQL、サーバーレスSQL、Sparkを目的に応じて選びます。
ADLS Gen2やPipelines、Power BIを、Entra IDや監視まで含めて一つの基盤として設計します。目的は、正しいデータを必要な人へ安全に届け、意思決定を改善することです。Synapseの導入そのものは、その手段にすぎません。
一つのKPIと実データによるPoCの開始
PoCの費用やAzure利用料を見積もるときは、開発規模と費用の前提を分けて整理します。
- 小規模PoC・部門横断基盤:費用の目安は小規模PoCで100万〜500万円程度、部門横断基盤で500万〜2,000万円程度です。
- 全社DWH:費用の目安は2,000万〜1億円以上です。
- Azure利用料:専用SQL、サーバーレスSQL、Spark、ストレージ、Pipelines、ネットワークなどの利用量で変わります。
- 見積もり条件:初期開発費、クラウド費用、保守費を分け、データ量、更新頻度、稼働時間、利用者、セキュリティ、移行範囲、運用時間を記載します。
PoCの合否基準と将来の移行可能性(RFPへの記載)
最初に、改善する業務判断と対象データ、更新期限を定めます。利用者と品質基準も、あわせて定めます。
- 実データで検証する:処理時間、品質、権限、費用を測って構成を決めます。
- 委託先を見極める:業務理解やモデリング、運用、内製化、成果物の引き渡しを確認します。
- 将来に備える:Fabricなども踏まえ、モデル、SQL、パイプラインを再利用できる形で管理します。
▼全体ガイドの記事
・Azure Synapse Analyticsのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。