
Datadogの導入は、要件整理から始まります。機能と支援会社の選定を経て、設計・テスト、段階稼働と進み、月次改善で運用に定着しやすくなります。
各フェーズで決めることや、費用と見積もりの確認点も、順に説明します。全体像は、完全ガイドもご覧ください。
▼全体ガイドの記事
・Datadogのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Datadogのシステムの全体像
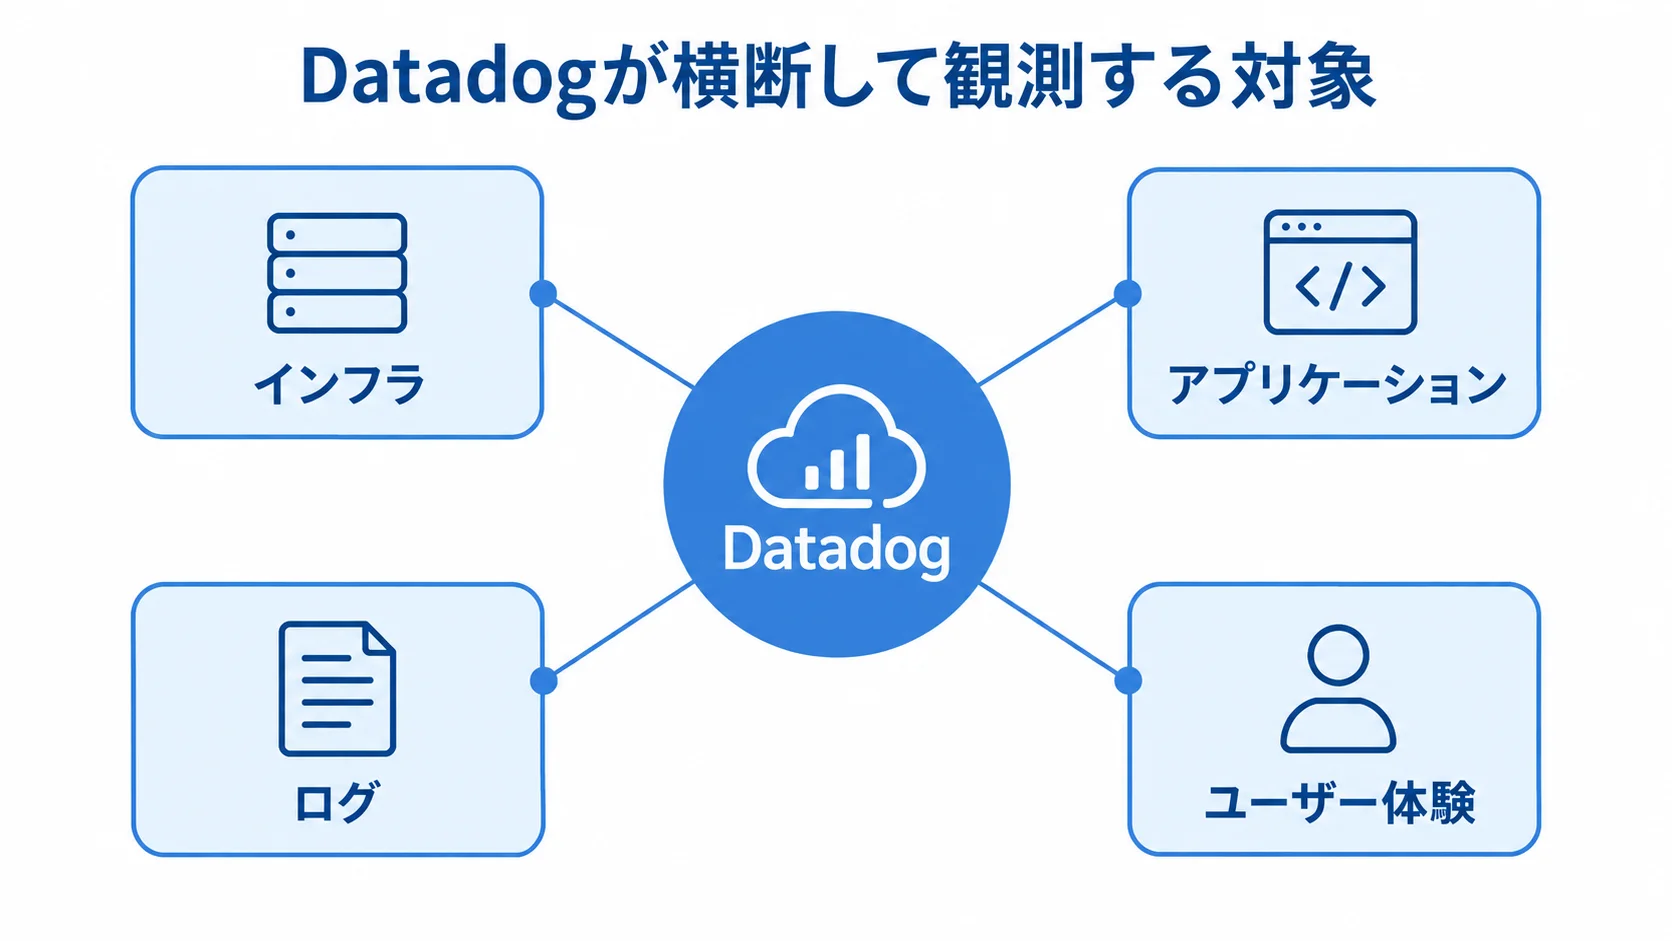
Datadogは、インフラ、アプリケーション、ログを横断して観測するSaaS型のプラットフォームです。観測の対象には、ユーザー体験、データベース、ネットワークのほか、セキュリティも含まれます。
監視画面を並べて見るだけでなく、障害に関係するメトリクス、ログ、トレースを関連付けて、検知から原因調査、通知、復旧までを一続きにつなげられる点が特徴です。
監視ツールではなく可観測性の基盤
従来の監視は、CPU使用率や死活状態など、あらかじめ決めた項目を確かめるのが中心でした。
一方で、Datadogでは注文APIのエラー率が上がったとき、関連サービスやDB遅延、トレース、直前のリリースをたどれます。開発やインフラ、SREの担当者と事業部門が同じ事実を見て、優先順位を決められる点が導入効果です。
- 監視対象:すべてを監視せず、停止許容時間、検知対象、利用者への影響、対応担当者から決める。
- データ範囲:必要なデータから始めて、段階的に広げる。
- タグ:サービス名、環境、バージョン、チームを軸に、業務機能も含めて標準化する。
タグを先にそろえておけば、後からダッシュボードやアラートを展開しやすくなります。
Agent・SDK・OpenTelemetryによるデータ収集
収集対象は、対象ごとに分けて決めます。使う仕組みが対象によって変わるためです。
- インフラ:ホストやKubernetesノードのDatadog Agentが、メトリクス、ログ、プロセス情報を送る。
- アプリ・利用者:APMライブラリやSDKで経路とエラーを追い、ブラウザ操作にはRUM、外部応答にはSynthetic Monitoringを使います。
- OpenTelemetry:既存アプリの改修を抑えたい場合や、別の分析基盤にも送る場合に併用します。
- 送信方式:用途に応じて選ぶ。
公式ドキュメントでは、Agentに組み込まれたDDOT Collectorと、アプリからAgentへOTLPで送る方式が案内されています。
Kubernetesで複数の送信先や高度な処理を使う場合はDDOT Collectorを、Datadogへシンプルに送る場合はOTLP Ingestを選びます。出典は、Datadog公式OpenTelemetryドキュメント(2026年)です。
Datadogのシステム開発・導入の進め方
Datadog導入は、6つのフェーズに分けて進めると、抜け漏れを管理しやすくなります。
各フェーズでは成果物と合格条件を決め、次の工程へ進む前に関係者の認識をそろえます。運用手順と改善担当者も、設計の段階から含めます。
フェーズ1:要件整理・企画と監視目的の決定
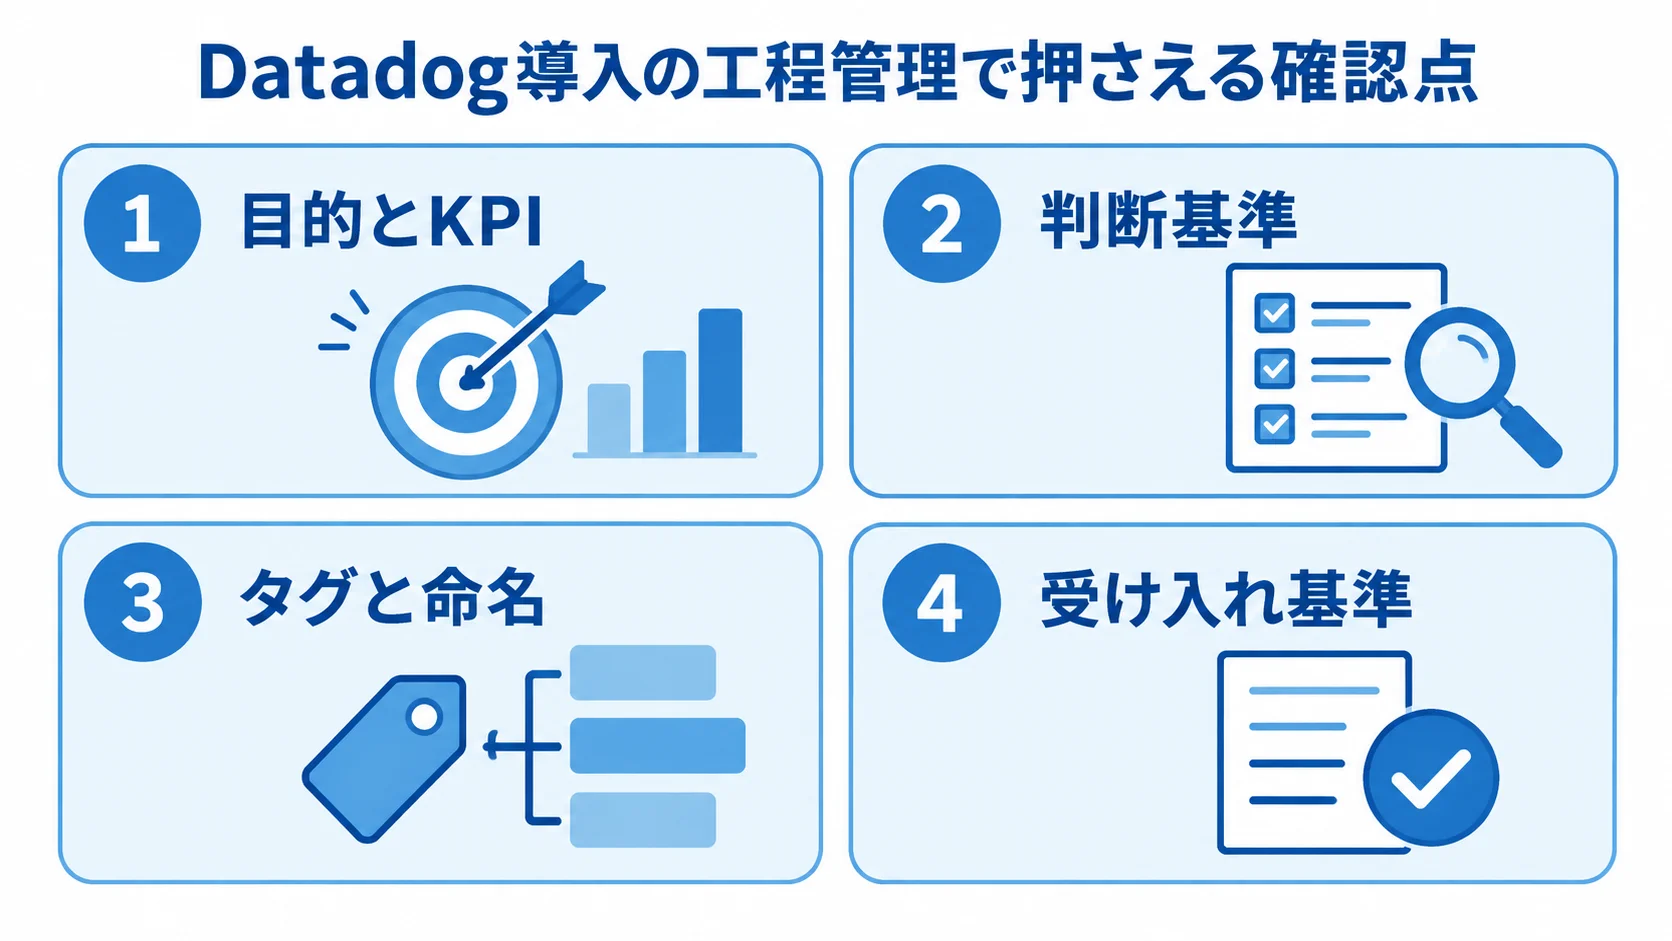
要件整理では、まず現状を洗い出し、そのうえで監視目的とKPI、対象範囲、運用条件を決めます。
- 現状把握:構成や利用者、業務上の重要度、障害履歴、既存監視、開発・運用体制を確認します。
- 目的とKPI:検知を早めたい障害と、原因特定に時間がかかる障害、利用者が気づく品質問題を分けて捉える。
- 指標:MTTD、MTTR、可用性、エラー率、レイテンシー、SLO違反件数、対応が必要だったアラートの割合を定めます。
- 対象範囲:クラウドとオンプレミス、ホスト・コンテナ・サービス数、APM対象、1日あたりのログ量、保持日数。
- 運用条件:個人情報の扱い、通知先、オンコール時間、権限、監査要件、SLO、既存ツールとの役割分担。
全ログの永久保存や全チームへの一律通知は、費用やアラート疲れにつながります。そのため、目的と代替案を確かめておきます。
フェーズ2:Datadogの機能と支援会社の選定
機能の選定では、監視目的に応じて、Datadogの機能と既存ツールの役割を分けます。
- Datadog機能:必要な監視機能を要件に合わせて選ぶ。
- 既存ツール:CloudWatch、Prometheus、Grafana、Splunkを全面移行せず、役割を分けて段階連携する方法もある。
- 判断基準:障害対応が短くなるか、データ重複が減るか、担当者が継続して運用できるか。
- 支援会社:販売代理店かどうかだけでなく、対応範囲(監視設計、アプリ計装、IaC、SRE、セキュリティ、24時間運用)を比べます。
候補には、Infrastructure Monitoring、APM、Log Management、Database Monitoringがあります。さらに、RUM、Synthetic Monitoring、セキュリティ監視も候補に入ります。
Datadog Japanの2026年Partner Awardでは、NTTデータとキンドリルジャパンが表彰されました。また、エーピーコミュニケーションズやクラスメソッドなども部門別に表彰されています(出典: Datadog Japan Partner Award 2026、2026年)。
受賞は、候補を絞り込む材料になります。ただし、同じクラウド・業界・規模での実績や、PoC後の設定引き渡し条件も、あわせて確認します。
フェーズ3:タグ・収集・通知の設計と開発
タグと収集、設定管理、通知を設計し、開発環境で検証してから本番へ展開します。
- タグと命名:
env、service、version、担当チーム、業務機能、リージョンをそろえます。 - 収集設定:環境を分け、Agent・SDK配置、ログ収集元、APMサンプリング、機密情報のマスキング、保存先と保持期間を決めます。
- コード管理:TerraformやAPIでモニター、ダッシュボード、SLO、通知ルールを管理し、レビューできる状態にする。
- 通知連携:緊急度や営業時間、担当サービス、一次対応者、エスカレーション先ごとに通知を分け、チケット、Slack、PagerDuty、CI/CDと連携する。
開発、ステージング、本番を混同しないようにします。タグは後から付け替えにくいため、ダッシュボードより先に決めておきます。連携後は、アラートから対応記録まで追跡できます。
フェーズ4:障害を想定したテスト
監視テストでは、データが表示されるかを確かめるだけでなく、実際に起こり得る障害を安全な環境で発生させます。
- インフラ障害:CPU高騰、ディスク枯渇、Pod再起動、証明書の期限切れ
- アプリ障害:アプリケーションエラー、データベース遅延、外部APIタイムアウト
テストでは、検知までの時間、通知先と内容、ダッシュボードから原因をたどれるか、一次対応者が手順書だけで復旧できるかを確かめます。
受け入れ基準は、重要な障害を定めた時間内に検知し、担当者が原因候補と影響範囲を把握できることです。誤検知が出たときは、閾値、評価期間、除外条件、通知レベルを調整します。
JCBの事例では、自動検知とAPMの詳細情報の取得によって初動対応が改善し、MTTDの短縮につながっています(出典: Datadog公式JCB導入事例、確認年2026年)。
導入テストで同じ確認を行えば、可視化を業務成果に結び付けられます。
フェーズ5:稼働と引き継ぎ
本番稼働は重要なサービスから段階的に広げ、必要な成果物と役割を引き継ぎます。
- 初回稼働:インフラメトリクス、主要ログ、APM、重大アラートに絞る。
- 段階拡張:問題がなければ、DB監視、RUM、セキュリティ監視、周辺サービスへと広げます。
- 成果物:管理者アカウント、権限表、タグ・モニター一覧、ダッシュボード、Terraformリポジトリ、ログマスキングルールを受け取ります。
- 運用引き継ぎ:障害対応手順、連絡網、費用確認手順を受け取る。
展開の前後で、エラー率、レイテンシー、通知件数、ログ量、利用料を比べます。特に、開発会社のアカウントや属人的な設定が残ると、契約後に変更できません。
誰がモニターを承認し、アラートを閉じ、月次費用を確認するかは、RACIのような役割表に書き出しておきます。
フェーズ6:月次レビューによる運用の定着
稼働後も月次で効果と利用状況を確認し、設定や標準手順を更新します。
- 効果指標:最初の1〜3か月は、対応が必要だったアラートの割合、ノイズの多いモニター、MTTD、MTTRを見ます。
- 運用状況:SLO違反、障害の再発、ログ量、カスタムメトリクス数、月額利用料。
- ログ調整:収集し過ぎている場合は、収集対象、サンプリング、インデックス、保持期間を見直す。
- 標準化:新サービスのテンプレートに、タグ、APM、ログ形式、SLO、ダッシュボード、アラート、Terraformを組み込む。
通知が増えても対応が速くならない場合は、閾値や担当範囲を見直します。また、リリース条件に監視設定と運用手順のレビューを加えると、後付けの対応を減らせます。
改善は、月次のFinOps、四半期ごとの権限・保持期間レビュー、障害後のポストモーテムで行います。
Datadogのシステム開発・導入費用の相場
Datadogの費用は四つに分けて見ます。まず、利用料とクラウド・ネットワーク関連費です。そのほかに、初期設計・連携・移行費と、教育・保守運用費があります。
利用料は、ホスト数だけでなく、APM対象ホスト、ログ量とインデックス保持、コンテナ、カスタムメトリクス、DB監視によっても変わります。そのため、「1台いくら」だけで予算を組むと、稼働後に差額が出やすくなります。
公式料金表から見るライセンス利用料の目安
利用料を見積もるときは、ホスト課金と機能別単価に加えて、ログの保持条件も確かめます。
- Infrastructure Pro:年額請求は1ホストあたり月額18.75ドル、月額請求・オンデマンドは22.50ドルです。
- APM:年額38.75ドル、月額45ドルです。
- Database Monitoring:年額87.50ドル、月額105ドルです。
- ログ:取り込みは1GBあたり0.13ドルです。インデックス済みログは、保持期間などで単価が変わります。
Datadog公式料金表には単価が掲載されています(2026年8月確認)。
1ドル=150円とし、割引、為替、税、従量利用を含めない試算では、Infrastructure Proのみ10ホストで月額約2.8万〜3.4万円です。10ホストにAPMを加えると、月額約8.6万〜10.1万円です。
APMなどを組み合わせた例では、30ホストで月額約28万円前後、100ホストで月額約86万円前後です。
これらは構成を限定した試算です。ログ、RUM、セキュリティ、長期保持などを追加すれば、上振れします。
設計・連携・運用支援の導入費用相場
国内のDatadog導入支援費を網羅した公的統計は確認できないため、ここでの数値は、一般的な開発工数と作業範囲からの推定です。
参考相場は、中小開発会社が人月80万〜120万円、大手SIerが150万〜200万円程度です。Datadog契約料とは別です。
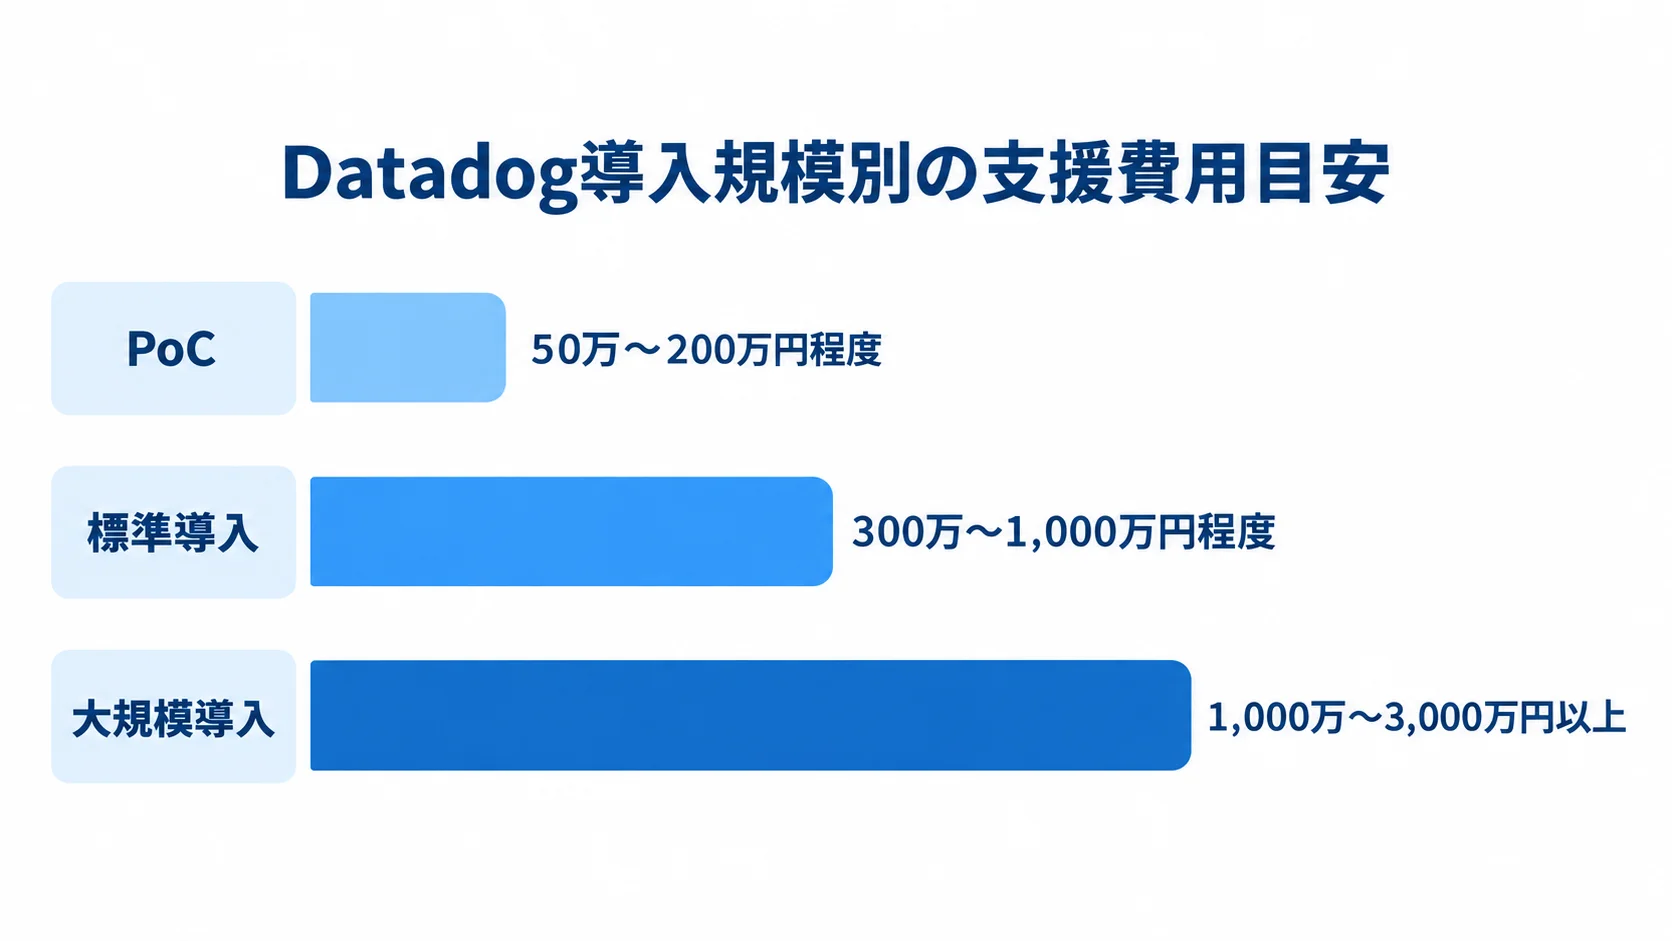
費用と期間の目安は、導入規模によって変わります。
- PoC:数サービスのAgent、基本ダッシュボード、主要アラート、費用計測で50万〜200万円程度、2〜6週間が目安です。
- 標準導入:300万〜1,000万円程度、期間は2〜4か月が推定レンジです。
- 大規模導入:1,000万〜3,000万円以上、期間は4〜9か月になる可能性があります。
標準導入には、クラウド、Kubernetes、APM、ログの設計が含まれます。さらに、SLO、通知、Terraform、運用手順、教育も含みます。
大規模導入は、マルチクラウド、オンプレミス、複数事業部にまたがる場合を指します。加えて、厳格な監査、既存監視の移行、24時間運用を伴う場合も含みます。
費用を抑えるには、重要サービス1〜3個でPoCを行い、検知・原因特定の時間、アラート件数、ログ量、月額利用料を測ります。そのうえで、PoCの基準値があれば、本番展開時に不要な機能や過剰なログ保持を削る材料になります。
保守費は初期導入費の年15〜25%程度を目安とする一般論もあります。ただし、実際の額は、レビュー、アラート調整、障害対応、機能追加の範囲によって変わります。
契約書では、どの作業項目が含まれるかを分けて確かめます。
Datadogの見積もりを取る際のポイント
見積もりは、作業範囲をそろえたうえで金額を比べます。そのため、同じ前提をRFPに記し、費用項目を分けて提案を求めます。
費用は、Datadog利用料やクラウド費、初期導入費に加えて、移行費、教育費、保守費を分けて示してもらいます。さらに、ログ量と保持期間、APM対象、カスタムメトリクス、コンテナ数を明記します。
RFPに書く前提条件
前提条件がそろっていないと、各社の見積もりを同じ条件で比べられません。そのため、RFPには構成と数量、データ条件、委託範囲を書き込み、監視や情報管理の条件も合わせて示します。
- 構成・数量:構成図、ホスト数、ピーク時コンテナ数、環境数、サービス数、1日あたりのログGB、保持日数。
- 監視・運用:APM対象、DB台数、外形監視対象、SLO、通知先、オンコール時間、既存監視、IaC利用状況。
- 情報管理:個人・認証・決済情報がログに混入する可能性、保存場所、委託先責任、監査ログの要否。
- 成果物:要件定義、タグ・収集設計、モニター一覧、ダッシュボード、SLO、Terraform、テスト結果、手順書、教育資料、費用試算、権限表。
「設定済み環境」だけを納品されると、自社で変更できない場合があります。そのため、コードや設定の所有権、リポジトリ、アカウント、秘密情報の管理方法も確認しておきます。
開発会社の比較観点:実績と体制・役割分担
候補会社には、同じ範囲でPoCまたは設計提案を依頼し、体制と見積もりの観点をそろえます。
- 技術経験:Datadog認定資格者の有無、AWS・Azure・Google Cloud・オンプレミス・Kubernetesの経験を確認します。
- 実装・運用体制:APM、OpenTelemetry、IaC、SRE、セキュリティ、24時間運用、教育、障害時支援を比べます。
- 見積もり範囲:要件定義とテストの工数、アラート調整、ログマスキング、稼働後改善の有無。
2025年のDatadog Japan Partner Awardでは、CTCが販売、キンドリルジャパンがシステムインテグレーション部門で表彰されました。
また、クラスメソッドはエコシステム、アイレットは認定資格部門で表彰されました(出典: Datadog Japan Partner Award 2025、2025年)。
表彰部門の違いは、各社の得意領域を比べる材料になります。ただし、安い一式見積もりでも、対象サービスやテストが少ないと追加費用が生じます。
Terraformや教育が不足していると、これも追加費用につながります。さらに、不要な製品を多く含む提案は避けて、PoC後に必要な範囲を段階的に契約します。
セキュリティ・データ・コストのリスク確認
ログには個人情報や認証情報が混ざることがあり、利用料もログ量や保持期間で変わります。そこで、セキュリティ、データ、コストの条件を先に整理しておきます。
- ログ保護:メール、アクセストークン、Cookie、住所、決済情報の混入に備え、マスキング、送信先、保存期間、インデックス、権限、監査ログ、削除手順の決定。
- 費用管理:全量インデックス、過剰なカスタムメトリクス、高頻度トレース、長期保持、未使用ダッシュボードの見直し。
- 利用料の変動:予算超過時に誰が何を止めるか、繁忙期のデータ増をどう検知するかを決める。
サンプルログも確認します。Trust Centerには、SOC 2、ISO/IEC 27001、27017、27018、27701、PCI DSSなどの資料があります(出典: Datadog Trust Center、2026年確認)。
認証は判断の材料の一つで、それだけで要件を満たすとは言い切れません。そのため、対象サイト、契約条件、データ処理契約を見たうえで、どこまでを誰が受け持つかを法務・セキュリティ部門と決めます。
セキュリティと費用は、月次レビューに含めます。
Datadogのシステム開発・導入でよくある質問
導入前に質問されやすい内容をまとめます。答えは自社の構成や契約条件によって変わるため、初回相談やRFP作成のときに確かめてください。
Datadogそのものをスクラッチ開発する必要がありますか?
通常は必要ありません。DatadogはSaaSとして利用し、Agent、SDK、OpenTelemetry、API、Terraformなどで自社システムとつなぎます。
周辺で開発するのは、業務固有のダッシュボード、通知、チケット、権限ワークフローです。既存機能を使い、独自要件だけを実装します。そのため、早期に運用へ移行しやすくなります。
小規模な会社でもDatadogを導入できますか?
導入できます。最初は、重要な本番サービス1〜3個に、Infrastructure Monitoring、主要ログ、重大アラートを設定します。
必要に応じてAPMや外形監視を追加します。なお、10ホストのInfrastructure Proのみなら、公式単価と1ドル=150円の試算で月額約2.8万〜3.4万円です。
ログや導入支援は別費用です。そこで、PoCで実際の使用量を測ってから予算化します。
ログを集めすぎて費用が高くなるのを防ぐにはどうしますか?
収集の前に、ログの目的、機密情報のマスキング、サンプリング、インデックス対象、保持期間を決めます。そのうえで、障害調査用と長期保存用のログを分け、同じ条件ですべてを保存しないようにします。さらに、稼働後は、1日あたりのログ量、インデックス量、検索頻度、保持期間、月額利用料を月次で確認し、使われないデータを減らします。
Datadogの導入を開発会社へ依頼するべきですか?
構成が複雑なとき、複数チームにまたがるとき、APM・ログ・SLO・セキュリティを設計したいときは、専門会社への依頼が有効です。
24時間運用や既存監視からの移行が必要な場合も、依頼を検討できます。一方で、対象が少なく、担当者がAgentやダッシュボードを管理できるなら、小規模なPoCから始める方法もあります。
依頼するときは、設定代行だけでなく、IaC、テスト、教育、引き継ぎ、稼働後の改善まで含めて比べます。
まとめ:Datadogの段階導入と運用定着
Datadog導入は、障害を早く見つけ、原因を特定し、担当者が復旧できる運用基盤をつくる取り組みです。
要件整理で目的とKPIを定め、製品の範囲と支援会社の役割を選びます。続く設計では、タグ、収集、通知、IaCを整え、テストで障害対応を検証します。
導入前の最終チェック
導入前には、対象サービスと優先順位、必要機能、タグを見ておきます。さらに、ログの機密情報、保持期間、通知ルール、SLO、権限、テスト方法も確かめておきます。
費用の上限、成果物、引き継ぎ先も決めておきます。見積もりは、ライセンス料、クラウド関連費、初期導入費、保守費に分けてもらい、ログ量やコンテナ数が変わった場合の増減条件も記載してもらいます。
小さな開始、成果の測定、段階的な展開
重要サービス1〜3個のPoCから始め、費用と運用負荷を見ながら段階的に展開します。
- 効果を測る:MTTD、MTTR、SLO違反、アラートのノイズ率、ログ量、月額利用料。
- 展開範囲を決める:効果が認められた範囲から、本番サービスや周辺システムへ広げる。
- 改善を続ける:月次レビューと障害後の振り返りで、可視化を業務成果と安定稼働に結び付ける。
▼全体ガイドの記事
・Datadogのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。