
Datadogのシステムは、監視機能、データ連携、運用設計を組み合わせて、障害の検知から原因調査、復旧、改善までを支える仕組みです。発注側は、どこまでを自社で担い、どこから開発会社に任せるかを決めておくと、導入の進め方や費用、開発会社の選び方を比べやすくなります。
▼関連記事一覧
・Datadogのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Datadogのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Datadogのシステム開発の見積相場や費用/コスト/値段について
・Datadogのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Datadogのシステムの概要
Datadogのシステムは、監視対象から集めたテレメトリーデータを一つの基盤にまとめる仕組みです。そのため、利用者、開発者、運用担当者が、サービスの状態を同じ文脈で確認できます。
対象は従来のサーバー監視に限らず、アプリケーション、データベース、ネットワークの状態も関連付けて扱います。さらに、ユーザー体験やクラウド設定、セキュリティも関連付けて扱えます。
「Datadogのシステム開発」の二つの意味
「Datadogのシステム開発」という言葉は、二つの意味で使われています。一つはDatadog自体の開発で、もう一つはDatadogを使った自社の監視・運用基盤の設計です。一般的な導入相談で求められるのは後者です。
導入相談先として見るのは、製品を開発する会社ではなく、自社基盤の構築と運用に対応する技術パートナーです。
- 監視設計:Datadogを使った、自社サービスの監視・運用基盤の設計。
- データ連携:AgentやSDKの組み込みと、ログ連携。
- 運用改善:アラート運用やSRE改善の支援。
導入対象は、稼働中の業務システムに限りません。新規サービスでも、設計段階でタグやSLOを決めておけば、リリース後の調査がしやすくなります。
既存の監視ツールを残したまま、重要なサービスだけをDatadogへ段階的に移行する方法もあります。
可観測性を一つの流れで扱う考え方
可観測性とは、外部から得られるデータでシステムの内部状態を推測し、未知の障害も調べやすくする考え方です。たとえば、メトリクスで遅延に気づき、ログで失敗した処理を確認し、トレースで原因のサービス間呼び出しを追います。
三つを別々の画面で見ると、担当者が手作業で突き合わせる時間が増えます。そこで、サービス名や環境名、バージョンに加えて、地域や業務機能などのタグを共通化すると、リリースや障害の影響範囲を横断して調べられます。
Datadogでできることと向いているシステム
Datadogは機能が多いため、最初からすべてを契約せず、事業への影響が大きい監視対象から優先順位を付けるとよいでしょう。
Webサービス、複数APIが連携する業務システム、コンテナやマイクロサービスが増えた環境では、データを関連付ける価値が高まります。
インフラとコンテナの状態監視
Infrastructure Monitoringでは、インフラの状態とサービス間の接続関係を確認できます。
- 監視対象:仮想マシン、コンテナ、Kubernetes、ホスト、クラウドリソース。
- 状態指標:CPU、メモリ、ディスク、ネットワーク、稼働状態。
- 依存関係:サービスが動くホストと接続先の確認。
コンテナや短時間だけ動くタスクが多い環境では、ホスト数だけで予算を組むと課金単位を誤ります。そのため、ピーク時のコンテナ数、タスク稼働時間、ホスト平均数に分けて試算します。
APMと分散トレーシングによる原因の絞り込み
APMは、アプリケーションのリクエストが通る処理、所要時間、エラー箇所を追跡する機能です。画面表示が遅い場合は、データベースのクエリや外部API、認証処理などを、リクエスト単位で調べられます。サービス間の通信も対象です。
マイクロサービスでは、一つの操作の内部で複数のサービスが連鎖します。そのため、トレースIDとサービス名をそろえておくと、インフラの異常やアプリの例外、該当ログを一つの障害としてたどれます。
APMを全サービスに広げるか、売上や業務への影響が大きいサービスに絞るかは、費用と調査効果を見比べて決めます。
ログ・ユーザー体験・セキュリティの連携
ログ、利用者体験、セキュリティの情報を関連付けると、障害や異常の原因を追いやすくなります。
- ログ:アプリケーション、OS、ネットワーク機器の記録を集め、検索や相関分析に使います。
- 利用者体験:RUMやSynthetic Monitoringによる、画面表示や操作の失敗の検知。
- セキュリティ:クラウド設定の不備や脆弱性、不審な挙動を、サービスや環境と関連付けます。
Monitor、SLO、Incident Response、Workflow Automationを使うと、通知先の振り分けやチケット作成を自動化できます。さらに、復旧手順も起動できます。
通知を増やすと、担当者の負担も増えます。そのため、先に重要度と担当チームを決めたうえで、営業時間やエスカレーション条件も定めておきます。
Datadogの構成とデータの流れ
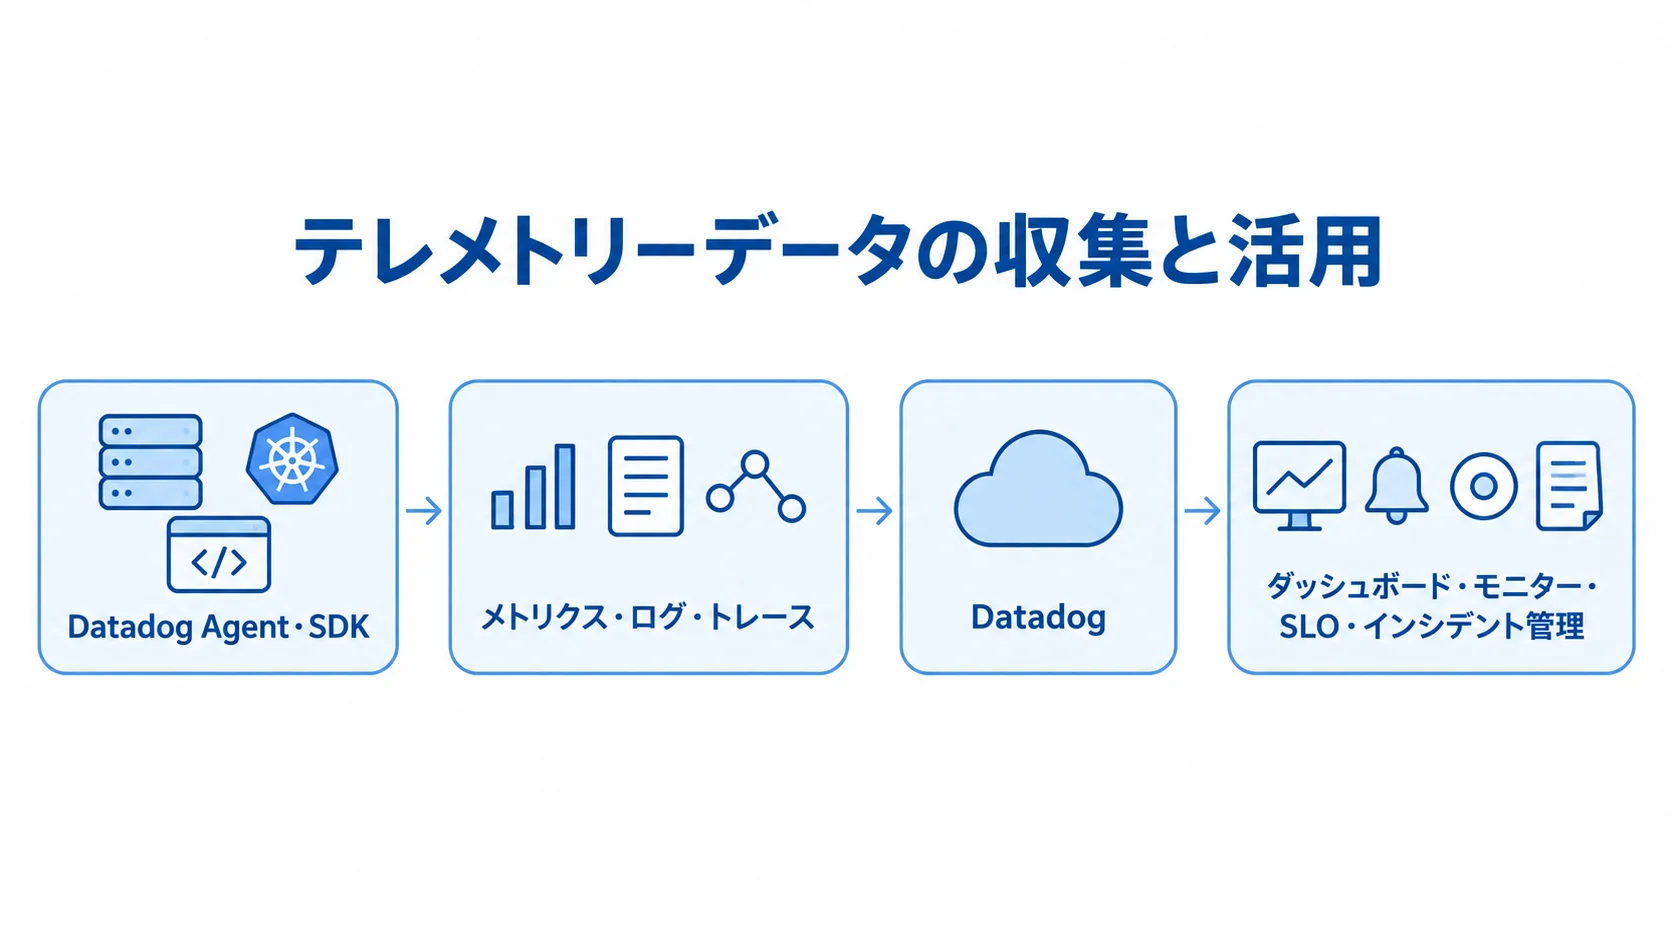
標準構成では、ホストやKubernetesノードにDatadog Agentを置き、アプリにはSDKや自動計装を組み込みます。
メトリクス、ログ、トレースをDatadogへ送り、ダッシュボード、モニター、SLO、インシデント管理で使います。また、導入前に、送信元とデータを図にし、保持期間と閲覧者も書き出すと、見積もりとセキュリティ確認を進めやすくなります。
▶ 詳細はこちら:Datadogのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
Agent・SDK・OpenTelemetryの役割の分担
データ収集では、Agent、アプリ側のSDKと自動計装、Collectorの役割を分けて考えます。
- Agent:ホストやコンテナのメトリクス、ログ、各種インテグレーションの収集。
- SDK・自動計装:アプリからトレースやカスタムメトリクスを送り出す部分。
- Collector:Agent内蔵のDDOTと、別運用のOTel Collectorの比較。
OpenTelemetryはベンダー中立の形式で、将来複数の出力先へ送る可能性がある場合に有効です。公式資料では、Kubernetesで細かく制御する場合はDDOT Collectorが適します。
加工や複数の出力先が不要な場合は、AgentのOTLP取り込みで設定を簡素にできます(出典: Datadog公式OpenTelemetryドキュメント、2026年)。
タグと命名規則の事前決定
タグ設計は導入の成否を左右します。まず共通項目と追加項目を決め、表記をそろえます。
- 共通項目:
env、service、versionの設定。 - 追加項目:チーム、地域、業務機能、顧客区分、重要度から、必要なものを選んで加える。
表記が揺れると、同じサービスのデータが別々に集計され、ダッシュボードやSLOが正しく機能しなくなります。
タグを増やしすぎると、カスタムメトリクスやインデックスの費用、検索性能、管理の複雑さに影響します。
命名規則、利用目的、登録責任者、廃止ルールを文書にまとめます。そのうえで、Terraformなどを使ってレビューします。
Monitor・SLO・通知の運用への接続
モニターは異常検知の条件を、SLOは利用者へ約束する信頼性を、通知は担当者の行動を定めます。
たとえば、注文APIのエラー率が一定時間を超えたら一次担当へ通知し、SLOの予算を使い切りそうならリリース判断を見直す運用もできます。
通知後に確認する画面、ログ、トレース、手順書は、一つの導線にまとめます。さらに、作成者やオーナー、休日の連絡先、誤検知の見直し期限も登録しておくと、担当者が変わっても運用を続けられます。
クラウド・Kubernetes・オンプレミスの導入パターン
環境によって、Agentの配置やネットワーク経路、権限、ログの扱いが変わります。そのため、既存の運用体制とセキュリティ要件に合う構成を選び、代表サービスで収集から通知までを検証します。
クラウド環境のサービス単位の可視化
対象には仮想マシンのほか、ロードバランサーやデータベース、キューなどのマネージドサービスも含みます。オブジェクトストレージやサーバーレスも、対象に入ります。
アカウントやプロジェクト、リージョンに加えて、環境とサービスのタグをそろえると、障害箇所を切り分けやすくなります。
クラウド標準の監視と併用することもできます。たとえば、標準監視で基盤の状態を確認し、Datadogでアプリや複数サービスの関連性、SLO、通知統合を担うなど、役割を決めて重複メトリクスを整理します。
Kubernetesの短命なリソースへの対応
KubernetesではPodやノードが入れ替わり、オートスケールで対象も変化します。そのため、固定のホスト名に頼らない設計にします。
- 実行環境:クラスタとネームスペースの範囲。
- サービス構成:デプロイメントとサービスの確認。
- バージョン:コンテナイメージのバージョンの追跡。
トレースをサービスマップにつなぎ、ログにトレースIDを含めると、Pod再作成後も調査を続けられます。
OpenTelemetryの処理を細かく制御したい場合は、DDOT Collectorの採用もPoCで確かめます。
オンプレミスとハイブリッドの責任の分け方
オンプレミスやハイブリッドでは、送信経路や接続設定、秘密情報の保管場所を確認します。全ログを外部へ送らない場合は、送るデータを最小限に絞ります。
- 接続:Agentからの送信経路、プロキシ、ファイアウォール、名前解決の確認。
- データ:マスキング、フィルタリング、保持期間の設計。
監視基盤そのものに障害が起きたときに、監視をどこまで続けるかも決めておきます。送信に失敗した場合は、バッファリングや再送、ローカル監視、緊急連絡の代替手段を定めます。
Datadog側と自社の責任を、サービス、ネットワーク、Agent、アプリごとに分けて、契約や運用手順に記載します。
Datadog導入・システム連携の進め方
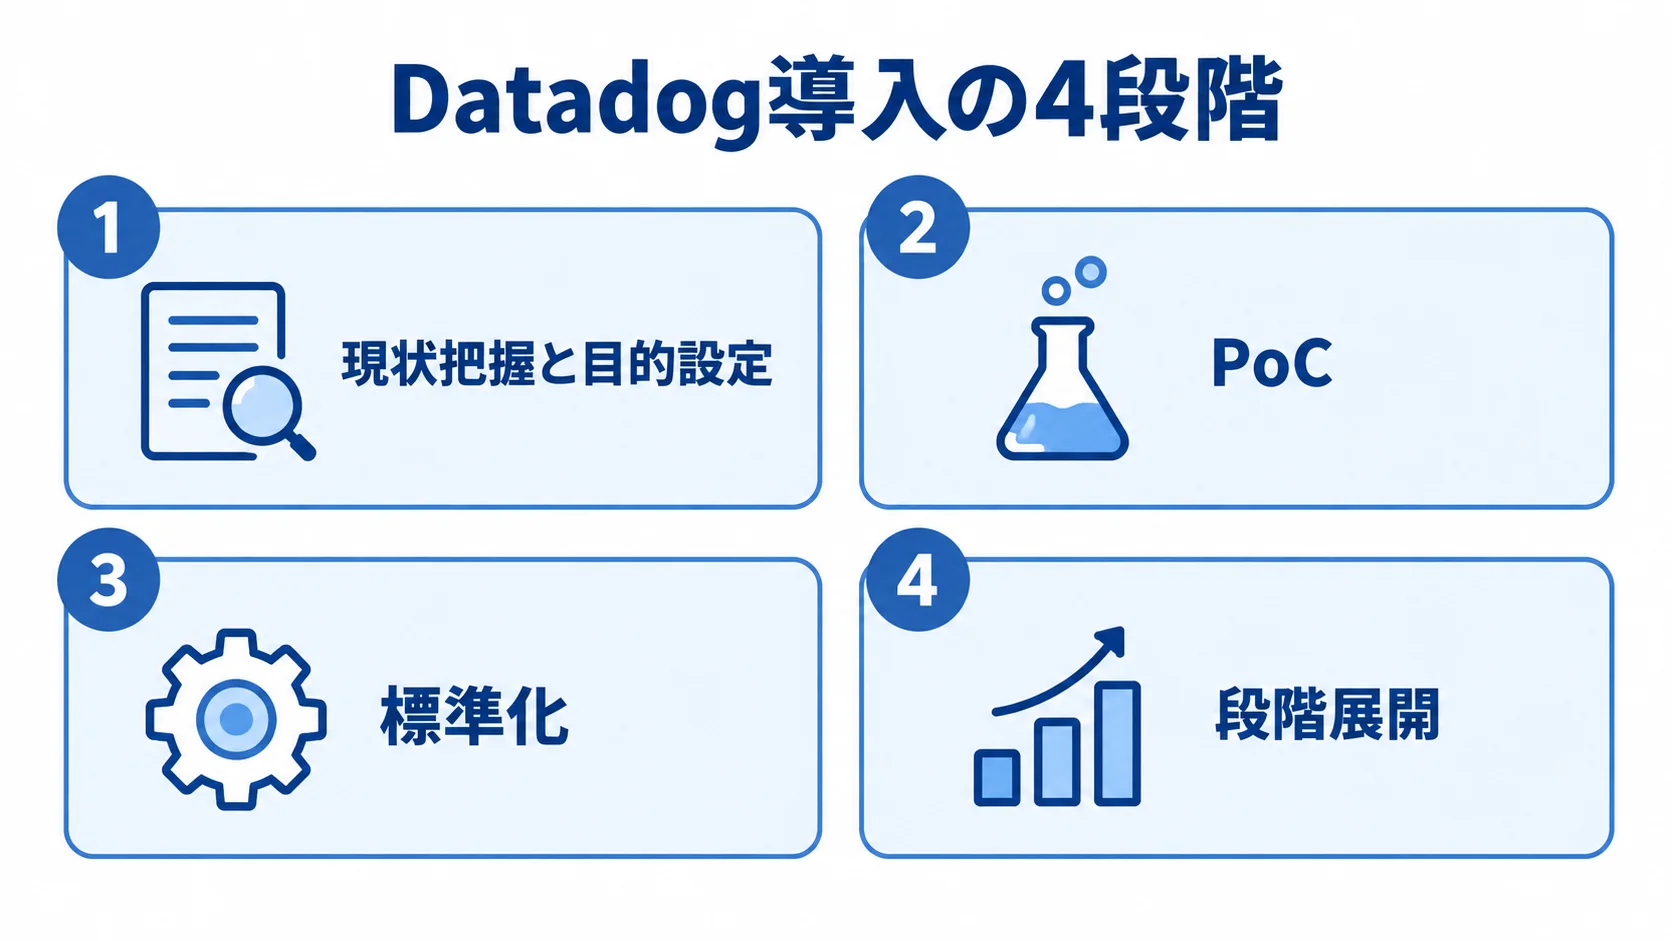
導入は、Agentを入れてダッシュボードを作った時点では、まだ途中の段階です。現状把握と目的設定から始め、PoCで検証したうえで、標準化を経て段階的に広げ、最後は運用改善へ進みます。また、障害対応を何分短縮したいか、どのデータを送らないかも、導入前に決めておきます。
現状把握と目的設定
最初に、システムと運用の状況を洗い出し、優先対象を決めます。
- システム:クラウド、オンプレミス、コンテナ、アプリ、データベース、ネットワークの確認。
- 運用:既存監視ツール、障害履歴、担当チームの整理。
- 優先対象:売上や顧客体験への影響、障害頻度、調査時間から選びます。
目的は「可視化」だけでなく、導入前後で比べられる指標に置き換えます。候補となるのは、平均検出時間や平均復旧時間、エラー率、レイテンシーなどです。
加えて、可用性やデプロイ頻度、対応に至ったアラートの割合も指標になります。数値がない場合は、最初の1か月を現状値の計測期間にします。
重要サービスでのPoC
PoCでは、重要サービスを1〜3個に絞り、Agent、APM、ログ、通知、ダッシュボード、SLOを設定します。平常時だけでなく、意図的なエラーや遅延を発生させて、検知、通知、原因特定、復旧にかかる時間を測ります。
期間は対象範囲によりますが、2〜6週間程度が目安です。全社ダッシュボードの完成度よりも、調査の速さやアラートの妥当性、タグの再利用性、ログ費用、担当者の操作性を評価します。
標準化と段階的な展開
PoCの設定をもとに、タグやログ形式、マスキング、通知レベルを標準化します。さらに、権限ロールや保持期間、ダッシュボード、モニターの命名規則もそろえます。
TerraformやAPIでモニターとダッシュボードをコード管理すると、レビュー、検証、リリース、ロールバックを再現しやすくなります。
本番の重要サービス、開発・検証環境、周辺システムの順に展開し、各チームへ運用を引き継ぎます。月次では、通知件数や誤検知率、利用料を確認します。加えて、SLO違反や平均検出時間、平均復旧時間も見ます。
Datadogの料金と導入費用の相場
Datadogの費用は、製品利用料と、導入・連携・運用の人件費に分けて考えます。費用は、ホスト数やAPM対象ホスト、コンテナ数で変わります。さらに、ログ量と保持期間、カスタムメトリクス、データベース監視対象でも変わります。
▶ 詳細はこちら:Datadogのシステム開発の見積相場や費用/コスト/値段について
公開単価からの利用料の試算
Datadogの利用料は、製品ごとに年額請求と月額請求の単価を分けて確認します。
- Infrastructure Pro:ap1で1ホストあたり年額請求は月18.75ドル、月額請求は22.50ドル。
- APM・Database Monitoring:年額は38.75・87.50ドル、月額は45・105ドル。
- ログ:取り込みは1GBあたり0.13ドル。インデックス化分は保持期間に応じて課金(出典: Datadog公式料金表、2026年)。
1ドル=150円で換算すると、Infrastructure Proだけを10ホストで使う場合は、月額約2.8万〜3.4万円です。10ホストにAPMを加えると、年額請求ベースで月額約8.6万円になります。
30ホストにAPMとDatabase Monitoringを2対象追加すると、月額約28.5万円が目安です。また、100ホストでInfrastructure ProとAPMを使う場合は、月額約86万円です。
ログ、コンテナ、セキュリティ、長期保持は、別途加算されます。金額は為替を固定した概算であり、契約期間や請求方法、割引によって変わり、利用量や追加製品でも差が出ます。
特に、ログとカスタムメトリクスは設計で増減しやすい項目です。平均値だけでなく、キャンペーンや障害時のピーク値でも上限を確認します。
導入・連携開発費の作業範囲による違い
導入支援費は、契約料とは別に必要になります。目安として、PoCは50万〜200万円で2〜6週間程度、標準導入は300万〜1,000万円で2〜4か月程度が推定レンジです。
複数環境や厳格な監査、既存監視からの移行を含むエンタープライズ導入は、1,000万〜3,000万円以上、4〜9か月程度が目安です。
この金額は、Datadog固有の国内公的相場ではなく、監視設計や連携、教育を含む一般的な作業量から算出した推定です。
費用は、ホスト数に加えて、工数を左右する作業でも決まります。
- 環境連携:マルチクラウド、Kubernetes、オンプレミスとの接続。
- システム対応:アプリ計装、ログのマスキング、既存ツールからの移行。
- 設計・運用:Terraform化、SLO設計、24時間運用、教育、監査資料。
重要サービスに絞り、既存の通知基盤を再利用すれば、初期費用を抑えられます。
ランニングコストの月次管理
運用後は、ライセンス料に加えて、ダッシュボード改善やアラート調整、SLOレビューを見込みます。さらに、コスト分析や機能追加、教育も含めます。また、初期導入費の年15〜25%程度を保守の目安にする考え方もあります。
24時間対応や大幅な移行を含む場合は、時間帯や対応件数、対応時間を別に定義します。成果物も、あわせて定義します。
月次では、利用料を見直し、使用量と費用の動きを確認します。
- 内訳:ホスト、APM、ログ取り込み、ログ保持、カスタムメトリクス、コンテナごとに分けます。
- 削減候補:ログの重複、不要なデバッグログ、長すぎる保持期間、高カーディナリティのタグの洗い出し。
削減では、品質を保ちながら送信量を減らします。
見積もりを取る際のポイント
製品名だけを伝えて一式で見積もってもらうと、提案どうしを比べられません。そのため、監視対象やデータ量、保持期間を、各社に同じ条件で伝えます。機能や連携先、運用体制も、そろえて示します。
また、契約料、初期設定、連携開発は、項目を分けてもらいます。教育や保守も分けてもらうと、比べやすくなります。
RFPへの対象量と運用条件の記載
RFPに監視対象の規模とデータ条件を記載すると、見積もりの前提がそろいます。
- 対象量:サービス、環境、ホスト、ピーク時のコンテナ数。
- ログとトレース:ログGB/日、保持日数、トレース量。
- 計測対象:APM対象数、カスタムメトリクス数、データベース対象。
通知先やSLO、既存ツールも明記し、個人情報の有無や権限、監査要件もあわせて示します。不明な項目は、推定値と実測予定日で補います。
納品物に、構成図やタグ設計書、ダッシュボード、モニター一覧、Terraformコードを含めるかも確認します。
ログマスキング設定や権限一覧、障害対応手順、テスト結果、教育資料、引き継ぎ記録も、納品の対象です。さらに、設定変更の承認者と本番適用者も確認します。
同じ前提での複数提案の比較
安い提案を選ぶ前に、対象範囲と除外範囲を確かめます。ログ収集だけの提案と、マスキングや保持期間、アラート運用まで含む提案とでは、価格だけで優劣を判断できません。
- 作業範囲:各提案に含む内容と除外項目。
- PoCと本番:検証範囲と、本番展開で追加される費用を分けて比べる。
- 料金・運用:料金単位、超過通知、保存場所、責任の分け方、サポート時間。
- 解約・成果物:解約時のデータ、設定やコードの所有権。
内製化を目指す場合は、外部へ任せる期間と、引き継ぎの教育やドキュメントも提案に含めてもらいます。
Datadogの開発会社・ベンダーの選び方
パートナーを選ぶ際は、Datadogの設定経験に加えて、自社の環境を一つの計画にまとめられるかを確認します。ここでいう環境とは、アプリやクラウド、ネットワーク、セキュリティ、運用体制などです。
公式の表彰や認定資格は、候補を絞る材料になります。ただし、それだけで自社に合うとは限りません。そのため、実績の規模や担当者の経験、PoCの進め方、内製化支援の範囲も聞いておきます。
自社の技術環境に合う経験の確認
実績は、Datadogを使った事実だけでなく、自社に近い環境で経験があるかで見ます。確かめるのは、クラウドやKubernetes、オンプレミス接続、アプリの言語などの技術環境です。さらに、データベースや既存監視、ログ量、24時間運用についても、近いかどうかを見ます。
守秘義務の範囲で、構成図や課題、導入後の改善内容を説明してもらいます。
周辺技術として、OpenTelemetryやTerraform、CI/CD、チケット管理、チャット通知なども確認します。さらに、コードレビューやテストを含む開発プロセスを提案できるかが、長期運用に関わります。
導入後の運用と内製化の範囲
導入後に必要な運用作業と、外部支援を受ける範囲を確認します。
- 運用作業:アラート調整、ダッシュボード改善、タグ追加、ログ費用の見直し、障害訓練。
- 支援内容:月次レビュー、問い合わせ窓口、障害時の支援、機能追加の扱い。
- 引き継ぎ:手順書の説明に加え、実際の障害シナリオを使った練習。
- 調査操作:モニター作成、ログ検索、トレース調査、通知抑制の確認。
- 変更操作:権限変更、コード変更、ロールバックを実行できるかの確認。
初期設定で終わると、現場が使いこなせず、アラート疲れが起きるおそれがあります。そのため、支援条件は契約前に確認しておきます。
責任分界と見積もりの透明性
担当範囲と費用の責任を、項目ごとに分けて確認します。
- 作業範囲:要件定義、設計、設定、アプリ改修、テスト、リリース、教育、保守の各工程について、担当を決めます。
- 請求管理:Datadog、クラウド、ネットワーク、外部サービス費の管理者。
- 提案比較:2〜3社で対象、ログ量、保持期間、APM、SLO、通知先をそろえる。
「別途見積もり」の発生条件と上限を確認すると、導入後の予算管理にもつながります。
▶ 詳細はこちら:Datadogのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Datadogのシステム開発の発注/外注/依頼/委託方法について
セキュリティ・法規制・データ管理の確認事項
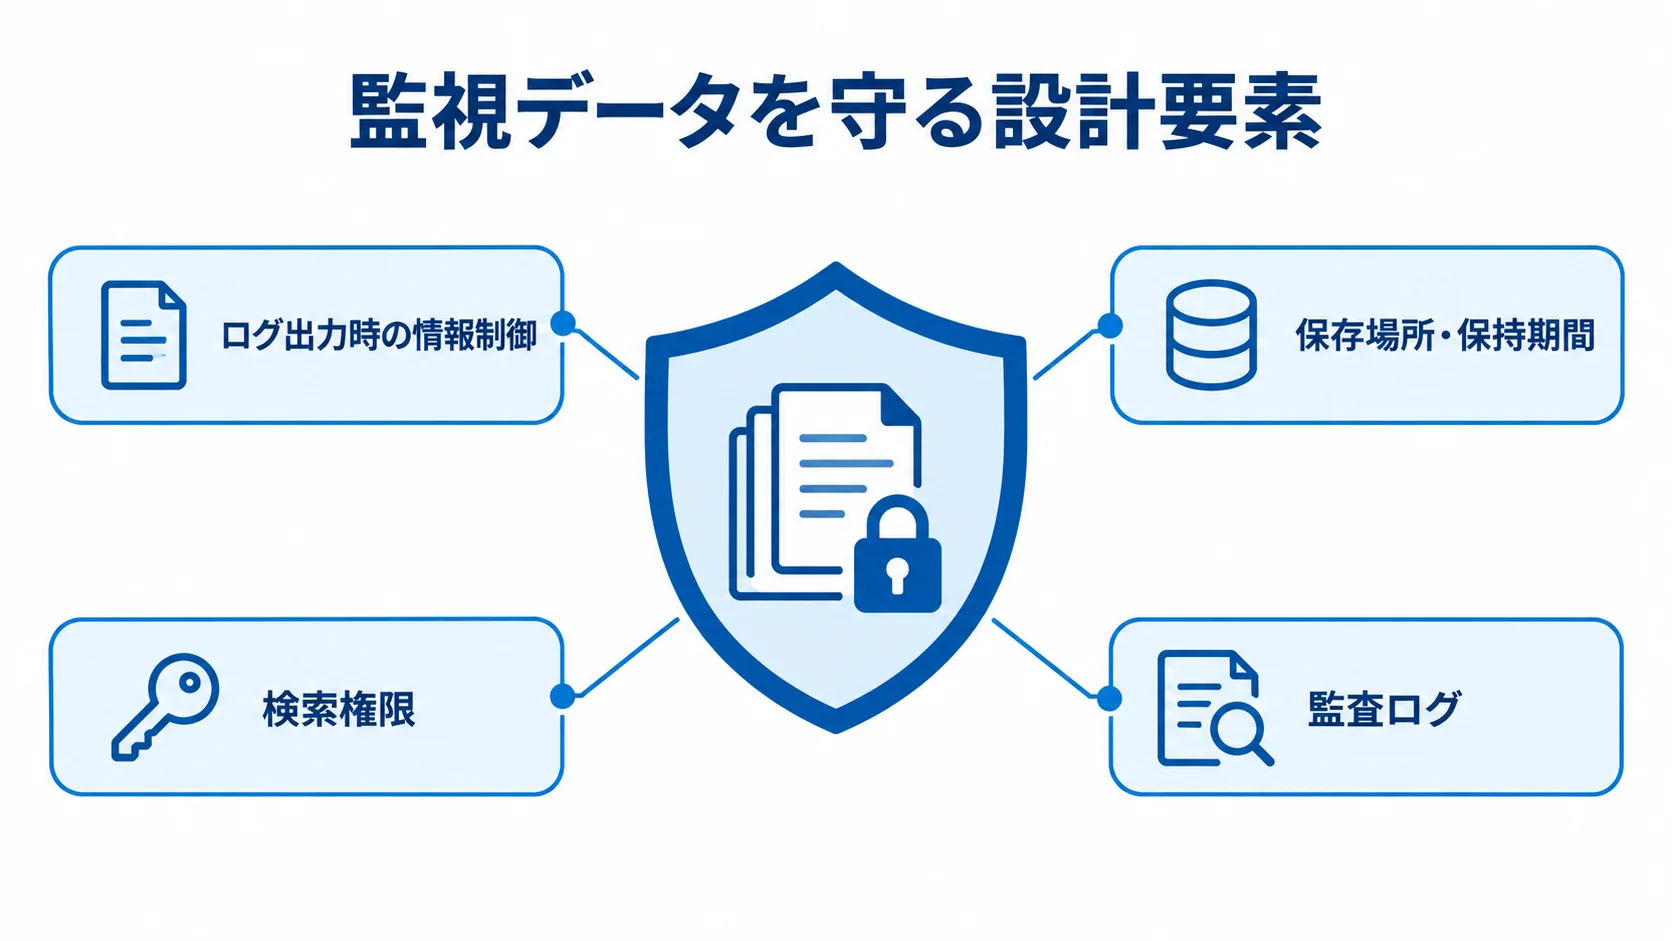
監視データには、個人情報や認証情報、アクセストークン、顧客IDのほか、業務上の秘密が混ざる可能性があります。そのため、送信しない情報や送信前のマスキング、検索できる人、保持期間を定めておきます。
可観測性の範囲を広げるほど、データ管理の設計も欠かせなくなります。
ログに秘密情報を送らない設計
アプリのログ出力時には、パスワードやトークン、決済情報、個人を直接識別する値を記録しないことが基本です。既存のログは、Agentやパイプラインでフィルタリングとマスキングを行います。
後処理だけに頼ると、漏えいのリスクも運用コストも増えます。そのため、アプリ側の設計と組み合わせて進めます。
本番では、デバッグログを常時送らない運用にします。そのうえで、通常時のログレベルや、障害時に一時的に詳細化する条件、保持期間、削除手順を定めます。また、検索権限は職務ごとに制限し、監査ログでアクセスを追います。
保存場所・保持期間・契約資料の確認
規制業種や委託先管理が必要な場合は、保存場所や越境移転、サブプロセッサー、削除方法を確認します。バックアップや障害復旧、監査協力の範囲も対象です。
Trust CenterにはSOC 2、ISO/IEC 27001、ISO/IEC 27017などの資料があります。また、ISO/IEC 27018、ISO/IEC 27701、PCI DSSも掲載されています(出典: Datadog Trust Center、2026年)。
導入の可否を判断するときは、必要な認証資料を、自社の運用条件とあわせて確認します。
- 認証:必要な認証が対象サービスを含むかの確認。
- 地域・契約:対象地域と契約条件を、自社要件と照らし合わせる。
認証名だけで導入の可否を決めることは避け、自社方針や業界指針、アクセス管理、委託先の責任の分け方を確認します。必要な資料は、契約前に取得しておきます。さらに、開発会社に依頼しても、確認の主体は自社です。
権限と監査の運用設計
権限は、管理者や設定変更者、閲覧者、インシデント対応者などの役割ごとに分けます。さらに、開発と本番の環境を分け、APIキーや認証情報は安全に保管します。退職や異動の際には、速やかに無効化します。
監視設定の変更をコードレビューと承認に通すと、意図しない通知停止やデータ送信を防ぎやすくなります。
セキュリティや開発、運用、法務・コンプライアンスの各担当が確認する事項を分けたうえで、導入判定を記録します。設定を誤ると秘密情報の収集源にもなり得るため、開始後も権限とデータ範囲を定期的に見直します。
よくある失敗例と導入後に見るKPI
Datadogは、導入した後も運用を続けていく必要があります。監視対象が増えるほど、アラート品質やタグ、ログ量、担当者の習熟度を管理します。
公開事例では、自動検知とAPM連携による初動改善、IaC化による運用工数削減が効果として示されています(出典: Datadog公式導入事例、2026年確認)。
アラートの増えすぎへの対策
よくある失敗は、監視項目を増やした結果、通知が多くなりすぎて、本当に重要な異常が埋もれてしまうことです。対策として、利用者への影響や復旧の緊急度、担当チーム、対応時間を基準に、通知を分けます。
- ページ通知:緊急対応が必要な異常向け。
- チャット通知:担当チームが確認する異常向け。
- 記録のみ:即時対応を求めない事象を残す。
一定期間対応されないモニターは、原因を調べて閾値や通知先を見直すか、削除します。
アラート発生後に誰が閉じるか、暫定・恒久対応をどこへ記録するかを決めます。また、通知件数だけでなく、対応に結び付いた割合も追います。
タグの不統一とログ費用の膨張への対策
service名や環境名がチームごとに異なると、同じサービスをまとめて分析できなくなります。そのため、命名規則は早い段階で決め、コードレビューや設定チェックで守ります。
ユーザーIDやリクエストごとの一意な値を、タグへ無制限に加えると、カーディナリティが増えて管理しにくくなります。分析に必要な粒度を、あらかじめ見極めます。
ログ費用は、取り込み量やインデックス化の割合、保持期間、検索頻度で変わります。一方で、障害調査に必要なログは短期で検索できるようにし、監査や法規制で必要なログには、別の保存方法も組み合わせます。
運用KPIによる導入効果の確認
導入効果は、信頼性、費用、開発の各面から確認します。
- 信頼性:検出・復旧時間、再発率、誤検知率、SLO達成率、原因特定時間を確認します。
- 費用:ホスト数、ログGB、インデックス量、カスタムメトリクス、コンテナ数を月次で追います。
- 開発:エラー検知、ロールバック判断、デプロイ頻度、調査に必要な担当者数を見ます。
費用は、予算との差と増加理由を説明できる状態にします。
数字だけを目標にすると、アラートを減らすために監視を外すといった逆効果も起きることがあります。そのため、信頼性や開発速度、運用負荷、費用を組み合わせて評価します。
よくある質問(FAQ)
導入の際によく尋ねられるのは、既存ツールとの関係や費用、導入範囲、OpenTelemetryとの使い分けです。自社の監視対象と運用体制に照らして確認します。
既存のクラウド監視ツールはすべて置き換える必要がありますか?
すべてを置き換える必要はありません。既存ツールで基盤の標準監視を行い、Datadogがアプリやログ、トレース、SLO、通知統合を担う方法もあります。
重複するデータと通知を整理し、重要サービスで効果を検証してから移行範囲を決めます。
小規模なサービスでもDatadogを導入できますか?
導入できます。対象を1〜3サービス、少数ホスト、主要ログとAPM、重要アラートに絞れば、2〜6週間程度のPoCで効果と費用を確認できます。
対象を広げる前に、タグ、通知、保持期間、運用担当を決めておくと、後からの作り直しを減らせます。
OpenTelemetryとDatadogはどのように使い分けますか?
OpenTelemetryは、テレメトリーを収集・処理する標準的な選択肢です。一方で、Datadogは収集したデータを可視化や分析に使い、通知やSLO、インシデント対応へつなげます。
Agent内蔵DDOT Collectorか、複数の出力先へ送る別Collectorかを、運用体制と将来の移行可能性で判断します。
料金を抑えるには何から見直せばよいですか?
まず確認したいのは、ログ取り込み量やインデックス化の割合、保持期間です。さらに、カスタムメトリクスやAPM対象、コンテナ数も見直します。そのうえで、不要なデバッグログを減らし、重要度に応じて保持期間を分け、必要なサービスから導入します。
安さだけを優先して必要な監視を外さず、平均復旧時間や障害影響も合わせて評価します。
まとめ
Datadogは、インフラ監視に加えて、メトリクスやログ、トレースをつなぐ可観測性基盤です。さらに、ユーザー体験やセキュリティ、SLO、インシデント対応までを一つの流れで扱えます。
導入前には、目的と対象を絞ったうえで、タグやデータ管理、通知、権限、費用を設計します。そのうえで、PoCで検証してから段階的に広げます。
自社に合う範囲からの導入計画
検討の際は、監視対象やホスト・コンテナ数、ログ量、保持期間、APM対象を洗い出します。さらに、通知先やSLO、個人情報の有無、既存ツール、運用体制もまとめます。
PoCの成功条件、導入後の引き継ぎ範囲、料金上限、セキュリティ資料を決めたうえで、同じ条件で提案を比べます。
導入後のKPIと費用の継続的な見直し
平均検出時間や平均復旧時間、アラート誤検知率、SLO達成率は、月次で確認します。ログ量や利用料も、あわせて月次で見ます。サービスや組織の変更に合わせて、タグや通知先、権限、ダッシュボードも更新します。
機能の追加そのものを目的にはせず、障害の早期発見や原因特定、利用者への影響の抑制、継続的な運用改善を目指します。そのため、KPIと費用を月次で確認し、品質と予算を管理します。
▼関連記事一覧
・Datadogのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Datadogのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Datadogのシステム開発の見積相場や費用/コスト/値段について
・Datadogのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。