
DevOpsの失敗は、文化・設計・組織への対策で防ぎ、速度と品質を高められます。成功事例を真似るより、失敗の理由を知るほうが、体制づくりの教訓になります。
ツールから監視、セキュリティまで、領域ごとに起きやすい失敗を見ていきます。全体像はDevOps強いの完全ガイドもご覧ください。
▼全体ガイドの記事
・DevOps強いの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ツール先行で文化が変わらない失敗
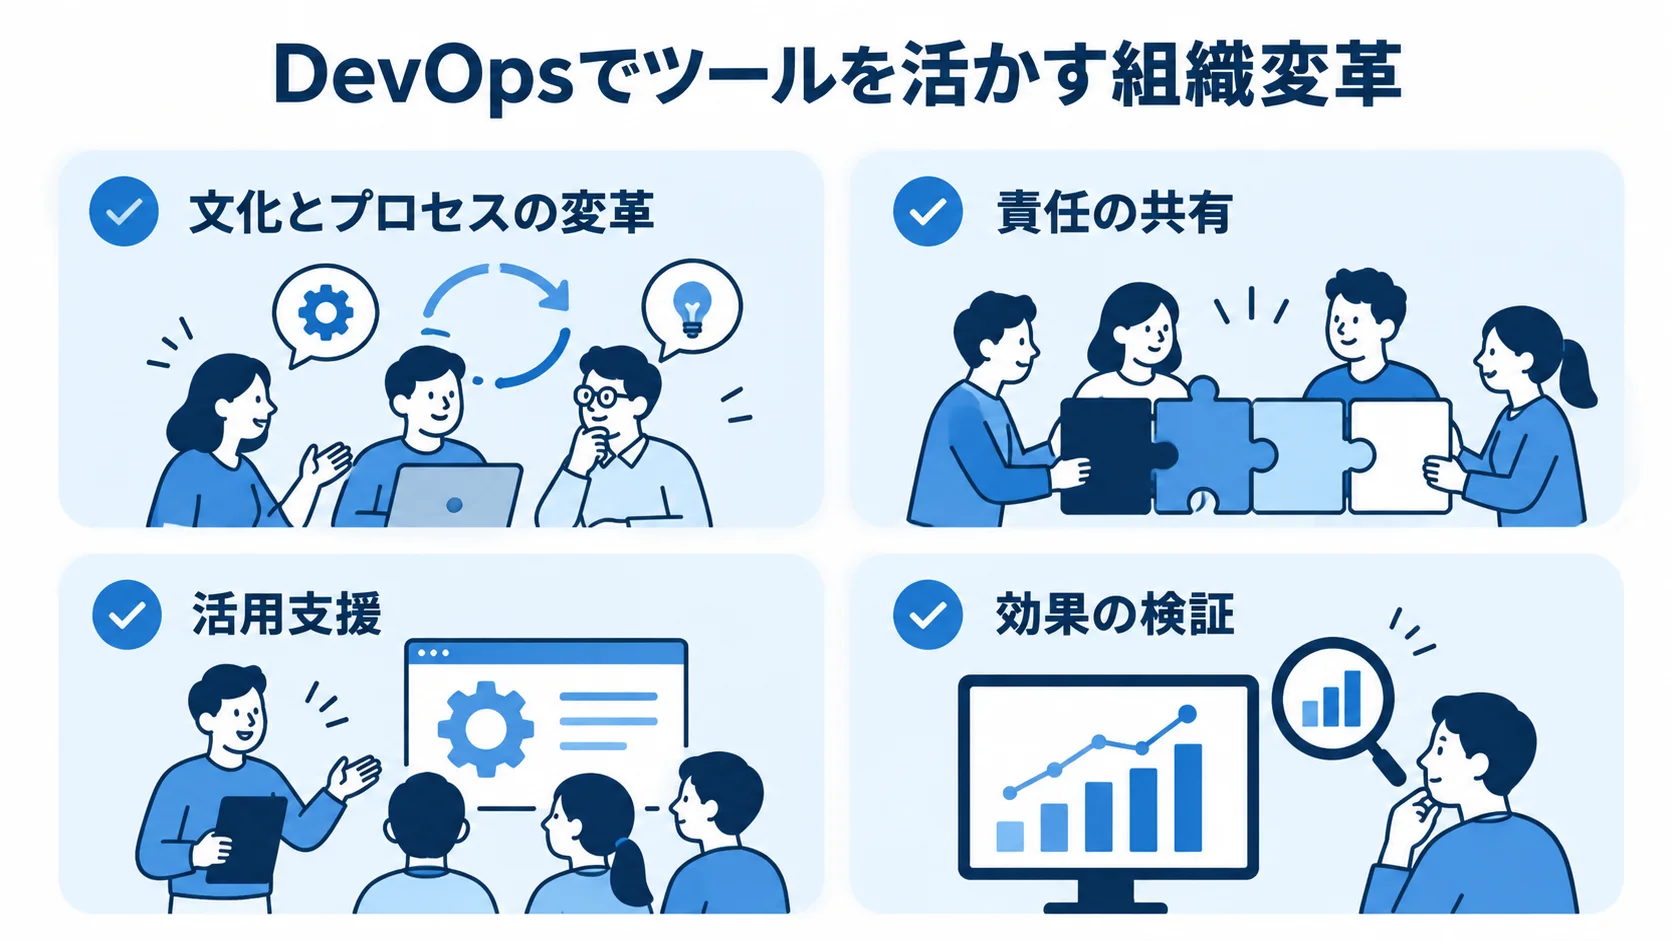
DevOps導入では、「ツールを入れれば強くなる」という誤解が失敗を招きます。CI/CDツールやコンテナ基盤を入れても、開発と運用の壁が残ったままだと、速度も品質も変わらないケースが頻発します。
DevOpsの本質は、文化とプロセスを変えることにあります。ツールはそれを支える手段にすぎず、目的と取り違えると投資が活きなくなります。
開発と運用の壁が残ったままという失敗
開発と運用の分断が残ると、CI/CDを入れても、開発が成果物を運用へ渡すだけの関係が続きます。障害時の責任の押し付け合いや、リリース時の摩擦も、そのまま残ってしまいます。
DevOpsは、開発チーム(Dev)と運用チーム(Ops)が共通の目標に向けて協働する文化です。組織のサイロ(縦割り)が残ったままだと、ツールだけが入った状態になってしまいます。
責任共有を実際に機能させるには、体制とKPIを両チームで設計しておく必要があります。共通の目標にする指標には、リリース頻度、変更失敗率、障害復旧時間があります。
- 責任の共有:成功も失敗も両チームで引き受けることです。
- 経営層の位置づけ:ツール導入ではなく、組織変革として扱います。
- 役割と評価:役割分担や評価制度まで見直す対象です。
ツールから始める場合でも、文化とプロセスの変革まで進めることが、形だけのDevOpsを避ける鍵です。
ツール費だけ払い活用できない失敗
ツール先行の失敗は、コストにも表れます。CI/CD、コード管理、セキュリティスキャンのSaaSは月数万円規模で、Datadogはホストあたり月15〜23ドルです。
導入しても、チームが使いこなせず従来どおり手作業が続けば、ツール費は固定費として無駄に払われ続けます。有名なツールでも、使われなければ意味がありません。
ツール費を活かすには、導入の前後で、課題の明確化から効果の検証まで通して見ておく必要があります。
- 課題の明確化:対象作業と、ツールに任せる役割を決めることです。
- 活用支援:学習時間を確保し、利用を支える体制です。
- 効果の検証:費用対効果を継続して確かめ、未使用のツールを見直すことで、費用の垂れ流しを防ぎます。
DevOpsの効果や費用の全体像は、メリットとデメリットを扱う関連記事もあわせてご覧ください。
テスト不備でパイプラインが形骸化する失敗
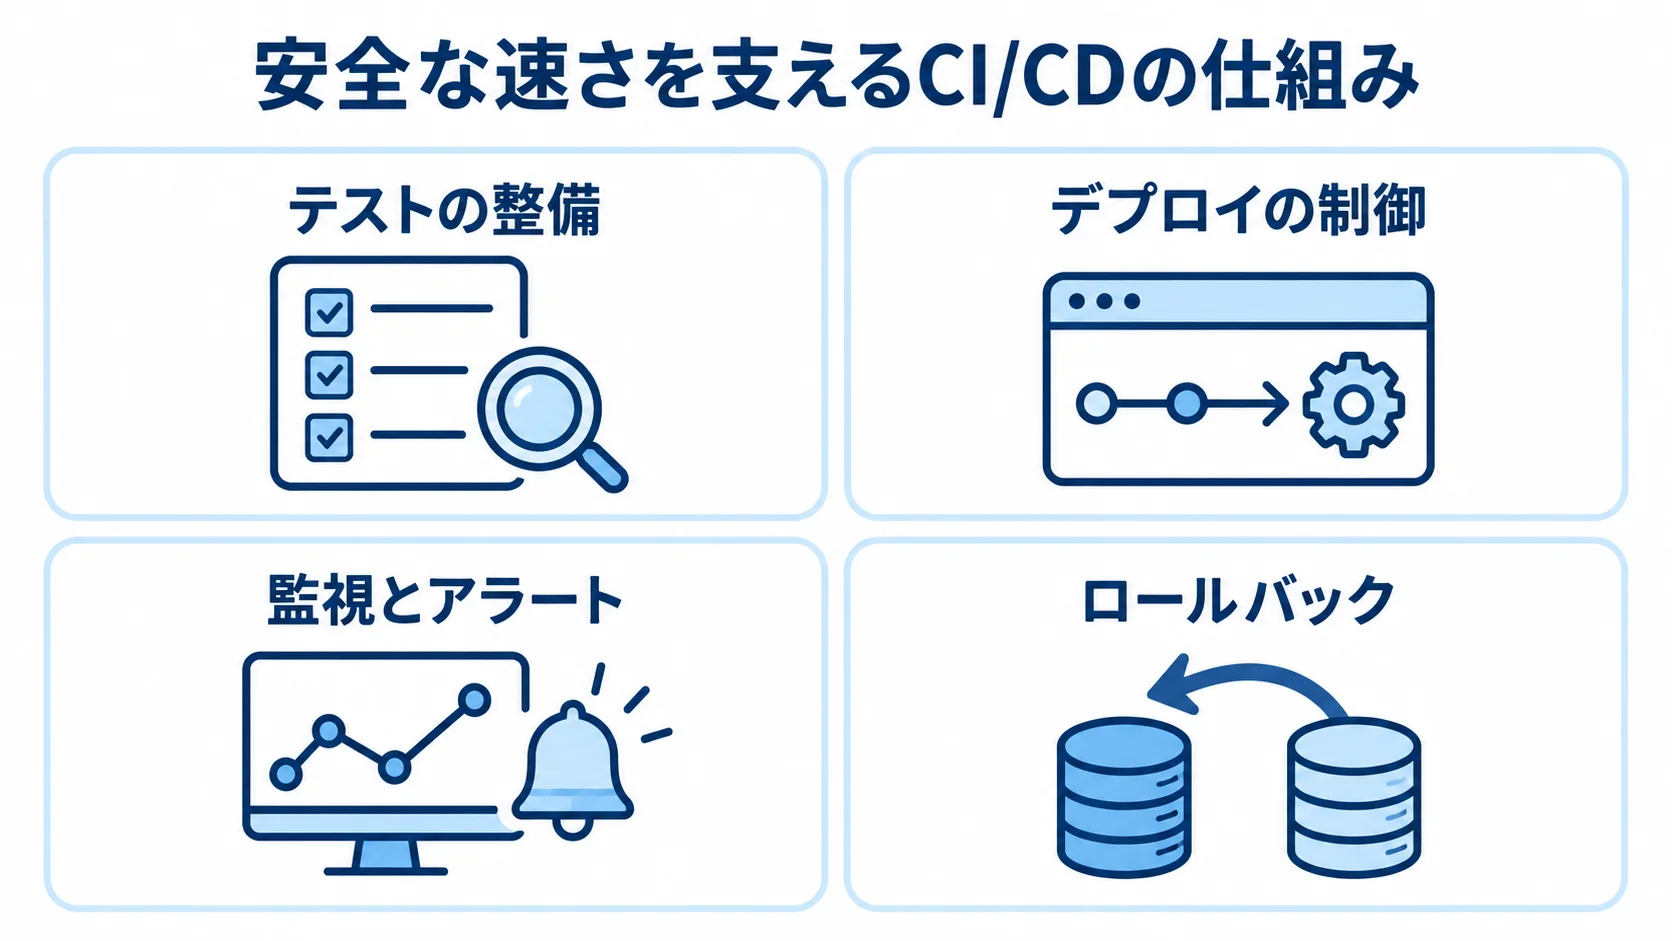
CI/CDを構築しても、自動テストが不十分であれば効果は半減します。検証が甘いまま自動デプロイが進むと、バグを本番へ速く届けてしまう危険があります。
パイプラインの形骸化は、DevOps導入で見落とされやすい深刻な失敗です。自動化の速さを安全な速さに変えるには、テストと監視が欠かせません。
自動テストが薄くバグを高速に届ける失敗
CI/CDは、変更を自動でテストし、問題がなければ自動でデプロイする仕組みです。テストの網羅性が低いと、すり抜けたバグがそのまま本番へ流れてしまいます。
手動デプロイであれば人が気づけた不具合も、高速なパイプラインでは止まらずに通過することがあります。「速くリリース」が「速く障害を起こす」に変わってしまう失敗です。
安全性を高めるには、単体・結合・回帰テストを組み込んでおきます。さらに、テストが通らなければデプロイを止めるゲートも設けます。
- テストの整備:最初に工数をかけてテストを厚くすると、自動化を安全な速さに変えられます。
- デプロイの制御:テスト失敗時はデプロイを止める仕組みです。
整備を惜しむと、パイプラインは「ただ速いだけ」の危険な仕組みになります。一次データでは、自動テストを組み込んで本番障害を減らした事例も示されています。機能の詳細は関連記事もご覧ください。
可観測性の欠如で障害に気づけない失敗
リリースを速くしても、本番の状態を観測する仕組み(可観測性)がなければ、障害の検知は遅れます。監視がないままだと、問い合わせで初めて障害に気づき、見えない障害が増えるおそれがあります。
メトリクス、ログ、トレースを一つにまとめて見られる監視を整えておきます。速くリリースする力と、異常を察知する力は、セットで備える必要があります。
監視とアラートは、自動デプロイと同時に整えておきます。監視の費用は、Datadogの例ではホストあたり月15〜23ドルです。
- 監視とアラート:障害を早期に検知して、復旧を速める役割です。
- ロールバック:問題発生時に、前のバージョンへ戻せる状態のことです。
障害の早期検知と迅速な復旧を考えれば、監視は必要な投資です。観測とロールバックを備えてこそ、高速なパイプラインを安心して運用できます。
IaC・コンテナが運用負債化する失敗
IaCやコンテナは、環境構築の自動化やポータビリティをもたらします。ただし、扱いを誤ると、運用の負債になることがあります。
構成が複雑になり、コードが属人化すると、保守できる人がいなくなった時点でブラックボックス化します。便利な技術でも、運用の設計次第では重荷になります。
IaCの属人化でブラックボックス化する失敗
IaCは、インフラの構成をコードで管理する手法です。その結果、環境構築を数日から数十分に短縮できます。
書いた本人にしか分からない複雑なコードは、異動や退職を機に、誰も変更できなくなります。自動化しても、一人に依存する構造が生まれてしまいます。
クラウド開発では、費用の約80%が人件費です。特定の人材に依存すると、その人を失うリスクや、引き継ぎコストの高さを招きます。
文書化とレビューの手順を設けておくと、引き継ぎの負担を抑えられます。また、シンプルさを保って、過度に凝った構成を避けることも大切です。
- 保守しやすいコード:誰もが読める標準にそろえることです。
- 知識の共有:複数人が理解し、保守できる体制のことです。
IaCの価値は再現性と効率にあります。誰でも保守できる状態をつくれば、運用負債への転化を防げます。
コンテナ・マイクロサービスの過剰設計の失敗
コンテナやマイクロサービスは、ポータビリティとスケーラビリティを高めます。一方で、規模に合わない過剰設計は失敗を招きます。
採用する際は、規模や運用体制に合う選択肢を比べます。
- 過剰設計:小さなシステムに多数のマイクロサービスやコンテナオーケストレーションを入れると、構成が複雑になり、人材不足や障害切り分けの難しさにつながります。
- 選定基準:「最新だから」に頼らず、システム規模とチームの運用能力に合わせて選ぶことです。
- 少〜中規模の選択肢:Lambda+API Gatewayなどは、アイドルコストを抑えつつシンプルに保てる構成です。
- 運用負債の回避:コンテナ等は規模と運用体制が合えば価値を生みますが、背伸びした設計は運用負債になります。
一次データでは、月数百円から利用でき、無料枠内に収まるケースも示されています。構成パターンの選び方は、要件定義の関連記事もご覧ください。
SRE化・内製化の頓挫とトイル温存の失敗
DevOpsを強い体制にする最終段階は、SRE(サイト信頼性エンジニアリング)への移行と内製化です。ここでつまずく企業も少なくありません。
従来の「絶対に止めない運用」から、文化を切り替えられない場合があります。また、外部委託が続いて、ノウハウが社内に蓄積されない失敗もあります。
この領域は、最も差別化が効く一方で、最も難しい領域でもあります。運用改善と知識移転を並行して進める必要があります。
トイルを自動化できず温存する失敗
SREは、SLO(サービスレベル目標)を設定し、トイル(手作業による繰り返しの労苦)をなくしていく考え方です。障害対応の自動化も目指します。
DevOpsを掲げていても、手作業の運用タスクが残り、エンジニアが日々の作業に追われる失敗があります。自動化基盤があっても運用の文化が変わらなければ、SREの効果は出ません。
トイルを放置すると、改善に使える時間が奪われ続けます。そこで、SLOを定めて運用目標を数値にし、繰り返される手作業を洗い出します。
- 自動化の計画:特定した作業を、計画的に自動化することです。
- 時間の確保:トイル削減を、正式な運用タスクとして位置づけます。
一次データでは、SLOの設定と監視の自動化によって、障害対応を変えた事例も見られます。改善を後回しにすると、SRE化の頓挫につながります。進め方は関連記事もご覧ください。
内製化が進まずノウハウが蓄積されない失敗
外部支援を丸投げに近い形で利用すると、内製化が進まない場合があります。外部委託には、本業に集中でき、立ち上げが速いというメリットもあります。
一方で、社内にノウハウが蓄積されない点はデメリットです。委託先に依存しすぎると、いざというときに自社で対応できず、「強い」体制にはなりません。
スキルトランスファーの設計がない委託は、内製化の頓挫に直結します。そこで、最初から内製化を見据え、外部パートナーの伴走を受けます。
一次データでは、外部の伴走を受けてCCoE(Cloud Center of Excellence)を立ち上げ、内製化した事例も見られます。また、クラウド人材の採用、育成、評価制度も整えておく必要があります。
- スキルトランスファー:伴走支援を通じた、知識の社内への移転です。
- 段階的な内製化:内製比率を高めるロードマップを描きます。
riplaは、フルスクラッチ受託と国内開発の立場から、CI/CD・IaC・SRE化の構築を支援しています。加えて、伴走による知識移転や内製化の支援も行っています。
失敗の構造を知り、文化から内製化まで一貫して設計することが、リスク管理につながります。
一気導入とセキュリティ軽視の失敗
DevOps導入には、進め方とセキュリティに特有の失敗があります。複数の施策を一度に変えて、頓挫してしまう例もあります。
自動化の速さを優先して、セキュリティが置き去りになる例もあります。どちらも、計画段階の認識が甘いと陥りやすい落とし穴です。
一度に全部変えようとして頓挫する失敗
CI/CDやIaCなどを一気に導入すると、現場が消化しきれず頓挫する場合があります。原因は、新しいツールとプロセスを同時に大量に持ち込むことです。
学習が追いつかず、日々の開発も滞ってしまいます。意気込みが空回りして施策が中途半端なまま定着せず、「DevOps疲れ」で改革そのものが頓挫することもあります。
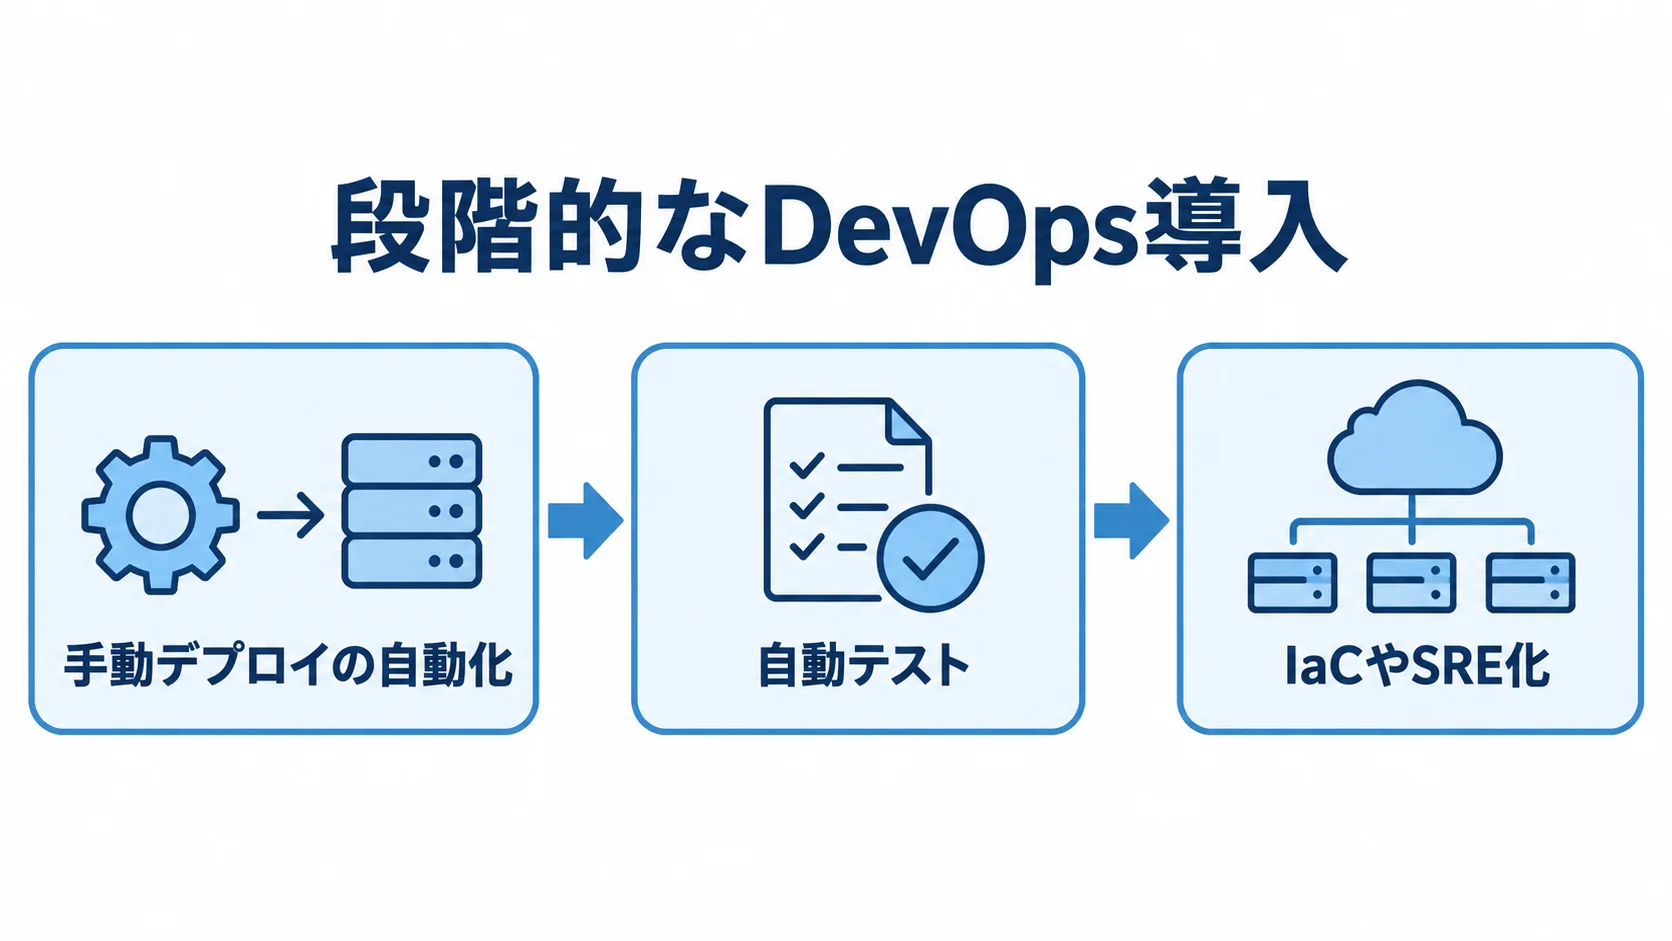
失敗を防ぐ定石は、段階的に導入することです。たとえば、効果の大きい一点である手動デプロイの自動化から始め、定着してから次の施策へ進みます。
- まずは、手動デプロイの自動化から始めます。
- 定着して効果を実感できたら、自動テストに進みます。
- その後、IaCやSRE化へと段階を踏んで広げていく流れです。
一次データでは、この順に進めて成果を上げた事例も見られます。小さな成功体験がチームの納得感を生み、改革を続けやすくします。
完璧な体制を一足飛びに目指すと、かえってDevOps化が頓挫します。目標は高く持ちつつ、一歩ずつ定着させることが大切です。
セキュリティを後回しにして脆弱性を量産する失敗
セキュリティ軽視も、見落とされやすい失敗です。リリース速度を優先して脆弱性チェックをパイプラインに組み込まないまま高速にデプロイすると、脆弱なコードが本番に届いてしまいます。
速さと引き換えに安全を損ない、重大なインシデントにつながる危険があります。自動化の恩恵が、裏目に出る失敗でもあります。
開発の早い段階からセキュリティを組み込む考え方が「DevSecOps」です。具体的には、パイプラインにセキュリティスキャンを自動で組み込みます。
- 検査の自動化:脆弱性を検知したら、デプロイを止める仕組みです。
- 早期の組み込み:セキュリティを自動化の流れに含めることです。
一次データでは、CI/CD・コード管理・セキュリティスキャンのDevOps系SaaSが月数万円規模で提供され、パイプラインへの組み込みが推奨されています。
セキュリティは、最初から自動化に織り込んでおくことで、速さと安全の両立につながります。
まとめ
DevOpsの失敗は、文化が変わらないこと、テストや可観測性が不足していること、IaC・コンテナの属人化や過剰設計に起因します。トイルの温存や、知識移転のない委託も要因になります。
強い体制は、文化やプロセスを変えるところから、運用や組織まで踏み込んで初めて生まれ、リリース速度と品質を高められます。これらは、事前に知っていれば避けられた失敗です。
回避には、責任共有の文化、自動テストと可観測性、標準化されたIaCと適切な構成が必要です。そのうえで、トイルを自動化し、SLOで運用目標を定めます。
さらに、伴走によるスキルトランスファーで内製化を進めます。riplaは、フルスクラッチ受託と国内開発を組み合わせ、DevOps体制づくりを支援しています。
全体像を確認したいときは、あらためて完全ガイドをご覧ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。