
名寄せシステムは、標準化とマッチング、代表レコードの管理、人手による確認を組み合わせることで、複数のシステムにある同一の対象を共通IDでまとめて把握できる仕組みです。
全体像、種類、主要機能、開発の進め方、費用、発注先の選び方の順に解説し、各テーマの詳細は関連記事で確認できます。
▼関連記事一覧
・名寄せシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・名寄せシステム開発でおすすめの開発会社/ベンダー6選と選び方
・名寄せシステム開発の見積相場や費用/コスト/値段について
・名寄せシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
名寄せシステムの全体像
名寄せの目的は、同じ対象を一つの視点で把握できる状態をつくることです。たとえば、営業部門の顧客情報、サポート部門の問い合わせ履歴、ECの購入履歴が別々に管理されている場合は、共通IDで関連付けることで、顧客単位の売上や接点を分析できます。
法人の場合は、正式名称や略称、旧社名のほか、本社・支店・グループ会社の関係まで整理すると、取引先全体の実態を見やすくなります。さらに、名寄せは重複を消す作業にとどまらず、元データを残したまま、統合の根拠と変更履歴まで管理する仕組みです。
名寄せシステムの定義と仕組み
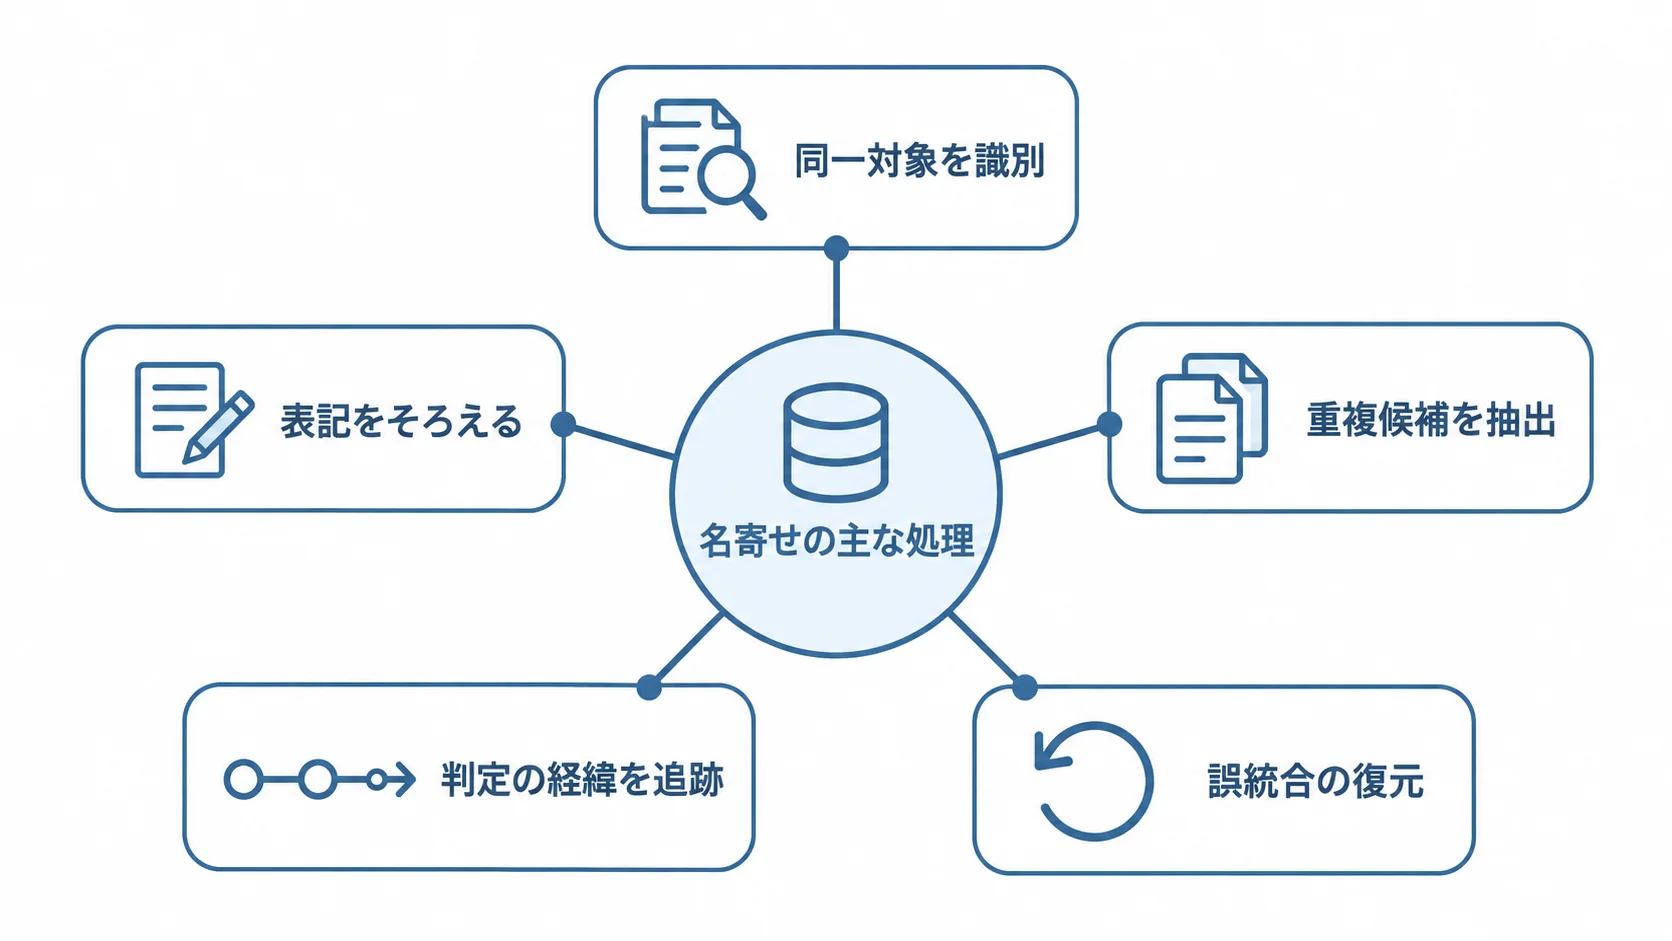
名寄せの仕組みは、対象の判定、元データの扱い、誤統合への備えという観点で分けて見ると整理しやすくなります。
- 同一対象を識別:人物・法人・世帯・商品などを判定し、統合IDや関係性を付けます。
- 表記をそろえる:全角・半角、旧字体・新字体、住所、電話番号の記号、法人格の書き方を統一する処理です。
- 重複候補を抽出:標準化したあとのデータで、完全一致、ルール一致、あいまい一致を組み合わせて判定します。
- 判定の経緯を追跡:代表値、元レコード、判定項目・日時・担当者を後から追えるようにします。
- 誤統合の復元:元データは消さずに残し、誤りが見つかった場合は統合を分けて戻せるようにします。
5つの処理を一続きで持つことで、データの関係を管理する業務基盤になります。
名寄せが必要になる背景
名寄せが必要になる背景は、登録の分散と、業務や分析への影響から確認できます。
- システムが分散:システムが増えると、同じ対象が異なる形式で登録されます。
- 重複と表記ゆれ:取引先データの重複経験は83.5%、表記ゆれは82.2%でした(企業のデータ管理実態調査、2025年)。
- 業務への影響:同じ顧客への重複案内、別人と誤認した営業連絡、法人単位の売上の過小評価が起こります。
- 分析の土台:名寄せは分析や自動化の前に整えておく基盤です。誤ったデータは、AIや分析基盤の回答や予測精度にも響きます。
企業のデータ管理に関する実態調査(2025年)は、情報システム担当者708人を対象にしたものです。また、利用システムは平均23.3個、取引先情報のシステムは平均10.6個でした(出典:同調査)。
名寄せシステムの種類と選び方
名寄せには、データを一度だけ整える方法と、日々の登録・更新まで継続して管理する方法があります。
適切な方式は、対象件数や更新頻度に加えて、誤統合をどの程度許容できるか、既存システムを残すか、誰が判定ルールを管理するかによって変わります。
導入後の責任範囲まで比べることも、機能の多さと同じくらい大切です。
一回限りのクレンジング・名寄せ
一回限りの作業は、過去データを整える用途と、継続運用へ移る条件の両方を押さえて検討します。
- 向く用途:M&A後の統合、システム移行、名簿整理、CSVの重複除去などが対象になります。
- 作業の流れ:複数のファイルを標準化し、候補を抽出したうえで、統合マスターや対応表を納品します。
- 対象範囲:日々の新規登録は対象にせず、過去データを短期間で整える用途に向いています。
- 再発防止:別の表記で登録されると重複が再び生じるため、登録時の候補表示、標準化、更新ルールの文書化が必要です。
- 段階導入:数万件程度で効果を見たい場合は、単発の作業から継続運用へ移ることもできます。
継続運用する名寄せシステム
継続運用型は、新規登録・更新・連携のたびに名寄せを実施し、統合顧客IDや法人IDを各システムへ返す仕組みです。
この型では、登録時に完全一致を確認し、類似度が中間の候補は担当者が見て、確度の高い候補だけを自動で処理する構成にすると、処理量と安全性を両立しやすくなります。
継続型には、専用パッケージやクラウド基盤を使う形、既存のDWH・ETLに機能を追加する形、業務画面や承認を含む個別開発があり、この中から選びます。さらに、複数部門で使う場合は、共通ID配布、連携再送、ルール版管理も確認します。
名寄せシステムの主要機能
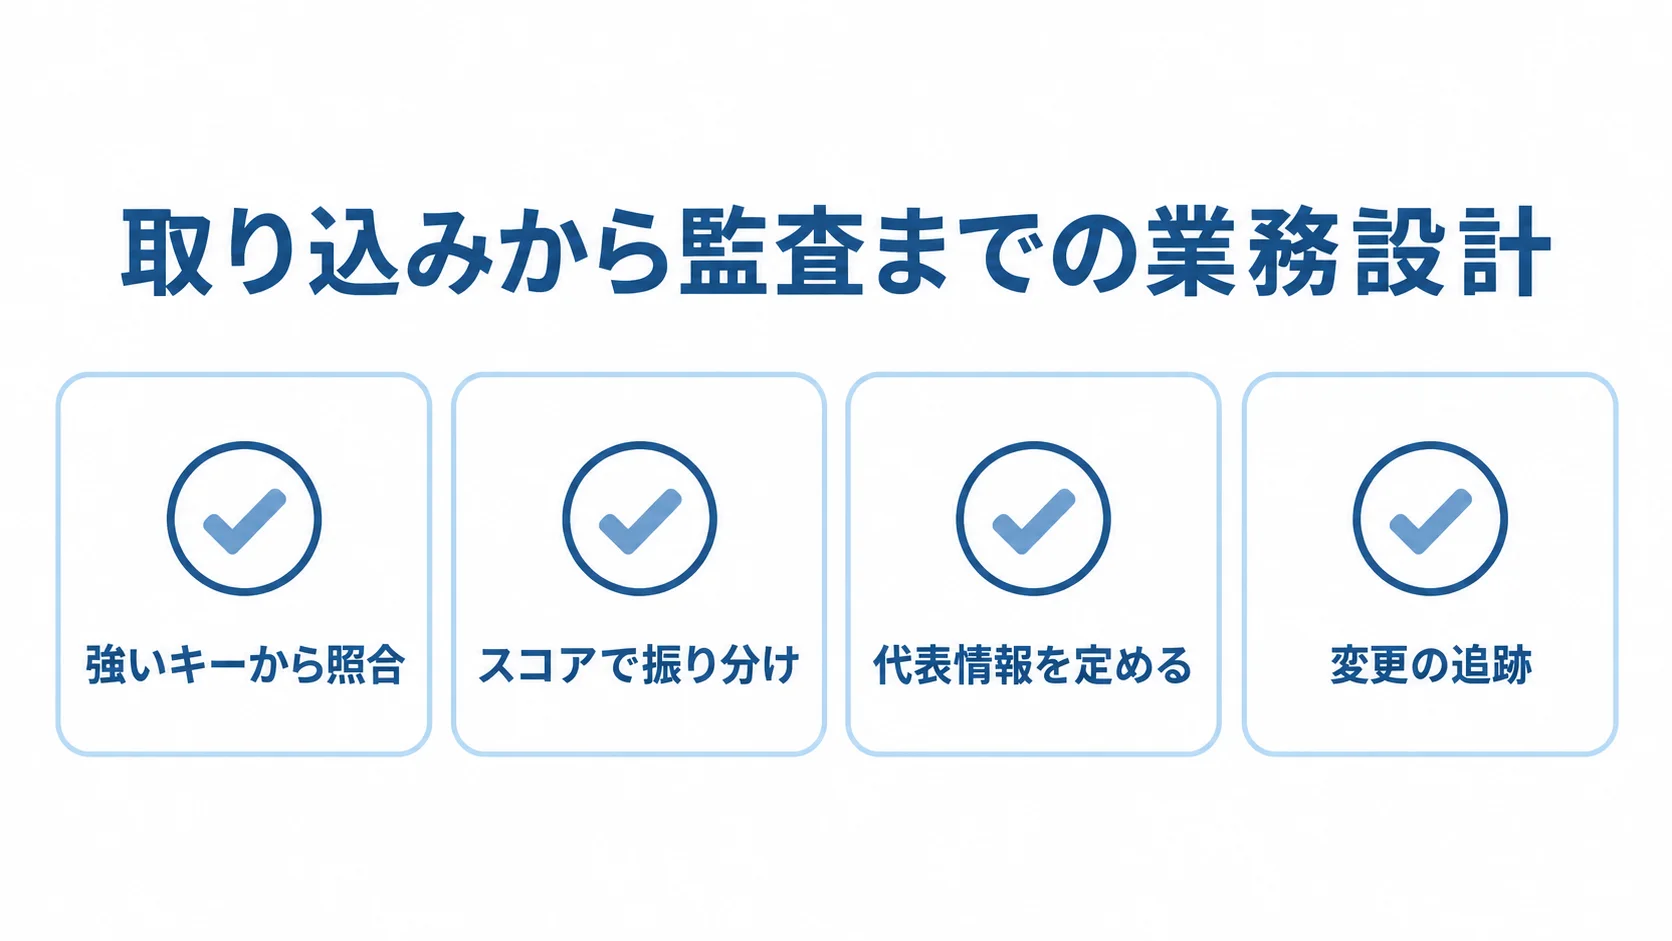
名寄せの精度は判定アルゴリズムだけで決まらず、取り込みから監査までを一続きの業務として設計してはじめて、現場で使える仕組みになります。
要件に、この節で扱う機能が含まれているかを確認してください。
標準化とマッチング
標準化と照合では、入力値をそろえる作業と、一致度に応じた判定方法を確認します。
- 個人情報をそろえる:氏名の空白や旧字体、住所表記、番地記号、電話番号、メールの大小文字を揃えます。
- 法人情報をそろえる:法人格、旧社名、支店・営業所の表記、法人番号を扱う場合があります。
- 元の値も保持:標準化の前後の値を残し、担当者が元データを確認できるようにします。
- 強いキーから照合:法人番号や会員番号を先に使い、そのあとに電話、メール、住所、氏名を組み合わせます。
- スコアで振り分け:あいまい一致では、高スコアは自動処理、中間帯は確認、低スコアは別人として扱う設計が一般的です。
スコアの閾値は、データの性質と業務リスクに応じて、検証を通じて決めます。
ゴールデンレコードと人手確認
代表情報の決め方と、機械だけでは確定させない境界を整理します。
- 代表情報を定める:同一対象の複数レコードから、業務で参照する値を選びます。
- 項目別に採用基準を決める:更新日や情報源の信頼度を使い、住所は最新、法人名は公式、連絡先は本人確認済みを優先します。
- 曖昧な候補の扱い:同姓同名、同住所の家族、本支店、グループ内の別法人は、機械で統合すると事故につながるため、人が判断する対象です。
- 判断材料を表示:判定理由、元レコード、差分、スコアを示し、承認・却下・保留を記録します。
- 変更の追跡:統合後の分割・復元、操作履歴、ルール変更履歴を残します。
名寄せシステム開発の進め方
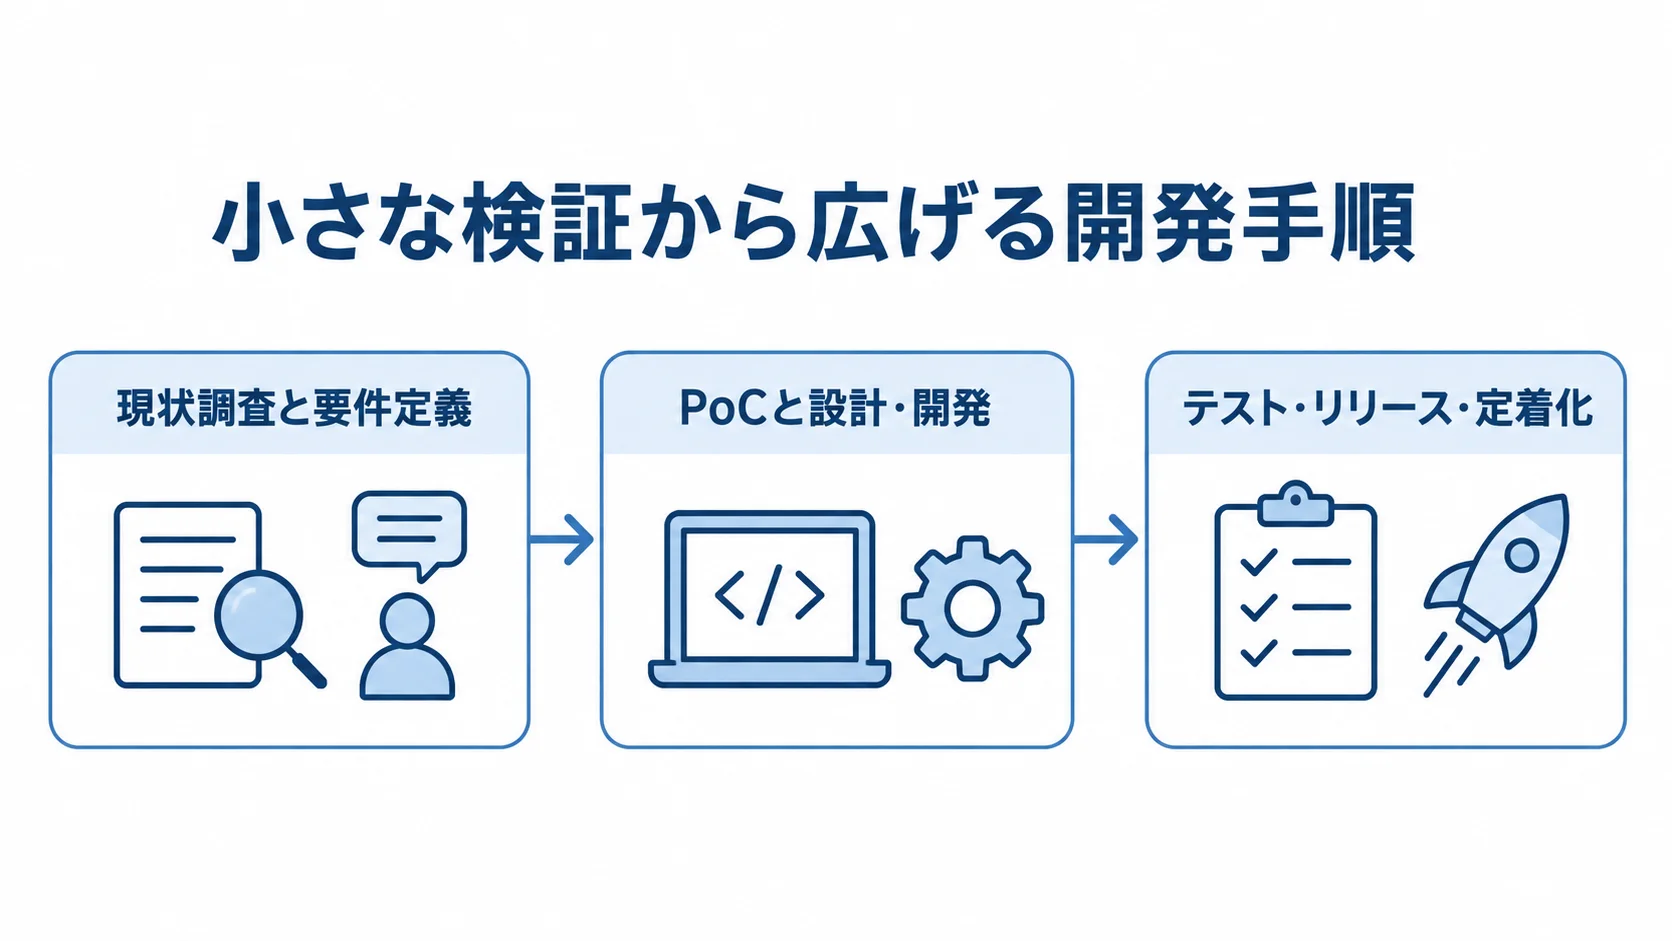
名寄せシステムは、いきなり全社データを統合するより、対象を絞って正解データを作り、精度と業務効果を確かめながら広げる方が安全です。
特に、データの中身を確かめないまま見積もりや製品選定を始めると、後から例外処理と連携改修が膨らみます。こうした手戻りを避けるため、開発では、データ調査と業務ルールの合意を最初に行います。
▶ 詳細はこちら:名寄せシステム開発の進め方/やり方/流れや方法/手法/工程/手順
現状調査と要件定義
要件定義では、まず対象データを洗い出し、次に業務KPIを設定します。
- 対象を一つ選ぶ:顧客・法人・世帯・商品など、名寄せするドメインを定めます。
- データの中身を洗い出す:ソース、件数、項目・型、欠損・重複率、更新頻度、管理部門、連携方式、個人情報を含むかどうかを確認します。
- 例外データを確認:正常例、表記ゆれ、住所変更、同姓同名、欠損を含むサンプルで、ルールを定めます。
- 業務KPIを設定:集計時間、二重接触・発送、候補確認時間、未判定・誤統合、連携エラーを測ります。
- 許容水準を合意:誤統合率を下げるほど人手確認が増えるため、業務ごとの基準を責任者と決めます。
PoCと設計・開発
PoCから本開発へ進む際は、精度の検証結果を設計に反映します。
- 代表サンプルでPoC:正解データを人手で作り、完全一致、ルール一致、あいまい一致を順に試します。
- 精度を測定:適合率、再現率、未判定率、誤統合件数を確認します。
- AIの利用範囲を決める:学習データの偏りと説明可能性を見て、候補提示か自動統合かを判断します。
- 本開発を設計:データモデル、共通ID、ルール、代表レコード、画面、権限、監査ログ、連携、再処理を定めます。
- 移行と既存連携を検証:既存システムを替えない場合は、名寄せ基盤を中間層に置き、元IDと共通IDの対応表を各システムへ返します。
全件移行の場合は、移行前後の件数差と業務への影響も検証します。
テスト・リリース・定着化
導入時は、テスト、段階的なリリース、運用への定着という順で進めます。
- 正常と例外をテスト:正常系に加えて、同姓同名、同住所の別人、本支店、旧住所、番号変更、空欄、外字、文字化け、連携遅延を確認します。
- 受入条件を確認:担当者が判定理由を理解でき、誤りを取り消せて、権限外のデータを見られないことを確かめます。
- 限定して段階導入:対象部門やデータソースを絞ってリリースします。
- 運用担当者を決める:データスチュワードが、ルールや辞書の更新、例外、復元、連携エラーを管理します。
- 品質を継続確認:担当者の経験だけに頼らないよう、月次でKPIを確認し、ルールを版ごとに管理します。
名寄せシステムの費用相場と内訳
名寄せシステムの価格は、データ件数に加えて、対象項目やデータソース数によって大きく変わります。さらに、辞書の種類、人手確認の量、連携方式、セキュリティ要件も価格を左右します。
公開価格が少ない領域のため、ここに示すのは、2025〜2026年時点のデータ管理システムの公開相場と、名寄せに必要な追加作業を組み合わせた予算検討用の目安です。実際の発注額を保証するものではありません。
▶ 詳細はこちら:名寄せシステム開発の見積相場や費用/コスト/値段について
案件タイプ別の予算目安
案件タイプごとの費用は、対象範囲と期間を合わせて見ると比べやすくなります。
- 一回限りの処理:50万〜300万円程度が目安です。
- 小規模な継続型:300万〜1,000万円、期間は3〜6か月です。
- 中規模の統合基盤:1,000万〜3,000万円、期間は6〜12か月です。
- 全社MDM・複数ドメイン:3,000万〜1億円以上、12〜24か月以上の場合があります。
- 公開相場:2025〜2026年のデータ管理システム開発情報も参考にします。
一回限りの作業の目安は、数万〜数十万件、CSV数本を扱い、氏名・住所・電話番号を標準化して候補リストを作る場合です。
一回限りの作業でも、人手確認や住所辞書、法人番号付与、複数回の再処理、納品後の修正が増えると、300万〜800万円程度になることがあります。
小規模型は、1ドメイン、2〜3システム、数万〜数十万件を扱うバッチ、管理画面、権限、CSVまたはAPI連携を想定しています。
中規模は、複数部門、4〜10システム、承認フロー、ゴールデンレコード、品質ダッシュボードを含む場合を指します。
全社型では、国内外の拠点、基幹連携、高可用性、移行リハーサル、ガバナンス、継続運用体制が必要です。
初期費用とランニングコストの内訳
初期費用と継続費用は、作業範囲と利用条件ごとに分けて確認します。
- 設計とデータ準備:現状調査・データプロファイリング、共通ID・データモデル、正規化辞書・名寄せルールを確認します。
- 実装と移行:候補判定、人手確認画面、連携・移行、権限・監査・暗号化を見積もりに含めます。
- 導入後の対応:テスト・教育、運用保守の費用も確認します。
- クラウド利用料:小規模は月5万〜30万円、中規模は月30万〜100万円以上が目安です。
- 従量課金と継続費:従量課金の条件を確かめます。全件再処理、候補確認、辞書メンテナンス、監視、バックアップ、データ移行費は、毎月積み上がることがあります。
名寄せでは、システム本体よりも、データの例外整理と既存システムとの連携に工数がかかることがあります。
クラウド料金は、件数や処理頻度に加えて、API回数、環境数、辞書更新、ログ保管、サポートでも変わります。
名寄せシステムの開発会社・ベンダーの選び方
発注先は、製品の機能だけでなく、対象データを理解し、誤統合を防ぐ業務設計まで伴走できるかどうかで選びます。
製品提供、データクレンジングの受託、導入支援、個別開発は役割が異なるため、同じ条件で単純に比べないことが大切です。
自社が一回限りの整理をしたいのか、日々のデータ品質を管理したいのかを、まず決めてください。
実績と対象データの適合性の確認
委託先の実績は、自社データとの適合性と、ルールや辞書などを次の担当者へ引き継げるかで確かめます。
- 対象データの種類:件数だけでなく難しさも確認します。個人の氏名・住所と、法人の本社・支店・グループ関係は別の経験です。
- 事例との適合性:顧客、会員、取引先、世帯、商品など、自社の対象に近い事例や、表記ゆれ・更新頻度への対応経験を質問します。
- 精度の定義:「精度99%」でも、何を正解とするか不明なら比較できません。
代表サンプルで正解データを作り、適合率・再現率・未判定率・誤統合率を測れるかを確認します。あわせて、ルール、辞書、対応表、ログ、テスト結果、運用手順書の有無も確認します。これらは、内製化や乗り換えに関わる確認項目です。
技術・連携・運用体制の比較
比較では、技術的な接続に加えて、運用開始後の支援や契約条件も確認します。
- 接続方式:CSV、API、ETL、iPaaS、データウェアハウスとの接続に加え、再実行、差分連携、バッチとリアルタイムの使い分けを見ます。
- 連携後の追跡:共通IDを返す複数システムで、失敗の検知と再送、元IDと共通IDの検索、データ変更の追跡ができるかを確かめます。
- 拡張時の費用:対象の拡張やデータ量の増加に伴う料金を質問します。
- 運用体制:ルールの変更担当者、退職後も運用できる体制か、問い合わせ受付時間、障害対応の目標時間を確認します。
- 契約と導入後の支援:窓口がなく変更のたびに追加費用が発生すると定着しにくいため、RFPに教育、保守、データ消去、契約終了時の移行条件を書きます。
見積もりと提案内容の比較条件
候補先の提案を比べる際は、同じ依頼条件と評価軸を使います。
- 共通の提示条件:対象件数、データソース数、項目一覧、サンプルの有無、許容誤統合率を候補先へ示します。
- 同じ依頼資料:希望納期、個人情報の取扱条件、既存システムを残す範囲、運用担当者も記載します。
- 費用の内訳:現状調査、PoC、開発、移行、教育、保守に分けて、前提条件と除外事項を確認します。「データ整備一式」は追加費用につながることがあります。
- 提案内容:機能表より、曖昧候補の自動統合・要確認・非統合の基準、取消・配信・障害復旧の方法を比べます。
- 総保有コスト:最安値だけで決めず、業務リスクと将来の運用費を含めて判断します。
▶ 詳細はこちら:名寄せシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:名寄せシステム開発の発注/外注/依頼/委託方法について
名寄せシステムのセキュリティとデータガバナンス
名寄せでは、氏名・住所・電話・メール・取引履歴などの個人データや機密法人情報を扱う場合があります。
利便性を優先して一か所に集めるほど、漏えい時の影響範囲は大きくなります。そのため、設計の段階で、目的、閲覧者、保持期間、委託先・再委託先、処理後の消去方法を決めておきます。
最低限確認したい安全管理措置
安全管理措置は、社内アクセス、委託先、クラウド利用の観点から確認します。
- アクセス制御:権限を役割と業務上の必要性に応じて最小限にし、管理者には多要素認証を設定します。
- 保護と復旧:通信と保存時の暗号化、環境の分離、アクセスと変更のログ、バックアップ、復旧テストを実施します。
- 画面表示:候補確認画面には必要な差分だけを表示し、全件ダウンロードを標準機能にしない設計も検討します。
- 委託先管理:安全管理措置の内容と、作業後の消去証明を求めます。
- クラウド利用:保存地域、バックアップ、管理者権限、ログ保持期間、サービス終了時の返却・消去を確認します。
再委託条件、事故時の連絡、監査、保存場所、保持期限も契約で定めておきます。また、個人情報保護委員会の通則ガイドラインは、委託先の選定、契約、取扱状況の把握による監督を示しています。
2026年のデータ連携・AI活用の動向
データ連携とAIの活用では、共通設計と最終判断の管理が論点になります。
- 企業間連携の設計:2026年3月に、企業間データ連携の共通要件や設計方針をまとめた手引きが公開されました。
- 初期設計で決める事項:連携に必要な共通事項の範囲と内容を定めます。
- AIの活用:表記ゆれの候補提示、類似レコードのスコア計算、判定理由の要約に使えます。
- AIの統合判断:AIだけで個人や法人を自動統合すると、誤りの説明や取消が難しくなります。
- AI利用時の管理:利用目的、ログ、評価用の正解データ、人の承認、モデル変更時の再検証を定め、最終判断の責任者を明確にします。
名寄せでは、共通識別子、データモデル、連携先の責任範囲、データの信頼性を、導入の早い段階から決めておきます(出典:データ連携の仕組みに関するガイドラインの手引き、2026年)。
導入後の運用とKPI
名寄せは、導入の日に完了するものではありません。システム追加や住所変更、法人統廃合、入力ルールの変更で判定結果や代表情報が変わるため、定期的な再処理と、日々の登録時のチェックで変化に追随します。
日々の登録と例外処理の管理
登録時の通常処理に加えて、例外や訂正を元に戻す運用まで決めておきます。
- 登録時の確認:強い識別子と既存情報を照合し、重複候補を登録者へ知らせます。
- 例外候補の判断:自動統合できない候補は、業務を理解した担当者が確認します。
- 確認待ちの管理:優先度、期限、担当部門を設定し、差し戻しや保留の理由を記録します。待ち件数が増えると処理が滞ります。
- 訂正・誤統合の復旧:本人や取引先からの訂正依頼では元データを残し、代表情報と関連IDを修正します。誤統合は影響先を特定し、復元後に再配信します。
- 直接編集への対策:直接編集は履歴が残らず、次回の処理で上書きされるおそれがあるため、承認ワークフローと変更履歴を持たせます。
成果と品質を測るKPI
導入効果は、データ品質と業務上の変化を分けて測定します。
- 品質指標:重複率、誤統合率、未判定率、候補確認時間、欠損率、標準化できない値の割合、更新遅延、連携エラー率を設定します。
- 業務効果:顧客単位の集計時間、二重接触、重複発送、検索時間、レポート作成時間を測り、同じ定義の月次推移を導入前と比較します。
- 効果額と原因分析:KPIを金額に換算し、悪化したときは原因を追跡します。
たとえば、月間の二重接触が400件から120件に減れば、削減効果は280件です。この削減数に、1件あたりの確認・再対応時間や顧客への影響を掛けると、業務改善の金額を試算できます。
KPIが悪化したときは、データソース、入力ルール、辞書更新、閾値のどれが原因かを、処理ログと変更履歴で追います。
名寄せシステムのよくある質問(FAQ)
名寄せシステムの導入では、既存システムを変更する必要があるか、AIで完全に自動化できるか、費用がどの程度かかるかが、よく質問されます。
初めて検討する方が判断しやすいよう、代表的な疑問に直接答えます。
名寄せシステムは小規模な会社でも導入できますか?
小規模な会社でも導入できます。まずは全社統合を目指さず、顧客・取引先の1ドメイン、2〜3システムに絞って、CSVの定期処理や登録時の重複確認から始めます。重複率、確認時間、二重接触を測って成果を確かめてから広げれば、費用と運用負荷を抑えやすくなります。
既存のCRMや基幹システムを入れ替えずに名寄せできますか?
既存システムを入れ替えず、名寄せ基盤を中間層に置けます。元IDと共通IDを対応表で管理し、必要な情報だけを各システムへ返す構成です。
連携方式、APIの有無、更新頻度、既存データの修正範囲によって設計が変わるため、データソースと連携の制約を初期段階で調べてください。
AIで名寄せを完全自動化できますか?
技術的には自動化の範囲を広げられますが、すべての判定をAIへ任せることは推奨されません。
法人の本社と支店、同姓同名の個人、同一住所の家族などは、誤統合の影響が大きくなります。そのため、AIや類似度スコアは候補の提示に使い、境界値の候補は人が確認する設計が安全です。
自動処理の範囲は、正解データで精度を測定してから決めます。
名寄せシステムの費用を抑える方法はありますか?
対象ドメインを一つに絞り、最初はCSVのバッチ処理から始めると、初期開発の範囲を小さく保てます。
利用しない機能は先に作らず、代表サンプルでPoCを実施して、必要なルールと確認画面を確定してから開発します。一方で、誤統合の復元、監査ログ、権限、データ消去などの機能は、安全性を保つうえで欠かせません。
安全性を保つ機能を削ると、将来の手戻りや事故対応の費用が大きくなるため、優先順位を分けて判断してください。
名寄せシステム完全ガイドのまとめ
名寄せシステムは、複数の業務システムにある同一対象を共通IDで結び付け、顧客・取引先・法人などを正確に把握するための基盤です。
標準化、マッチング、候補確認を中心に、一つの運用として設計します。ゴールデンレコードや連携、監査、品質モニタリングも同じ運用に含め、そのうえで、元データを残したまま統合・復元できる状態をつくります。
導入前に押さえる3つのポイント
第一に、名寄せは、共通IDと判定根拠を管理する仕組みとして捉えます。
第二に、誤統合を防ぐため、確実な候補の自動処理と、境界値の人手確認を分けて設計します。
第三に、費用は、システム本体に加えて、データ調査、辞書、連携、運用、セキュリティまで含めて判断します。
最初に取り組むべきこと
導入の初期段階では、対象範囲を絞って検証し、結果を費用と発注先の判断につなげます。
- 対象と検証:範囲を絞った検証から始め、結果を見て対象を広げます。
- 導入の流れ:対象ドメインとKPIを絞り、データの中身を洗い出したうえで、PoCにより精度と誤統合リスクを測定します。
- 費用目安:一回限りのクレンジングは50万〜300万円程度、小規模な継続型は300万〜1,000万円程度、中規模は1,000万〜3,000万円程度です。
- 発注先の比較:条件を揃え、実績や運用・セキュリティで比べます。
最初は、顧客または取引先の一つのドメイン、2〜3システム、代表サンプルに絞り、重複率と誤統合率を測ります。小さく検証してから対象を広げると、現場で使えるルールと運用体制を作りやすくなります。
金額は、連携、辞書、人手確認、運用の内容によって変わります。そのため、発注先を比べる際は、対象データの実績、判定理由、復元方法、セキュリティ、運用体制、契約終了時のデータ移行を同じ条件で見ておきます。
▼関連記事一覧
・名寄せシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・名寄せシステム開発でおすすめの開発会社/ベンダー6選と選び方
・名寄せシステム開発の見積相場や費用/コスト/値段について
・名寄せシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。