
名寄せシステム開発は、要件整理から定着までを6フェーズで進みます。データ棚卸しから始め、判定を正解例で検証し、段階的に移行して定着させます。
正解例での検証と段階移行を経ると、誤統合を抑えた共通ID基盤につながります。全体像は名寄せシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・名寄せシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
名寄せシステム開発の全体像
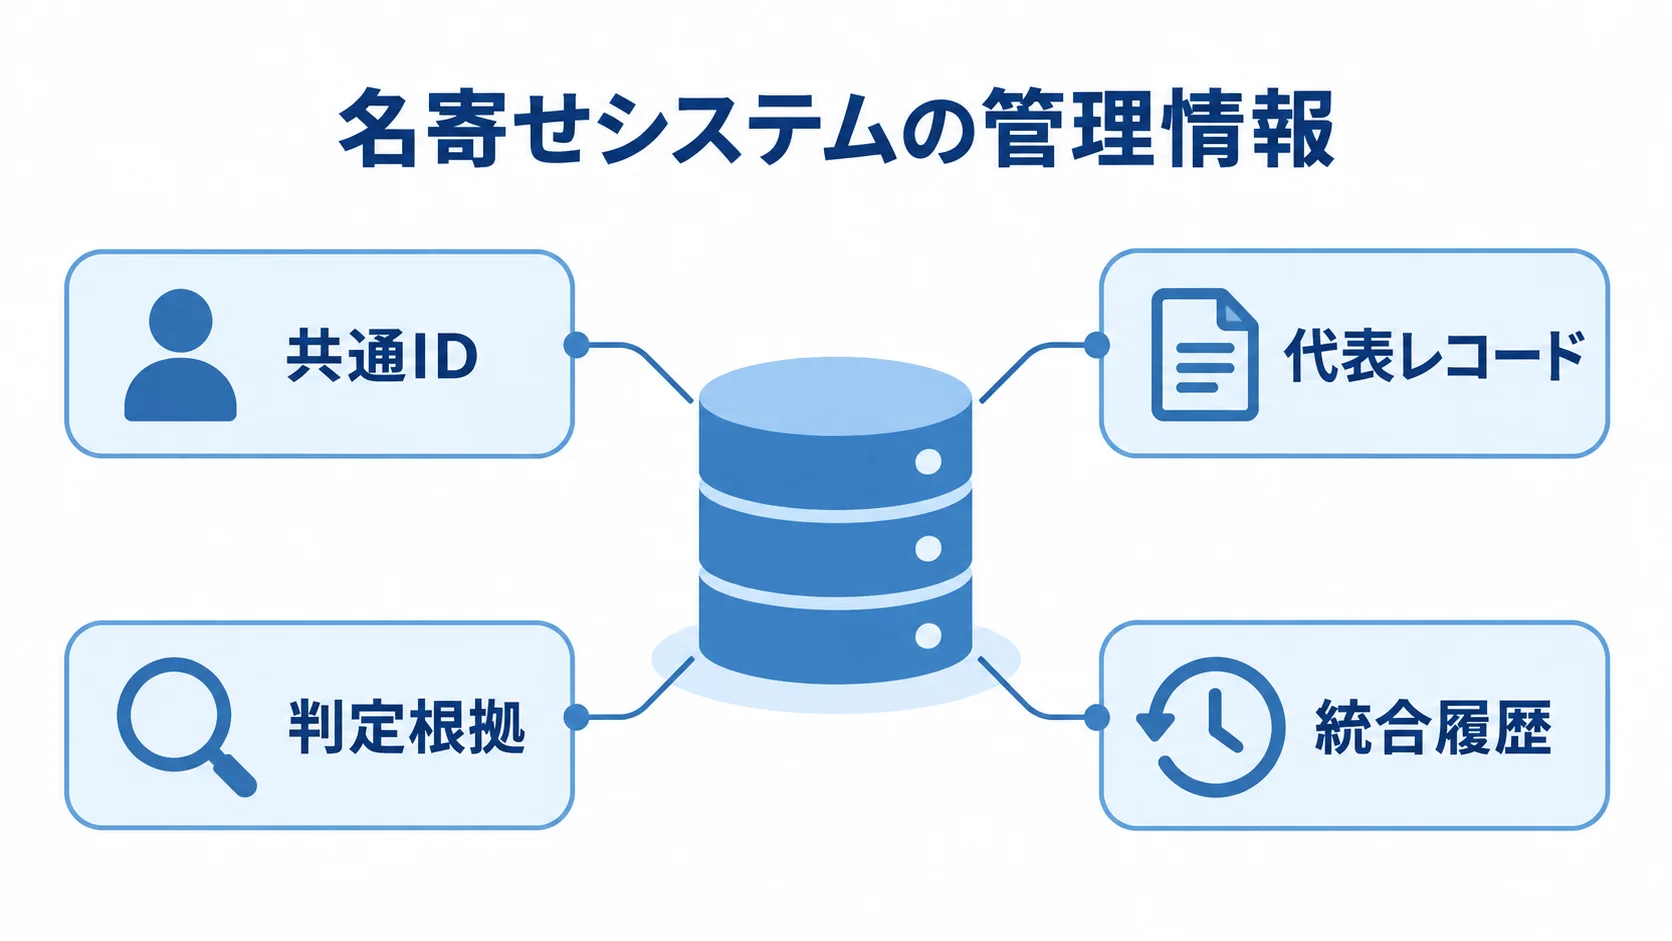
名寄せは、重複を削除するだけでなく、元のレコードを残したまま同一の人物や法人を判定する仕組みです。この仕組みでは、共通IDや代表レコードに加えて、判定根拠と統合履歴も管理します。
名寄せ開発の成否は、判定アルゴリズムに加えて、対象範囲や責任者、人手確認、統合後の各システムへの反映まで設計できているかで決まります。
名寄せシステムの定義
名寄せシステムは、CRM、SFA、ERP、ECなどに分散したデータから、同じ対象を識別します。会員DBや名刺管理、ExcelやCSVも対象に含まれます。識別した対象は、共通のエンティティIDで管理します。
たとえば、「株式会社ripla」「(株)ripla」「ripla Inc.」を同一法人と結び付けたり、住所変更の前後の顧客を関連付けたりします。ただし、同姓同名の別人、同居家族、本社と支店、親会社と子会社は、似ていても同一とは限りません。そのため、高確信度の候補だけを自動統合し、境界にある候補は担当者が確認します。
名寄せシステムの基本機能は、取り込み、標準化、候補抽出、判定・統合、ゴールデンレコード管理、配信です。
- 代表値:統合後に、どのレコードの値を採用するかの取り決め。
- 復元:統合の取り消しやレコード分割への対応。
- 監査:ルールの変更者と変更時点の記録。
- 品質管理:権限、監査、品質モニタリングの仕組み。
名寄せシステムが必要とされる背景
データが分散すると、同じ取引先へ複数の営業担当が接触したり、顧客別の売上や問い合わせを正確に集計できなかったりします。
Sansan株式会社の「企業のデータ管理に関する実態調査」(2025年)では、企業は平均23個のシステムを利用しています。さらに、取引先情報は平均11個のシステムで管理されており、回答企業は重複83.5%、表記ゆれ82.2%、更新漏れ81.8%を経験したと答えています。
名寄せで整えたデータは、次の業務改善に活用できます。
- 顧客分析:顧客別の売上を見られます。
- 営業・販促:二重接触やDMの重複発送を防ぎ、休眠顧客を見つけます。
- グループ集計:M&A後の数字をまとめる場面で使えます。
- AI活用:学習・検索に使うデータの品質を高めます。
全社統合を急がず、法人顧客など効果を測りやすい1ドメインから始めれば、費用とリスクを小さくできます。
名寄せシステム開発の進め方
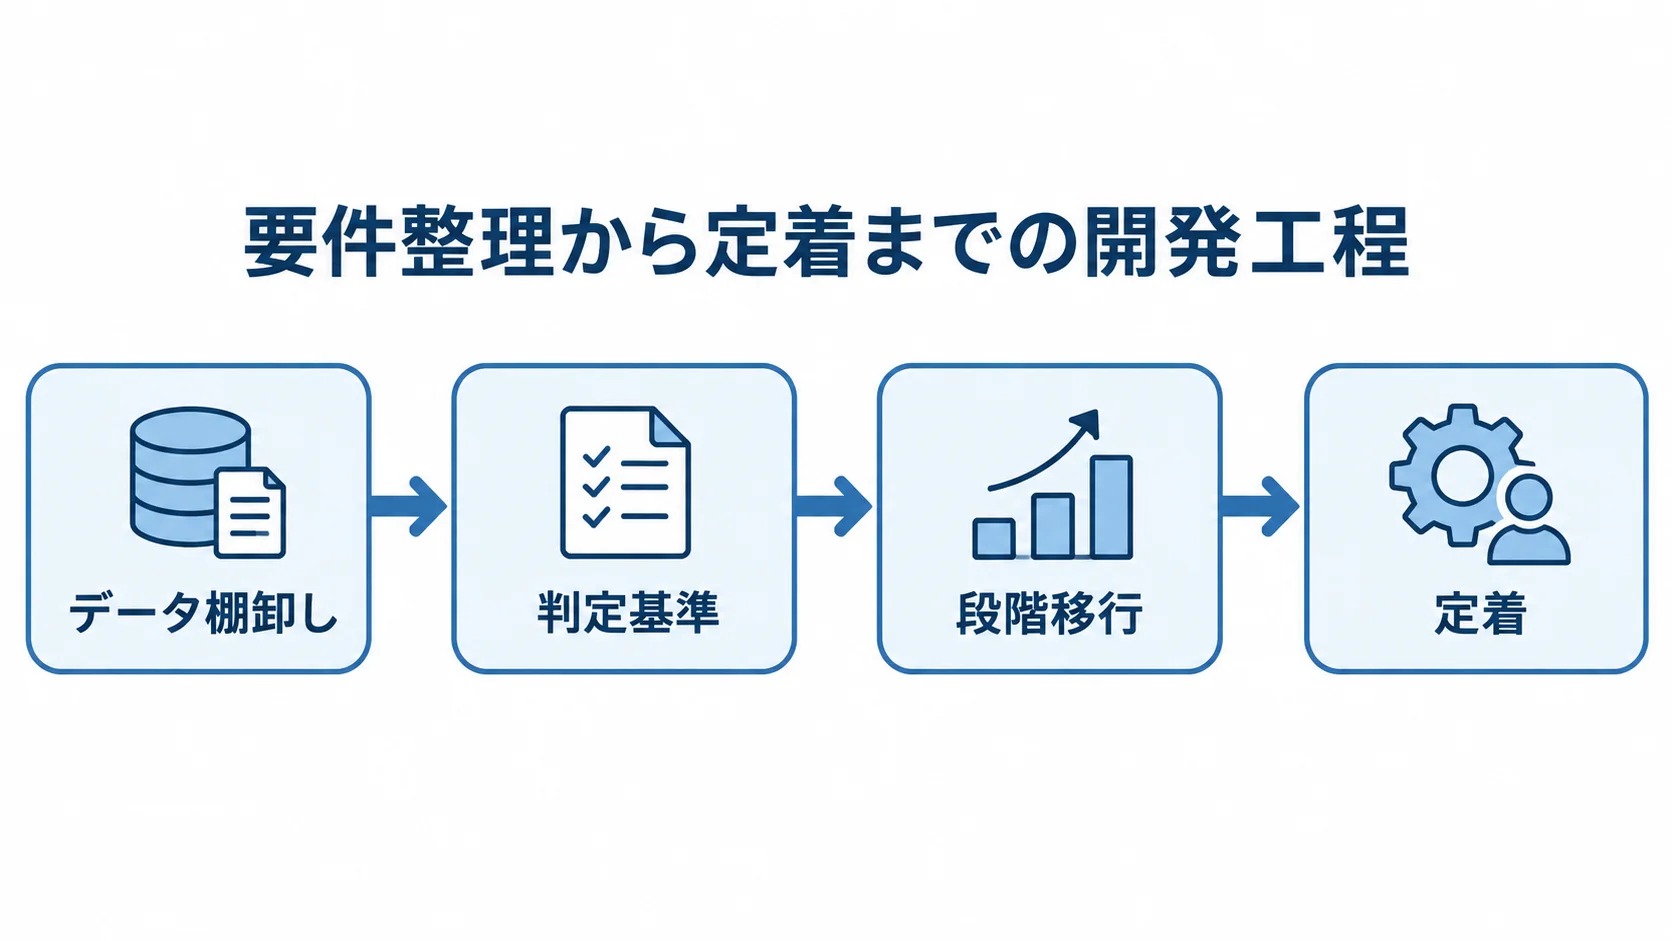
名寄せシステム開発は、要件整理から定着までを6フェーズで進みます。開発に入る前に、現状データを調べ、判定基準を検証しておくと安全です。また、各段階では終了条件を決め、次へ進む前に正解例、未解決事項、責任者を確かめます。
フェーズ1:要件整理とデータ棚卸し
最初に、個人、法人、世帯、商品など、何を同一対象として扱うかを発注側で決めます。対象によって識別項目と誤統合リスクが異なるため、早い段階で定めておきます。
データソースごとに、保有部門、件数、更新頻度、主キーを発注側と開発会社で洗い出します。さらに、項目名、欠損率、表記ゆれ、個人情報の種類、連携方式、責任者も洗い出します。
氏名と住所だけで足りるかは、現物のデータを見てから判断します。見ずに決めると、住所変更や同姓同名の処理で要件が膨らみます。
成果を測るKPIも、この段階で定めておきます。たとえば、重複率を何%まで下げるか、誤統合を何件以下に抑えるかを決めます。また、候補確認時間の削減率や、顧客別レポートの作成時間の短縮幅も目標として設定します。
確認項目は、対象・規模、頻度・精度、運用の観点から洗い出します。
- 対象・規模:ドメイン、データソース数、総レコード数。
- 頻度・精度:更新頻度、許容する誤統合率、要確認件数。
- 運用:統合後の配信先と、その責任者。
自動統合の件数を増やすことより、業務上許容できる誤統合の範囲に収めることを優先します。
フェーズ2:パッケージ・クラウド・スクラッチの選定
選択肢ごとに得意分野と費用負担が異なるため、移行が目的か継続運用が目的かを先に決めます。そのうえで、必要な連携や承認機能を基準に選びます。
- 受託クレンジング:M&Aや名簿統合向けです。日々の重複登録防止は別途設計が要ります。
- 名寄せパッケージ:辞書、候補抽出、ルール管理を備え、短期導入向けです。独自の階層や承認は追加設定が必要です。
- クラウドMDM等:iPaaSやDWHとの連携・拡張向けです。従量課金、データの所在、終了時の移行を確かめます。
- スクラッチ開発:複雑な権限や配信に対応しやすい一方、初期費用と保守負担が大きくなります。
機能表の比較に加えて、安全なサンプルと同じ正解データで判別性能を比べます。完全一致、ルール一致、あいまい一致の判定を検証します。
また、統合の取り消しや分割、判定根拠、辞書更新の扱いを確かめます。さらに、CSV・API・ETL、権限、監査ログも確認します。
発注側は、サポート範囲、成果物の引き渡し、個人情報の消去証明も、同じ質問票で比べます。
フェーズ3:標準化・判定・統合の設計と開発
設計では、表記をそろえる標準化と、同一性を判定するマッチングを分けます。形式をそろえてから判定するため、同じ基準でデータを比べられます。
- 標準化:全角・半角、旧字体・新字体、法人格、空白をそろえる。
- 住所・連絡先:住所、郵便番号、電話、メールの形式を整える。
- 判定キー:法人番号、会員番号などの強いキー。
- 補助判定:電話・メールや氏名・住所のあいまい一致の組み合わせ。
判定に使った項目、元の値、正規化後の値は保存しておきます。後から判定理由を確かめられるようにするためです。
スコアを使う場合は、たとえばスコア帯ごとに処理を定めます。
- 高スコア:自動で統合。
- 中間スコア:人が確認。
- 低スコア:統合せず、候補として残す。
判定の閾値はデータを見て調整するため、開発前には固定しません。
代表レコードは、項目ごとに採用基準を決めます。基準には、最新更新日、業務システムの信頼度、必須項目数などがあります。また、統合ログや分割・復元、再処理、ルール版管理は、初めから設計に含めます。
フェーズ4:正解データを使ったテスト
ランダム抽出だけでは不十分なため、テストデータには通常の表記ゆれに加えて、誤判定しやすい例を意図して含めます。
- 人・住所:同姓同名、同一住所の家族、旧住所。
- 法人:本社と支店、グループ会社。
- 変更・欠損:電話番号の変更、欠損レコード、海外住所。
業務担当者が正解ラベルを付け、結果と照合します。そのうえで、適合率、再現率、未判定率、誤統合件数、候補確認時間を測ります。
機能に加えて、ファイルの欠損・重複、APIのタイムアウト、再取り込み、途中失敗からの再開も試します。さらに、配信遅延、権限外の閲覧、ログ検索、バックアップ復旧も確かめます。
PoCで精度が高くても、本番の更新頻度やデータ量では処理時間が許容範囲を超える場合があります。そのため、受入条件には、精度、処理時間、エラー通知、復旧手順、担当者の操作性を含めます。
フェーズ5:段階的な稼働
全件を一度に統合するより、対象部門やデータソースを限定して段階的に移行するほうが安全です。
初回リリースでは、共通ID付与と候補確認だけに絞る方法も選べます。また、既存データを自動で上書きしない方法もあります。
その後は、確認件数、誤統合の報告、連携エラーを見ながら、配信範囲と自動化率を広げます。
切り替えの前には、複数回リハーサルを行い、バックアップも確かめます。差分を説明できる状態にしておきます。
- 照合する件数:対象、統合、要確認、未統合、配信それぞれの数。
- 当日の体制:問い合わせ窓口と、障害時の停止判断。
- 復旧と教育:ロールバックの方法と、担当者研修の準備。
- 情報管理:個人情報を含む作業ファイルの保管期限の設定。
移行後も運用で対応する課題は、漏れなく課題管理表に登録します。
フェーズ6:ルールとデータ管理の定着
稼働後も、新規登録のたびに重複を確認し、住所や法人情報を更新しながら、定期的に再処理します。
発注側は、データスチュワード(データ品質の責任者)を決め、ルール追加、候補承認、統合取消、辞書更新、異議申立ての担当を明文化しておきます。
月次では、重複率に加えて複数の指標を確認します。なお、AIは候補の提示や類似度の計算を補助させる位置付けにすると安全です。
- 品質:誤統合率、未判定率、欠損率。
- 作業:候補確認の平均時間と、共通ID付与までの時間。
- 連携と履歴:連携エラー、取消件数、最終更新からの日数。
最終統合、例外処理、ルール変更は、業務責任者が承認します。判定理由も、後から確かめられるよう記録しておきます。
名寄せシステム開発の費用相場とコストの内訳
費用は件数だけでなく、データソース、欠損・表記ゆれ、辞書、人手確認で変わります。さらに、連携、更新頻度、セキュリティ、保守範囲によっても変わります。
ここで示すのは、2025〜2026年に確認したデータ管理システムの相場と追加作業から整理した予算目安で、公開価格の一律料金として見るものではありません。
案件タイプ別の費用目安
移行作業と継続システムでは費用の前提が異なるため、規模や追加作業を含めた推定レンジを確認します。
- 一回限り:数万〜数十万件、CSV数本、標準的な氏名・住所・電話番号の正規化と候補リスト作成なら、50万〜300万円程度が推定レンジです。
- 追加作業あり:人手確認、住所辞書、法人番号、再処理、法人階層の整理を含むと、300万〜800万円程度の可能性があります。
- 小規模システム:1ドメイン、2〜3システム、数万〜数十万件で、300万〜1,000万円程度。期間は3〜6か月程度が目安です。
- 中規模基盤:4〜10システム等を含み、1,000万〜3,000万円程度。6〜12か月を見込みます。
- 全社MDM:複数ドメイン、国内外、基幹連携等を含み、3,000万〜1億円以上。12〜24か月以上のケースがあります。
小規模は、バッチ、管理画面、権限、CSVまたはAPI連携を想定します。一方で、中規模は複数部門、ゴールデンレコード、承認、定期連携、品質ダッシュボードを含みます。
全社MDMでは、高可用性、データガバナンス、移行リハーサル、24時間運用も想定します。名寄せ単体の定価ではありません。
株式会社riplaの「データ管理システム開発の見積相場や費用/コスト/値段について」は、データ管理システム全般の予算目安です。そのため、この相場は初期予算の仮置きとして扱い、継続的な重複防止システムは一回限りの移行作業と分けて見積もります。
初期費用の8項目
調査や連携の追加費用は、画面開発費と分けて見ないと見落としがちです。そこで、見積書では4区分、計8項目を確認します。
- 調査・設計:現状調査とデータプロファイリング、データモデルと共通ID設計。
- 辞書・判定:標準化辞書と名寄せルール設計、候補判定と人手確認画面。
- 連携・統制:既存システムとの連携と移行、権限・監査・暗号化。
- テスト・運用:テストや教育、運用保守の範囲。
特に、データ調査と、名寄せ結果を各システムに戻す連携では、工数が増えやすくなります。
期間の目安は、プロファイリングが2〜4週間、PoCが1〜2か月です。また、設計・実装は2〜6か月、移行リハーサルと受入は1〜3か月です。
クラウド利用料や保守費は、対象件数、API回数、辞書更新で変わります。さらに、環境数、監視、問い合わせ対応によっても変わります。
たとえば、小規模なら月5万〜30万円、中規模なら月30万〜100万円以上が予算上の推定レンジです。実際の料金は、必ず提案書の前提条件と照合します。
ランニングコストと追加費用
稼働後は、クラウド基盤の利用料や、データ転送とAPIの費用がかかります。辞書・法人情報の更新、監視、障害対応にも、継続して費用が生じます。ルール変更、人手確認、定期再処理も、運用の作業として残ります。
システムを追加する場合は、接続の設計と受入テストが必要になります。海外拠点を含める場合は、言語、住所体系、法令の確認も欠かせません。
外部委託する場合は、ファイルの受け渡し方法や再委託の扱い、アクセス権を契約に含めます。さらに、保管期限と作業後の消去証明も、契約に含めます。
初期費用が安くても、辞書更新や誤統合の修正が有償だと、運用費が膨らむことがあります。そのため、月額に含まれる条件を明記してもらいます。
- 月額に含む範囲:データ件数、処理回数、サポート時間、SLA。
- 追加費用:追加連携の単価、辞書更新や誤統合修正の費用の扱い。
- 契約終了:データの返却形式と移行支援の内容。
名寄せシステムの見積もりを取る際のポイント
発注先によって対応範囲は異なるため、同じ条件で複数社から見積もりを取り、金額だけでなく成果物と責任範囲を比べます。
候補は、データ整備会社、名寄せ製品会社、導入SIerです。RFPには、現状と正解例、KPIを記します。さらに、連携先、セキュリティ、稼働後の体制も含めます。
要件とサンプルデータの準備
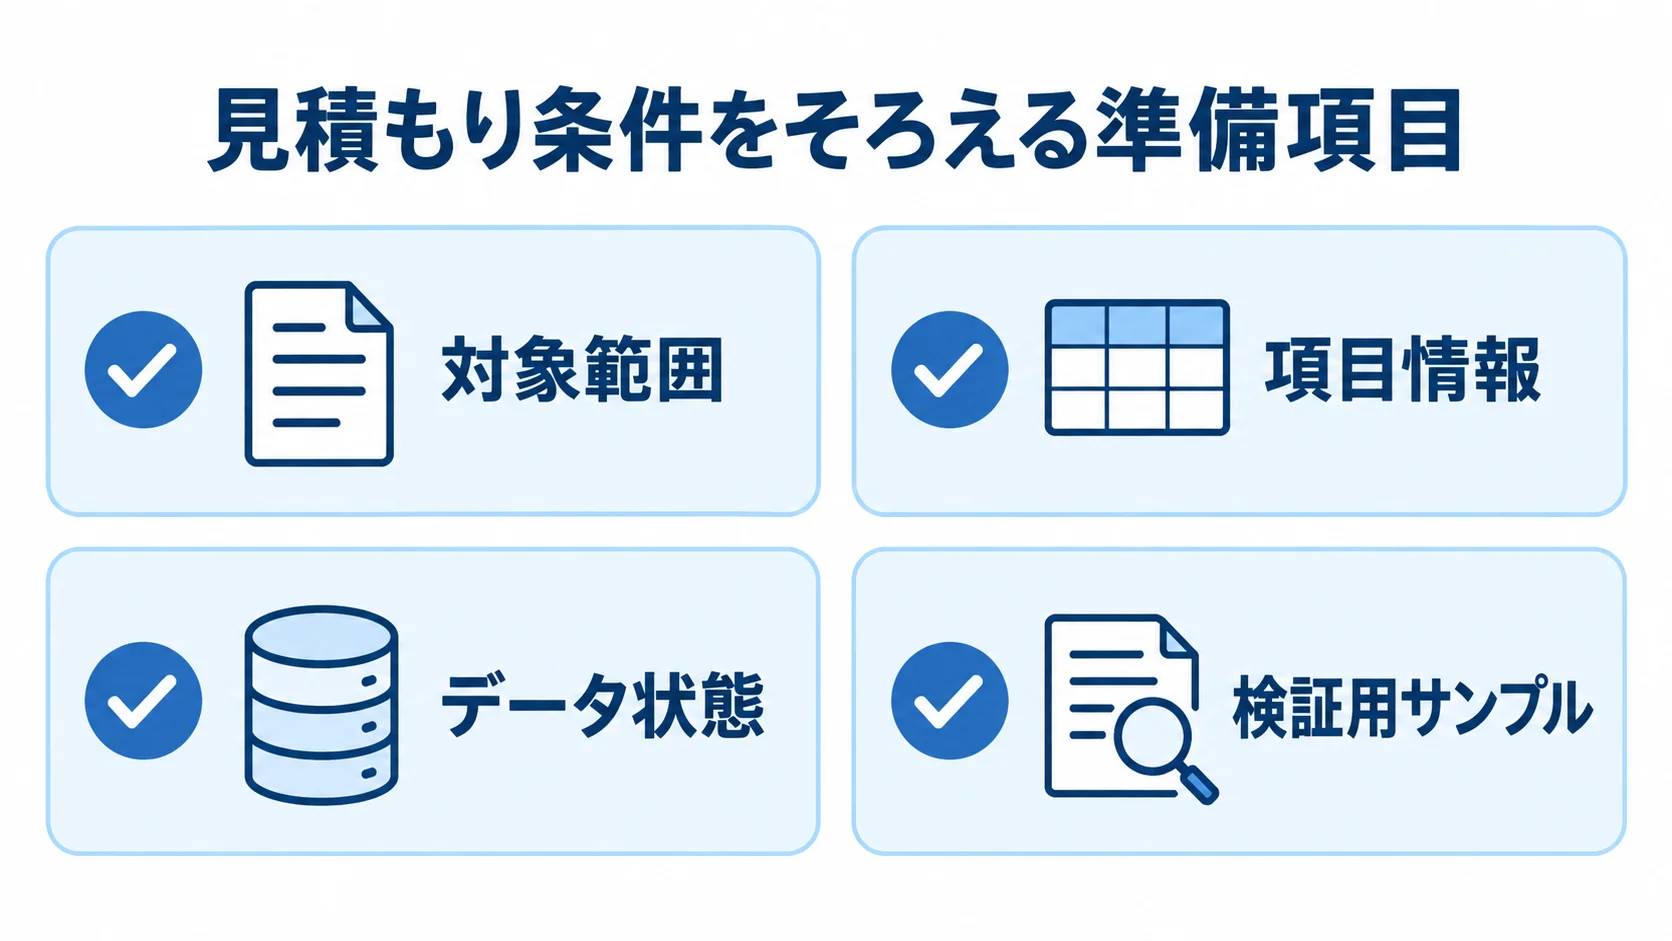
見積もりの条件をそろえるため、発注側は対象範囲と項目情報を整理します。あわせて、安全な提供方法と検証用サンプルを準備します。
- 対象範囲:ドメイン、データソース数、件数、年間増加数、更新頻度。
- 項目情報:氏名、会社名、住所、電話、メール。法人番号や会員番号の有無。
- データ状態:欠損率、形式の揺れ、個人情報区分、元システムの所有者。
- 安全な提供:個人情報をそのまま渡さず、匿名化・マスキングと安全な受け渡し。
- 検証用サンプル:正解が分かる同一レコード、同姓同名の別人、同住所の家族、本社と支店、表記ゆれ、欠損データ。
サンプルを使うと、誤統合リスクと人手確認の負荷も見積もれます。
発注先の実績と運用体制による比較
候補会社の対応範囲と運用体制を、同じ基準で比べます。
- 対応実績:対象(個人・法人・世帯)、対応件数、許容誤統合、要確認候補の扱いを尋ねる。
- 機能・連携:対象に近い実績、辞書更新の主体、人手確認画面、統合取消・履歴、API・CSV・ETLの対応。
- 引き継ぎ:担当者教育、設計書・ルール・ログの引き渡し、保守終了時のデータ返却。
- PoC評価:良かった例だけでなく、失敗例や未判定例を示せる会社は、実運用の課題を説明しやすい傾向があります。
株式会社NTTデータ バリュー・エンジニアのData-Master®は、導入コンサルとデータ構造の明確化を扱います。クレンジングと補完も対象です。
法人番号付与や、法人・事業所・支店単位の名寄せも扱うサービスです。また、現状調査や運用設計を誰が担うのかも確かめます。
個人情報・誤統合・ベンダーロックインの管理
個人情報を扱うRFPでは、具体的な安全管理策と、委託先の確認方法を定めます。安全管理策には、暗号化、最小権限、多要素認証があります。加えて、アクセス・変更ログ、バックアップと復旧テストも含めます。
さらに、開発・検証・本番の分離や保持期限を確認します。再委託と作業後の消去証明も確かめます。認証を取得しているかどうかは、判断材料の一つにとどめます。
個人情報保護委員会の「個人情報の保護に関する法律についてのガイドライン(通則編)」は、2026年6月に一部改正されました。同ガイドラインは、取扱規程や責任者、点検・監査を示しています。アクセス制御や不正アクセス対策も含まれるため、自社データの性質と量に応じて具体策を確かめます。
- 誤統合対策:自動統合、要確認、統合禁止の条件の切り分け。
- データ移行:共通ID、正規化値、元データ対応表、判定ルール、履歴、辞書を標準形式で返せるかどうか。
- 連携設計:共通要件、連携範囲、責任分界の整理。
支店の管理が必要な場合は、法人IDと事業所IDを別々に持たせます。
IPAが2026年3月に公開した企業間データ連携ガイドラインの手引きは、複数企業・システム間の共通要件と設計方針を整理しています。名寄せRFPでは、連携範囲や、どこまでを誰が受け持つかを定める際の参考になります。
名寄せシステム開発でよくある質問(FAQ)
発注前によく確認される論点として、自動化の限界、既存システムの入れ替え、必要な精度を取り上げます。
名寄せの精度は何%を目標にすればよいですか?
目標は、誤統合の影響と、確認に使える時間から決めます。一律に99%を目指す必要はありません。
- 金融・医療・契約管理:誤統合の影響が大きいため、自動統合を厳しくし、要確認を多めに残す設計が安全です。
- 販促分析:多少の未統合を許容できる場合があり、候補を広く提示して担当者が確認する方法もあります。
既存のCRMや基幹システムを入れ替える必要がありますか?
必ずしも入れ替える必要はありません。既存システムを残し、名寄せ基盤で共通IDと正規化データを管理できます。
必要な項目だけを配信する構成も選べます。配信の手段には、API、ETL、iPaaSがあります。ファイルで渡す方法もあります。
まずは2〜3システムから始め、業務効果と運用負荷を見て範囲を広げます。そうすると、全面刷新よりリスクを抑えやすくなります。
個人情報をクラウドの名寄せシステムで処理しても大丈夫ですか?
安全性は、クラウドかオンプレミスかだけでなく、保存場所、暗号化、アクセス制御の確認で判断します。さらに、認証とログも確かめます。
バックアップや再委託、障害復旧も確かめます。契約終了時の返却と消去は、自社のリスクに応じて判断します。
個人情報保護委員会のガイドラインを安全管理措置の基準とし、委託先の監督と監査可能性を契約に定めます。
名寄せシステムの開発期間はどのくらいですか?
一回限りのクレンジングは、調査と候補確認を含めて数週間から数か月が目安です。小規模は3〜6か月です。一方、中規模は6〜12か月、全社MDMや複数拠点連携は12〜24か月以上になる場合があります。
データの洗い出しや正解データがなく、連携先の責任者も未定なら、開発前の準備期間も見込みます。
まとめ
名寄せは、同一対象を識別し、共通IDと判定履歴を保つ業務基盤です。一度データを整えて終わる作業と考えておく必要があります。
要件整理では、対象と目的を定めます。KPIと責任者も決めます。そのうえで、受託、パッケージ、クラウド、スクラッチを比べます。
設計では、標準化とマッチングを分けます。そして、正解データを使うテストで、誤統合と確認の負荷を測ります。
まずは1ドメイン・2〜3システムからの開始
費用とリスクを抑えるには、顧客または法人など1ドメインに絞り、2〜3システムでPoCを行う方法が現実的です。
予算目安は一回限りのクレンジング・名寄せが50万〜300万円、小規模が300万〜1,000万円、中規模が1,000万〜3,000万円です。
金額はデータ品質と連携範囲で変わります。そのため、相場は目安として扱い、プロファイリングとサンプル検証のあとに個別見積もりへ進みます。
精度よりも業務で続く運用設計
継続運用では、初期要件と稼働後の品質指標を分けて管理します。
- 運用要件:自動統合・要確認・統合禁止の境界、統合取消、ルール版管理。辞書更新、権限、監査ログ、再処理も含めて定めます。
- 品質指標:重複率、誤統合率、未判定率を測ります。確認時間や連携エラー率も測り、データ管理者が改善します。
目的を「顧客単位で正しく速く判断できる状態」と定めると、システム投資の効果を社内で説明しやすくなります。
▼全体ガイドの記事
・名寄せシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。