
Google Bigtableのシステム開発は、Bigtableを中心に、データの受け付けから分析までを組み合わせて作ります。
時系列・イベント・ユーザー関連のデータに分けて捉えると、保存先や参照方法の判断に役立ちます。記事の最後では、PoCの相談前チェック項目とFAQも紹介します。
▼関連記事一覧
・Google Bigtableのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Google Bigtableのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Google Bigtableのシステム開発の見積相場や費用/コスト/値段について
・Google Bigtableのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Bigtableのシステムの概要
Google Bigtableは、業務画面までを単体で提供するサービスではなく、データを蓄積する基盤です。具体的には、イベントをメッセージ基盤で受け付け、データパイプラインで加工したうえで、Bigtableに蓄えます。
そこに、APIや画面、分析基盤、監視も組み合わせます。採用時には、オンラインで参照するデータと分析に回すデータを分け、用途とアクセス方法を定めます。
大量データを低レイテンシで扱うマネージドデータベース
Bigtableは、行キーの順に並ぶ疎なテーブルに、列ファミリー、列修飾子、タイムスタンプ付きの値を保存します。公式概要では、数十億行、数千列、テラバイトからペタバイト規模を扱えるサービスと説明されています(出典: 公式概要、2026年8月確認)。
リレーショナルテーブルは、使わない列にもNULL用の領域を確保します。一方でBigtableは、行ごとに保持する項目が異なるデータにも対応しやすい点が特徴です。
時系列・IoT・イベントデータとの相性
センサーの値から取引履歴まで、Bigtableと相性のよいデータは用途ごとに分けて捉えられます。
- IoT・監視:センサーの測定値やログを蓄える用途。
- イベント・取引:広告、マーケティング、金融取引の履歴が中心です。
- ユーザー関連:プロフィールやレコメンドに使う特徴量を保持します。
ユーザーIDと時刻で直近の行動を取り出す処理や、設備IDと計測時刻の範囲を読む処理に向きます。
任意条件の検索や複数テーブルのJOINが頻繁に必要な場合は、別のデータベースや分析基盤と役割を分けるのが現実的です。
Google Bigtableが向いている業務と向かない業務
採用の判断では、性能の大きさより先に、業務の読み書きのパターンを言葉にして確かめます。参照キーが事前に決まり、単一行や連続したキー範囲を高頻度で処理する業務なら、候補になります。
データ量が小さく、多様な検索や厳密なトランザクションを重く見る業務では、別の選択肢と並べて比べます。
キー検索と時系列の追記に向く業務
アプリが参照キーを持ち、時刻順に追加したデータを読む業務は、採用の候補に入ります。
- キー検索:顧客ID、デバイスID、商品IDで参照する業務。
- 期間参照:時刻順のデータから、直近の一定期間を読み出します。
- 大量イベント:毎秒発生するイベントを受け止めます。
- アクセス増加:急増したアクセスに合わせて、ノードを増やせます。
Bigtableのデータは行キーの順に並びます。そのため、検索条件を後から足すより、利用するクエリを先に洗い出してテーブルに反映します。
小規模CRUDや複雑なJOIN中心の業務で過剰になる点
小規模な顧客管理や受発注画面のように、データ量と同時接続数が限られ、一覧検索や更新トランザクションが中心の業務では、ノード費用と設計の負荷が過剰になる可能性があります。
複数テーブルのJOIN、集計、整合性制約が中心の場合は、Cloud SQLやSpannerといったリレーショナル系も比べます。さらに、柔軟な構造の業務データならFirestore、分析や大規模集計ならBigQueryが合う場合もあります。
Bigtableのデータ構造とrow key設計
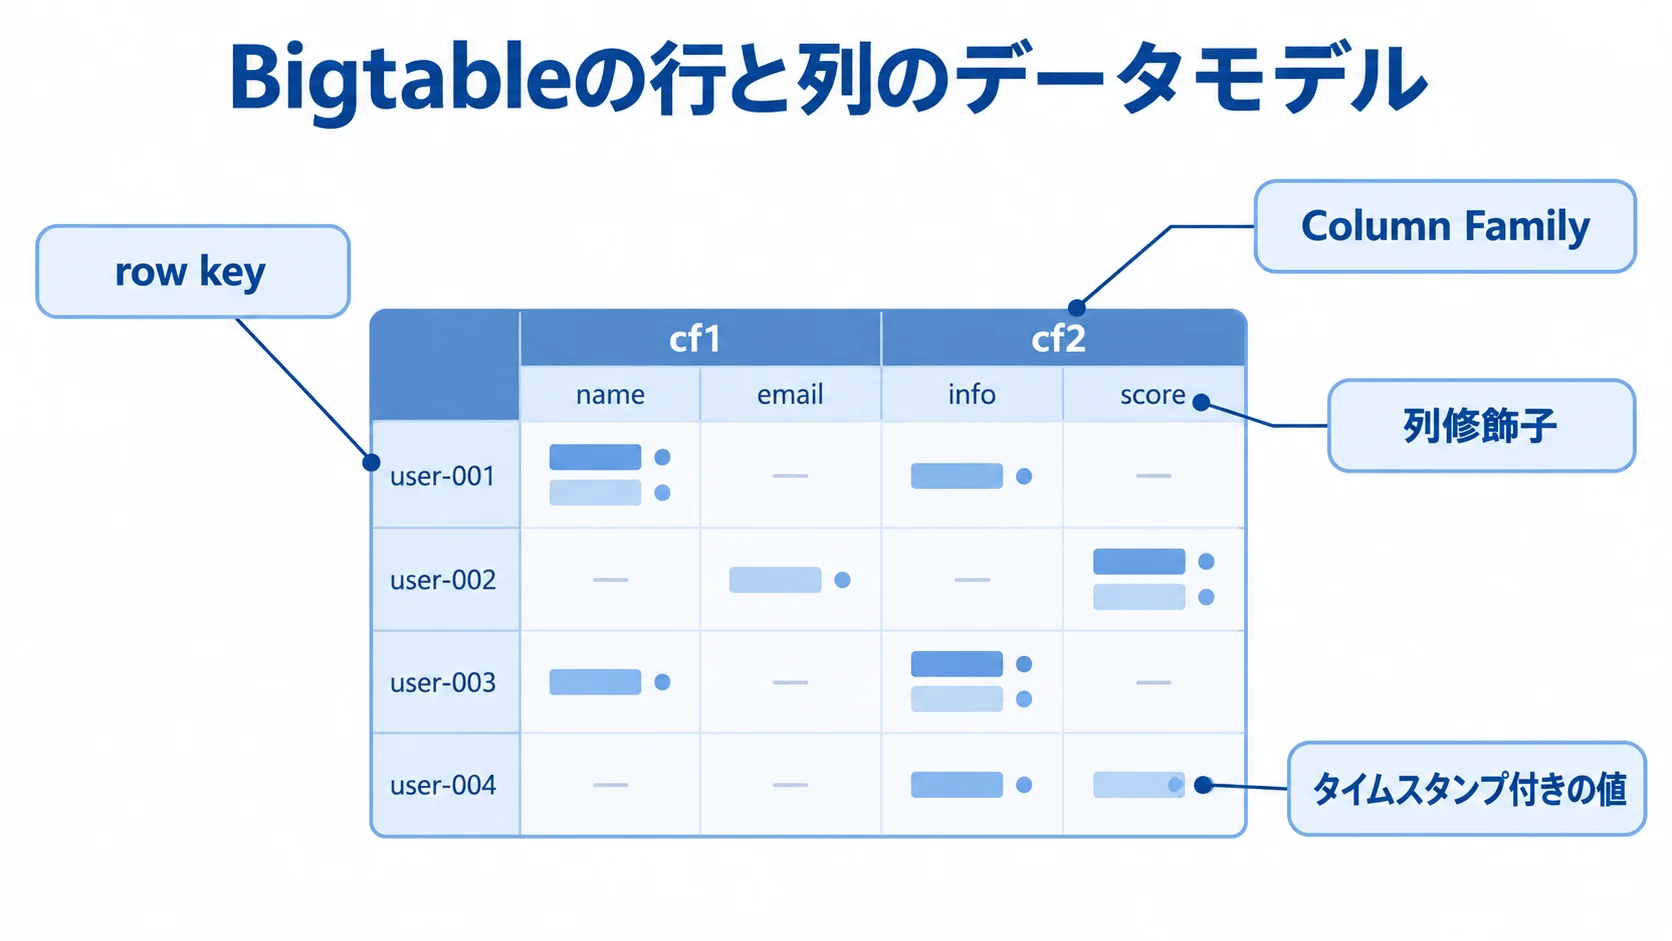
Bigtableの開発では、画面やAPIより先にデータモデルを試作します。各行は一意なrow keyで識別され、関連する列はColumn Familyにまとめられます。
同じ列にタイムスタンプの異なるセルを複数保持できるため、履歴を上書きせずに残せます。ただし、トランザクションは単一行の範囲に限られ、テーブル間のJOINもありません(出典: 公式テーブル仕様、2026年8月確認)。
row keyの分散と読み出し単位の両立
row keyでは、負荷の分散と関連行の近接配置を両立させる必要があります。地域と時刻を使う場合は、地域ごとの範囲を取り出せるように、識別子と時刻を組み合わせます。
同じ地域や時刻に書き込みが集中すると、ホットスポットが起きやすくなります。そこで、ハッシュ接頭辞、シャード番号、逆順時刻を候補にし、実データに近い負荷試験で比べます。
Column Familyと保持期間の設計
Column Familyには、保持期間やアクセス特性が共通する列をまとめます。たとえば、生ログを90日だけ残し、集約値を長期間保持するときは、Familyごとにガベージコレクションポリシーを使い分けます。
履歴を無制限に残すと、ストレージ費用と読み出しの対象が増えていきます。そのため、法令や契約、業務上で必要な期間を確かめ、削除の条件を決めておきます。
列名が長すぎると、データ量に影響します。読みやすさと容量のバランスも、あわせて確かめます。
Google Bigtableの標準的なシステム構成
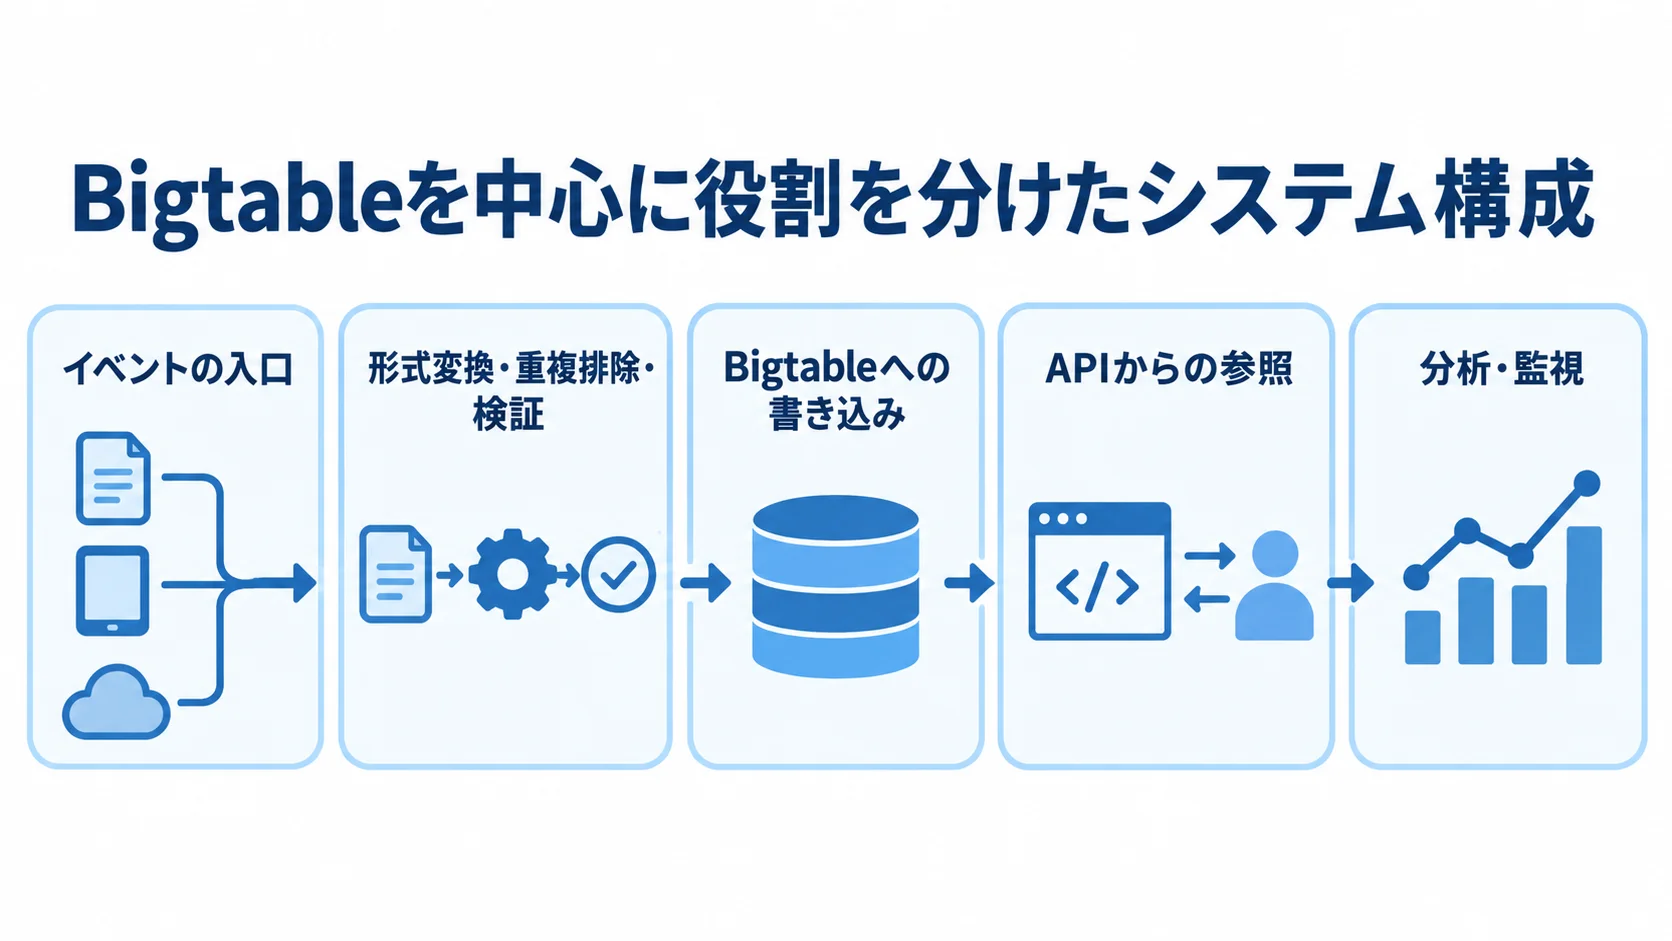
システムは、データの入口、加工、保存、提供、分析、監視の役割に分けて組み立てます。リアルタイム参照用のデータと後から集計するデータを同じ場所に置かないことが、性能とコストを安定させる基本になります。
取り込みとAPIの分離
イベントの入口にはPub/Subなどを置き、Dataflowなどで形式を変換し、重複を排除して検証したうえで、Bigtableへ書き込みます。
アプリからの直接書き込みと、バッチやストリームによる取り込みを分けておくと、障害時の再送と処理量の調整を別々に扱えます。
APIは、Cloud RunやGKEなどからBigtableを参照します。認証や入力検証、タイムアウトの処理に加え、リトライやレスポンスのキャッシュも、このAPIの中で実装します。
分析・監視・変更連携の役割分担
経営分析や機械学習に使うデータは、BigtableからBigQueryなどの分析基盤へ連携します。変更を下流へ流す場合は、Change Streamsを使います。そのうえで、監査、アーカイブ、集計更新の流れを設計します。
監視では、CPU使用率、読み書きのレイテンシ、エラー率を追います。あわせて、スロットリングとバックログを見ます。さらに、複製遅延とストレージ増加量も確認し、症状が現れる前に通知できるようにします。
Google Bigtableのシステム開発の進め方
Bigtable開発は、まず要件定義とデータモデル設計を行い、次に技術検証とアプリ開発へ進みます。最後に、移行・テスト、運用設計を進めます。
画面を先に作ると、row keyを変えたときにデータ構造やAPIを作り直すことがあります。QPSやレイテンシ、データ増加量は、発注前に数値で決めておきます。保持期間、RTOとRPO、整合性要件も、数値に直しておきます。
▶ 詳細はこちら:Google Bigtableのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義とPoCによる採用判断の確認
要件定義では、性能とデータ量を具体的な数字に落とし込みます。利用者数、保持期間、復旧目標も、この段階で具体化します。
- 負荷:平常時・ピーク時のQPSとp95・p99応答時間。
- データ:1件のサイズ、1日あたりの増加量、保持期間。
- 利用・復旧:同時利用者数と障害時の復旧目標。
- PoC:実際のキー分布と読み書き比率の再現。
無料トライアルは、1ノード・最大500GBのSSDで10日間試せます。延長すると最長90日まで検証できると案内されています(出典: 公式概要、2026年8月確認)。
無料枠で動いたからといって、本番の性能が保証されるわけではありません。そのため、本番相当のデータ量で測定します。
設計・開発・テスト・リリースの段階化
作業は、次の順に進めます。
- row keyとColumn Familyを決め、セルの版数と削除ポリシー、再試行と冪等性の扱いを、この段階で固めます。
- APIとデータパイプラインは小さく作り、負荷試験用のデータ生成も自動化します。
- 負荷試験では、通常時とピーク時の負荷、急増、ノードやリージョンの障害に加え、重複したイベントや遅れて届くイベントも試します。
- バックアップからの復元を確かめたうえで、二重書きや段階展開を使ってリリースします。
リリース前に、切り戻しの条件を文書にまとめます。
納品物と責任分界の取り決め
納品物には、要件定義書、構成図、row keyとスキーマ設計書を含めます。負荷試験結果、IaCコード、監視画面も、納品の対象です。移行手順やバックアップと復元の手順に加え、障害対応Runbookも対象です。
ソースコードと運用引き継ぎ資料も、納品の範囲に含めます。クラウド利用料と監視は誰が負担するのか、明記しておきます。障害対応や移行後の保守についても、負担先を決めます。
完成の条件は、画面が動くことだけでは足りません。p99レイテンシやデータ欠損件数で受入基準を定め、復旧時間やコスト上限も、同じ基準に含めます。
Google Bigtableのシステム開発費用相場
Bigtableを使うシステムは、開発費とクラウド利用料を分けて見積もります。月額料金だけを見ると、API・連携・監視の費用を見落としがちです。移行と保守の費用も、見積もりに入れておく必要があります。
以下は概算です。金額はデータ量とQPSで変わり、既存システムや可用性、連携本数でも動きます。最終的には、PoCと要件定義をもとに再計算します。
▶ 詳細はこちら:Google Bigtableのシステム開発の見積相場や費用/コスト/値段について
規模別の開発費の目安(PoCは100万〜300万円)
開発費は規模によって大きく開くため、区分ごとに金額と期間を分けて見ておく必要があります。区分は4つに分けて整理します。
- PoC:row key設計、簡単なAPI、負荷試験を含め100万〜300万円程度。少量移行やSDKによる読み書きも対象で、期間は2〜6週間。
- 小規模業務アプリ:500万〜1,500万円程度。期間は2〜4か月。
- 中規模本番システム:1,500万〜5,000万円程度。期間は4〜9か月。
- 大規模基盤・既存DB移行:5,000万円〜2億円以上の場合があり、期間は9〜18か月以上。
この数字は、一般的な業務システムの相場と、Bigtable固有の設計・移行の工程をもとにした推定です。公式の価格ではありません。
クラウド実費の変動要因(ノード・クラスタ・保存量)
公式料金表の単価と、別料金になる項目を見ていきます。
- Enterprise:米国リージョン例のノード単価は、1時間0.65ドル(2026年8月確認)です。
- Enterprise Plus:同じ条件では、1時間0.85ドルです。
- 月額の単純計算:30日間、1クラスタ、1ノードでは468ドルと612ドルです。
- 別料金:ストレージ、ネットワーク、バックアップが対象です。
監査ログやDataflow、Pub/Sub、分析基盤も、別に計算します(出典: 公式料金表、2026年8月確認)。
日本円に換算した額は、為替や請求通貨で変わります。そのため、円換算の金額だけで予算を固定しないようにします。
冗長化とData Boostによる費用の増加
冗長化、読み取り分離、利用割引は、それぞれ課金条件が違うため、分けて見積もります。
- 複数クラスタ:2クラスタや別リージョンでは、ノードとストレージがクラスタ数に応じて増えます。複製・ネットワーク費用と初回コピー時間も見積もります。
- Data Boost:大量読み取りをアプリ用ノードから分けて、必要なときに使います。最低利用単位と処理量課金は、事前に確かめます。
- コミット割引:割引率と、PoC後に契約する時期を判断します。
公式資料では、1年で20%、3年で40%の割引が案内されています(出典: 公式Committed Use Discount資料、2026年8月確認)。ただし、負荷が固まらない段階のPoCで長期契約を結ぶのは避けます。
既存データベースからBigtableへ移行する方法
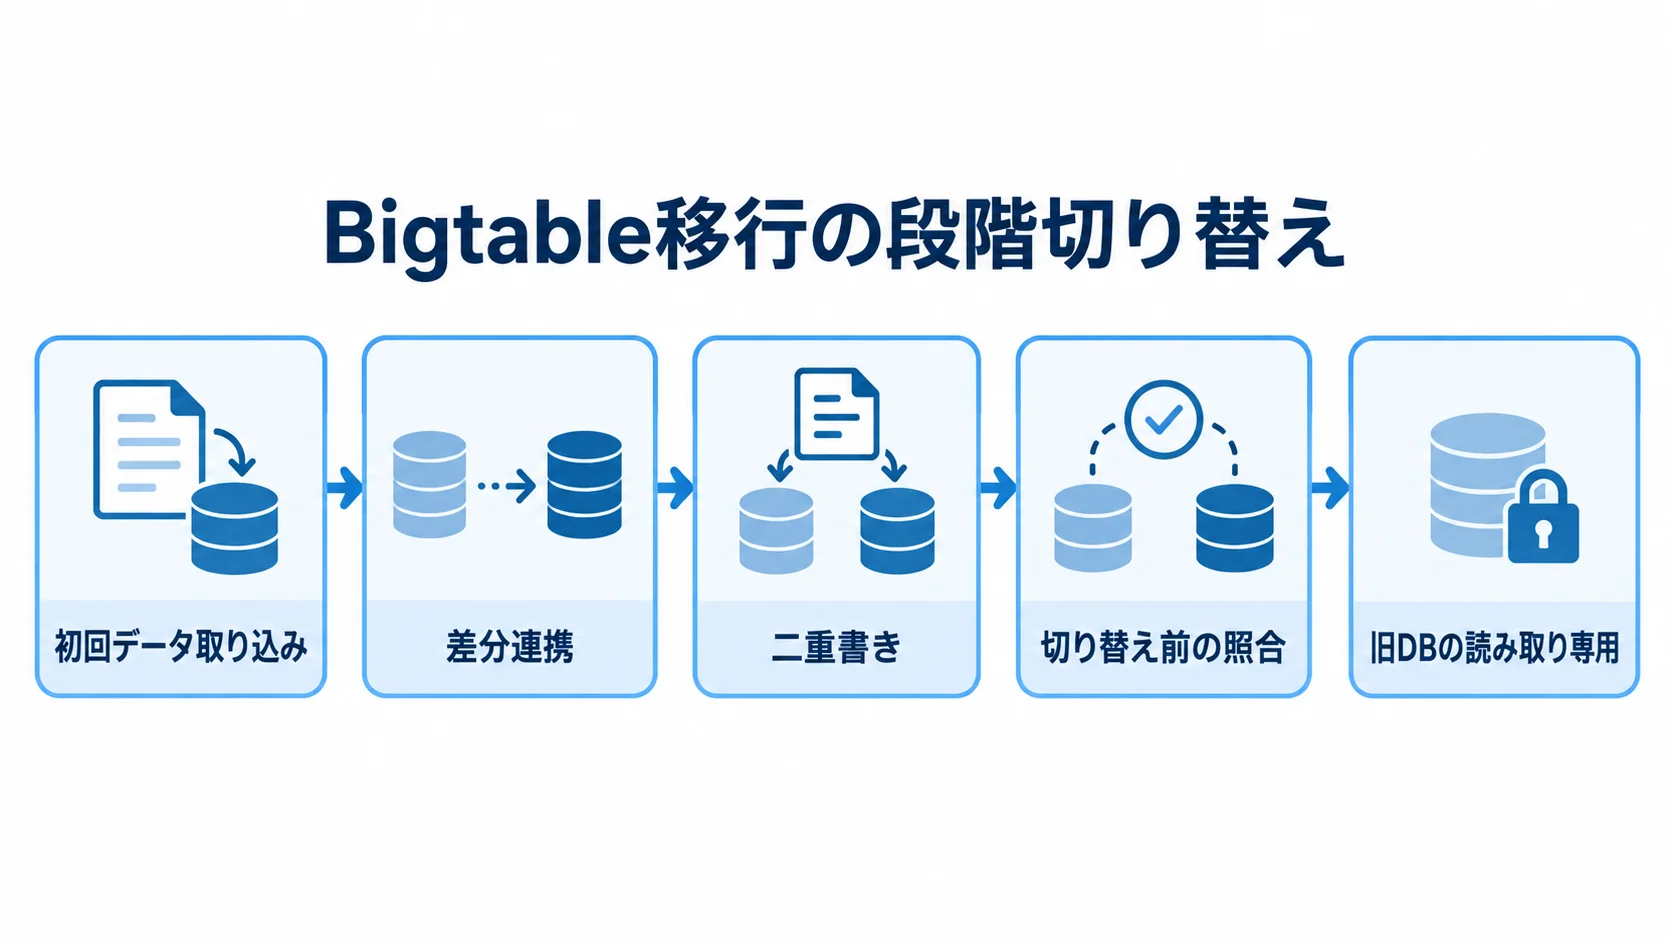
MySQLなどのRDB、HBase、Cassandraから移行する場合は、データをコピーするだけでは終わりません。検索条件はrow keyとテーブル設計に置き換え、JOINや集計を行う場所も設計し直します。
停止時間を短くするには、移行を一連の計画として組み立てます。まず、バックフィルと差分同期で既存データを揃えます。
そのうえで、二重書きと整合性検証を行い、段階切り替えに進みます。切り戻しの手順も、計画に含めます。
移行前のデータとクエリの対応表
既存テーブル、主キー、検索条件を一覧にします。そこに、更新頻度やデータ量を加えます。保持期間と個人情報の有無も、同じ表に書きます。
各画面やAPIのクエリは、単一行検索、キー範囲検索、分析基盤への連携に分けて整理します。発注者側でもこの対応表を管理すると、移行後に一覧が作れない、履歴が欠けるといった手戻りを減らせます。移行検証では、サンプルだけでなく、最大サイズの行、古いデータ、削除済みデータも対象にします。
二重書きと段階切り替えによる停止リスクの抑制
大規模な移行では、初回の取り込みから切り戻しまでを、次の4つの管理に分けて進めます。
- 初回取り込み:旧DBを正として初回データを取り込み、その後の更新は差分で連携します。
- 二重書き:順序や重複、遅延を管理し、片側だけ成功したときの再実行も決めておきます。
- 切り替え前の照合:件数とハッシュ、代表キーで照合し、許容差を定めます。
- 切り戻し:切り替えたあとも旧DBを一定期間は読み取り専用で残し、戻せる期限と判断する人を決めておきます。
照合では、時系列の欠落や最新の更新時刻も調べます。
Bigtableのセキュリティと個人情報保護
顧客情報や行動履歴を保存するなら、安全対策はクラウド側の暗号化だけでは終わりません。権限やネットワーク境界、監査ログは、運用として設計します。
鍵管理やバックアップ、削除の扱いも、運用の一部として決めます。委託先や事故時の連絡についても、あわせて取り決めます。
国内リージョンや保存場所、国外移転の扱いは、要件定義の段階で法務や情報システム部門と確かめます。契約上の保存期間も、同じ場で決めておきます。
IAMとネットワーク境界の最小権限構成
アクセス制御では、権限を誰に与えるかと、Bigtableのどの範囲まで制御できるかを確かめます。
- 最小権限:必要な権限だけを、開発者、運用担当、アプリ、移行ジョブのそれぞれに与えます。
- 制御単位:権限の単位は、プロジェクトからテーブル、Authorized Viewまでです。
- 行分離:テーブル分割やAuthorized View、アプリ側の認可、別サービスを比べます。
- 境界と記録:VPC Service Controlsや監査ログを、脅威と運用体制に応じて使い分けます。
Bigtableでは、行・列・セル単位の細かな制御はできません(出典: 公式概要、2026年8月確認)。
暗号鍵・監査・バックアップの運用
暗号鍵やアクセス記録、復元の手順を、委託管理も含めて一連の運用に組み込みます。
- 暗号鍵:保存時の暗号化は標準で有効です。CMEKを使う場合は、保管場所とローテーション、無効化の影響を決めます。担当者不在時の復旧手順も定めます。
- 監査ログ:管理操作とデータアクセスを分けて、利用者、時刻、対象テーブルを必要な期間残します。
- バックアップ:別環境への復元を定期的に試し、権限の再現、削除期限、復元後の整合性も確かめます。
- 委託管理:委託契約で取扱状況を合理的に把握し、安全管理措置を実施します(出典: 個人情報保護委員会「通則編」ガイドライン、2026年8月確認)。
本番運用で確認する性能・障害・コスト
マネージドサービスでも、クエリやrow key、リトライの設計は自動で最適化されません。保持期間や予算アラートも、人が見直す必要があります。
性能と可用性、データ品質を定期的に点検します。セキュリティとコストも、同じ周期で確かめます。
想定と実際の負荷がずれたときに備えて、変える設定や再設計の基準を、Runbookに残しておきます。
p95・p99とホットスポットの継続監視
平均値だけでなく、p95とp99の読み書きレイテンシを見ます。加えて、エラー率やCPU使用率、スロットリングも確認します。毎秒の読み書き件数も、あわせて追います。
平均が正常でも、row keyの偏りによって特定のタブレットだけ高負荷になることがあります。キー分布や時間帯別のアクセス、顧客・デバイスへの集中を確かめられるようにします。必要になれば、キー設計やアプリ側のキャッシュを見直します。
業務単位の整合性と災害対策
単一クラスタでは、同じクラスタへの読み書きが強整合になります。一方で、複数クラスタの場合は、既定でクラスタ間の読み取りが結果整合になります。
複製の遅れは、通常数秒から数分程度です。ただし、負荷や障害の状況によっては遅れる可能性があります(出典: 公式レプリケーション資料、2026年8月確認)。
在庫や課金、注文では、最新値が必要な処理を定めます。そのうえで、単一クラスタのルーティングや再試行、競合解決、フェイルオーバーの手順も設計します。
予算アラートと利用状況の定例レビュー
費用は、ノード数やクラスタ数、保存容量ごとに把握します。バックアップやネットワーク、関連サービスの利用量も、同じように分けて見ます。
環境ごとに、予算と月次上限を設定します。急増時の通知や、検証環境の停止ルールも決めておきます。ノードを増やしても性能が上がるとは限りません。
ホットスポットや非効率なスキャンが原因なら、キーやクエリを見直します。月次レビューでは、想定と実際のQPSを比べます。レイテンシやストレージ増加、障害件数も確認し、1リクエストあたりのコストも追います。
Google Bigtableの開発会社/ベンダーの選び方
開発会社は、クラウド導入の支援とNoSQLのデータモデリングの経験を確認します。そのうえで、負荷試験や移行、パイプライン、監視、障害対応の経験も見ていきます。
ロゴや資格を見ただけでは、row keyの偏りや結果整合性への対応力は分かりません。初期提案で、代替データベースを含めた比較を示せるかどうかも、判断材料になります。
Bigtable固有の設計と移行実績の確認
提案では、類似するデータ量やピークQPSを、可能な範囲で数字とともに示してもらいます。p95・p99レイテンシ、キー設計、保持期間、クラスタ構成についても、確かめます。
HBaseやCassandraからの移行経験があれば、バックフィル、差分同期、二重書きの進め方を聞きます。整合性検証や切り替え、切り戻しについても、どこまでを誰が受け持つかを質問します。
実績では、公開できる範囲で課題や採用理由を尋ねます。負荷試験や障害対応、運用後の改善まで話してもらうと、実務の深さが見えてきます。
見積もりの範囲と運用体制の比較
見積もりは、要件定義からPoC、設計、実装までと、移行からリリース、保守までに分けてもらいます。成果物と工数も、この区切りごとに確かめます。
Bigtableの利用料が見積もりに含まれるか、別請求になるかを明確にします。ノードやクラスタが増えたときの予算管理は、誰が担うのかも決めておきます。
24時間監視や障害の一次対応、復旧支援は、契約の範囲に入っているかを確かめます。セキュリティパッチや復元テスト、月次の性能レビューも、範囲に含むかを見ます。契約範囲を見ておくと、稼働後の追加費用を抑えやすくなります。
代替案と契約終了時のデータ取り出し
契約先の選定では、代替案、引き渡し範囲、契約終了時の条件を確かめます。
- 代替案:Bigtableが最適でない場合、Cloud SQLやSpanner、Firestore、BigQueryの案も説明できるかを見ます。
- 納品・引き渡し:スキーマやIaC、API仕様を自社へ渡せるかを確かめます。移行スクリプト、監視設定、運用Runbookの扱いも、同じ場で確かめます。
- 契約終了:データ形式と取り出しの期間・費用、鍵紛失時の影響、関連サービスの停止順序を、RFPに含めます。
▶ 詳細はこちら:Google Bigtableのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Google Bigtableのシステム開発の発注/外注/依頼/委託方法について
よくある質問
検討の途中でよく出る質問を取り上げます。自社の要件に当てはめると、PoCの範囲や開発会社への相談事項を明確にできます。
BigtableはRDBの代わりに使えますか?
一部の用途では使えますが、RDBをそのまま置き換えるものではありません。JOINや複数行のトランザクション、自由な条件検索、厳密な制約が中心なら、RDBを残すか別のDBが合います。
キー検索や時系列の追記、大量の読み書きが中心なら、Bigtableをオンライン参照の層に使います。分析や業務管理は、別の基盤に分ける構成を検討します。
小規模なシステムでもBigtableを選べますか?
選べます。ただし、将来のデータ量やアクセス量だけでなく、現在の要件と費用も含めて判断します。
小規模CRUDが中心なら、よりシンプルなサービスで始めて、読み書きが増えた段階で移行する方法もあります。
将来の移行に備えるなら、論理モデルやAPI、イベント形式、保持期間を特定のサービスに頼りすぎないようにします。選択肢を残せます。
Bigtableの月額費用を抑えるにはどうすればよいですか?
使っていないノードやクラスタは常時稼働させず、保持期間とガベージコレクションを適切に設定します。過剰な範囲スキャンも減らします。
Data Boostの分離実行やデータ階層が合うかは、負荷と費用を比べて判断します。利用が安定してから、コミット型割引を検討します。
予算アラートと月次レビューを使い、ノードだけでなく、ストレージやネットワーク、連携サービスの合計を管理します。
PoCでは何を検証すればよいですか?
本番に近いrow keyとデータ分布を使って、ピークQPSや読み書き比率、p95・p99レイテンシを測ります。ホットスポットや障害時の挙動、欠損・重複、月額費用も、あわせて確かめます。
単一行の読み取りだけでなく、範囲スキャンや同時書き込み、TTL削除、バックアップ復元も試します。
終了の条件を数値で定め、未達のときはrow keyを変えるか別サービスへ戻すかを、先に決めておきます。そうすれば、検証そのものが目的になることを避けられます。
まとめ
Bigtable採用の判断軸
Bigtableは、数十億行規模のデータを低レイテンシで読み書きするオンライン基盤として力を発揮します。
採用前には、読み書きのパターンとrow key、保持期間を定めます。加えて、QPSやレイテンシ、整合性、RTOとRPOも決めます。小規模CRUD、複雑なJOIN、行単位の厳密な権限制御が中心なら、別のDBも比べます。
PoCとRFPによる次の一歩
採用の判断から運用の開始まで、PoCと費用の整理、運用設計、委託先の確認を順に進めます。
- PoC・費用:キー分布と本番相当の負荷を検証し、開発、利用料、移行、監視・保守費を分けて見積もります。
- 運用:IAMや暗号鍵、監査ログを整えます。復元と個人情報の保存・削除、複製時の整合性も、手順にまとめます。
- 委託先:Bigtable固有の設計・移行を数字で説明できるか、代替案と契約終了時のデータ取り出しを示せるかを確かめます。
▼関連記事一覧
・Google Bigtableのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Google Bigtableのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Google Bigtableのシステム開発の見積相場や費用/コスト/値段について
・Google Bigtableのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。