
Google Bigtableのシステム開発は、要件整理を起点に、サービス選定、設計、テストを経て、段階稼働へ進めます。
全体は6つのフェーズに分かれ、各段階で数値や合否基準を決めておくと、手戻りを抑えられます。
▼全体ガイドの記事
・Google Bigtableのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Bigtableのシステム開発の全体像
Google Bigtableのシステム開発では、先にデータベースを作ってからアプリを合わせるのではなく、利用者の操作やAPIの読み書きパターンを起点に進めます。Bigtableは検索の仕方に合わせてデータの並べ方を決める仕組みなので、この順序が欠かせません。
そのうえでデータモデルを決めます。Bigtableは行キーで並べたテーブルを基本とし、列ファミリー、列修飾子、タイムスタンプ付きセルでデータを保持します。Google Cloudは、予定するクエリを中心にスキーマを設計するよう推奨しています(出典: Google Cloud「Schema design best practices」、2026年7月更新)。
Bigtableに向いているシステム
Bigtableは、ユーザーIDや端末IDなどのキーを指定し、短時間で読み書きするシステムに向いています。
- 時系列データ:IoTセンサーの計測値を蓄積します。
- イベント・ログ:広告、マーケティング、監視の記録を扱います。
- 履歴・特徴量:レコメンド用の特徴量、金融取引、顧客行動の履歴
Google Cloudは、数十億行、数千列、テラバイトからペタバイト級のデータを扱えると説明しています(出典: Google Cloud「Bigtable overview」、2026年7月更新)。なお、Bigtableは、その規模に達していなくても利用できます。
重要なのは、アクセスパターンが明確で、1行または行範囲の読み書きが中心かどうかです。また、大量の行を蓄積し、ノードの追加で処理能力を伸ばしたい場合にも強みを活かせます。
他のデータベースとの役割分担
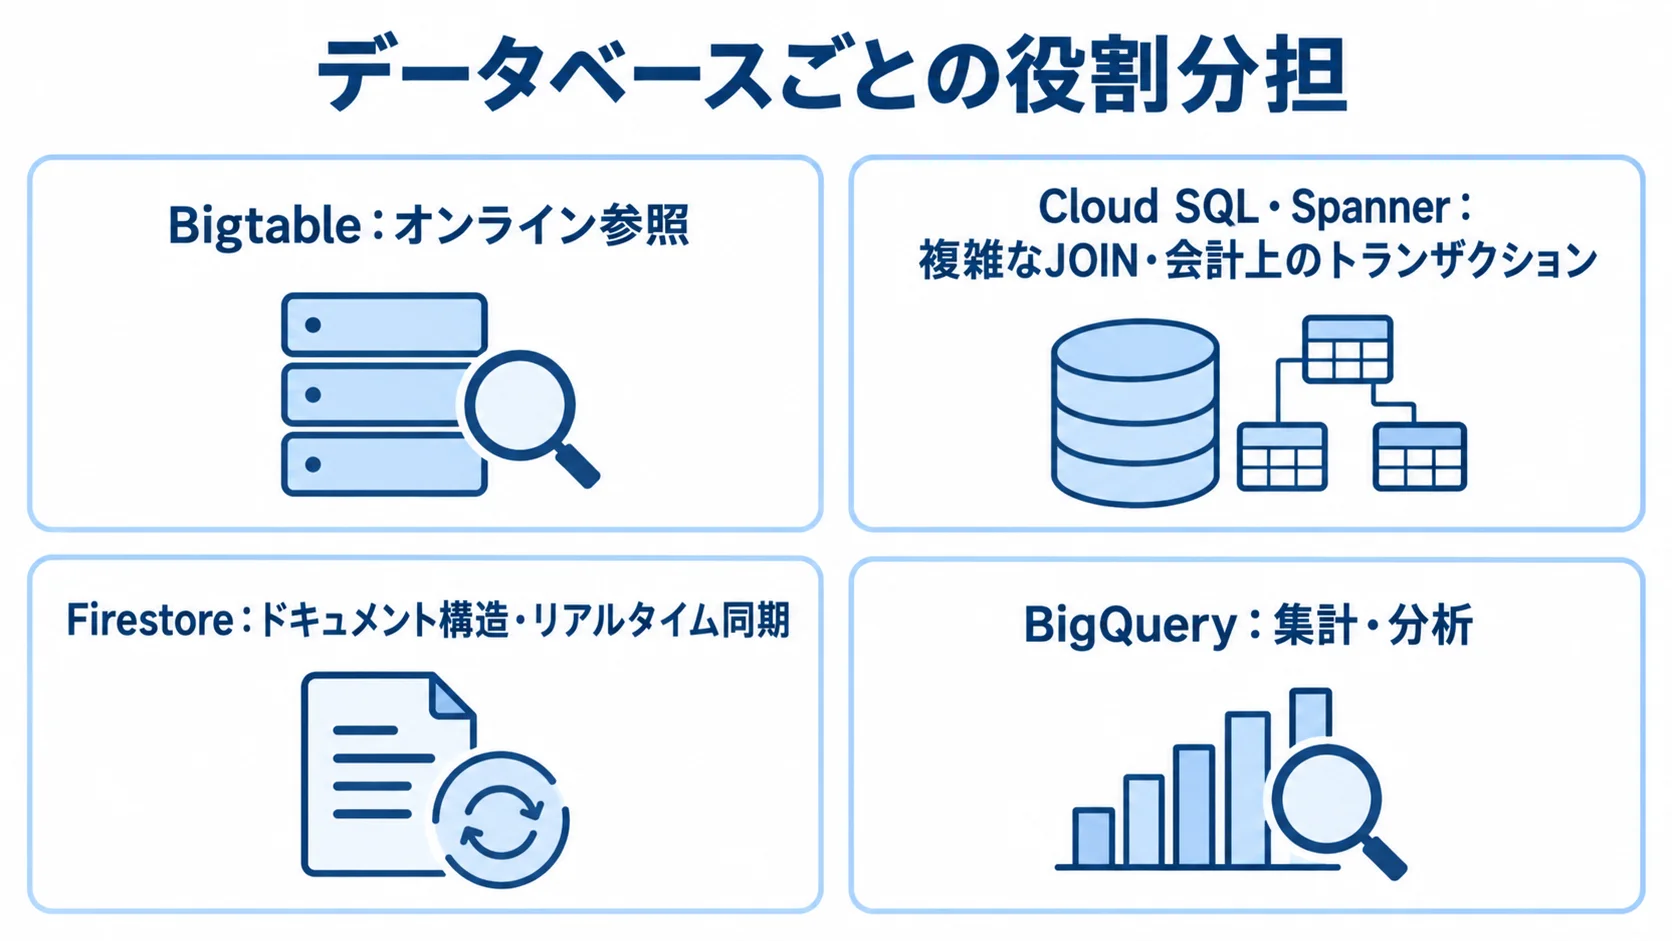
業務システム全体をBigtableだけで構築する必要はありません。また、処理ごとにデータベースを分ける構成も検討できます。
- Cloud SQL・Spanner:複雑なJOINや会計上のトランザクションを受け持ちます。
- Firestore:ドキュメント構造やユーザー間のリアルタイム同期を担います。
- BigQuery:集計・分析を受け持ち、Bigtableはオンライン参照に使います。
たとえば、Pub/Subでイベントを受け、Dataflowで整形してBigtableへ格納できます。APIはCloud RunやGKEで提供し、分析データをBigQueryへ渡す構成です。
小規模なCRUDアプリで検索条件が頻繁に変わる場合、Bigtableの設計と運用が過剰になる可能性があります。採用前に、検索をrow keyや行範囲で表せるかを確認します。
単一行のトランザクションで業務要件を満たせるかも判断材料です。さらに、「将来のデータ量が大きいから」という理由だけで選ばないようにします。
Google Bigtableのシステム開発の進め方
開発は全部で6つのフェーズに分けて進めます。要件整理から定着までの各段階で、成果物と合否基準をあらかじめ決めておきます。
特にrow keyと整合性は、後から変えると、アプリや移行処理の広い範囲に影響します。そのため、初期段階で検証に時間を配分して、「思ったより速くない」「費用が増えた」「移行後にデータが合わない」といった手戻りを抑えます。
フェーズ1:要件整理によるQPS・レイテンシ・保持期間の数値化
要件整理では、業務内容と、測定できる性能・運用条件を順に整理します。「速くしたい」という要望のままでは、設計も見積もりも決まりません。
- 業務要件:業務フロー、利用者、データの発生源、参照先の整理
- 性能要件:読み取り・書き込みQPS、同時接続数、p95・p99、データ増加量の数値化
- データ運用:1行の最大サイズ、保持期間、削除時期を定めます。
- 非機能要件:RTO・RPO、国内リージョン、障害時の切替、正確性を確認します。
- 成果物:業務要件一覧と非機能要件表、データ項目を一式にそろえます。想定クエリとピーク根拠も含めます。
平常時は1,000QPS、ピーク時は10,000QPSと表します。p99は100ミリ秒以内、1日の増加は300GBのように、測定可能な値で示します。
個人情報の保存・削除と監査ログの保存期間は、発注側が決めておきます。開発会社は、この条件を前提に設計を進めます。
業務によって、求められる即時性は変わります。たとえば、注文・在庫では直後の読み取り結果を重視し、行動ログでは数秒の遅延を許容できる場合があります。
フェーズ2:Bigtableと代替サービスの比較と選定
要件を整理したら、機能と運用条件を同じ項目でそろえて比べます。Bigtableを採用しない案も候補に入れておくと、過剰設計やベンダーロックインを避けられます。
- サービス:Bigtable、Cloud SQL、Spanner、Firestore、BigQueryの5つを候補にします。
- 要件:検索表現、トランザクション範囲、データ量、ピークQPS、レイテンシの違い
- 運用・費用:可用性、運用負荷、予算の比較。Bigtable以外の案も含めます。
- Bigtableの構成:エディション、SSD・HDD、クラスタ数、手動ノード・自動スケーリング、Data Boostの要否
複数クラスタは可用性や地域分散に有利ですが、既定ではクラスタ間の読み取りが結果整合性です。一方で、単一クラスタは強整合性です。複数クラスタでは、アプリプロファイルで読み取り整合性を設計します(出典: Google Cloud「Replication overview」、2026年7月更新)。
フェーズ3:row keyと連携方式の設計と開発
設計・開発では、クエリに合うデータモデル、移行方法、作業範囲を固めます。Bigtableでは、後から検索条件を増やしても、RDBのように自由なインデックスは追加できません。
- row key:想定クエリに応じたデータ配置の設計
- テーブル:列ファミリーとセルの保持方針を決めます。
- 検索・成果物:検索方法と開発成果物の対応関係
- 既存DB移行:移行方式とデータ確認方法を定めます。
- 連携範囲:周辺サービスの作業範囲の明確化
row keyの例は、ユーザー履歴が「ユーザーID#逆順時刻」、地域別の計測値が「地域ID#センサーID#時刻」です。また、まとめて読むデータは近くに配置します。
時刻だけをrow keyの先頭に置くと、書き込みが一部のノードに集中します。そのため、Google Cloudは時刻始まりを避け、高カーディナリティの識別子を前置する設計を推奨しています(出典: Google Cloud「Schema design best practices」、2026年7月更新)。
列ファミリー(Column Family)は業務のまとまりで分け、セルのバージョン数とガベージコレクションポリシーを決めます。検索条件を増やしたい場合は、別のrow keyのテーブルを用意する、連続マテリアライズドビューを使う、下流のBigQueryで扱うといった方法を検討します。
成果物には、row key設計書、テーブル・列ファミリー定義、API仕様を含めます。さらに、エラー処理とIaCを加えます。監視項目、データ保持・削除手順も入れます。
MySQL、HBase、Cassandraなどからの移行では、スキーマを変換するだけでなく、初期バックフィル、差分同期、二重書きを設計します。さらに、件数・ハッシュ・サンプル照合、段階切り替え、切り戻しまで決めておきます。
Pub/SubやDataflowなどの周辺サービスについては、どこまでを開発するかを決めます。Cloud RunとBigQueryの範囲も、同じように決めます。別プロジェクトの費用や運用責任も、見積もりに反映します。
フェーズ4:負荷・障害・移行データのテスト
テストでは、本番の利用状況に近い負荷とデータを用意し、性能、障害、移行結果を確認します。
- 本番に近いrow keyとデータ分布を用意し、単一行の読み書き、行範囲のスキャン、バッチ処理を試します。
- ピークQPSとp95・p99を確認し、ノード追加への追従、ホットスポット、GC後の容量も見ます。
- 平均応答時間だけでなく、ピーク時の最大レイテンシを合格条件にします。エラー率、CPU使用率、ノード数、費用見込みも含めます。
- アプリ、Bigtableクラスタ、ネットワーク、Pub/SubやDataflowの遅延を切り分けた障害試験
- 複数クラスタでは切り替え後の整合性、未複製データ、古い値を許容する画面、再送時の重複処理を検証します。
- 旧DBとBigtableの件数と必須項目、代表キー、時刻範囲を照合し、差分原因を追えるログを残します。
フェーズ5:段階稼働と切り戻しの準備
本番稼働は、切り替え条件と復旧手順を定めてから、段階的に進めます。
- 全トラフィックを一度に移さず、カナリアリリースか利用者・機能単位の段階移行を選ぶ
- 旧システムとBigtableのどちらを正とするかを決め、二重書き失敗時の再送と読み取り先を手順化する
- エラー率・レイテンシ・データ差分に基づいて切り替えを判断する(キュー滞留やクラウド費用も判断材料)
- 担当者・承認者・連絡先をまとめたRunbookを用意する
- 切り替え後は、アプリのエラーに加えて、Bigtableのレイテンシ、ノード数、CPU、ストレージ、複製遅延、監査ログの欠落を監視する
Runbookには、作業時刻と確認画面、コマンドと切り戻し条件も残します。バックアップ復元と誤削除からの復旧は事前に試し、権限を持つ担当者が復旧できることを確認します。
フェーズ6:運用の標準化とシステムの定着
稼働後は監視結果を定期的に確認し、性能・費用と運用手順を見直します。
- 構成見直し:ノード追加、row key、保持期間、アーカイブ先を、監視データで判断します。
- 月次指標:p95・p99、QPS、エラー率、ホットスポットを毎月追います。ノード、ストレージ・バックアップ量、費用、未解決インシデントも合わせて確認します。
- 運用教育:テーブル、列ファミリー、GCポリシーの扱い方を教育します。バックアップと復元、権限変更、障害時の連絡・エスカレーションも扱います。
- 個人情報の分離:テーブル分割、Authorized View、アプリ側認可を組み合わせ、削除・監査の責任を定めます。
費用だけを削ると性能や可用性を損なうため、SLOと合わせて見直します。
権限はプロジェクト、インスタンス、テーブル、Authorized Viewなどで管理できますが、行・列・セル単位では制御できません(出典: Google Cloud「Bigtable overview」、2026年7月更新)。
Google Bigtableのシステム開発費用相場とコストの内訳
費用は、初期開発費、Google Cloud利用料、稼働後の保守・監視費に分けて考えます。ただし、Bigtable単体の国内SI費用を横断的に比べられる公表統計は限られます。
ここで示す金額は、一般的な業務システムの相場に、Bigtable固有の設計・移行・データ基盤の工程を踏まえた推定です。要件やデータ量、QPSによって変わるうえ、連携数や移行難易度でも変わります。そのため、予算計画の初期目安として扱ってください。
開発規模ごとの費用と期間の目安
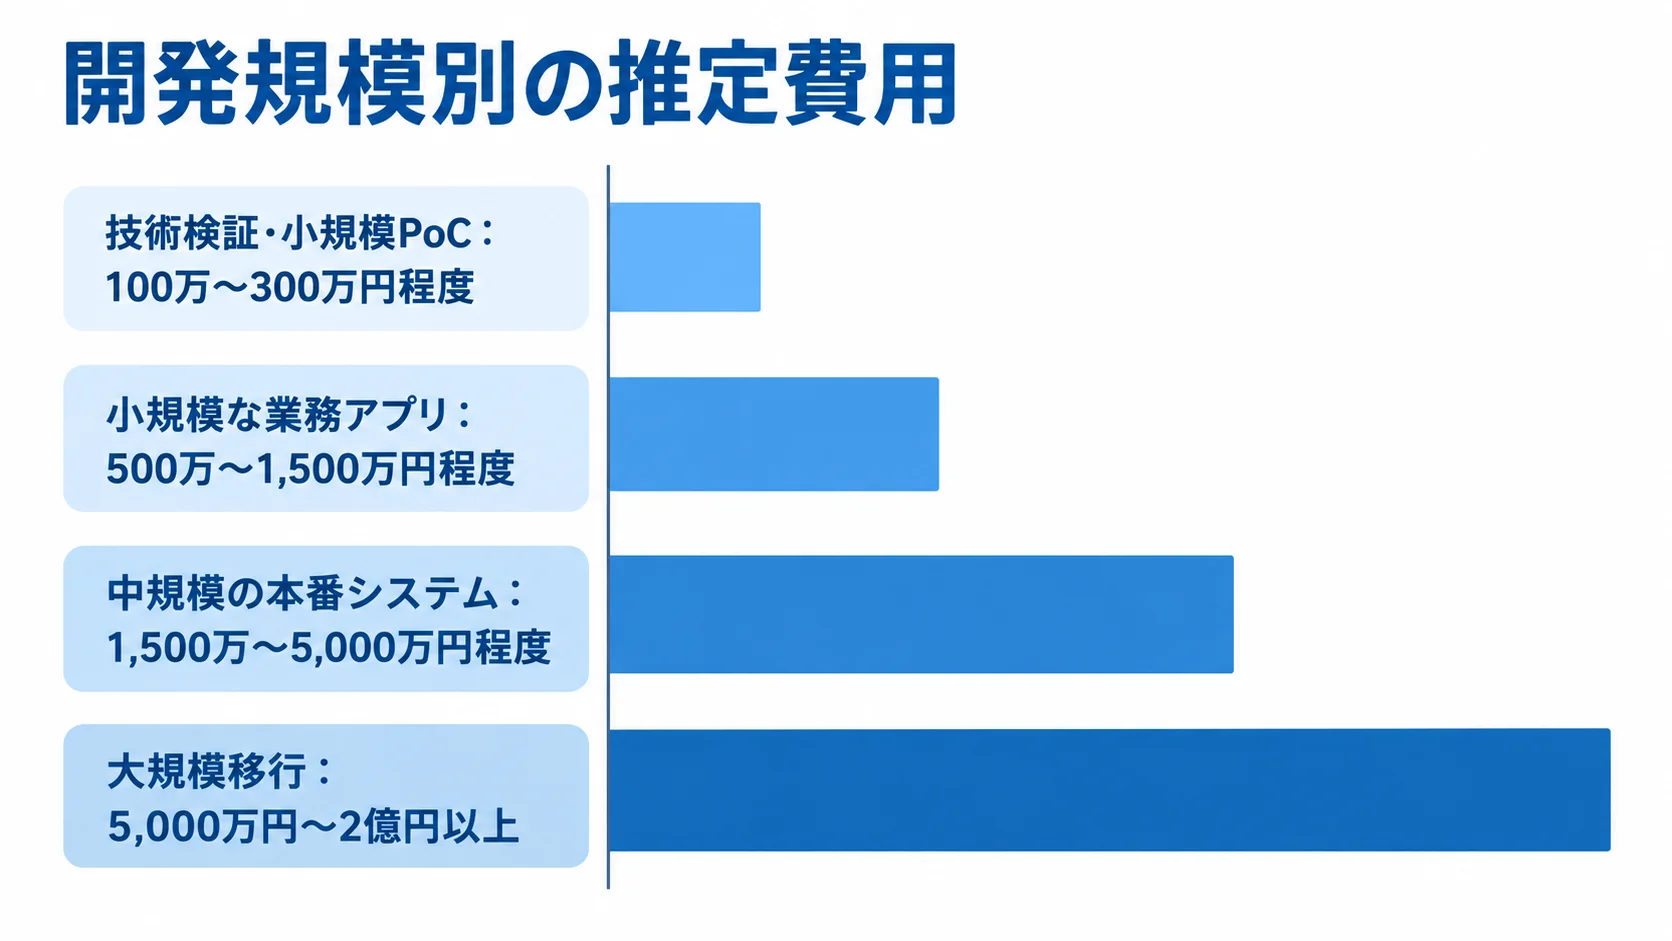
開発規模ごとの推定レンジは、含める機能や移行範囲によって異なります。
- 技術検証・小規模PoC:100万〜300万円程度、2〜6週間。row key設計、SDK・API試作、少量移行、負荷測定を含みます。
- 小規模な業務アプリ:500万〜1,500万円程度、2〜4か月。API、認証、単一クラスタ、監視、運用手順が対象です。
- 中規模の本番システム:1,500万〜5,000万円程度、4〜9か月が目安です。
- 大規模移行:5,000万円〜2億円以上、9〜18か月以上となる可能性があります。
中規模では、Pub/Sub・Dataflow・BigQuery連携、複数テーブルが入ります。さらに、権限、バックアップ、性能試験も含みます。一方で、大規模移行では、HBase・Cassandraからの移行に加え、複数リージョン、二重書き、DR、24時間運用まで含む想定です。
開発規模ごとの金額は、リサーチノートに基づく推定レンジで、特定の会社が提示する確定価格ではありません。
Google Cloudの利用料の課金対象
利用料は、エディションとクラスタのノード数、テーブルとバックアップのストレージで決まります。さらに、ネットワーク帯域も利用料に含まれます。料金を見積もるときは、課金対象と利用条件を分けて確認します。
- ノード:エディションとクラスタ数で変わり、プロビジョニング中は未使用時間も課金対象です。
- ストレージ・処理:SSDはGiB・時間単位、Data Boostは処理量に応じたサーバーレス課金です。
- 複数クラスタ:ノードとデータコピーが増え、リージョン間レプリケーションにも費用がかかります。
- 長期契約:割引率だけでなく最低利用額も確認します。
ノードは、利用量ではなくプロビジョニングしたリソースに対して課金されます(出典: Google Cloud「Bigtable pricing」、2026年8月確認)。
開発環境は、常時起動するか、営業時間外に縮小するかを決めておきます。ノードは未使用時間も課金対象のため、この判断が費用に直接響きます。
2026年8月の米国アイオワ料金は、Enterpriseが0.65米ドル、Enterprise Plusが0.85米ドル(1ノード・1時間)です。30日720時間、1クラスタ1ノードの場合は、ノード分がそれぞれ月468米ドルと612米ドルです。
1米ドル=160円で換算すると、約7.5万円・9.8万円です。ただし、実際の請求額は、リージョンや契約、為替、税で変わります。さらに、ストレージやネットワークの利用量でも変わります。
Committed Use Discountは、1年契約で20%、3年契約で40%の割引が示されています。ただし、最低利用額を継続する契約です(出典: Google Cloud「Committed use discounts」、2026年7月更新)。
PoCや負荷がまだ読めない初期段階では、割引率を見る前に、実測した最低利用量と解約・縮小の条件を確認します。
Google Bigtableの見積もりを取る際のポイント
見積もりは総額だけでなく、含まれる作業を同じ条件で比べます。データモデルやAPI、移行の境界が曖昧だと、後から追加費用が生じることがあります。監視やクラウド費用についても、境界が曖昧だと同じ問題が起きます。
見積もり前に準備する資料
見積もりの前に、要件と利用量を伝えられる資料をそろえます。移行品質や個人情報の扱いも、資料で示しておくと提案者が判断しやすくなります。
- 業務フロー、画面・API一覧、データ項目、既存DBの容量と増加量
- 平常時・ピーク時のQPSと応答時間、同時利用者数、保持期間と削除要件、RTO・RPO
- 稼働時間と既存システムの停止可能時間、row key未確定時の代表検索
- 移行対象のテーブルとレコード件数、NULLや重複、文字コード、時刻、過去データの欠損、差分更新頻度、移行後の参照期間、移行マスタと正解データ
- RFPに含める個人情報の分類と利用目的、アクセス担当、保管地域、削除・開示請求への対応
代表検索は「ユーザーの最新20件」「店舗ごとの1日分」「指定IDの現在値」などで示すと、提案者が設計の前提を立てられます。
移行マスタと正解データは、発注者側で用意しておかないと、移行品質を判定できません。
開発会社の提案の比較基準
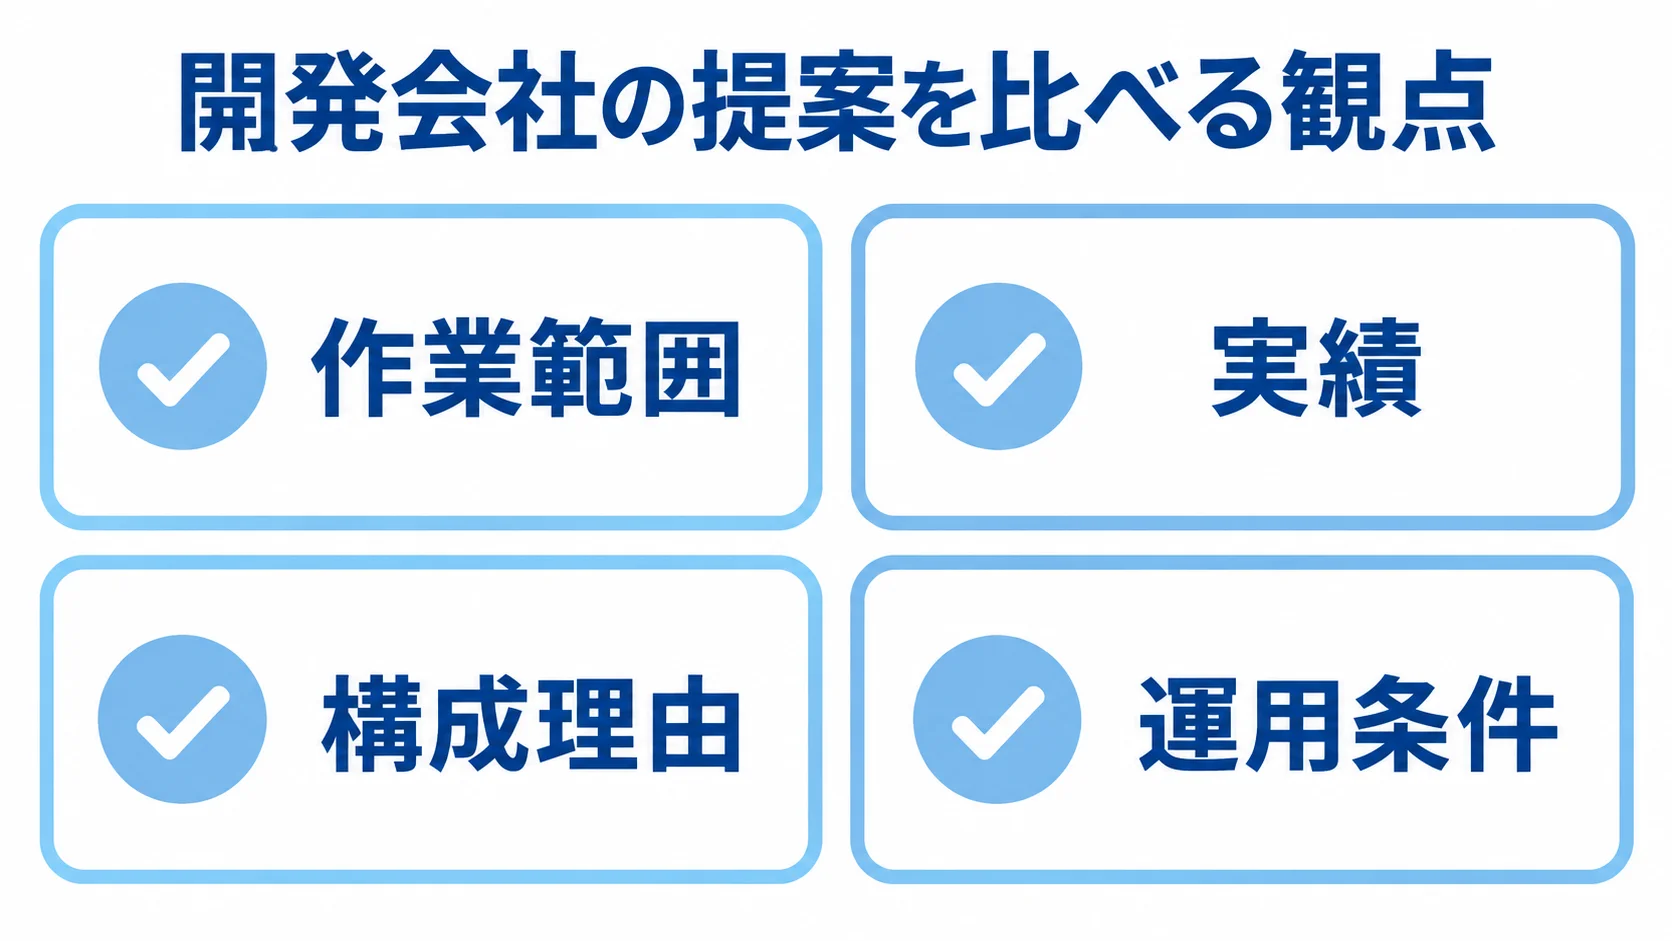
提案を比べるときは、作業範囲と性能実績を確認します。さらに、構成理由と運用後の条件も見ます。
- 作業範囲:要件整理、PoC、row key・スキーマ設計、API、連携、移行を並べます。試験、セキュリティ、監視、リリース、教育も並べます。
- 実績:QPS・レイテンシ、ホットスポット改善、移行後のデータ照合の経験
- 構成理由:Bigtableを使わない案や単一クラスタ案も含め、ノード数と追加費用の根拠を比べます。
- 運用条件:Data Boost・バックアップ課金、夜間縮小、障害時の責任、契約終了時のデータ取得の条件
提案書には「含む・含まない・前提条件」を記載してもらいます。資格やロゴよりも、実際の性能と改善実績を評価の中心に置きます。
提案者が「要件次第です」と答える場合は、必要な測定項目とPoC合格基準を示せるか確認します。
追加費用と失敗を防ぐ契約条件
追加費用を防ぐには、検証範囲、納品条件、変更時の扱いを契約に明記します。
- 検証・移行:row key候補数、負荷試験のデータ量・時間を定めます。移行対象、照合方法、切り替え回数も決めます。
- 納品・責任:納品物、ソースコード・IaCの帰属、障害対応時間、クラウドアカウント所有者を明記します。
- 追加作業:単価と、QPS・保持期間がどの範囲なら契約内かを決めます。
- 運用費用:監査ログ、バックアップ、転送、複製の費用を確認します。検証環境、負荷試験の増強、DataflowやPub/Subも対象にします。
監査ログは、管理操作とデータアクセスを分けて考えます。そのうえで、何を有効化し、何日保存し、誰が確認するかを運用設計に含めます(出典: Google Cloud「Cloud Bigtable API audit logging」、2026年7月確認)。
Google Bigtableのシステム開発でよくある質問
採用の可否、費用、移行に関する質問を順に見ていくと、自社で必要な検証を絞り込みやすくなります。
既存のRDBをGoogle Bigtableへそのまま置き換えられますか?
そのまま置き換えられるとは限りません。Bigtableは行キー中心のキーバリューストアで、複雑なJOINや複数行のトランザクションを前提とするRDBとは異なります。
現実的なのは、検索パターンをrow keyで表せる業務だけを移し、マスタや集計は別サービスに残す段階移行です。
小規模なシステムでもBigtableを選ぶ価値はありますか?
検索条件が少なく、将来のアクセス増加が見込まれる小規模システムなら、PoCで検討する価値があります。ノードの最低構成やプロビジョニング課金があるため、データ量が少なくても低コストとは限りません。
Cloud SQLやFirestoreなどと比べるときは、初期開発費、月額利用料、運用担当者の負荷を合算して見ます。
個人情報をBigtableに保存するときの注意点は何ですか?
暗号化とIAMの設定に加えて、データ分類と利用目的を整理します。さらに、最小権限、CMEKの鍵管理、VPC Service Controlsも決めておきます。
監査ログ、バックアップ、削除期限は、運用ルールとして決めておきます。委託先管理と漏えい時の連絡手順も、社内規程と運用に落とし込みます。
Bigtableは行・列・セル単位の権限制御に対応しません。テーブル分割やAuthorized View、アプリ側の認可で補えるかを、PoC前に確認します。
まとめ
開発を成功させる要点
Bigtable開発は6フェーズで進めます。各段階で判断基準を決めておくと、手戻りを防げます。
平常時とピーク時のQPS、p95・p99レイテンシ、保持期間を数値化します。さらに、RTO・RPO、整合性、国内保管の要否も決めておきます。row keyと想定クエリは、早期に負荷検証します。
PoCと見積もりへ進む準備
費用は、初期開発費、Google Cloud利用料、保守・監視費に分けます。そのうえで、データ量やQPS、クラスタ数から再計算します。移行範囲と連携サービスも、同じように再計算します。
- 技術検証・PoC:100万〜300万円程度
- 小規模な組み込み:500万〜1,500万円程度
- 中規模本番:1,500万〜5,000万円程度の目安
- 大規模移行:5,000万円〜2億円以上が推定レンジ
比較時はBigtableに限定せず、Cloud SQL、Spanner、Firestore、BigQueryとの役割分担も検討します。
相談時は、想定クエリとrow key案、性能目標を渡します。移行対象や、監視・復旧要件も伝えます。
PoCの合格基準、納品物、追加費用の条件まで確認すると、実装後の手戻りを抑えられます。
▼全体ガイドの記事
・Google Bigtableのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。