
Google Cloud Monitoringのシステム開発費用は、監視の範囲やデータ量、運用体制によって、100万〜3,000万円以上まで変わります。
費用を大きく左右するのは、監視する対象の広さ、集めるデータの量、そして導入後の運用を社内と委託先でどこまで分けるかです。
▼全体ガイドの記事
・Google Cloud Monitoringのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Cloud Monitoringのシステムの概要
Google Cloud Monitoringは、業務システムの可観測性を高めるクラウドサービスです。Google Cloud上のVM、コンテナ、データベース、ネットワーク、APIなどを監視し、メトリクス、ログ、トレース、イベントを集約して、異常の検知や復旧判断を支えます。業務アプリそのものを開発するサービスとは別物で、業務システムを見守る役割を担います。
インフラ監視と業務監視の両方の設計
監視設計では、インフラの状態と業務への影響を分けて整理します。
- インフラ指標:CPU、メモリ、ディスク、HTTPエラー率、レイテンシ、GKEのPod状態
- 業務影響:注文受付、決済API、在庫連携、夜間バッチの異常
- 検知手段:カスタム指標、ログベース指標、Uptime Check、SLO
顧客や現場が困る状態を先に定めると、必要な監視設定が見えてきます。
Cloud Monitoring単体と周辺サービスの使い分け
周辺サービスは、監視対象や既存の資産に応じて組み合わせます。
- Google Cloud連携:Cloud Logging、Cloud Trace、Error Reporting、Pub/Sub
- Kubernetes資産:Managed Service for Prometheus
- 既存の分析・運用:GrafanaやHinemos
Grafanaは既存ダッシュボードの活用に候補となります。一方で、Hinemosはジョブ管理やマルチクラウド統合にも候補となります。
製品は、監視対象、分析、既存運用、担当者のスキルごとに役割を分けて組み合わせます。そうすると、導入費と月額費を管理しやすくなります。
Google Cloud Monitoringのシステム開発の進め方
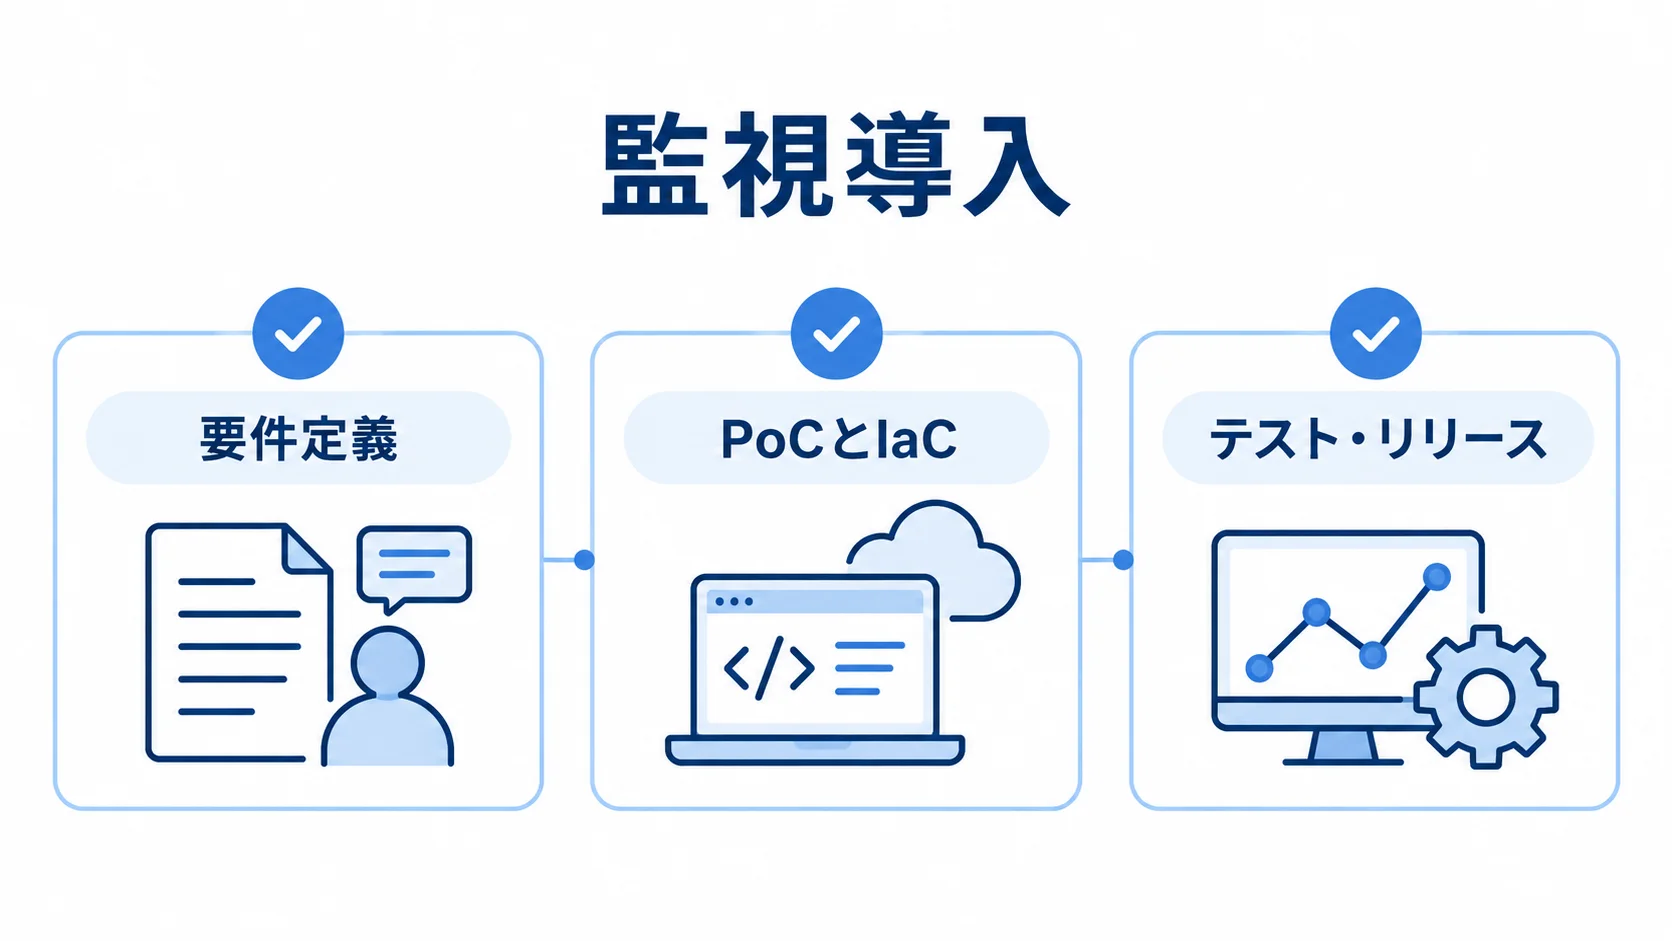
監視導入では、ダッシュボードの作成に加えて、業務影響とデータ量を整理することが欠かせません。そのうえで、PoCで検知から通知までを確かめ、本番へ展開します。
見積書で工程を分けてもらうと、要件定義から教育まで、必要な作業を一つずつ確認できます。
要件定義での業務影響とSLOの決定
要件定義では、監視対象と業務上の目標をはっきりさせます。
- 対象一覧:Google Cloudプロジェクト、GKE、VM、データベース、外部API、オンプレミス、バッチ、既存監視製品
- 事業上のSLO:注文受付の可用性、決済APIのレイテンシ、バッチ完了時刻
- 対応ルール:重大度、通知先、対応開始までの時間、エスカレーション先、メンテナンス時間、誤検知の扱い
CPUが80%を超えたら通知する設定は、利用者への影響や優先度を示しません。そこで、対応ルールまで定めておくと、監視設定を運用に結び付けられます。
PoCとIaCによる費用と運用性の早期確認
PoCでは、全社のリソースを一度に取り込まず、重要なサービスを一つ選びます。
- 計測・検知:標準指標、カスタム指標、ログとの相関、Uptime Check
- 通知・障害対応:Slackやメール通知、障害の再現、切り戻し
- 設定管理:ダッシュボード、アラート、通知チャネル、SLO、除外フィルタをTerraformなどでコード化
確認期間は2〜6週間程度です。その間に、実際の誤検知率とデータ量を把握し、開発・検証・本番の設定差分も管理します。
手作業で設定を積み上げると、担当が替わったときに再現できず、将来の改修費が膨らみやすくなります。
テスト・リリース後のアラートの見直し
テストでは、障害を意図的に発生させ、検知時間、通知先と回数、原因調査に必要なログを確認します。
本番後は、通知件数、誤検知率、検知から復旧までの時間、SLO違反、月間監視費用を毎週または毎月見直します。
初期設定で通知が多いと、担当者が通知を無視するアラート疲れにつながります。そこで、重要度の低い通知はまとめ、顧客影響の大きいものを優先します。
Google Cloud Monitoringの開発費用相場とコストの内訳
Google Cloud Monitoringの監視システム一式には、定額の開発パッケージがありません。初期費用は、工数の積み上げで決まります。
工数は、設計とアプリ計装、ダッシュボードとアラートの実装、テストに加えて、文書作成と教育にもかかります。さらに、Google Cloudの従量料金と、運用を委託する場合の月額費用は別途発生します。
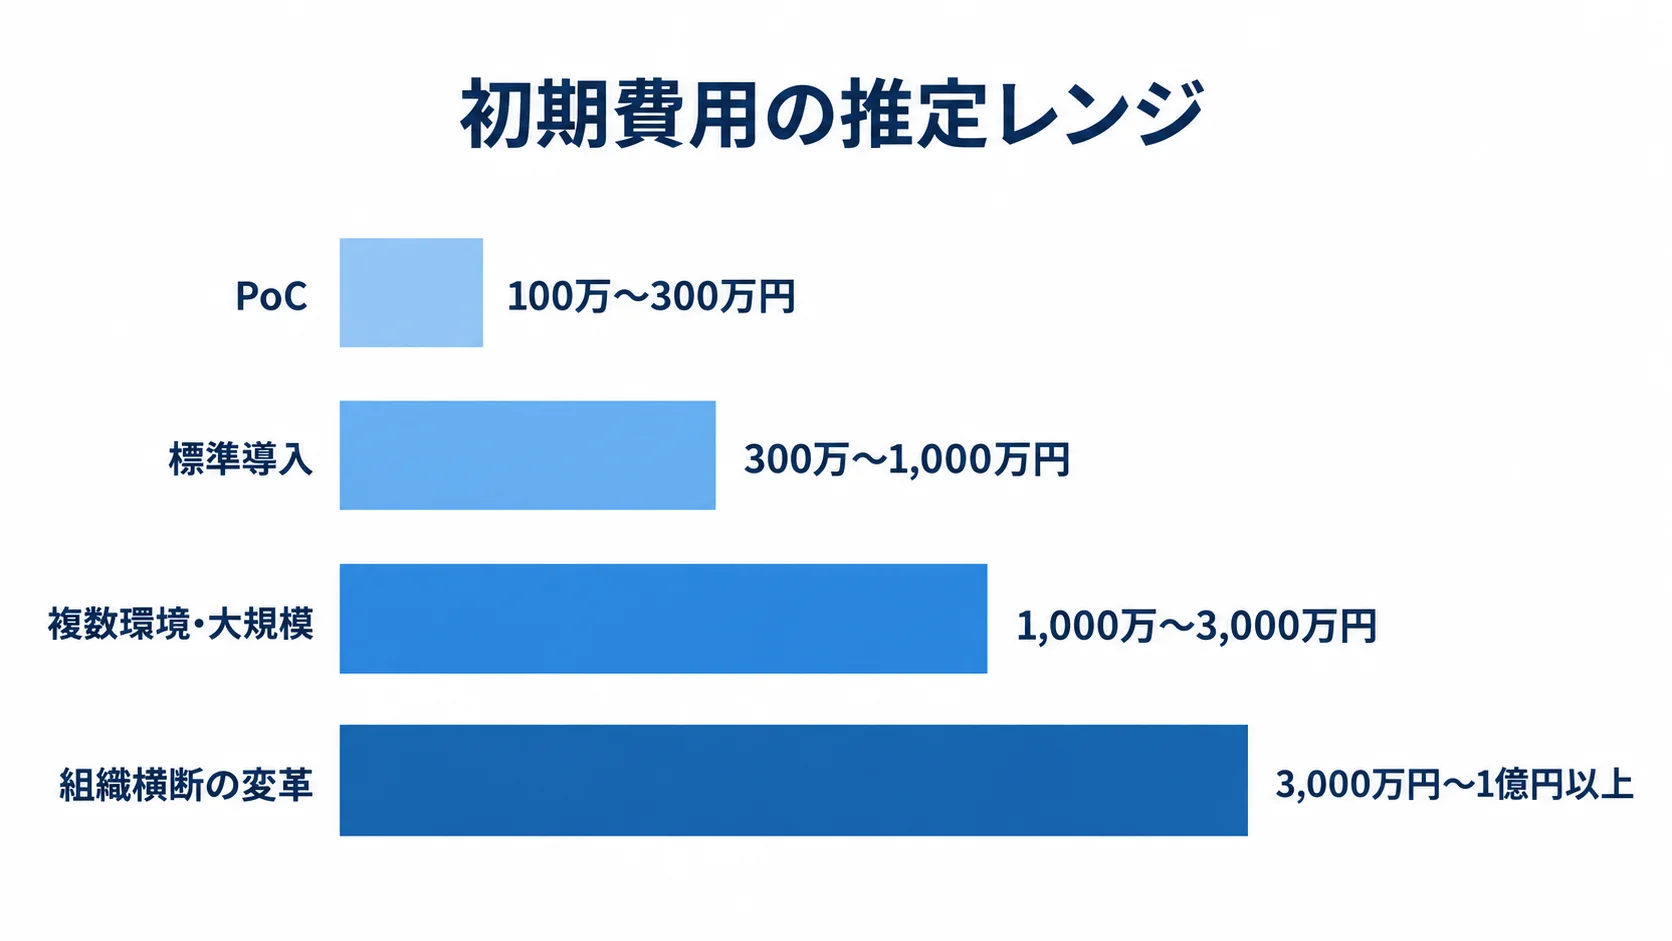
初期費用の推定レンジ(100万〜3,000万円以上)
初期費用の推定レンジは、対象範囲と導入規模によって変わります。
- PoC:1〜2プロジェクト、標準指標、数個のダッシュボード、基本アラート、メール・Slack通知、Terraformのひな形で100万〜300万円程度
- 標準導入:業務システム監視、カスタム指標、ログ連携、Uptime Check、SLO、権限分離、テスト、運用手順を含め300万〜1,000万円程度
- 複数環境・大規模:複数プロジェクト、オンプレミス、別クラウド、既存監視、Prometheus、長期保存、災害対策、24時間運用で1,000万〜3,000万円程度
- 組織横断の変革:数百〜数千サービス、業務KPI、SRE、エラーバジェット、監査対応、運用改革を含み、3,000万円〜1億円以上
期間の目安は、PoCが2〜6週間程度、標準導入が2〜4か月程度です。複数環境では4〜9か月程度で、大規模案件は9か月〜2年超の計画になる場合もあります。
初期費用と期間の目安は、業務システムの規模と工程をもとにした推定レンジで、公開されている定価ではありません。
見積書の工程別の費用内訳
標準的な案件では、工程別の配分を見積もりの比較軸にできます。あわせて、成果物と検収条件も確認しておきます。
- 要件定義・監視設計:全体の10〜15%
- ダッシュボード・アラート設計:15〜25%
- IaC・エージェントを含む実装:30〜40%
- テスト:15〜20%
- 移行・教育・運用引き継ぎ:10〜15%
アラート調整や障害訓練が別料金になっていると、契約後に総額が増える可能性があります。受入テストや運用手順書も、料金に含まれるかを確かめておきます。
人月単価は、中小開発会社で80万〜120万円程度、大手SIerで150万〜200万円程度というリサーチ上の比較レンジがあります。ただし、これは会社、役割、契約形態で変わる一般的な目安で、Cloud Monitoringの公式価格ではありません。
人数と期間は、設計者やクラウドエンジニアなどの役割ごとに分けてもらうと、比べやすくなります。
Google Cloud利用料と運用費の切り分け
Monitoringデータは取り込み量、Prometheusはサンプル数で料金が変わり、有人運用費も対応範囲で異なります。
- Monitoringデータ:Managed Service for Prometheus以外の一部は、最初の150MiBが課金対象外
- 従量単価:その後は1MiBあたり0.2580ドル、次の帯は0.1510ドル、250,000MiB超の部分は1MiBあたり0.0610ドル
- Prometheus:サンプル数と収集間隔で月額が変わる
この単価は、2026年8月に確認したGoogle Cloud公式Observability料金表に基づきます(出典: Google Cloud Observability料金表、2026年)。対象サービスや契約条件で扱いが異なるため、契約前にPricing Calculatorと実測値で確認します。
公式例では、100コンテナが各1,000時系列を60秒間隔で送ると、月4,380百万サンプルで262.80ドルです(出典: Google Cloud Observability pricing examples、料金計算例)。
同じ条件で15秒間隔にすると、月17,520百万サンプルで1,051.20ドルになります(出典: Google Cloud Observability pricing examples、料金計算例)。
1ドル150円を仮置きした場合は、約3.9万円と約15.8万円です。この試算は、為替や料金改定で変わります。特に、収集間隔と時系列数が月額を大きく左右します。
平日日中の監視設計、アラートチューニング、月次報告までなら、月10万〜50万円程度が目安です。一方で、24時間365日の一次対応、エスカレーション、障害報告、定例改善まで含めると、月50万〜200万円程度です。
これは技術者の稼働量から置いた目安で、Google Cloudの公開定価ではありません。見積もりでは、従量利用料と保守改修費を分けて示してもらいます。オンコールやログ保存費も、別の項目として見積もりに載せてもらいます。
費用を左右する変動要因とコスト最適化のポイント
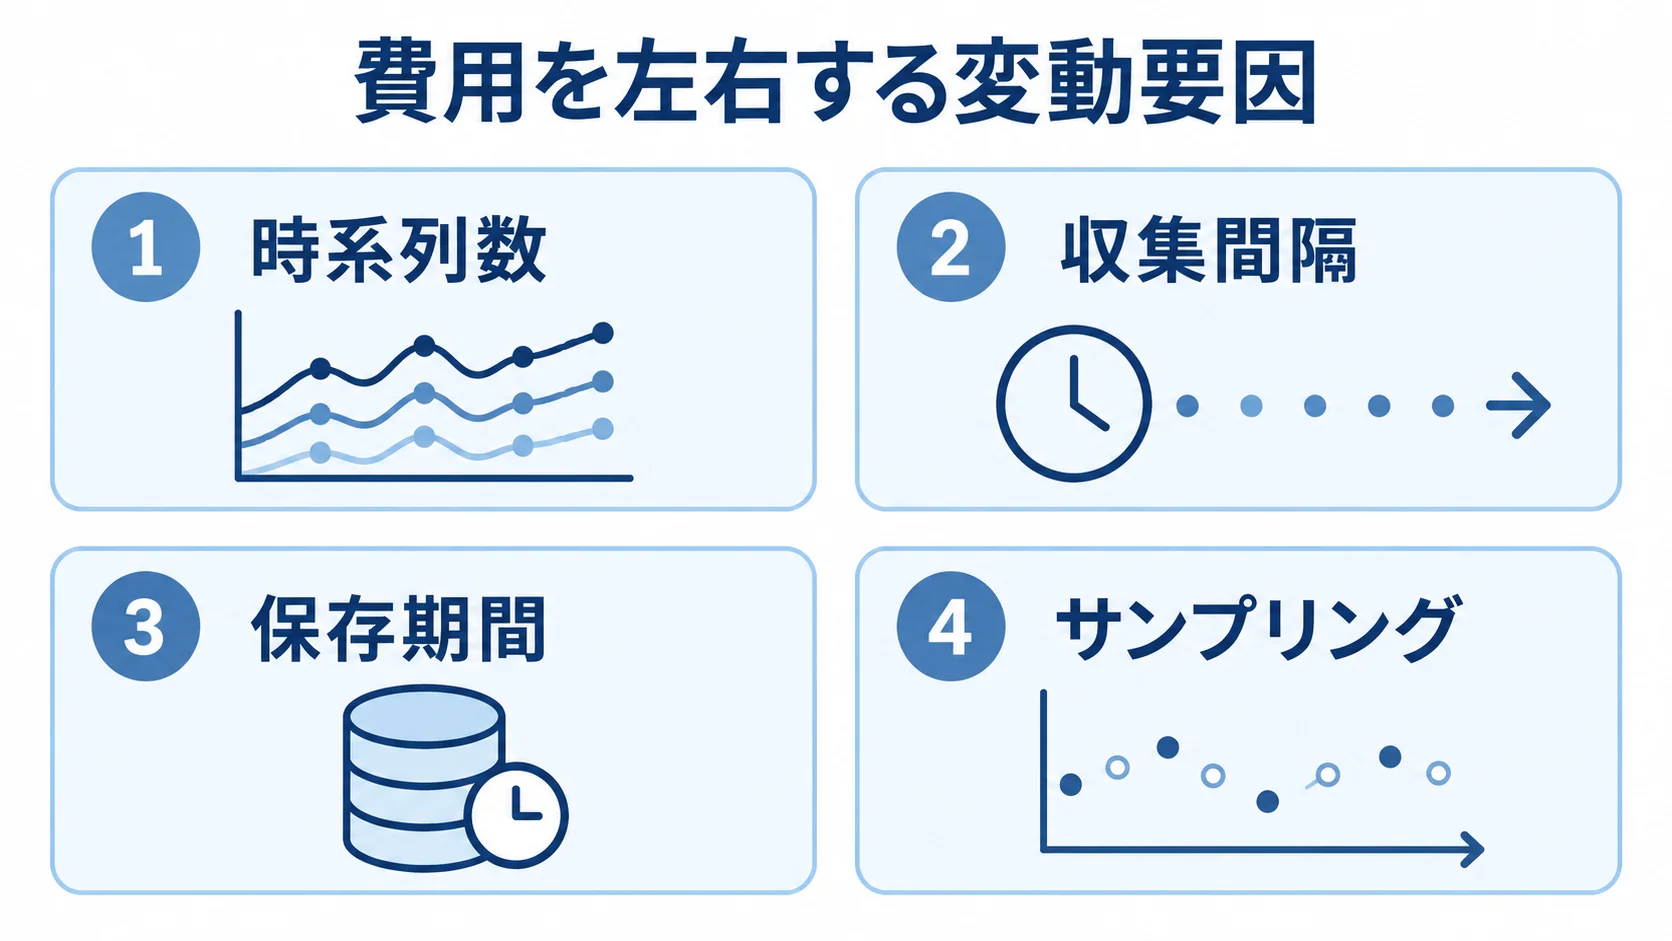
監視費用は、サーバーの台数だけでなく、指標の種類やラベルの組み合わせで増える時系列数や、収集間隔によっても変わります。そこで、顧客影響を守る監視を残し、不要なデータを削ります。
費用を左右する要素は、時系列数や収集間隔、保存期間です。ほかにも、ログ量やトレース、クエリ回数が費用に関わります。アラート構成や担当者の対応時間も、費用に響きます。
高カーディナリティのラベルの抑制
頻繁に変わる値をラベルに入れると、時系列が急増します。
- 避ける値:ユーザーID、注文番号、リクエストIDなど頻繁に変わる情報
- 限定する値:サービス名、環境、リージョンなど分析に必要な情報
- 個別情報の記録先:業務識別子はログやトレースに残す
たとえば、公式資料では、指標を出すVMが100台あり、10個の値を持つラベルが10個あると、組み合わせは100×10×10で10,000になります(出典: Google Cloud「Google Cloud Observabilityの費用を最適化してモニタリングする」、2026年確認)。
収集間隔・保存期間・サンプリングの業務別調整
指標の収集間隔は、SLOと用途に応じて調整します。すべてを15秒間隔で集める必要はありません。
- 決済API:数秒単位の検知が必要なら短い収集間隔
- 日次利用状況・容量計画:1分またはそれ以上の間隔
- ログ・トレース:短期調査と長期監査で保存先・期間を分け、エラーや遅延を中心にサンプリング
公式例では、同じ100コンテナ・1,000時系列でも、60秒間隔と15秒間隔で月間サンプル数が4,380百万と17,520百万に変わります。
トレースは、高トラフィックの全リクエストを無条件に保存せず、エラーや遅延を中心にサンプリングします。
アラートとクエリの集約による運用負荷の軽減
同じリソースを一台ずつ監視するより、サービス単位やフリート単位に集約した方が、ポリシー数と通知数を抑えられる場合があります。
- 集約単位:個別リソースよりサービス単位やフリート単位を検討
- 詳細調査:個別の状態はダッシュボードやログで追跡
- 一次通知:顧客影響とサービス単位で集約
Google Cloudの料金例では、100台を1つのポリシーにまとめる構成と、100個に分ける構成を比較しています。後者は、メトリクス参照費用が増える例です。
このため、異常の粒度を落とさずに詳細を追える設計にすれば、通知数や運用負荷を抑えられます。
導入事例の再現条件の確認
公開事例の成果は、自社の規模や運用条件と照らして判断します。
- 監視対象:対象システムと事業規模
- 運用状況:現状のMTTRと運用人数
- 導入条件:移行期間と改善KPI
IKS Healthは、Cloud MonitoringやCloud Loggingを含むリアルタイム可観測性を活用しました。平均復旧時間を30分未満に短縮し、インフラ費を30%削減したと紹介されています(出典: Google Cloud IKS Health case study、2026年確認)。
ただし、成果には18か月、150人超のコアチームによる変革と、同社固有の規模・運用改善が含まれます。そのため、同じ削減率や復旧時間を前提にするのではなく、自社条件で効果を試算します。
見積もりを取る際のポイントと開発会社の選び方
見積もりを比べる前に、監視対象と運用条件を同じ資料にまとめます。条件が曖昧なままだと、会社ごとに範囲が異なり、金額を比べられません。
RFPで初期費用とGoogle Cloud利用料を分けて示してもらうと、価格と提案の質を比べられます。保守改修費や有人運用費も、別々に書いてもらうとよいでしょう。
RFPに記載する監視量・SLO・通知・個人情報
RFPには、監視量、運用条件、セキュリティ要件を記載します。
- 対象とデータ:プロジェクト、VM、Pod、サービス数、指標、収集間隔、月間ログ量、保存期間、トレース、Uptime Check
- 運用条件:SLO、通知先、既存監視、バッチ・チケット連携、夜間対応、一次・二次対応の分界、月次報告、障害訓練、月額上限
- 個人情報:IPアドレス、ユーザーID、注文番号、自由記述のエラーメッセージのマスキング、権限、保存場所・期間、委託先権限
個人情報などがログに入る可能性があるため、アクセス権と保存条件も確認します。
複数社の同条件での比較と成果物の確認
Google Cloudの認定や導入実績に加えて、設計から引き継ぎまで担えるか、納品物は何かを比べます。
- 技術力:監視設計とアプリ計装を担い、障害を再現して原因を説明できる
- 設定納品:Terraformやアラート定義を納品する
- 契約成果物:PoC成果物、設計書、ダッシュボード定義、アラート一覧、テスト結果、手順書、障害履歴、引き継ぎ研修
Cloud Monitoring単独か、Prometheus、Grafana、Hinemosなどと連携するかで、必要な経験は異なります。
成果物を契約に含めておくと、将来の内製化や他社への切り替えにつながります。
セキュリティと契約上の責任分界の事前決定
セキュリティ要件と障害時の担当を、契約前に明確にします。
- アクセス制御:IAMの最小権限、MFA、サービスアカウント分離、ベンダーのアクセス記録
- 変更管理:監視設定の承認と監査ログの確認方法
- データ保護:個人情報・秘密情報の混入防止、暗号化、ネットワーク接続
- 責任分界:検知後の復旧担当と停止判断の担当
Monitoring APIの操作は、Google Cloudの監査ログに記録できます。そのうえで、誰が確認し、設定変更をどう承認するかは、自社と委託先で設計します。
特に、復旧担当や停止判断が決まっていない状態で24時間監視を契約すると、通知後の復旧が遅れる可能性があります。
よくある質問(FAQ)
見積もりの前によく寄せられる、費用と導入方法の質問をまとめました。
料金は構成や契約で変わるため、固定の価格ではありません。判断に必要な条件を、あわせて確認しましょう。
Google Cloud Monitoringの導入は最低いくらかかりますか?
少数プロジェクトで標準指標と基本アラートを試すPoCなら、初期費用は100万〜300万円程度が推定目安です。
ただし、従量料金、ログ保存、既存システムへの計装、24時間運用は、別費用になる場合があります。業務KPIや複数環境まで含めると、300万〜1,000万円程度へ広がります。
Cloud Monitoringは無料で使えますか?
標準指標には無料枠や課金対象外のものがありますが、すべての監視データが無料になるわけではありません。
カスタム指標、Prometheus形式のサンプル、ログ、トレースは、課金される可能性があります。APIクエリや保存、データ転送なども、データ量や使い方によって料金が生じることがあります。
利用量は、Pricing Calculator、請求レポート、メトリクス管理画面で確認します。
既存の監視製品はCloud Monitoringに置き換えるべきですか?
Google Cloudの標準指標とアラートは、Cloud Monitoringで扱えます。そのため、既存の監視製品を置き換えるかどうかは、判断材料の一つになります。
一方で、ジョブ管理や長期保存、マルチクラウド、既存のオンコール運用は、従来製品に残す構成も選べます。
移行費や二重運用費、担当者の習熟、障害時の責任分界を比べ、重要サービスの一部でPoCを行いながら段階的に判断すると、全面移行のリスクを抑えられます。
費用を抑えながら重要な監視を残すにはどうすればよいですか?
重要サービスのSLOと障害シナリオを先に定め、不要な高カーディナリティラベルを削ります。
指標の収集間隔とトレースのサンプリングを調整し、ログの保持期間とアクセス頻度も見直します。
アラートはサービス単位にまとめ、毎月の利用量と請求額を確認します。そのうえで、顧客影響の検知に必要なデータに予算を振り向けます。
まとめ
開発費の目安は、PoCなら100万〜300万円程度です。標準的な業務システム監視なら300万〜1,000万円程度で、複数システムや24時間運用まで含めると1,000万〜3,000万円以上が推定目安です。
従量料金は、メトリクスの種類と量やPrometheusのサンプル数で変わります。ログやトレース、クエリ、保存期間も、料金に関わります。
予算の初期・クラウド・運用の3区分
見積もりでは、開発会社への初期費用、Google Cloudの月額利用料、保守・有人運用費を別々に提示してもらいます。
RFPには、監視対象、データ量、SLOを記載します。通知先や既存監視、セキュリティ条件などは、前の節の項目に沿って書き込みます。そのうえで、複数社を同じ条件で比べます。
障害訓練や運用引き継ぎも含め、導入後に使い続けられる金額かを判断します。
重要サービスのPoCからの開始
PoCの結果を使い、次の見積もりを自社の条件に近づけます。
- 顧客や売上への影響が大きいサービスを一つ選ぶ
- 検知から復旧判断までの流れを試す
指標数やサンプル数、ログ量を実測します。通知件数や作業時間も記録し、次の見積もりに反映すれば、自社条件に近い推定ができます。
監視の導入で障害が減るとは限りません。SLOと運用責任を含め、費用対効果を評価します。
▼全体ガイドの記事
・Google Cloud Monitoringのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。