
Google Cloud Monitoringの全体像は、監視データの種類、導入手順、費用、運用体制の4つで整理できます。業務上の異常検知から復旧判断までを支える監視基盤です。
各テーマの詳しい内容は、下に並べた関連記事で確認できます。
▼関連記事一覧
・Google Cloud Monitoringのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Google Cloud Monitoringのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Google Cloud Monitoringのシステム開発の見積相場や費用/コスト/値段について
・Google Cloud Monitoringのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Cloud Monitoringのシステムの概要
Google Cloud Monitoringは、業務システムを継続的に観測し、問題を知らせるObservability(可観測性)の中核サービスです。業務アプリケーションを開発するサービスとは役割が異なり、観測と通知を担います。
Google Cloud各サービスの標準メトリクスを自動収集できます。さらに、必要に応じて独自指標、Prometheus形式の指標、外部環境のデータも組み合わせられます(出典:Google Cloud公式「Cloud Monitoring overview」、2026年)。
監視対象はCPUだけでなく業務の状態
従来のインフラ監視では、CPU使用率、メモリ、ディスク容量、ネットワーク転送量などをしきい値で確認してきました。これらは重要です。ただし、CPU使用率が低くても業務上の障害は起こり得ます。
監視対象は「サービスが動いているか」だけでなく、「利用者が目的の処理を完了できるか」まで広げます。
- 決済:APIの失敗と決済失敗率
- 注文:注文完了画面のエラーと注文確定率
- 在庫・バッチ:連携の遅延と夜間処理の未完了
たとえばECサイトでは、リクエスト数、エラー率、95パーセンタイルの応答時間を見ます。基幹システムでは、連携ファイルの到着、処理件数、滞留キュー、締め処理の完了時刻が指標になります。
Cloud Monitoringでは、カスタムメトリクスやログベースの指標を作れます。アプリ側で業務上の異常を数値化すると、対応すべきアラートを絞りやすくなります。
標準構成は収集・分析・通知・対応の4層
Google Cloud Monitoringのシステムは、データの収集、分析、通知、対応の4層で捉えると役割が分かります。
- 収集:アプリ、コンテナ、仮想マシン、DB、外部APIからデータを集める
- 分析:Cloud Monitoring・Cloud Logging・Cloud Traceでのデータ確認
- 通知:ダッシュボード、アラートポリシー、SLOの設定と、各担当先への連絡
- 対応:検知した異常を復旧作業につなげる
通知先には、チャット、メール、チケット、オンコールがあります。さらに、各設定はTerraformなどのコードで管理できます。
画面上だけで設定すると、開発・検証・本番の差分や、担当者の退職による属人化が起こり得ます。そのため、設定の変更履歴をレビューして、これらを抑えます。
特に、検知後に誰が何分以内に何をするかを決めておくことは、ツールを選ぶ以上に大切です。
Google Cloud Monitoringの種類と構成要素
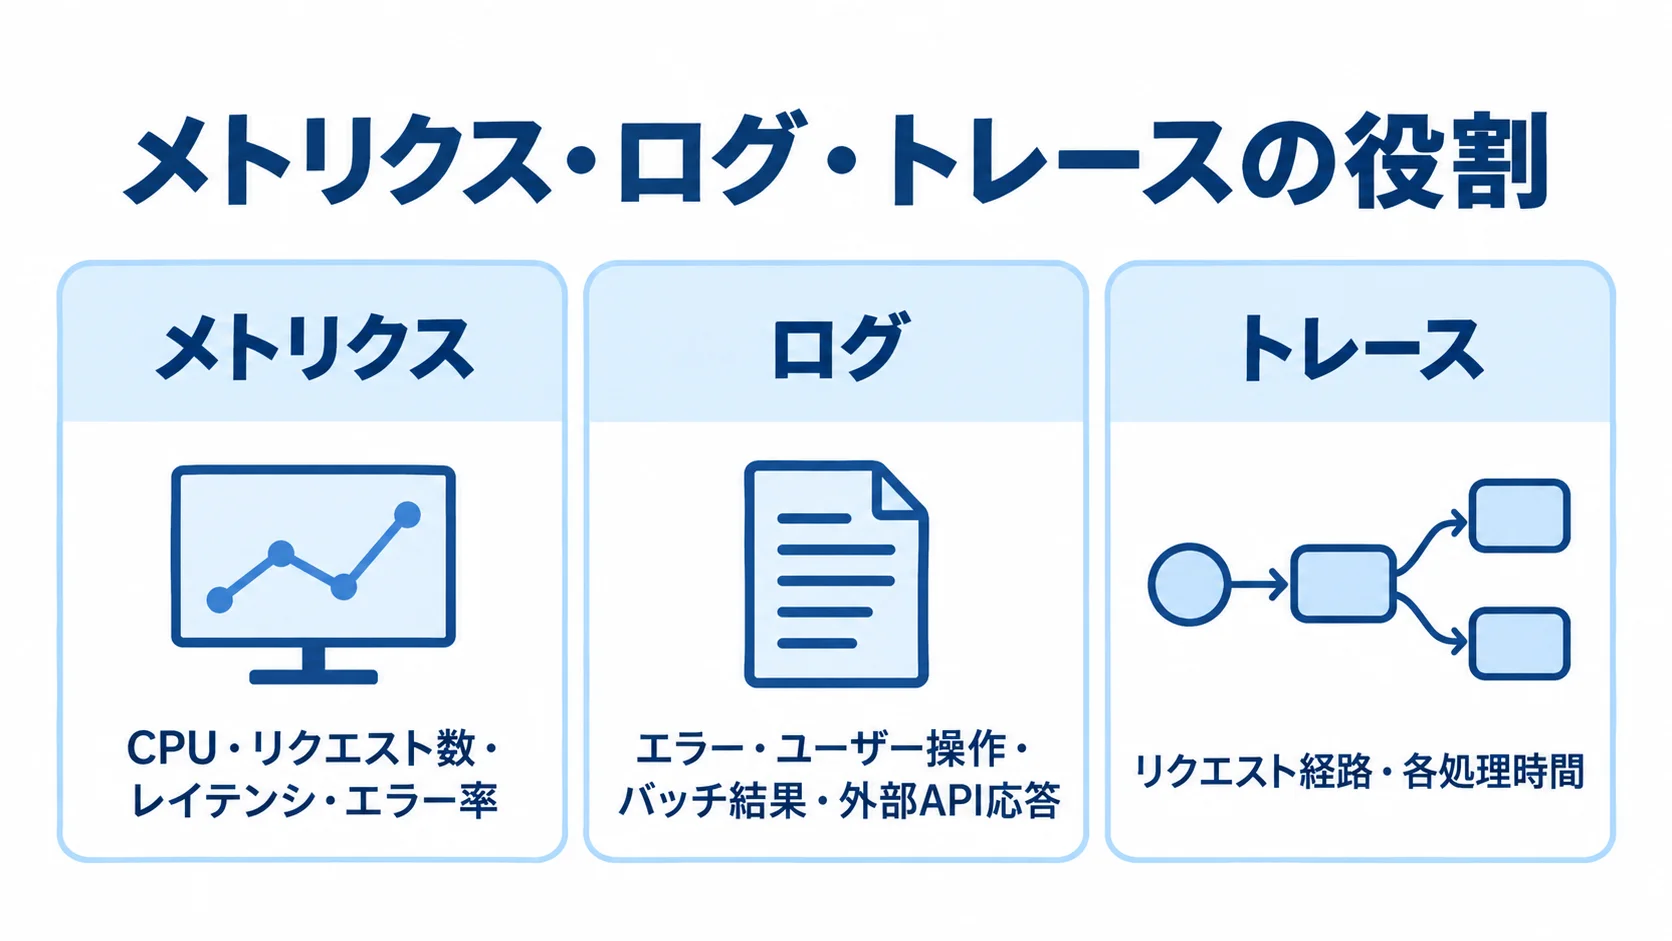
監視対象を増やしても、必ずしも安心につながるとは限りません。そこで、重要なサービスの状態を原因調査に使える粒度で集め、費用と運用負荷の釣り合いを取ります。業務システムで使う主要なデータと機能は、役割ごとに分けて見ていきます。
メトリクス・ログ・トレースの目的の違い
メトリクス、ログ、トレースは、それぞれ異なる目的で使い分けます。
- メトリクス:CPU、リクエスト数、レイテンシ、エラー率を時系列で追い、異常検知やSLO計測に使う
- ログ:エラー、ユーザー操作、バッチ結果、外部API応答から発生事象を調べる
- トレース:1つのリクエストが複数サービスを通る経路と、各処理時間の確認
たとえば、注文完了率が下がった場合は、メトリクスで時刻と影響範囲を確認します。次に、トレースで遅いサービスを特定し、ログで外部決済のエラーコードを調べます。
サービス名、環境名、リクエストID、リリース番号を共通で付けておくと、3種類のデータを関連付けて原因を調べられます。
アラート・SLO・Uptime Checkによる利用者目線
アラートは、対応が必要な状態を担当者へ伝える仕組みです。ただし、CPUの一時的な上昇だけで通知すると、不要な通知が増えることがあります。
- 継続する異常:エラー率が5分間上昇した状態の検知
- 決済の異常:失敗率が通常の2倍になった状態を捉える
- SLOの逼迫:エラーバジェットを使い切りそうな状態の通知
重要度を緊急・高・中・低に分け、重要度ごとに通知先と対応期限を変えます。これにより、担当者は優先度に応じて対応できます。
SLOは、可用性やレイテンシなどで守る水準を定めた目標です。SLAが契約上の約束であるのに対し、SLOは開発・運用チームが改善判断に使います。
Uptime Checkは、HTTP、HTTPS、TCPなどの接続を外部から定期的に確かめます。サーバーが稼働していても、ログインや検索が使えない問題を見つけるのに役立ちます。また、公開エンドポイントと非公開サービスでは、アクセス方式と権限を分けて設計します。
単体利用と既存ツール連携の選び方
単体利用にするか既存ツールと連携するかは、既存資産や監視対象で決まります。
- Cloud Monitoring中心:Google Cloudの標準指標と基本アラートを短期間で用意する
- Prometheus併用:KubernetesのPrometheus資産を生かす
- 外部連携:複数クラウドやオンプレミスをまとめて運用する場合に検討する
業務ジョブ、長期保存、既存チケット管理まで扱うなら、外部の統合運用製品や、データを見える形にするツールが合う場合もあります。
製品名を選ぶより先に、データの保存先、確認する担当者と画面、復旧作業を始める条件を決めることが大切です。
既存監視はすぐに廃止せず、重複アラートを整理しながら段階的に移行します。そうすると、監視の空白と二重運用の負担を抑えられます。
Google Cloud Monitoringのシステム開発・導入の進め方
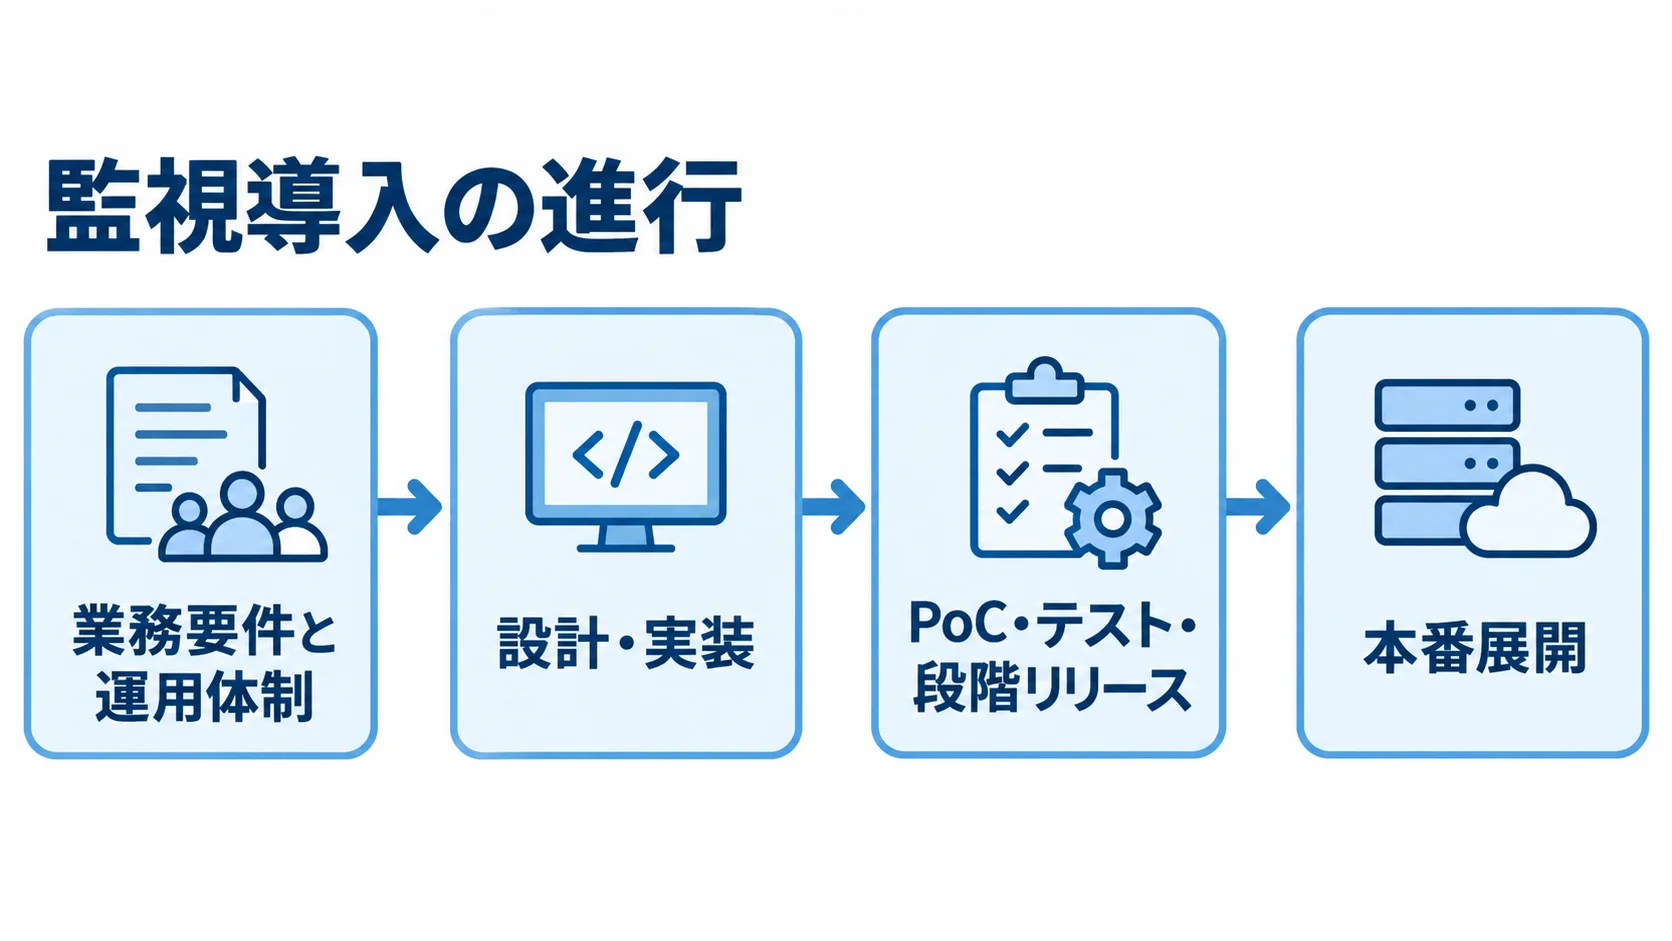
監視の導入は、業務要件と運用体制を設計してから設定を入れる開発です。全プロジェクトと全ログを取り込むと、費用と通知が膨らみ、重要な異常が埋もれてしまいます。
まず重要業務を一つ選び、PoCで検証してから本番へ広げます。
▶ 詳細はこちら:Google Cloud Monitoringのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義での業務影響と責任分界
最初に、監視の目的を業務への影響として言葉にします。そのうえで、業務目標、対象範囲、対応体制を具体的に決めます。
- 業務目標:「注文受付を5分以上止めない」「決済APIの95パーセンタイルを1秒以内」などの目標を立てる
- 対象範囲:夜間バッチを午前7時までに完了させる目標、対象サービス、稼働時間、繁忙期を整理する
- 制約と体制:停止時間、RTO、RPO、保存期間、個人情報、担当者、期限を洗い出す
- 連絡と分担:一次対応期限、二次対応へのエスカレーション、休日・夜間の連絡方法を決める
開発会社へ委託する場合は、復旧作業まで含むのか、通知だけなのか、障害原因を誰が調べるのかを契約書に明記します。要件定義を短縮しすぎると、後から通知先や監視範囲の変更が続き、工数が増えます。
設計・実装でのデータと設定のコード化
設計・実装では、対象ごとに取得するデータを決め、設定をコードに落とし込みます。
- 対象:アプリ、コンテナ、VM、DB、外部API、バッチ、ネットワークを洗い出し、取得データを決める
- 計装・指標:標準指標で足りない場合はOpenTelemetryを追加し、注文件数、処理時間、失敗理由を測定
- ログ:サービス名、環境、リリース番号、リクエストIDを付けて、相関分析に使う
- 構成管理:ダッシュボード、アラート、通知、SLO、保守期間、除外条件をTerraformやAPIで再現できる状態
- 成果物:設定ファイル、構成図、監視項目一覧、対応表、運用手順、連絡網
開発・検証・本番のプロジェクトや権限を分け、変更レビューと承認を必須にします。これにより、誤操作によるアラート削除や本番設定の上書きを防げます。
PoC・テスト・段階リリースによる現実の負荷の確認
PoC・テスト・段階リリースで、検知と対応、そして費用を確かめます。
- 重要業務を一つ選び、標準・アプリ指標、ログ、トレース、Uptime Check、通知をつなぐ
- エラーを起こして、検知時間、通知先、原因説明、切り戻しを見る
- 収集間隔やラベル数を変えたときの、1か月相当の費用を試算する
- 重要サービス、共通基盤、周辺サービスの順に本番展開し、各段階で受入テストを行う
- 週次または月次で、MTTR、検知率、誤検知率、通知件数、SLO違反、監視費用を確かめる
対応が要らないアラートは統合や抑制をして、実際の障害で役立った条件を残しておきます。改善を継続的に回すことが必要です。
Google Cloud Monitoringの費用相場とコストの内訳
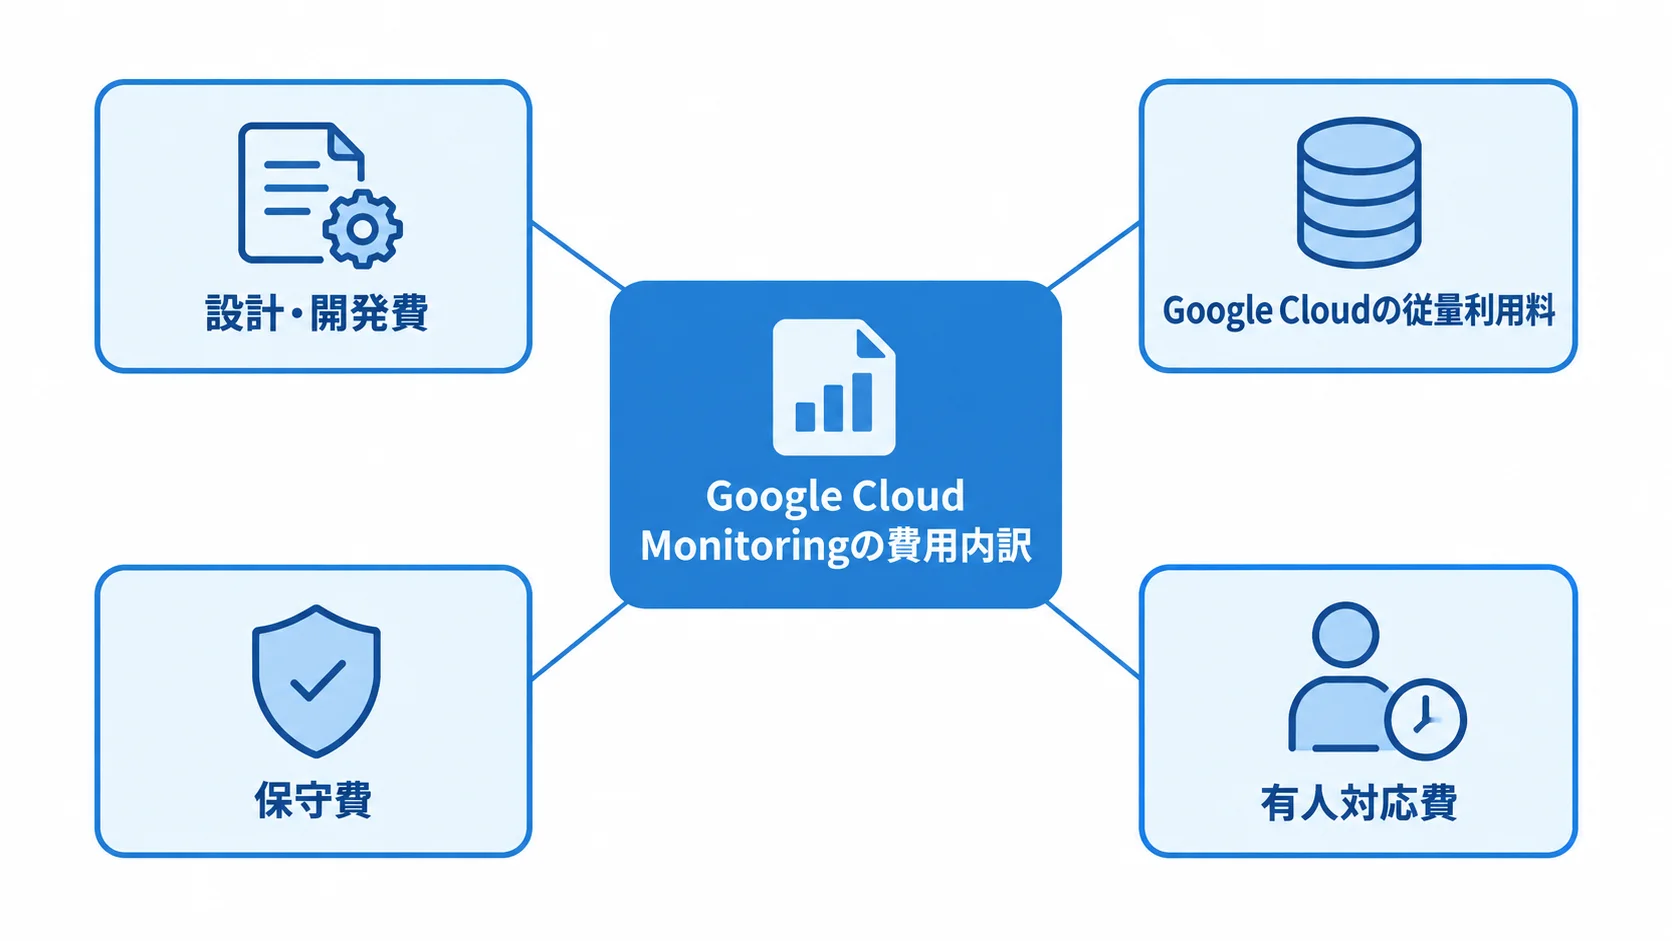
Google Cloud Monitoringには、監視システム一式の固定価格がありません。そのため、費用は設計・開発費、Google Cloudの従量利用料、導入後の保守・有人運用費に分けて考えます。
下に挙げる初期費用は、対象範囲と連携数を置いた2026年時点の一般的な推定目安で、公式の定額表ではありません。費用は、プロジェクト数、Pod数、指標数によって変わります。ログ量、保存期間、通知先、24時間対応の有無も費用に響きます。
▶ 詳細はこちら:Google Cloud Monitoringのシステム開発の見積相場や費用/コスト/値段について
初期の設計・開発費の幅(100万円から数千万円)
初期費用と期間は、対象規模と監視範囲によって変わります。
- PoC・小規模:100万〜300万円程度、2〜6週間。
- 標準的な業務システム:300万〜1,000万円程度、2〜4か月。
- 複数環境・24時間運用:1,000万〜3,000万円程度、4〜9か月。
- 大規模基幹システム:3,000万円超、1億円以上になるケースもあります。
小規模では、1〜2プロジェクトを対象に、標準指標と基本アラートを用意します。ダッシュボードは数個で、チャット・メール通知とTerraform雛形も加えます。
標準規模は、複数プロジェクトを対象に、コンテナ、VM、DBの監視を含みます。さらに、カスタム指標とログ連携、SLOを扱います。権限分離、テスト、運用手順もその中に入ります。
複数クラウドやオンプレミスの規模になると、既存監視も対象に入ります。また、業務ジョブや長期保存、災害対策も対象です。
数百以上のサービスを組織全体で観測し、SREや監査対応、段階移行まで行う大規模基幹システムもあります。見積書は、要件定義、設計、実装を工程ごとに分けてもらいます。さらに、テスト、移行、教育、引き継ぎも、それぞれ別の項目として示してもらいます。
従量利用料を左右するデータ量・収集間隔・保持期間
従量料金は、データ量、収集間隔、保持期間を確かめながら試算します。
- 収集量:監視対象と時系列の数がサンプル量を左右する
- 収集間隔:短くすると、同じ対象でもデータ量が増える
- 抑制策:全データを高頻度で集めず、検知用指標と原因調査用ログを分ける
- データ整理:高カーディナリティのラベルや不要なログを抑え、保持期間を用途別にする
- 予算管理:アラートを集約し、請求先アカウント単位で利用量と予算アラートを見る
公式の例では、100コンテナがそれぞれ1,000時系列を送る場合、60秒間隔で月4,380百万サンプル、262.80米ドルです。
同じ条件で15秒間隔にすると、月17,520百万サンプル、1,051.20米ドルです。
つまり、データ量は4倍、料金例も約4倍です(出典:Google Cloud「Pricing examples for Google Cloud Observability」、2025年10月2日時点)。
この例はPrometheus指標だけの計算で、ログ、トレース、保存の費用は含みません。クエリ、通知、転送、導入支援費も含まれていません。料金は契約条件や改定で変わるため、発注前に公式料金表と計算ツールで再計算します。
導入後の保守費と有人対応費
導入後の委託費は、対応時間とサービス範囲によって異なります。
- 平日日中:監視設計や調整は月10万〜50万円程度の推定
- 24時間365日:一次対応などを含めて月50万〜200万円程度が比較の目安
- 総額確認:初期費用だけでなく、利用料、保守、改修、保存、通知、教育、障害時費用を合算する
これらは公開定価ではありません。24時間対応の推定は人件費をもとにしており、対応時間、対象サービス、オンコール人数、復旧作業の範囲で変わります。
アラート調整と障害訓練が対象外だと、稼働後に追加費用が発生しやすくなります。設計書、設定ファイル、運用手順も、範囲に入っているかを見積もりで確かめておきます。
Google Cloud Monitoringの開発会社・サービスの選び方
開発会社や運用サービスを比べるときは、Google Cloudへの対応の有無に加えて、業務要件に沿った支援ができるかを見ます。見るのは、監視項目の設計、アプリ計装、ダッシュボードやアラートの作り方です。さらに、障害対応や費用管理、内製化まで支援できるかも確かめます。
監視設定だけを納品するのか、検知後の復旧まで担うのかで、必要な体制と契約金額は大きく変わります。
実績の確認:製品名より監視対象と成果
提案を受ける前に条件をそろえ、監視対象と導入後の成果を確かめます。
- 前提条件:構成、月間データ量、SLO、既存監視、通知先、夜間対応を伝える
- 導入成果:監視サービス、障害シナリオ、検知時間、復旧時間の変化を尋ねる
- 経験の近さ:業種だけでなく、規模や運用体制が近い事例を重視する
Google Cloudの公式事例では、Cloud Runなどを活用してクラウドインフラ費を40%削減し、ゼロダウンタイムを達成した例があります。
別の医療系事例では、Cloud MonitoringとCloud Loggingを含む構成で、MTTRを30分未満にしたと報告されています。
インフラ費は30%削減したとのことです(出典:Google Cloud公式導入事例、2026年)。
これらは個別環境の結果なので、自社で同じ数値になる保証はありません。そのため、成果を生んだ監視設計と運用改善の内容まで確かめます。
技術力と運用体制の評価
技術と運用の両面で、必要な設計や対応を担えるかを確かめます。
- 監視技術:標準・カスタム指標、ログ、トレース、Prometheus、OpenTelemetry、Terraform、API
- 統合設計:複数プロジェクトや外部環境の権限、メトリクススコープ、保存先、ラベル設計
- アラート設計:相関付け、集約、抑制、メンテナンス時間の設計も評価の対象
- 運用体制:一次対応時間、休日連絡、エスカレーション、責任分界、報告、改善会議
内製化や他社への切り替えに備えて、契約に所有権と納品範囲を盛り込みます。対象は、Terraformのソースやアラート定義、ダッシュボードです。さらに、監視項目一覧や障害履歴、運用手順も含めます。
特定の担当者しか変更できない状態や、設定を持ち出せない状態は、長期的なリスクになります。
RFPでの費用とセキュリティの質問
RFPでは、比較条件とセキュリティ要件を具体的に示します。条件がそろわない見積もりは、金額が安く見えても比べられません。
- 見積条件:対象数、指標・ログ量、収集間隔、保持期間、SLO、通知先、既存ツールを指定する
- 成果物:改修、対応時間、障害テスト、誤検知調整、月額料、費用上限の管理を明記する
- アクセス管理:最小権限、アカウント分離、多要素認証、変更承認、委託先の記録を確認する
- データ保護:保存先、暗号化、個人情報・秘密情報のマスキングを対象にする
監査ログはサービス名monitoring.googleapis.comで絞り込み、権限に応じた管理操作やデータアクセスを記録できます(出典:Google Cloud「Monitoring audit logging」、2026年)。
監査要件がある場合は、誰が、どの期間、どの場所でログを確認するかを決めておきます。個人情報やカード情報が混入する可能性があるなら、導入前にアプリのマスキングと出力項目を見直します。
クラウドのリージョンに加えて、提供者や再委託先、国外アクセスを確かめます。さらに、利用目的、安全管理措置、契約上の役割も、法務・セキュリティ部門と確認します。
▶ 詳細はこちら:Google Cloud Monitoringのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Google Cloud Monitoringのシステム開発の発注/外注/依頼/委託方法について
よくある質問(FAQ)
導入の際には、料金、既存監視との関係、個人情報の扱いについての質問が多く寄せられます。導入前に確認したい疑問に、順に答えます。
Google Cloud Monitoringは無料で使えますか?
一部の利用量には無料枠がありますが、監視システム全体を無料で運用できるとは限りません。
費用は、メトリクス、Prometheusサンプル、ログ、トレースなどの量に応じて発生します。保存、クエリ、通知、データ転送も費用の対象になります。
対象数と収集間隔をもとに、料金計算ツールで試算します。開発会社に依頼する場合は、Google Cloudの利用料と設計・運用の人件費を分けて確かめます。
既存の監視ツールは廃止したほうがよいですか?
すぐに廃止する必要はありません。まず、Google Cloudの標準指標とアラートをCloud Monitoringに寄せます。そのうえで、オンプレミスや業務ジョブ、長期保存など既存ツールが担う領域は連携させます。
重複通知を整理してから段階的に移行します。PoCでは、障害検知、原因調査、通知、切り戻しを確かめ、監視の空白期間を作らないことが大切です。
業務KPIをCloud Monitoringで監視できますか?
監視できます。たとえば、注文数や失敗率、処理時間をカスタムメトリクスとして送れます。
キューの滞留数やバッチ完了件数も送れます。さらに、ログから数値を取り出し、ログベース指標にする方法もあります。
指標名やラベルには、顧客IDや注文番号のように増え続ける情報をそのまま使わないようにします。代わりに、サービス、環境、地域など集計に必要な範囲に絞ります。
監視システムの開発を外注するべきですか?
自社で、業務要件やSLOを設計できるかどうかが判断の基準になります。アラート運用、セキュリティ、IaC、障害対応まで設計できるかも見ます。
標準機能の設定と小規模な監視は内製しやすい一方、複数環境や既存監視連携などでは専門会社の設計支援やPoCが役立つ場合があります。
24時間対応や監査要件、アプリ改修を伴う場合も、外部支援を検討できます。設定ファイルと運用手順を自社へ引き渡せる契約かを確認します。
まとめ:監視を業務改善につなげる設計
Google Cloud Monitoringは、Google Cloud上のリソースを見張るだけでなく、業務の状態を観測して改善に生かす仕組みです。
メトリクス、ログ、トレース、Uptime Check、SLOを業務KPIと結び付け、検知後の対応まで設計すると、障害の早期発見と原因調査の基盤になります。
監視を入れることと、障害を減らすことは別の話です。特に、アラートの品質と運用改善を続けることが成果を左右します。
導入前に決めるポイント
導入前に決めるのは、監視する業務とSLO、収集データと保存期間、通知を受けて復旧する担当者です。加えて、初期費用・従量利用料・運用費の予算も決めておきます。
IAMや監査ログ、個人情報の扱いも確かめます。そのうえで、まずは重要な業務一つでPoCを行い、障害シナリオと月額費用を実測してから、対象を広げます。
次に行うこと
次の順で資料を整え、提案と運用状況を確かめます。
- 現行構成図とアラート一覧を作り、重要業務の障害シナリオを3〜5個選ぶ
- 必要なメトリクス、ログ、トレースを定義し、同じ条件でRFPを出す
- 監視設定、テスト、費用管理、文書、引き継ぎ、障害対応の範囲を比べる
- 運用後はMTTR、誤検知、SLO、通知件数、月額費用を定期的に見直す
監視を業務改善につなげるには、改善を続けることが欠かせません。
▼関連記事一覧
・Google Cloud Monitoringのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Google Cloud Monitoringのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Google Cloud Monitoringのシステム開発の見積相場や費用/コスト/値段について
・Google Cloud Monitoringのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。