
Google Cloud Monitoringの発注は、要件整理、委託範囲の決定、障害シナリオでの受入確認の順に進めます。この順に決めると、業務を守る監視につながります。
▼全体ガイドの記事
・Google Cloud Monitoringのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Cloud Monitoringのシステムを発注・外注する全体像
Google Cloud Monitoringは、Google Cloud上のサービスやアプリの状態を把握する、Observabilityの中核です。扱う対象データは、メトリクス、ログ、トレース、イベントです。
Google Cloud公式資料によると、標準メトリクスを収集できます。さらに、Ops Agent、Managed Service for Prometheus、OpenTelemetryもデータ収集に使えます。
収集したデータは、ダッシュボードやアラートに使うほか、合成モニターやSLOにも活用できます。そのため、導入するツールを選ぶより前に、業務システムの構成と運用組織に合わせた設計が中心になります。
業務システムの監視で見えるようにする情報
CPUやメモリだけでは、業務にどんな影響が出ているかが見えません。そこで発注時には、業務への影響が分かる指標を選びます。例としてECサイトでは、次の情報を監視対象にします。
- 注文受付:注文の失敗率
- 決済API:応答のレイテンシ
- 在庫連携:連携の遅延
- 夜間バッチ:処理の完了時刻
Cloud Monitoringには、Google Cloud、AWS、サードパーティーソフトウェア向けに、6,500種類を超えるメトリクスが用意されています。さらに、独自のカスタムメトリクスも登録できます(出典: Google Cloud公式「Metrics, time series, and resources」、2026年)。
取得できる情報は多くても、すべてを取得する必要はありません。RFPでは、対象と指標、判定条件を書き、通知先と対応時間まで指定します。
たとえば、「本番のGKEクラスタ」と書くだけでなく、「注文APIのエラー率を5分間隔で確認し、一定値を超えたら一次対応者へ通知する」と記します。こう書くと、業務を守る仕組みとして評価できます。
Cloud Monitoringと周辺サービスの役割分担
サービスごとに役割を分けておくと、どのデータをどのサービスで扱うかが明確になります。既存製品を残す場合は、データの管理先もあわせて決めておきます。
- Cloud Monitoring:数値を見える形にし、アラートを出す
- Cloud Logging:ログの検索と保存
- Cloud Trace:処理の遅延箇所の追跡
- Error Reporting:エラーの集約
- Prometheus等:GKE上の指標資産や既存Grafana・Hinemosとの連携
Google Cloud公式の概要では、Metrics Explorerとアラートを別機能として説明しています。ダッシュボードやUptime Checkも、それぞれ別機能として挙げられています。また、複数プロジェクトやAWSアカウントを対象にするメトリクススコープも、別機能です(出典: Google Cloud公式「Cloud Monitoring overview」、2026年)。
外注の範囲には、アプリ計装、ログのマスキング、通知連携が含まれるかを明記します。Terraformでのコード管理や既存監視からの移行、障害訓練、24時間対応についても、含むかどうかを書き分けます。
監視設定を作る会社と復旧を担う会社が異なる場合は、障害時の連絡経路と、どこまでを誰が受け持つかを契約前に確認します。
Google Cloud Monitoringの発注形態の選び方
発注形態は、作る範囲が明確か、改善を続けるか、夜間対応まで任せるかで選びます。自社の責任範囲と委託範囲を先に分けておくと、価格と継続性を比べられます。
- スポット発注:小規模な可視化やPoC
- 準委任:要件が固まらない大規模案件
- MSP・運用保守:監視後の一次対応も委託
スポット発注・PoC型が向くケース
監視対象が1〜2個のGoogle Cloudプロジェクトで、標準メトリクスや数個のダッシュボードを短期間で整える場合は、スポット発注やPoC型が向いています。通知先には、メールやSlackも対象にできます。
PoCでは、画面以外に何を渡すかも決めておきます。監視対象一覧、アラート条件、通知テストの記録を含めます。加えて、月額利用料の試算、Terraformなどの設定コード、本番展開計画も入れます。
検証期間は2〜6週間程度を置き、代表的な障害シナリオを再現できるかを確かめてから、本番発注へ進みます。これにより、全社一括導入の失敗リスクを抑えられます。
PoCでは、仕様を委託先に任せきりにせず、業務に影響のある事象を発注者と委託先で共有します。
- 注文:ログインは成功するが、完了まで進まない
- バッチ:予定時刻を過ぎても処理が終わらない
成功条件は、検知までの時間と通知先で定めます。そのうえで、原因調査に必要な情報と切り戻し方法も決めておけば、実装の評価に使えます。
伴走型の準委任・MSP型が向くケース
既存アプリが複雑で、監視対象を調べながら業務KPIを決める場合は、準委任型にして設計担当者と毎週協議します。リリースや障害、組織変更のたびに監視の調整が要るため、毎週の協議が欠かせません。
Google Cloudの専門担当が少ない場合は、MSP型で平日日中の監視設計や月次報告を委託できます。必要に応じて、24時間365日の一次対応とエスカレーションまで委託範囲を広げられます。
業務上の優先順位や復旧判断は、MSPへ自動的には委託されません。そのため、初動と復旧のそれぞれで、誰が何分以内に行動するかを契約に記します。
- 初動:検知、一次切り分け、担当者への連絡
- 復旧:作業の実施、原因分析、再発防止
監視会社への権限は、常時付与するか、承認時だけ付与するかを決め、IAMと作業記録に反映します。あわせて、委託先を変えることや内製化できる状態も保ちます。
RFPと要件整理の準備範囲
RFPは、複数社の提案と見積もりを同じ条件で比べるための資料です。技術仕様まで発注者がすべて決める必要はありません。
準備では、現行構成と守りたい業務、想定障害を整理します。そのうえで、必要な運用時間や予算の考え方、納品条件を決めておきます。なお、要件定義を短くしすぎると、監視対象や通知ルールが後から増えます。
RFPに入れる監視対象・業務要件・非機能要件
監視範囲を具体化するため、システムの構成とデータ量、業務への影響を記載します。さらに、運用条件も書きます。
- 接続先:プロジェクト数、GKEのクラスタとPod数、Cloud RunとCompute Engine、DB、外部API、オンプレミスやAWS
- データ条件:月間ログ量、メトリクス数、Prometheus収集間隔、保持期間
- 運用条件:既存監視製品、通知チャネル、検知時間と通知遅延、SLO、RTOとRPO
- 管理条件:保守時間、誤検知、障害履歴、月次報告、監査ログと権限承認
業務要件は、利用者や売上への影響で書きます。たとえば、注文失敗率や決済応答時間、在庫連携の遅延などがあります。バッチ締め時刻も、同じ見方で書きます。
個人情報やカード情報がログに混入する可能性があれば、マスキングや除外の方法、保存場所、アクセス権限を明示します。条件が曖昧だと、標準指標だけの提案とアプリ計装まで含む提案を、正しく比べられません。
納品物と受入条件の決め方
納品範囲と検収条件は具体的に書き出しておき、画面だけの納品にならないようにします。
- 設計:監視の仕様書、メトリクスとラベルの一覧、IAMの構成
- 設定:アラート、通知チャネル、Uptime Check、SLO、IaCコード
- 運用:ログ除外・マスキング、対応手順、作業の予定表、教育資料、変更履歴
- 権利と引き継ぎ:所有権・利用権、ライセンス、リポジトリ管理者、契約終了時の引き渡し
受入では、画面の表示だけでなく、障害シナリオで確認します。たとえば、注文APIのエラー率を上げて、所定時間内にインシデントが作成され、Slackへ通知されるかを試します。
担当者がログとトレースから原因を特定できるかも、あわせて確認します。さらに、誤検知の抑制やデプロイ中の保守設定、重複通知の集約も試験します。こうした試験により、本番後のアラート疲れを抑えます。
請負と準委任の使い分け
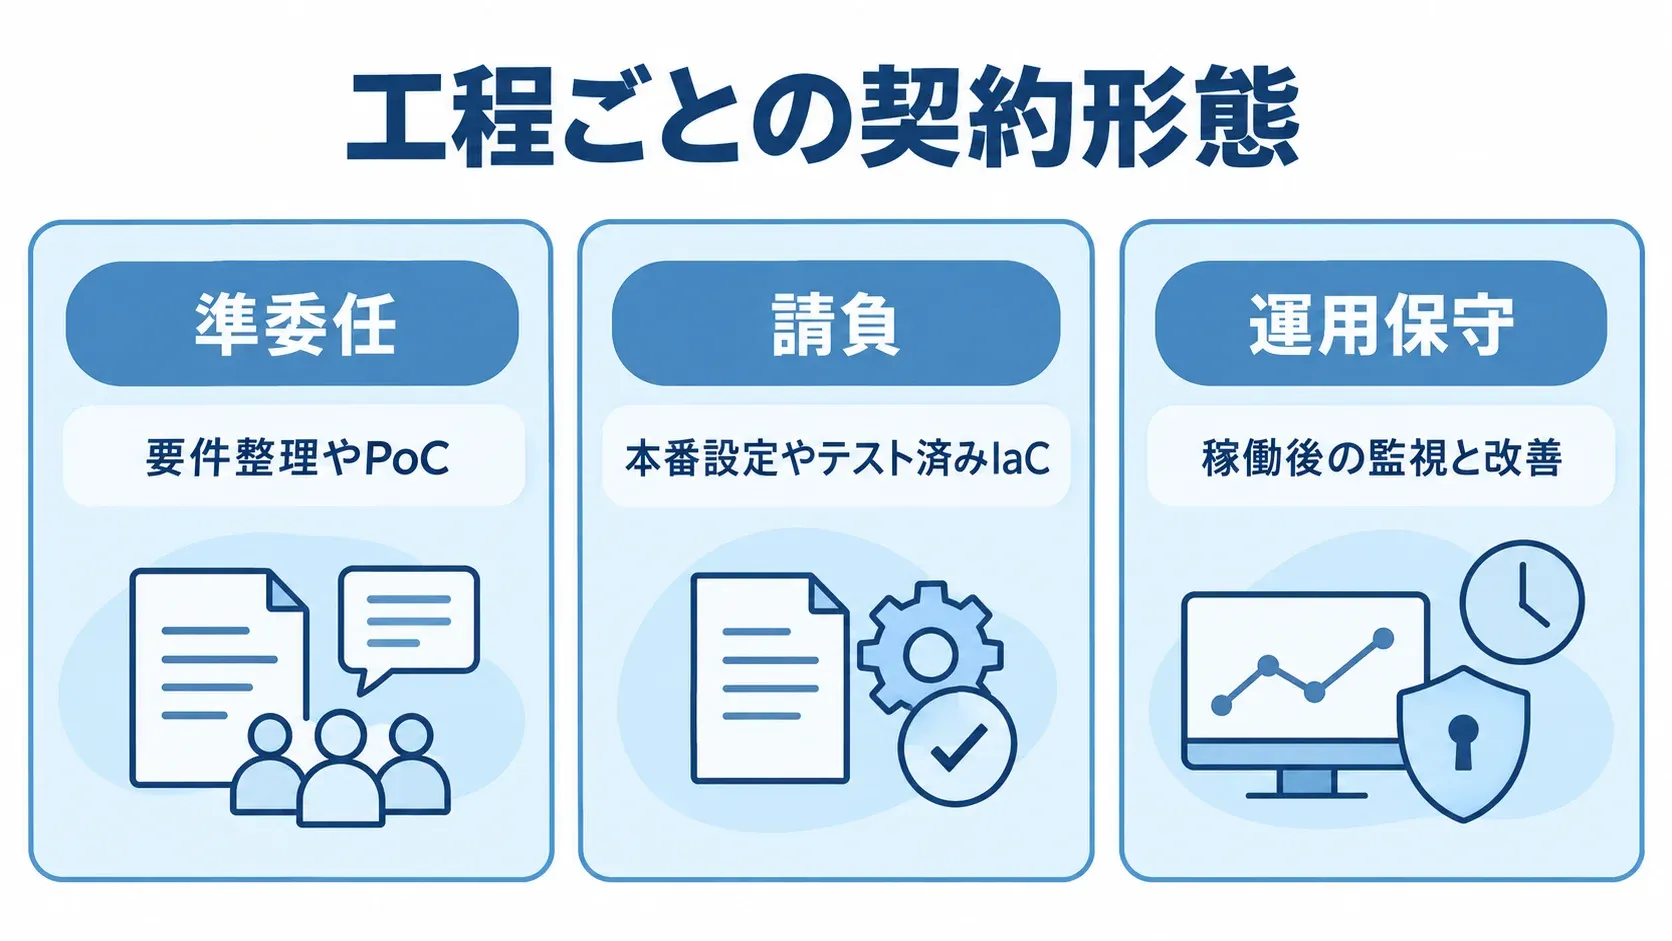
請負は、合意した成果物を完成させて引き渡す案件で使います。一方で、準委任は専門家と進める調査や設計、調整、運用改善の案件で使います。
契約は、工程ごとに組み合わせられます。たとえば、要件整理やPoCは準委任、本番設定やテスト済みIaCは請負にします。稼働後の監視と改善は、運用保守として扱います。
要件が明確な工程の請負契約
成果物と検収を管理しやすくするため、要件が確定している範囲は請負にします。
- 事前確定する項目:監視対象、アラート条件、ダッシュボード数、通知先
- 検収条件:試験方法と納期
契約後の変更には、費用がかかる場合があります。監視対象の追加やアプリ改修は、変更管理の対象にします。ログ量の変化や24時間対応の追加も、変更管理に含めます。
追加費用と納期への影響をどう協議するかは、契約書や個別仕様書に記載します。また、見積書は、要件定義、設計、実装を工程ごとに分けます。テストや移行、教育、引き継ぎも、それぞれ分けてもらいます。
アラート調整や障害訓練は、稼働後になって必要性が分かる場合があります。そのため、初期の請負に含める回数と、追加対応の単価または月額を、先に確認しておきます。
調査・運用改善の準委任契約
資料が不足している場合や、有効なメトリクスを検証しながら決める場合は、準委任が適しています。進捗は、稼働時間と担当範囲を基準にして確認します。
- 週次で確認:成果、課題一覧、設計判断の記録、次週の計画
- 契約で明確化:会議体、レビュー方法、作業報告、意思決定者、上限工数
準委任に、請負と同じ完成責任を求めると、双方の認識がずれます。運用保守では、画面確認や一次対応、ベンダー連絡の範囲を分けます。さらに、復旧や月次報告、改善提案の範囲も定めます。
復旧を委託する場合は、権限や緊急時の承認、作業ログを定めます。バックアップやロールバックの扱いも、あわせて決めます。
また、契約終了時に、設定コードや履歴、手順書、アカウント情報を移管できる条項も設けます。
Google Cloud Monitoringのシステム発注費用相場と内訳
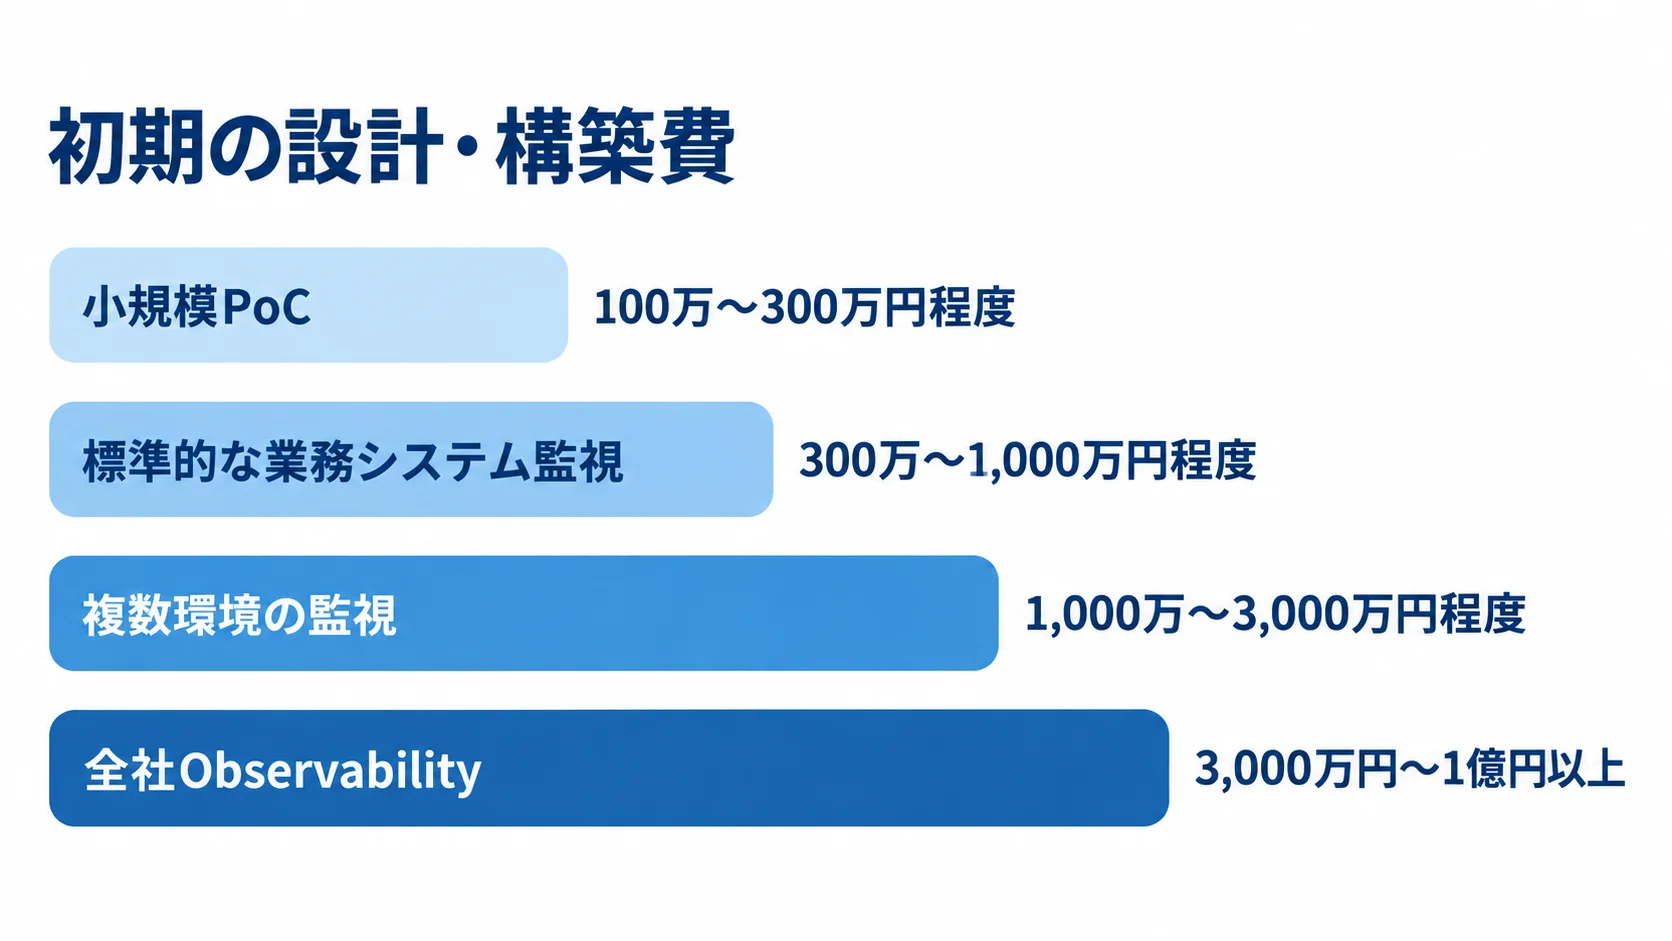
発注費用は、受託会社の初期開発費と、Google Cloudの従量利用料、稼働後の保守・監視費に分かれます。なお、Google Cloudに監視システム一式の定額相場はありません。
金額は、対象リソースやデータ量、保持期間によって変わります。通知やアプリ改修、運用時間も、金額を左右します。
以下の金額は、人月単価と工程配分を基にした推定です。公開定価や固定価格ではありません。
初期の設計・構築費と対象範囲
規模別の初期費用と期間は、監視対象や連携範囲で変わります。
- 小規模PoC:100万〜300万円程度、2〜6週間程度
- 標準的な業務システム監視:300万〜1,000万円程度、2〜4か月程度
- 複数環境の監視:1,000万〜3,000万円程度、4〜9か月程度
- 全社Observability:3,000万円〜1億円以上、9か月〜2年超の場合もある
小規模の推定は、1〜2プロジェクトの標準指標と数個のダッシュボードを想定しています。基本アラートとSlackやメール通知を設け、Terraform雛形も含みます。
標準規模の推定には、Cloud RunやGKE、VM、DBの監視が入ります。カスタムメトリクスやログ連携、Uptime CheckとSLOも含みます。さらに、権限分離とテスト、運用手順も入ります。
複数プロジェクトの推定は、オンプレミスやAWS、Prometheusとの連携を含んだ場合が前提です。さらに、既存監視製品や長期保管、DR、24時間運用設計も含めた推定です。
数百〜数千サービスの全社監視や組織横断の運用改革では、上記の大規模レンジになることがあります。そのため、対象数と連携数を確かめ、要件定義や設計、実装を分けて見積もります。テストや移行も、同じように分けます。
Google Cloud利用料と運用費の内訳
利用料は、監視データやログ、トレースの量で変わります。クエリや保存、通知の量も、利用料に影響します。公式料金例では、100コンテナが1,000時系列を送信する条件で、次の差があります。
- 60秒間隔:月4,380百万サンプル、262.80米ドル
- 15秒間隔:月17,520百万サンプル、1,051.20米ドル
1ドル150円と仮定すると、約3.9万円と約15.8万円になります。為替や契約条件、他サービスの費用を含まない試算です(出典: Google Cloud公式「Pricing examples for Google Cloud Observability」、2026年)。
公式資料では、カーディナリティを変えずに収集間隔を15秒から60秒へ変えると、最大75%の削減につながる場合があるとされています(出典: Google Cloud公式「Optimize and monitor Google Cloud Observability costs」、2026年)。
一方で、短い間隔が必要なSLOや検知もあります。そのため、一律に60秒へ変えず、重要度ごとに間隔とラベルを設計します。
平日日中の監視設計・調整は、月10万〜50万円程度が推定レンジです。24時間365日の一次対応、エスカレーション、月次報告まで含む運用は、月50万〜200万円程度が推定レンジです。公開定価ではありません。
委託先選定と見積比較の確認ポイント
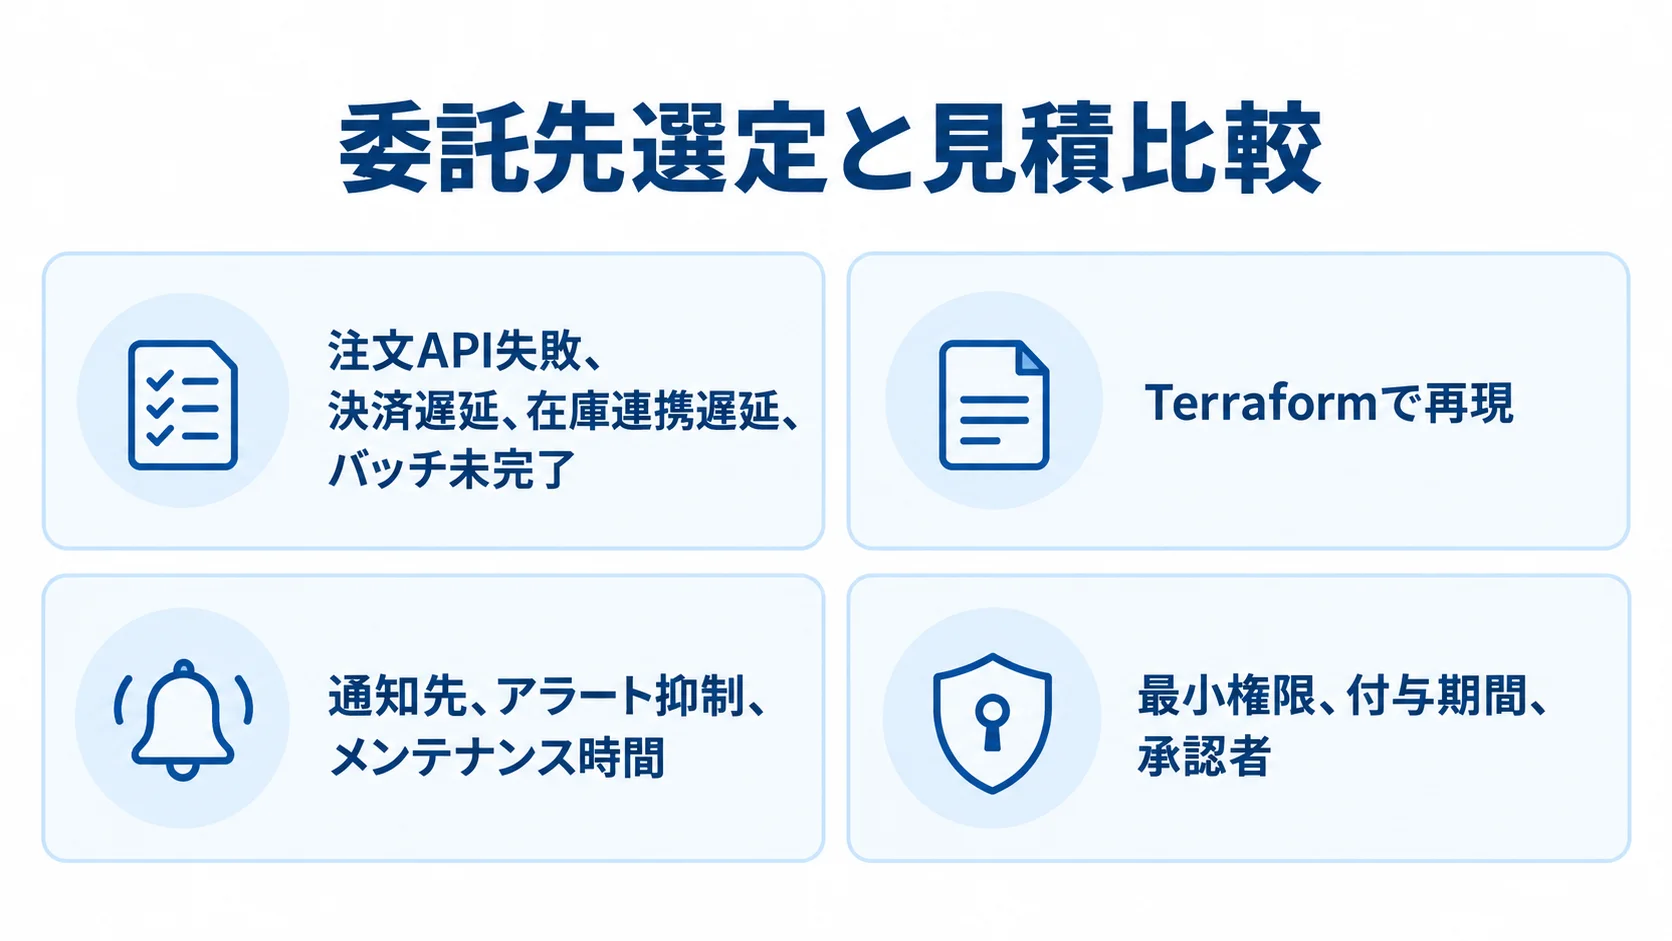
認定や導入件数だけで判断せず、監視設計と運用改善を業務に結び付けて説明できるかを確かめます。各社には同じRFPを渡し、提案の条件を分けて示してもらいます。
- 見積条件:対象範囲、前提条件、除外事項、納品物
- 費用と体制:担当体制、期間、初期費用、月額費用、Google Cloud利用料
同じ障害シナリオによる実装力と運用力の評価
提案時は、実際の障害を一つ選び、検知から連絡までの説明を求めます。
- 想定例:注文API失敗、決済遅延、在庫連携遅延、バッチ未完了
- 調査方法:メトリクスをLoggingやTraceと関連付け、画面やクエリを示す
- 設定管理:Terraformで再現し、開発・検証・本番の差分を管理する
- 運用設定:通知先、アラート抑制、メンテナンス時間を説明する
大規模案件では、設計やアプリ、Google Cloud基盤、運用の各担当と責任者を確かめます。構築会社と運用会社が別の場合は、引き継ぎ資料や共同テスト、障害時の連絡順も確認します。
実績は会社名だけでなく、監視対象、サービス数やログ量、稼働後に改善した指標を具体的に質問します。
安い見積もりの前提と抜け漏れ
安い見積もりでは、対象範囲や納品物が限られている場合があります。そのため、見積もりの前提と除外事項を照合します。
- 監視範囲:標準メトリクスのみで、アプリ改修は対象外
- 通知・試験:通知先がメールのみで、テストは画面確認だけ
- 納品・保守:Terraformや手順書なし、稼働後調整は別料金
総額に加えて、要件定義や設計、実装の金額と工数を並べてもらいます。テストや移行、教育、保守の分も並べ、対象外の項目がないかを確かめます。
初期開発費とGoogle Cloud利用料は、固定額にまとめないようにします。データ量が増えれば従量費が変わり、サービスやアラートを追加すれば保守費も変わります。
契約には、月次で利用量を確認する運用を含めておきます。確認するのは、未使用の課金対象データ、ログ除外率、アラート数です。
MTTRやSLO違反も、あわせて見ます。こうした運用を含めると、費用と品質を改善できます。
セキュリティと将来の内製化の評価
Cloud Monitoringの設定変更やダッシュボードの参照には、IAM権限が関係します。そのため、委託先アカウントの権限を管理し、作業記録も残します。
- 権限管理:委託先の作業アカウントを個人アカウントと分け、最小権限、付与期間、承認者を定める
Cloud Monitoringのサービス名は「monitoring.googleapis.com」です。権限に応じて、管理操作やデータアクセスの監査ログが生成されます(出典: Google Cloud公式「Monitoring audit logging」、2026年)。
ログに氏名やメール、IPアドレスが入る場合は、個人情報や秘密情報を含む可能性があります。会員IDや注文番号、自由記述のエラー内容が入る場合も、取り扱いに注意が必要です。
法務や情報システムの部門と、マスキングや記録対象外の項目を確かめます。保存期間や委託先のアクセスも確認します。さらに、国外アクセスや再委託、契約終了後の削除も確かめます。
内製化を見据えて、Terraformやアラート、ダッシュボードを発注者のリポジトリに置きます。命名規則や手順、障害履歴も、同じ場所にそろえておきます。委託先だけが変更できる状態は避けます。
Google Cloud Monitoringの発注・外注でよくある質問
打ち合わせで出やすい質問を、予算や契約、運用責任、既存システムとの関係を踏まえて答えます。
Google Cloud Monitoringは自社対応と外注のどちらがよいですか?
標準メトリクスや小規模なダッシュボードは、自社でも対応できます。一方で、業務KPIの設計やアプリ計装を含む場合は、外注が有効です。既存監視との統合や24時間対応まで求める場合も、外注が選択肢になります。
全面委託に限らず、重要業務のPoCを外注し、設定コードと手順書を受け取って自社運用へ移す方法もあります。判断は、担当者数や障害対応の経験、運用時間、内製化方針で行います。
既存のDatadogやGrafana、Hinemosは廃止すべきですか?
必ずしも廃止する必要はありません。要件に応じて、既存製品と役割を分けられます。
- Google Cloud単一環境:Cloud Monitoringで標準指標を確認
- Kubernetes:Managed Service for Prometheusで指標を扱う
- 業務ジョブ・マルチクラウド:既存製品との統合を検討
二重収集による費用増や重複通知を避けるため、データと通知、長期保存の正本を先に決めます。そのうえで、移行範囲を判断します。
Google Cloud Monitoringの外注費用を抑える方法はありますか?
基本は、重要業務から監視対象を増やすことです。価値の低いメトリクスやログを、無制限に取り込まないようにします。
公式資料を参考に、Prometheusの収集間隔やラベルのカーディナリティを設計します。ログ除外やトレースのサンプリングも含め、月次で利用量を確認します。
初期見積もりでIaCや運用手順を納品に含め、自社で将来の変更を行えるようにしておくと、長期の委託費を抑えられます。
まとめ
発注前の確認事項
発注では、監視画面だけでなく、業務KPIやSLOを対象にします。さらに、通知や復旧、再発防止まで含めます。重要業務は、注文や決済、在庫、バッチから選びます。
代表的な障害シナリオでPoCを行い、必要なデータと運用体制を実測します。そのうえで、構築は請負、調査や改善は準委任、一次対応や月次報告は運用保守に分けておくと、責任と費用を整理できます。
稼働後の継続運用
安定した運用を続けるため、発注条件や費用を確かめ、稼働後の改善につなげます。
- RFPと引き継ぎ:対象と計測量、保持期間、通知やSLO、安全要件、24時間対応、Terraformと手順書を記し、設定と知識の移管も決める
- 小規模・標準監視:初期費用は小規模PoCで100万〜300万円程度、標準監視で300万〜1,000万円程度
- 複数システム・全社規模:1,000万〜3,000万円以上の推定レンジ。要件によって変わる
- 費用の確認:Google Cloud利用料と委託先運用費を分け、見積もりの前提と除外事項を確かめる
- 稼働後の見直し:MTTR、検知率、SLO違反、通知件数、監視費用を確認する
▼全体ガイドの記事
・Google Cloud Monitoringのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。