
Google Cloud Monitoringのシステム開発は、要件整理から定着まで6フェーズで進みます。目的は、重要業務の異常検知から復旧までを仕組みにすることです。
各フェーズで決めることと、費用や見積もりの確認点を順に見ていきます。全体像は、完全ガイドの記事もあわせてご覧ください。
▼全体ガイドの記事
・Google Cloud Monitoringのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Cloud Monitoringのシステムの全体像
Google Cloud Monitoringは、Google Cloud上のアプリケーションやVM、コンテナを監視する基盤です。データベースやネットワーク、APIも対象で、状態を可視化して異常対応を支援します。
Cloud Logging、Cloud Trace、Error Reporting、Prometheusなどと組み合わせて使う、可観測性の中核です。業務アプリケーションを開発する製品ではありません。
指標・ログ・トレースを業務影響につなげる仕組み
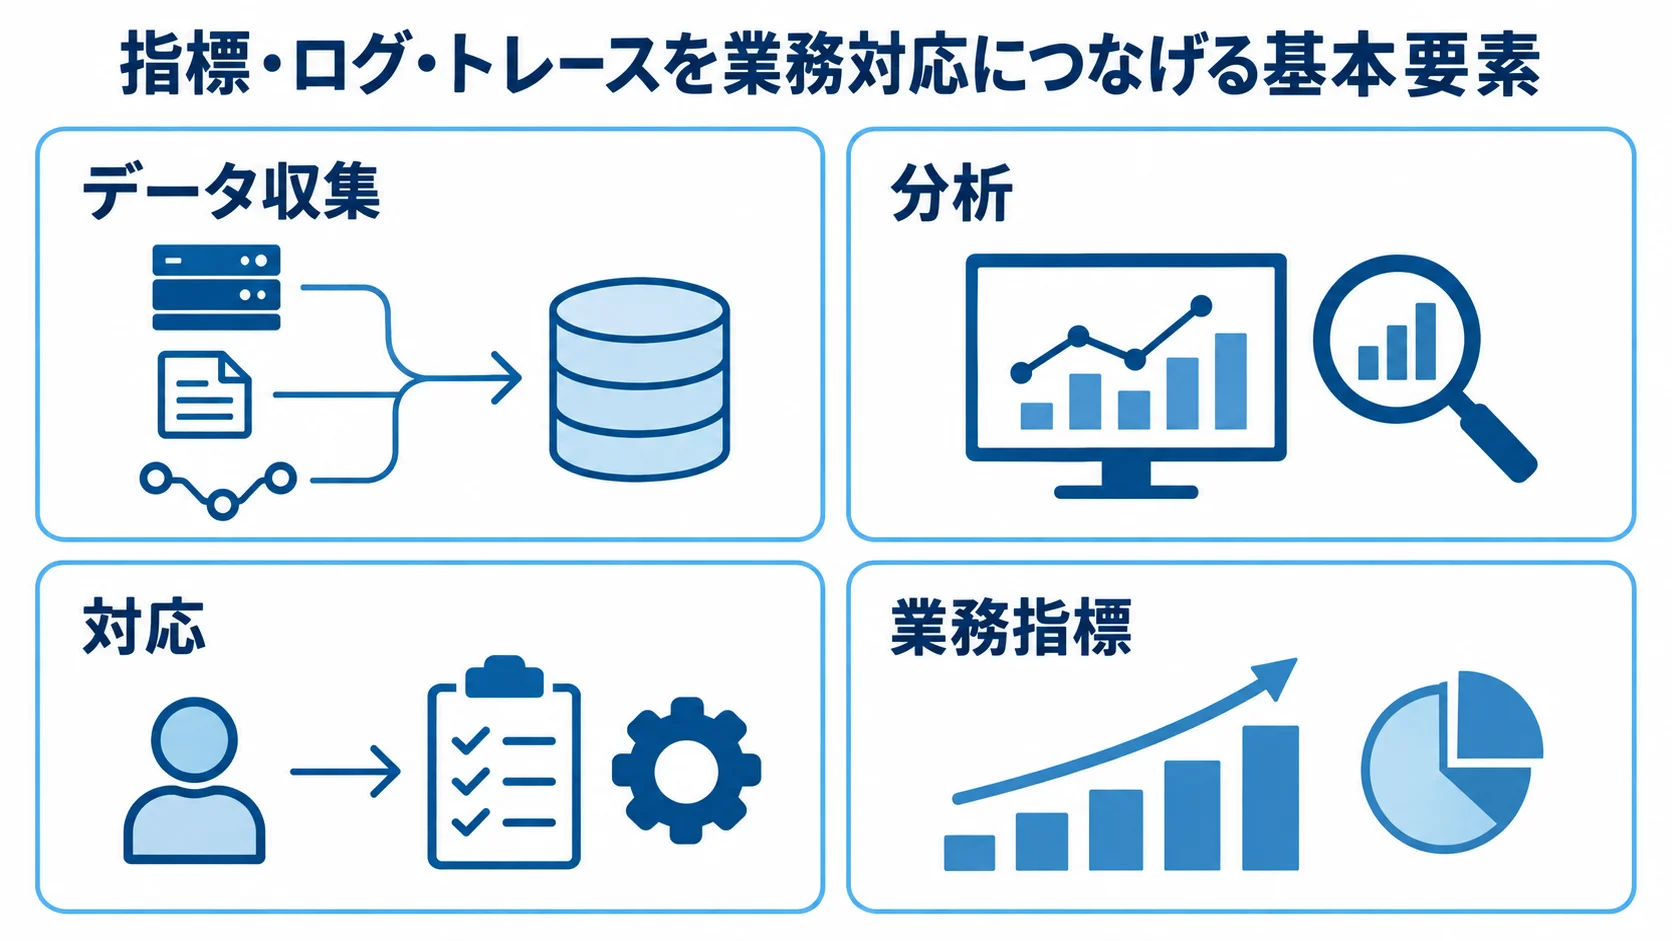
指標・ログ・トレースを業務対応につなげるには、データ収集から業務指標までを要素ごとに分けて考えます。
- データ収集:アプリケーション、GKE、VM、外部サービスが対象です。
- 分析:Cloud Monitoring、Cloud Logging、Cloud Traceで読み解く。
- 対応:通知、チケット、自動復旧へとつなげます。
- 業務指標:注文失敗率、決済APIのレイテンシ、在庫連携の遅延、バッチ未完了件数。
CPUやメモリ以外の業務指標は、カスタム指標やログベース指標として扱えます。Google Cloudの標準指標は、自動で収集されます(出典:Google Cloud「Cloud Monitoring」、2026年8月確認)。
データの取り込み方は環境ごとに異なります。Compute EngineのVMではOps Agent、KubernetesではManaged Service for Prometheusを使い、外部環境ではAPIやエージェントなどで取り込みます。
Alerting Policyでは、しきい値や変化率を条件に設定できます。欠測、予測値、SLO違反なども条件にでき、通知先にはメール、Slack、PagerDutyなどを設定できます。
Cloud Monitoring単体と他製品との連携の選択
構成は、環境や既存資産に合わせて、製品ごとの役割を分けて決めます。標準指標、アラート、SLO、Uptime Checkは、Cloud Monitoringの中で早く整えられるため、Google Cloudに環境が集まっていれば候補になります。
- Google Cloud中心:Cloud Monitoringを中心にした構成です。
- Kubernetes資産を活用:Managed Service for Prometheusを組み合わせ、既存のGrafanaを残す選択肢もあります。
- 統合運用が必要:マルチクラウドや業務ジョブ、運用カレンダー、長期保存を扱う場合は、Hinemosなどとの役割分担を検討します。
既存製品は、導入直後にすぐ捨てる必要はありません。まず重要サービスで検知品質と費用を実測し、そのうえで重複する監視を整理します。
判断では、監視対象や通知の優先度、ジョブ連携を見ます。監査ログや担当者、障害時の責任分界、将来の内製化も判断の材料です。画面の使いやすさは、判断材料の一つにすぎません。
Google Cloud Monitoringのシステム開発の進め方
進め方は6フェーズで、要件整理、サービス選定、設計開発、テスト、稼働、定着の順に進みます。成果物と判断基準を先に決めておくと、ダッシュボードだけの納品になるのを防ぎやすくなります。
監視は本番に設定しただけでは終わりません。誤検知を減らし、通知を受けた人が復旧までたどり着けて初めて、業務の価値につながります。
1. 要件整理フェーズで決める業務影響とSLO
要件整理では、発注側と開発会社が、何を監視するかより先に、どんな障害が起きると事業が困るかを決めます。そのうえで、業務への影響を目標の形に置き換えます。
- 注文受付:5分以上停止させない目標。
- 決済API:95パーセンタイルを1秒以内にする目標。
- 夜間バッチ:午前7時までに完了させる目標。
可用性やレイテンシのSLO、エラーバジェットを決めます。重大度と、検知から一次連絡までの時間も合わせて定めると、後のアラート設計が具体的になります。
監視対象の洗い出しには、Google Cloudのプロジェクトを含めます。GKE、VM、Cloud Runも対象です。データベース、ロードバランサ、バッチ、外部APIも洗い出します。
オンプレミスやAWS、既存監視の状況も押さえます。通知先や担当者、営業時間も確認します。
ログに何が入るかも押さえます。IPアドレスや会員ID、注文番号、自由記述のエラー内容などが対象です。成果物は、監視対象一覧と業務影響マップ、SLO案です。ログ分類と責任分界表も、成果物に含まれます。
重要業務が優先順位の上位にあるか、障害シナリオが具体的に描けているかを確認します。次に、誰が何分以内に対応するかを決めます。
監視対象外を説明できるか、個人情報を含むログの扱いが決まっているかも確認します。未決事項を残したまま実装へ進まないことが大切です。
全リソースを一度に監視せず、売上や顧客体験、法令上重要なサービスから始めます。こうすると、PoCの効果と費用を判断できます。
2. 選定フェーズで比べる構成と責任範囲
製品選定は、環境や運用の中心に合わせて考えます。単純な優劣では決めず、要件ごとに見ていきます。
- Google Cloud単一環境:標準指標との親和性。
- Kubernetes中心:Prometheusへの移行性。
- マルチクラウド:データ統合の適合性。
- 業務ジョブ中心:ジョブ管理やカレンダー連携。
候補には、Cloud Monitoring、Managed Service for Prometheus、Grafanaがあります。このほか、DatadogやHinemosも挙がります。各製品は、要件に照らして比べます。
導入後の担当範囲も決めます。アラート作成だけか、夜間一次対応や月次報告まで含むかで、契約と費用が変わります。エスカレーション、障害訓練、改善提案まで決めておくと、契約の範囲が明確になります。
RFPには同じ障害シナリオを載せ、ログから原因を説明できるかを見ます。通知を抑制・統合できるかや、Terraformと運用手順を納品できるかも確かめます。
PoCでは、代表的な障害を再現して、目標時間内に検知できるかを確かめます。原因を絞り込めるか、誤検知が許容範囲に収まるかも見ます。月額利用料と切り戻し方法も確認します。
検証期間は2〜6週間程度の小規模なものとします。画面表示だけを合格条件にしないことで、全社導入の手戻りを減らせます。
3. 設計開発フェーズのIaCと通知品質
設計開発では、設定、通知、ログ管理の要点を押さえます。
- 監視設定:プロジェクト、メトリクススコープ、IAMを定め、収集方法、ラベル、保持期間も決めます。
- 可視化と通知:ダッシュボード、アラート、通知チャネル、SLO、Uptime Checkの設計。
- 環境管理:開発・検証・本番の分離と、設定のコード管理。
- アラート品質:情報通知と即時対応通知の区別。
- ログと監査:不要な情報を記録しないことと、変更の追跡。
設定はTerraformなどでコード管理しておくと、手作業による設定漏れや環境差分を抑えられます。アラート名や重大度、対象サービスは同じ規則で管理します。対応runbookのURLやメンテナンス時間も、この規則に含めます。
アラートは、件数が多ければよいとは限りません。CPU使用率が短時間だけ急上昇した時点で通知するか、一定時間続いた場合に通知するかを決めます。
顧客への影響を表す、注文失敗率や決済レイテンシなどの条件を優先します。バッチの未完了と後続処理の停止も条件になります。また、複数の条件を組み合わせる方法もあります。
ログでは、リクエストIDやサービス名、環境名を揃えます。リリース版やエラー分類も揃えておくと、指標と相関させられます。
カード番号やパスワード、アクセストークン、不要な個人情報は、ログに出さない設計にします。
監視設定の作成や変更、権限操作は、Cloud Monitoringの監査ログで追えます。誰がどの変更を承認したかも、そこで確認します。
4. テストフェーズの障害再現と受け入れ
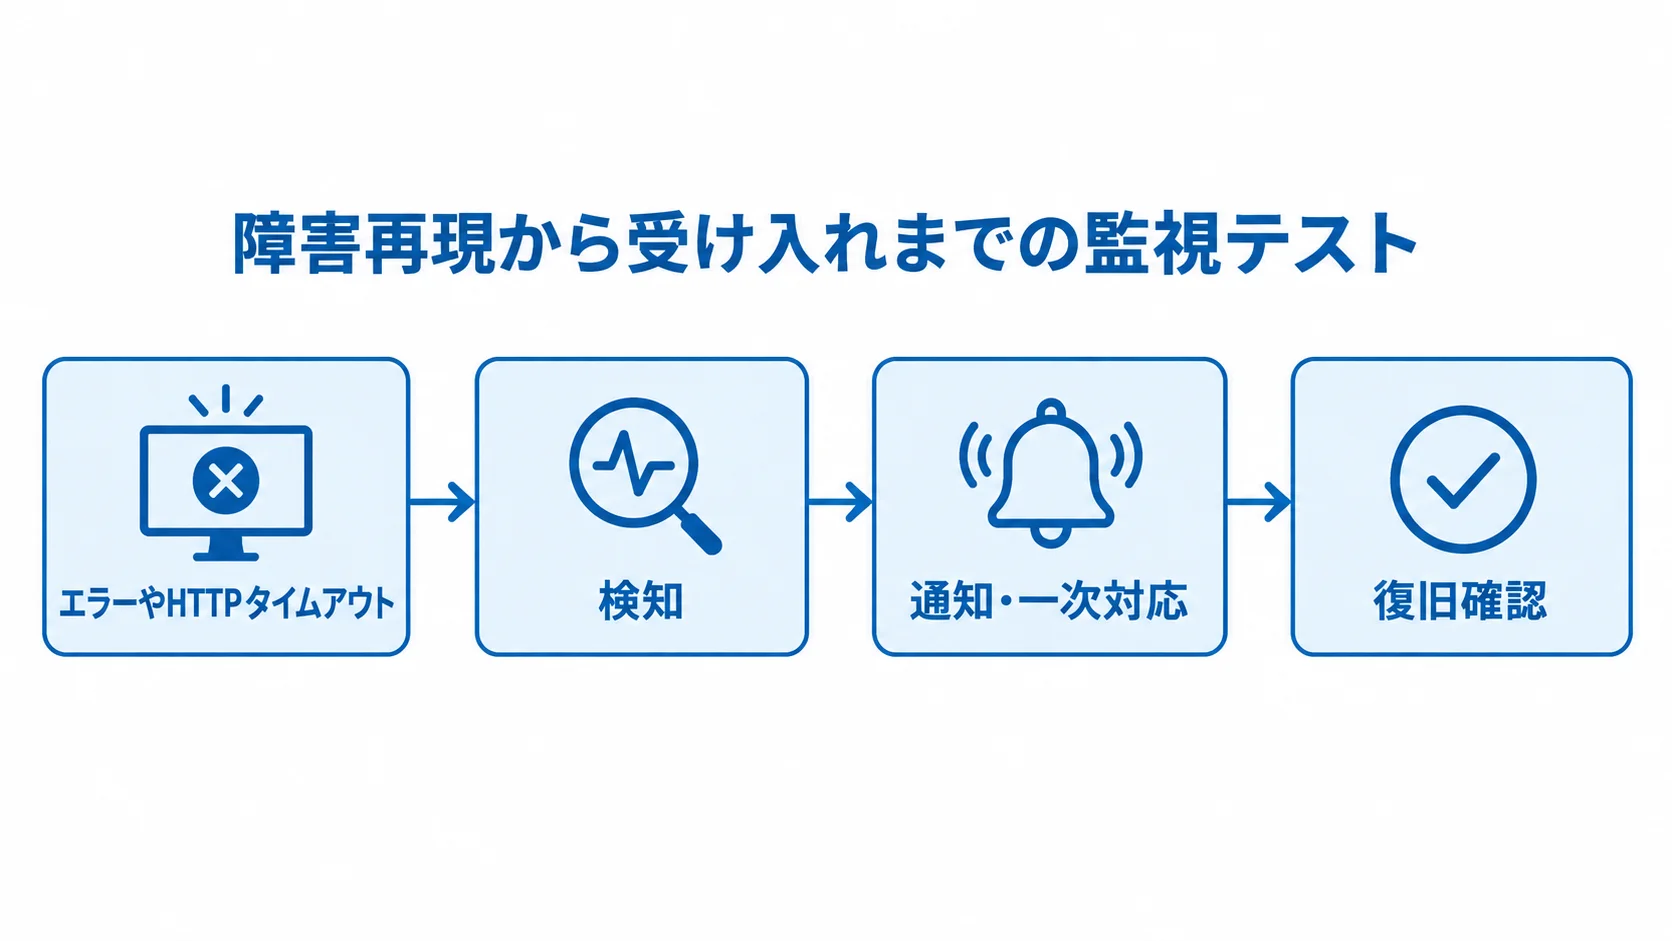
監視テストでは、安全な検証環境で障害を再現し、復旧確認まで通します。設定ファイルの構文確認だけでは、監視テストとして不十分です。
- アプリケーション:エラーとHTTPタイムアウトの再現。
- 基盤:DB接続失敗、GKEのPod異常終了、ディスク不足が対象です。
- 処理連携:バッチ遅延や外部API障害の再現。
検知からインシデント作成、通知、一次対応、復旧確認までを、順に検証します。なお、Uptime Checkでは、起動の確認と、ログインや検索、購入などの重要操作が成り立つかの確認を分けます。
受け入れ記録には、発生条件や検知時間、通知先と内容を残します。さらに、担当者の判断、復旧確認、誤検知の有無も記録します。
複数のアラートを重大インシデント一つにまとめられるかを確認します。メンテナンス中の通知を抑制できるかも見ます。夜間の連絡網も試します。
テスト結果を納品物に含めておくと、稼働後にどこまでを誰が受け持つかが明確になります。
5. 稼働フェーズの段階展開
稼働時は、段階展開と通知調整を、どの順で進めるかを決めます。
- 重要サービス、共通基盤、周辺サービスの順に、本番へ展開します。
- 切り替え前に確かめるのは、通知の重複と通知先、オンコール責任者、設定の戻し方です。
- 稼働直後は毎日アラート件数を見て、重大度や条件、除外フィルタ、通知を調整します。
- 初期の1〜2週間は関係者でインシデントを確認し、アラートが行動につながるかを見ます。
最初に切り替える対象は、障害シナリオを把握しやすく、業務影響を測りやすいサービスにします。開発担当、インフラ担当、業務担当、運用ベンダーが、同じインシデントを見ます。
対象を分けて改善を進めると、大規模な一括切り替えに比べて、業務を止めるリスクを抑えやすくなります。
6. 定着フェーズのKPIと運用改善
定着後は、KPIの確認と改善、引き継ぎを続けます。
- 運用指標:検知率、平均検知時間、MTTR、重大インシデント数を追います。
- 費用と品質:誤検知率、通知件数、SLO違反、監視関連費用も対象です。
- 継続運用:SLOとエラーバジェットを、開発計画に反映させます。
- 引き継ぎ:担当者が変わっても運用を続けられる資料の整備。
月次または週次で、ダッシュボードとアラートを一覧にして見直します。使われていない指標や、誰も対応できない通知、重複する条件を減らします。過剰なラベルも整理します。
運用の引き継ぎでは、Terraformやダッシュボード定義、アラート一覧を納品物に含めます。通知チャネルや権限一覧、障害対応手順も、同じ納品物にまとめます。
エスカレーション表やテスト記録、月次レポートのテンプレートも渡します。設定の意味と変更手順を残しておけば、担当者が異動した後も変更を続けられます。
効果が一時的な可視化だけで終わらないよう、障害訓練やリリース後レビューも契約に含めます。
Google Cloud Monitoringの費用相場とコストの内訳
Google Cloud Monitoringの監視システム一式には、公式の定額相場がありません。そのため、初期設計・開発費、Google Cloudの従量利用料、保守・監視運用費を分けて考えます。
初期費用は、人月単価と工程を基にした推定レンジで、公開定価ではありません。実際の見積もりでは、監視対象や連携数を示したうえで再計算してもらいます。
前提には、プロジェクト数やVM・Pod数、メトリクス数、ログ量を含めます。保持期間、通知先、24時間対応の有無も、前提に入れます。
規模別の初期費用の目安(小規模は100万〜300万円)
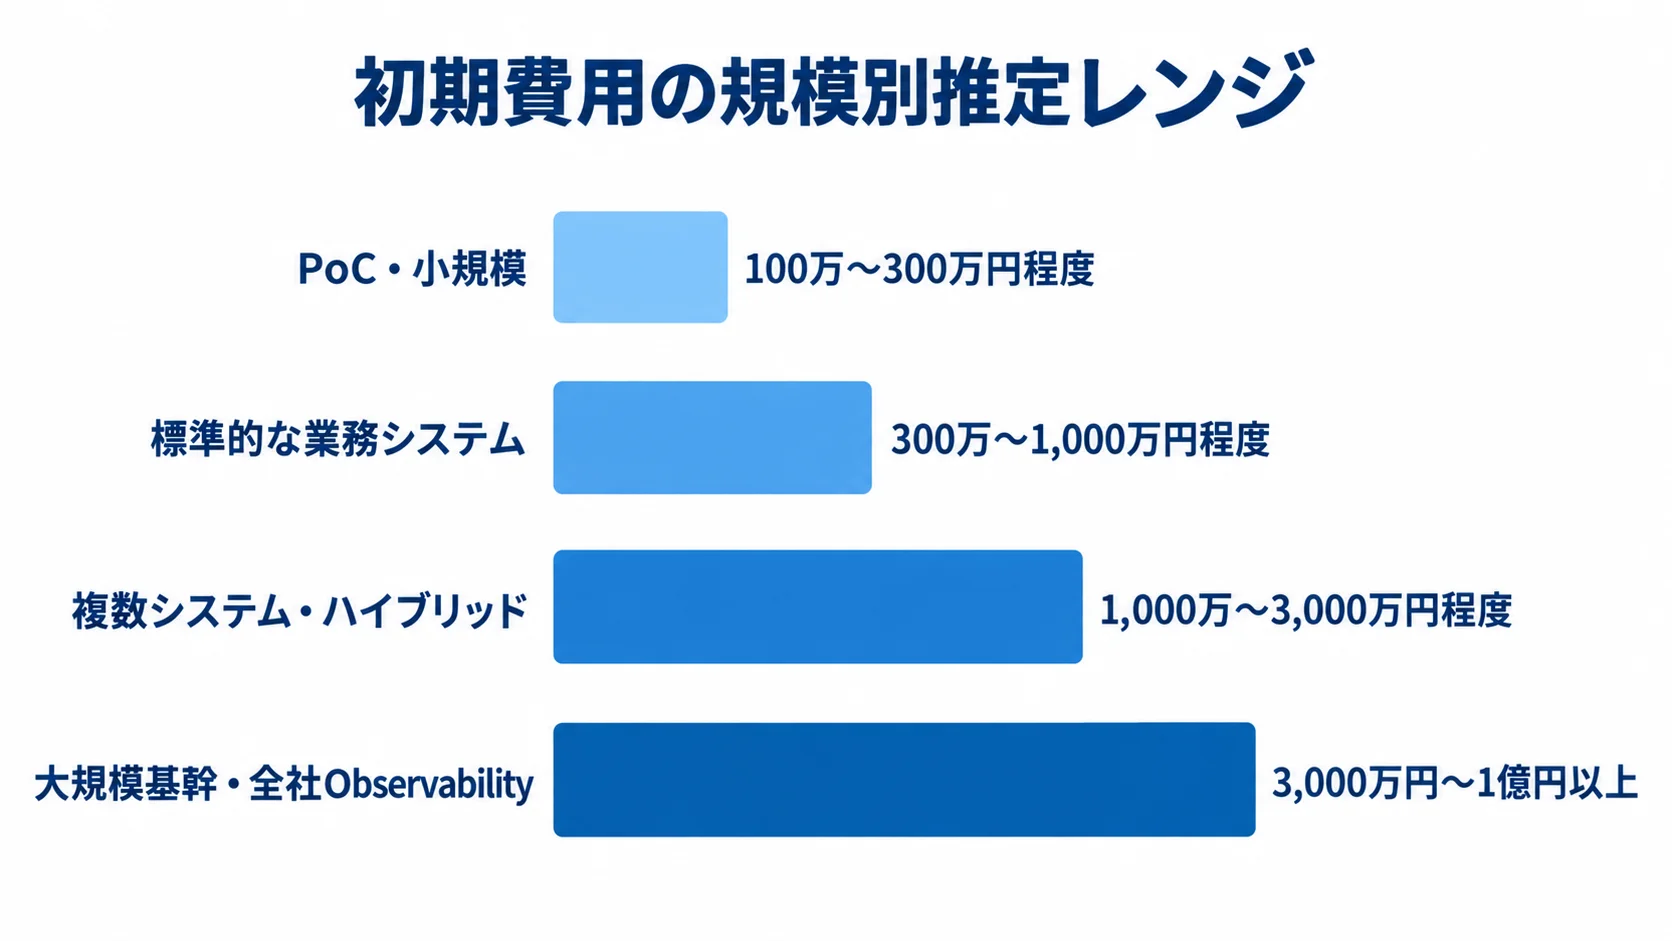
規模別の初期費用と期間は、対象範囲によって変わります。ここに示すのは公開定価ではなく、推定レンジです。
- PoC・小規模:100万〜300万円程度、期間は2〜6週間程度です。
- 標準的な業務システム:300万〜1,000万円程度で、2〜4か月程度を見込みます。
- 複数システム・ハイブリッド:1,000万〜3,000万円程度、4〜9か月程度です。
- 大規模基幹・全社Observability:3,000万円〜1億円以上、9か月〜2年超の場合もあります。
小規模は、1〜2プロジェクトと標準指標が対象です。数個のダッシュボードや基本アラート、Slackかメール通知、Terraformの雛形も含みます。
標準規模では、Cloud Run、GKE、VM、データベースを監視します。カスタム指標、ログ連携、Uptime Check、SLO、権限分離が加わり、テストと運用手順も含みます。
複数システムでは、オンプレミスやAWS、Prometheusとの連携が加わります。既存監視との連携や、長期保管、災害対策、24時間運用設計も含まれます。
大規模案件も、対象範囲に大きく左右されます。そのため、金額だけでなく、成果物と除外条件を比べます。
Google Cloudの利用料と、データ量・収集頻度
Google Cloudの現行料金表では、Managed Service for Prometheus以外の課金対象Monitoringデータが対象になります。
- Monitoringデータ:主に取り込みバイト数で課金されます。
- Prometheus:サンプル数に応じた課金です。
- 費用調整:収集頻度の変更でサンプル課金を抑えられる場合があります。
150MiBを超えて100,000MiBまでは1MiBあたり0.2580ドルです。100,000MiB超から250,000MiBまでは0.1510ドル、250,000MiB超は0.0610ドルです。
なお、バイト取り込み課金には、請求先アカウント単位で最初の150MiBの無料枠があります。標準のGoogle Cloud指標など、課金対象外のデータもあります(出典:Google Cloud「Google Cloud Observabilityの料金」、2026年8月確認)。
Managed Service for Prometheusは、100万サンプルあたりの料金が段階的に決まります。最初の500億サンプルまでは0.060ドル、次の2,000億サンプルまでは0.048ドルといった具合です。
公式例では、100コンテナが1,000時系列を60秒間隔で送る場合、月43億8,000万サンプルで262.80ドルです。一方、15秒間隔の場合は、月175億2,000万サンプルで1,051.20ドルです(出典:Google Cloud「Observabilityの料金例」、2026年8月確認)。
1ドル150円で仮置きすると、約3.9万円と約15.8万円です。これはPrometheus指標だけの試算で、ログとトレースは含みません。転送、保存、通知、運用費も、この金額には含まれません。
公式のコスト最適化例では、収集間隔を15秒から60秒に延ばすことで、カーディナリティを維持したままサンプル課金を75%抑えられます。
ただし、決済や障害検知のように秒単位の監視が必要な箇所まで、一律に間隔を延ばすのは危険です。サービスごとに必要な検知時間に合わせて、間隔を決めます。
重要度の低い指標に限って、収集頻度やラベルを見直します。
運用費(平日日中か24時間対応か)
有人運用の推定額は、対応時間と範囲によって変わります。ここに示すのは公開定価ではなく、類似システムを基にした推定レンジです。
- 平日日中:監視設計やアラート調整で月10万〜50万円程度です。
- 24時間365日:一次対応、エスカレーション、月次報告込みで月50万〜200万円程度です。
推定では、平日日中は0.2〜0.5人月、24時間対応は1人月以上の技術者対応を想定しています。
Cloud Monitoringなどの従量利用料や、保守改修、オンコール費は、別の項目として提示してもらいます。
見積もりの金額が安い場合は、含まれていない作業を確かめます。アラート調整や障害訓練、文書の有無を確認します。受け入れテスト、ログ保管設計、設定変更対応も含まれるかを見ます。
1年目の総額で比べると、契約後の予算差異を抑えやすくなります。その際は、初期開発費と12か月分のGoogle Cloud利用料、保守・運用費、追加改修費を含めます。
見積もりを取る際のポイントとチェックリスト
見積もりは、監視対象やデータ量、通知先、SLOを同じ粒度でそろえて比べます。ダッシュボードの枚数だけでは、Google Cloud Monitoringの見積もりを比べられません。テスト、移行、教育、運用体制も、同じ基準で示してもらいます。
要件が固まっていないなら、前提条件と仮の数量を見積書に書いてもらいます。変更が出たときの精算方法も、あわせて明記してもらいます。
要件と数量をそろえた見積もりの前提
依頼時には、対象の数量と監視条件を一覧にしておきます。公開と非公開のエンドポイントをどう確認するか、夜間対応の有無も明記します。
- 対象数:プロジェクト、環境、VM・Pod・Cloud Run、DB、外部API。
- 監視条件:業務KPI、ログの1日量、収集間隔、保持期間。
- 設定数:ダッシュボード、アラート、通知先、既存製品との連携。
- 確認方式:公開向けUptime Checkか、非公開向けPrivate Uptime Checkか。
成果物には、要件定義書や監視対象一覧、構成図を含めます。IAM設計やTerraformなどのコードが含まれるかも確かめます。
ダッシュボードやアラート一覧、通知設定、SLO定義も、中身を確認します。ログのマスキング方針やテスト仕様書、障害対応手順、運用引き継ぎ資料も対象です。自社がコードを利用・変更できる権利も確かめます。第三者サービスは、契約名義と解約時のデータ出力方法を押さえます。
同じ障害シナリオによる複数社の比較
候補会社には、同じ構成図と障害シナリオを渡します。回答がそろうと、各社の対応力を比べやすくなります。
- 障害対応:共通シナリオへの対応内容。
- 技術力:アプリ計装、Terraform、セキュリティ、SRE、既存監視との連携。
- 運用支援:24時間対応や内製化支援の有無と、改善指標の具体化。
決済APIのエラー率が上がったとき、どの指標とログを見て、誰へ通知するかを説明してもらいます。原因の説明に加えて、復旧手順も確かめます。
Google Cloudの導入実績も、候補を評価する一要素として扱います。各社の回答をもとに、見積もりで改善する指標を決めます。
Google Cloudの事例では、PienomialがCloud MonitoringとCloud Loggingを一元的な監視・ログ基盤にしました。同社は、クラウドインフラ費を40%削減し、ゼロダウンタイムを実現したと紹介されています。
IKS Healthの事例では、Cloud LoggingやCloud Monitoringを含む運用を改善しました。MTTRを30分未満にし、インフラ費を30%削減したとされています。
いずれも個別案件の結果で、同じ成果を保証するものではありません。見積もり時に「何を改善指標にするか」を具体化する参考になります(出典:Google Cloud「Pienomial」「IKS Health」、2026年8月確認)。
セキュリティと責任分界の契約条件
監視ログに個人情報や秘密情報が含まれる場合は、情報管理と責任分界を先に確かめます。
- 情報管理:取得項目、マスキング、アクセス権、保存先、保持期間。
- 委託管理:国外アクセスや再委託先、削除方法を、法務・セキュリティ部門と確かめます。
- 契約条件:障害対応の責任と時間、SLA、追加作業単価。
個人情報保護委員会は、外国にある事業者が運営するクラウドを利用する場合、サービス提供者や取扱状況の確認が必要だと注意を促しています。
安全性は、契約と運用の実態から判断します。リージョンが日本かどうかは、その確認の一つです。
契約書には障害の定義を書き、検知と連絡、復旧を誰が担うかを明確にします。設定変更の承認、監査ログ、月次報告、再発防止も、契約書に記載します。メンテナンス時の扱いや、監視が止まったときの代替手段も決めておきます。
復旧責任者や判断権限が曖昧なままだと、監視ツールを導入しても障害対応は改善しません。見積書と運用設計書を合わせて確かめます。
よくある質問(FAQ)
導入前によく寄せられるのは、機能や料金、既存製品との関係、アラート運用、個人情報の扱いです。実務の観点から、それぞれ見ていきます。
既存の監視製品をCloud Monitoringにすぐ置き換えるべきですか?
すぐに置き換える必要はありません。Google Cloudの標準指標はCloud Monitoringへ寄せ、ジョブ管理やマルチクラウド、既存の通知運用は既存製品と連携させる、段階的な移行が現実的です。
重要サービスで検知品質と運用負荷、月額費用を比べたうえで、重複する機能を整理します。
Google Cloud Monitoringは無料で使えますか?
一部の標準指標や無料枠はありますが、すべてが無料なわけではありません。外部・カスタム指標、Prometheusのサンプル、ログ、トレースでは、料金が発生する可能性があります。
Uptime CheckやSynthetic Monitoring、API読み取り、保存期間も、課金の要因になり得ます。そこで、対象や収集間隔、時系列数、ログ量をもとにPoCで月額を測り、公式料金表と照らし合わせます。
監視ログに個人情報が含まれる場合はどうしますか?
まずは、個人情報やカード情報をログに出さないアプリケーション設計にします。会員IDやIPアドレスを扱う場合は、マスキングとアクセス権限を決めます。
保持期間や監査ログ、委託先、国外アクセス、削除手順は、法務・セキュリティ部門と決めます。その内容を、監視要件と契約に反映します。
障害調査に使う相関IDは、本人を直接識別する情報と分けておくと有効です。
まとめ
Google Cloud Monitoringの開発は、業務影響を定め、検知から復旧までを仕組みにするプロジェクトです。重要サービスから段階的に進めると、アラート疲れや予算超過を抑えやすくなります。
全体は、要件整理、選定、設計開発、テスト、稼働、定着の順に進めます。
導入前に確認する5つの要点
導入前には、対象や責任の範囲を曖昧にしないことが大切です。
- 対象:業務影響の大きい順に監視対象を並べます。
- 責任:SLOと検知後の責任者を決めます。
- データ:標準・カスタム指標、ログ、トレースの役割を分けます。
- 費用:収集量と保持期間から利用料を試算します。
- 納品物:Terraform、テスト記録、運用手順。
どれか一つでも未確定なら、PoCか要件整理の成果物として明示します。
最初の一歩となる重要業務の選定
最初のPoCは、重要業務を選んでから、代表的な障害を再現して効果を測る順で進めます。
- 注文、決済、在庫、バッチなどのなかから、重要業務を一つ選びます。
- その業務の代表的な障害を再現する、小規模なPoCを行います。
- 検知時間、誤検知、MTTR、月額利用料、担当者の対応負荷を記録します。
PoCの結果は、次の対象の選定と見積もりに反映します。
ツールやベンダー、契約を決める前に、業務を止めないための判断基準を社内で共有します。この共有が、定着する監視システムへの近道になります。
▼全体ガイドの記事
・Google Cloud Monitoringのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。