
GKEを使うシステム開発は、要件整理から始まり、稼働と定着まで6つのフェーズで進みます。
各段階で完了条件を決めて記録し、次へ進むかを判断しながら進めることが、業務に合う運用基盤につながります。
▼全体ガイドの記事
・Google Kubernetes Engineのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Google Kubernetes Engineのシステムの概要
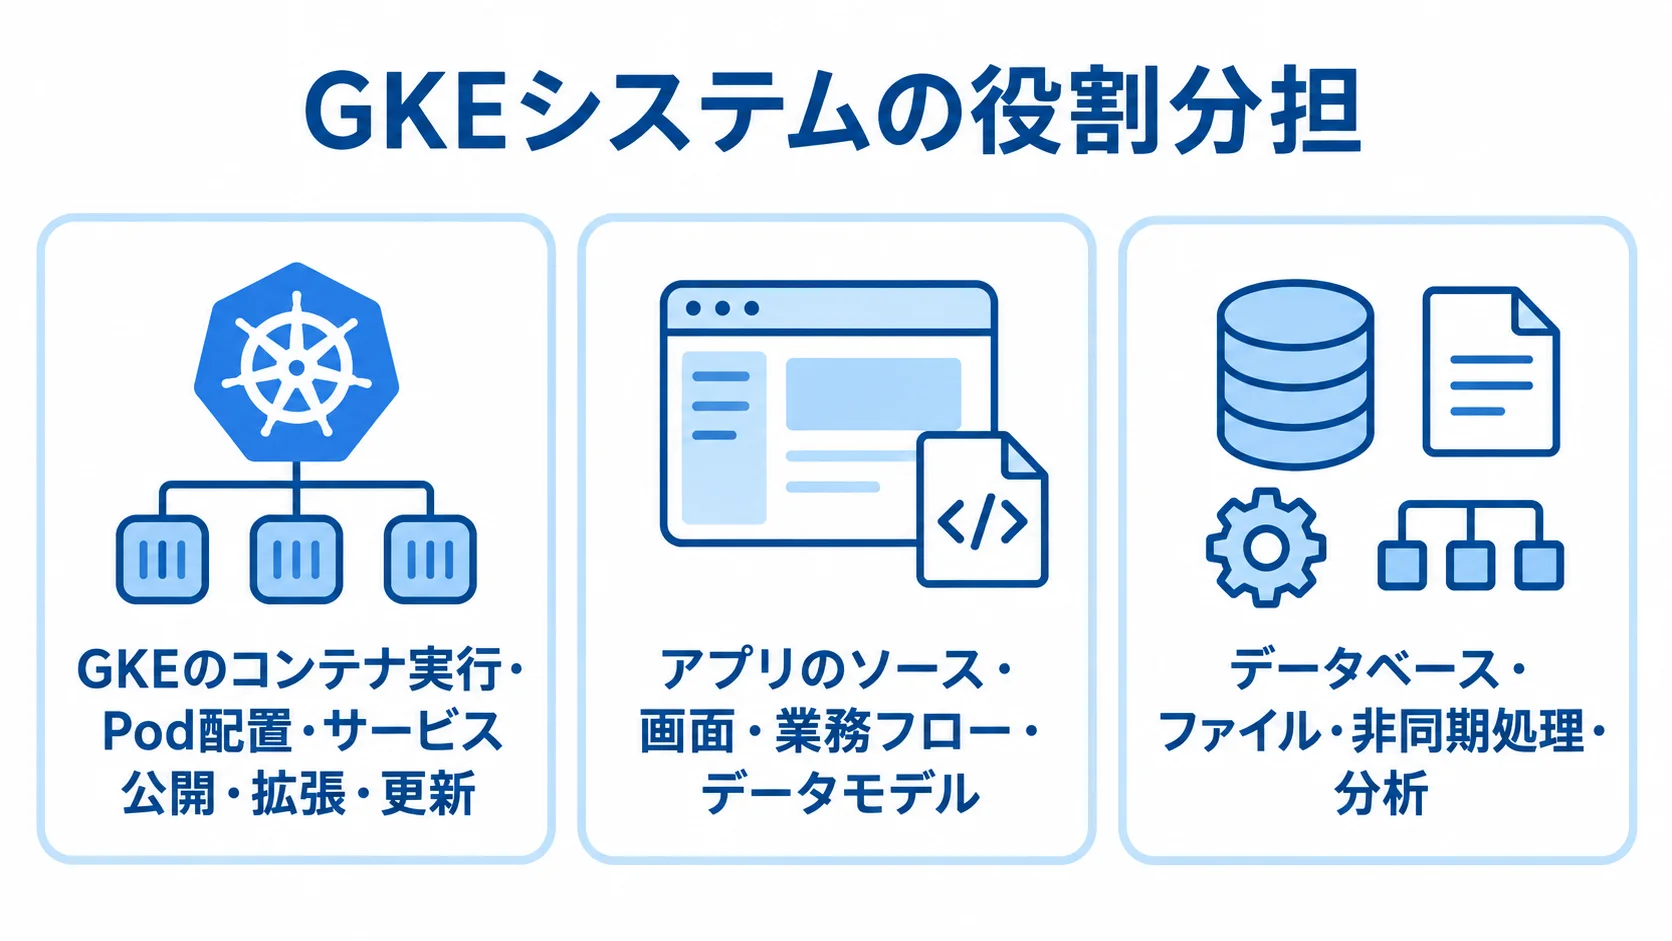
Google Kubernetes Engineのシステムは、コンテナ化した業務アプリをGKEで実行する構成です。アクセス制御やデータ管理、継続的デリバリーには、Google Cloudの各サービスを組み合わせます。監視にも、各サービスを使います。
GKEは業務システムを安定して配備・拡張する実行基盤で、業務機能そのものは別に開発します。この役割を前提にすると、開発範囲を整理できます。
GKEが担当する範囲と担当しない範囲
GKEとアプリ開発の担当範囲は、次のように分けて考えます。
- GKEの担当:コンテナ実行、Pod配置、サービス公開、拡張、更新
- 別途開発する範囲:アプリのソース、画面、業務フロー、データモデル
- 周辺サービス:データベース、ファイル、非同期処理、分析
データベースにはCloud SQL、Spanner、Firestoreなどを候補に挙げます。ファイルはCloud Storage、非同期処理はPub/Sub、分析はBigQueryなど、役割ごとに組み合わせます。
GKE構築費だけで見積もると、後から認証基盤や外部API、データ移行の費用が加わります。監視と障害対応も、最初から見積もりに含めておく必要があります。
発注側と開発会社は、GKE内外の機能と既存連携を一覧にし、項目ごとに責任者と運用方法を決めます。
AutopilotとStandardの選定基準
両モードは、ノードの運用をGKEに任せるか、自分で細かく制御するかで性格が分かれます。
- Autopilot:ノード運用をGKE側に寄せ、Podのリソース要求を中心に使う
- Standard:ノードプール、マシンタイプ、OS、GPU、ネットワーク、配置を細かく制御する
特別な権限や構成上の制約が必要でなければ、多くのワークロードでAutopilotが推奨されています(出典:Google Cloud Documentation「About GKE modes of operation」、2026年7月更新)。選ぶ際の基準は、料金の安さよりも、ノード操作が必要かどうかとリソース要求です。
標準的なWeb API、管理画面、バッチでノード操作が不要なら、Autopilotが候補になります。GPUや特殊なカーネル設定、特権コンテナが必要な場合は、Standardを検討します。また、既存ノードとの互換性や細かな配置制御が必要な場合も、Standardが候補になります。
迷う場合は、代表的なワークロードを両モードでPoCします。比べるのは、手順と性能、ログ、費用です。障害時の復旧時間も、比べる項目に入れます。
Google Kubernetes Engineのシステム開発の進め方
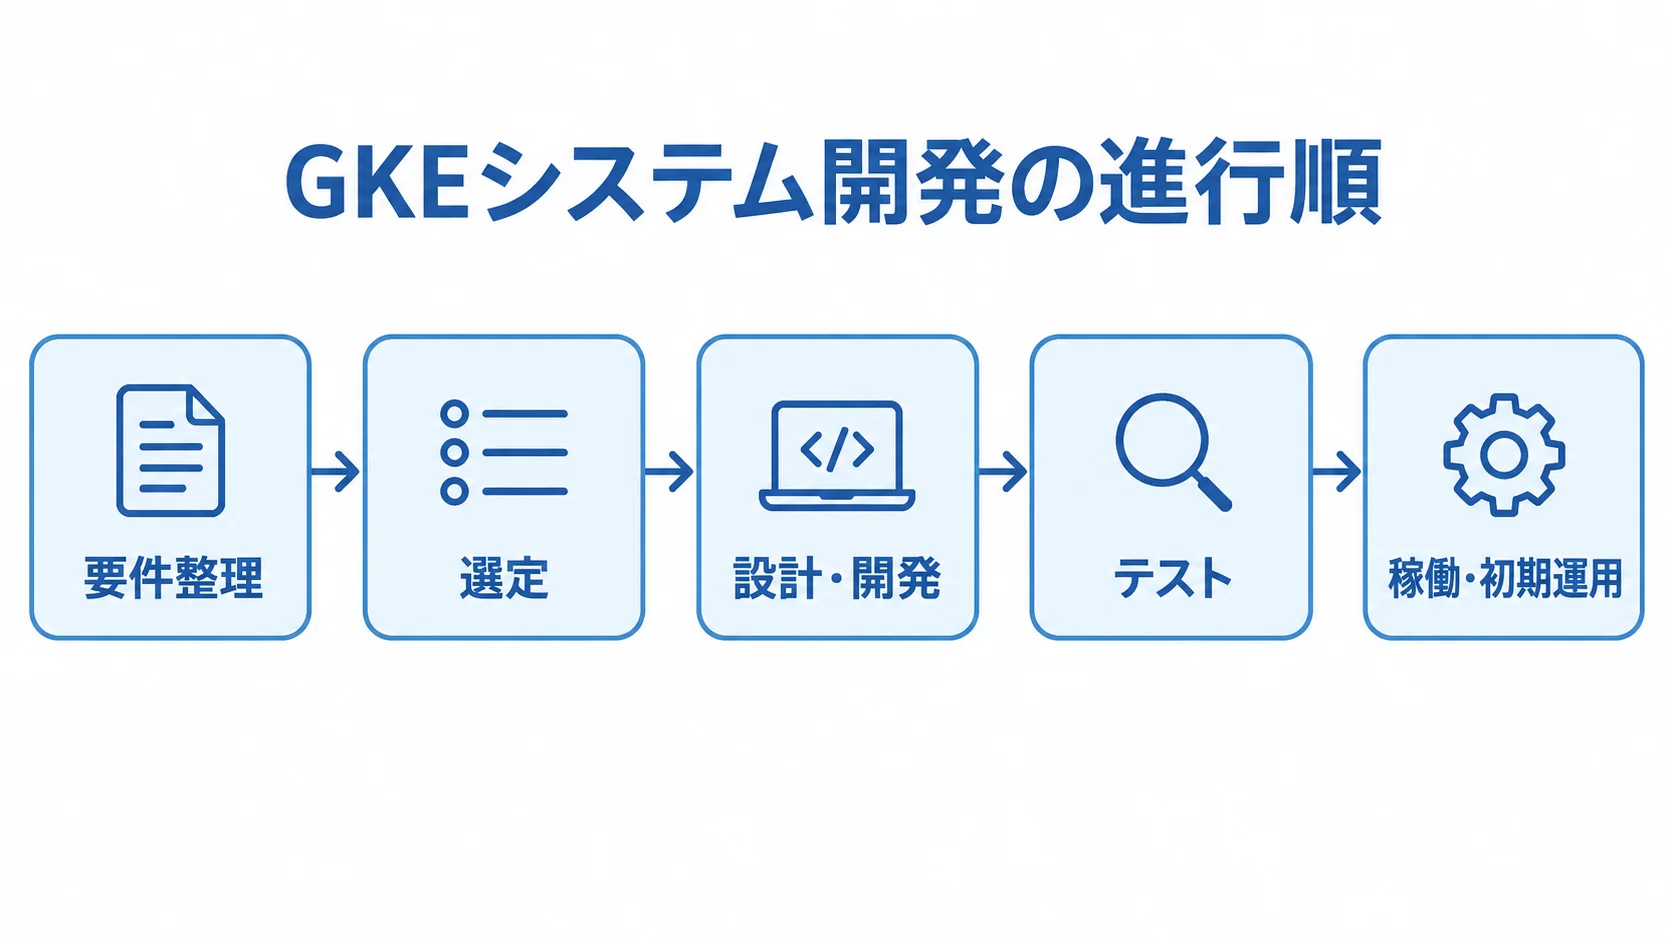
開発は6つのフェーズに分けて進めます。クラスタを先に作らず、各段階の完了条件と次へ進む判断を記録します。
- 業務要件と非機能要件の整理
- GKEの妥当性と利用モードの選定
- アプリと実行基盤の設計・開発
- 機能、負荷、障害、復元のテスト
- 移行、稼働、初期運用の管理
- 運用の改善と担当者への引き継ぎ
1. 要件整理:業務要件と非機能要件の確認
要件整理では、業務の流れと非機能条件を確認します。確認の観点を先にそろえておきます。
- 業務要件:利用者、業務、データ、得たい結果
- 非機能要件:負荷、可用性、復旧、ログ、個人情報
- 運用条件:認証・権限、データ移行、予算上限、担当者の勤務時間
販売管理なら受注から請求まで、会員基盤なら登録から退会・データ削除までを業務フローにします。
例外処理は、画面やAPIの一覧から抜けやすいため、繁忙期、承認差し戻し、外部サービス停止時の動きも確認します。
負荷はピークと平均の両方を決めます。許容待ち時間や稼働率、RTO、RPOも、この段階で決めておきます。さらに、監査ログや移行、予算の条件を確認するほか、個人情報の保管場所も押さえます。
条件が曖昧なままだと、後工程でクラスタ数やマシンサイズを増やすだけの判断に傾きます。
2. 選定:GKEの妥当性とモードの比較
要件がまとまったら、次の観点で基盤とモードを比べます。
- 代替基盤:Cloud Run、App Engine、Compute Engine、既存パッケージ、SaaS
- GKEの適性:独立デプロイ、細かな拡張、コンテナ標準の移行性
- モードの比較軸:費用、制御範囲、権限、GPU、運用体制
個別のKubernetes機能を使わない単純なWebサイトや少数の定型APIは、運用負担の小さいサービスが適する場合があります。一方で、複数サービスの独立デプロイや負荷に応じた細かな拡張、コンテナ標準による移行性が必要なら、GKEが候補です。
利用目的を先に明確にし、採用理由と不採用の選択肢を記録します。
2025年9月からGKE Standardでは、一部機能を追加費用なしで使える料金体系が案内されています(出典:Google Cloud Blog「GKE gets new pricing and capabilities on 10th birthday」、2025年8月)。
その対象は、Fleet、Teams、Config Managementなどのマルチクラスタ管理機能で、Policy Controllerも含まれます。ただし、機能を使うほど設計・運用の専門性が必要です。
3. 設計・開発:アプリとプラットフォームの一体開発
基盤とアプリは一体で設計し、環境分離や再現方法も決めます。
- 基盤と権限:組織、ネットワーク、IAM、RBAC、Namespace
- アプリ実行:コンテナ、Kubernetesリソース、Probe、リソース上限
- 自動化とデータ:CI/CD、IaC、DB、監視の再現性
Google Cloudのフォルダとプロジェクトを分け、VPCとサブネットを設計します。Private Google Accessとファイアウォールも設計します。
開発、検証、本番は、それぞれ別のプロジェクトに置きます。環境分離とアクセス申請の流れも決めます。
PodからCloud SQLやCloud Storageへ接続する場合、静的な鍵は配布しません。Workload Identity Federation for GKEとサービスアカウントを使います。
コンテナの定義には、Dockerfile、Deployment、Serviceを用意します。IngressまたはGateway、ConfigMap、Secret参照も定義します。さらに、Readiness ProbeとLiveness Probeも設定します。
イメージはArtifact Registryへ登録し、Cloud BuildやGitHub Actionsなどで自動テストとデプロイを行います。
TerraformなどのIaCで、クラスタやIAM、ネットワークを再現します。監視も同じIaCで再現します。
DBをPodに入れるかは慎重に判断します。運用負担やバックアップ要件に合うマネージドDBを優先します。
4. テスト:正常系に加えた非機能と障害の検証
テストでは、動作の確認に加えて、障害や復旧の場面も試します。
- 機能と権限:段階ごとの機能確認と、脆弱性・権限の検証
- 基盤動作:Pod、ノード、更新、Ingress、Secret、ログ、アラート
- 非機能:負荷、バックアップ復元、切り戻し条件
テストは、単体と結合を経て、システムと受入の順で進めます。Pod再起動やノード交換も確認します。さらに、オートスケール、ローリング更新、Ingressのヘルスチェックも検証します。
Canaryは新バージョンを一部の利用者へ流す方法です。また、Blue-Greenは旧環境と新環境を切り替える方法です。採用時は、切り戻し条件を数値で決めます。
負荷試験では、平均負荷だけでなく、業務計画に基づくピークの2倍などを試します。記録するのは、レイテンシ、エラー率、CPU・メモリです。さらに、Pod数、DB接続数、外向き通信量も記録します。
バックアップは、別環境への復元時間とデータ整合性まで試します。たとえば、RTOが2時間の場合は、担当者が手順書で2時間以内に復旧できるかを実測します。
5. 稼働:切り替えと初期運用の管理
稼働前後の確認と担当分担を決め、切り替えの判断がぶれないようにします。
- 本番判定:受入、課題、監視、連絡、戻し方、移行結果の確認
- 切り替え:開始宣言者と、継続・中止の判断値の決定
- 初期運用:監視間隔と、社内外の障害対応分担の明文化
既存システムから移行する場合は、最低1回リハーサルします。その際、停止時間、差分データ、件数照合を確認します。文字コードやタイムゾーン、外部連携の再送も確認します。
稼働直後は、エラー率と応答時間を短い間隔で確認します。さらに、Pod再起動やノード、DB負荷、キューの滞留も確認します。
ログと監視には、Cloud Logging、Cloud Monitoring、Traceを組み合わせます。Error Reportingも加えて、利用者の操作からインフラまで障害を追います。
障害窓口は開発会社に任せきりにせず、自社の業務責任者、情報システム部門、クラウド運用担当の分担も明文化します。
6. 定着:運用改善と内製化
定着では、稼働後の運用を振り返って改善し、担当者への引き継ぎも進めます。
- 成果と改善:業務成果や運用指標の定期的な見直し
- 運用の引き継ぎ:担当者が操作や復旧を演習する
- セキュリティ:最小権限やログ収集などを運用に組み込む
月次では、SLO達成率、障害件数、変更失敗率を振り返ります。さらに、復旧時間や費用、リリース頻度も見ます。
リリースを速めたい場合は、デプロイ時間だけでなく、承認・テスト待ちや切り戻し時間も分解します。
引き継ぎは演習形式で行い、Namespace作成やログ確認、ロールバックを扱います。さらに、スケール設定や脆弱性対応、アップグレードに加えて、復元も引き継ぎます。
Google Cloud公式文書は、IAMとRBACの最小権限を推奨しています。さらに、Workload Identity Federation、プライベートノード、Secret Managerも推奨されています。
NetworkPolicyやログ収集も、推奨項目に含まれます(出典:Google Cloud Documentation「Best practices for hardening your cluster’s security」、最終更新2026年7月17日)。
定着の条件は、設計書を残すことに加えて、担当者が実際に操作できる状態へ引き継ぐことです。
Google Kubernetes Engineのシステム開発費用相場とコストの内訳
初期費用は、要件定義、アプリ開発、コンテナ化の工数で変わります。IaCやCI/CDの工数も、費用を左右します。テストや移行、教育の工数によっても変わります。
クラウド費用は、クラスタとPodまたはノードの構成で変わります。ストレージやロードバランサ、NATの料金も加わります。ログやバックアップ、外部通信も費用の対象です。
費用の比較では、クラスタ管理料だけで判断しないことが大切です。
初期の開発費用の規模と移行難易度による違い
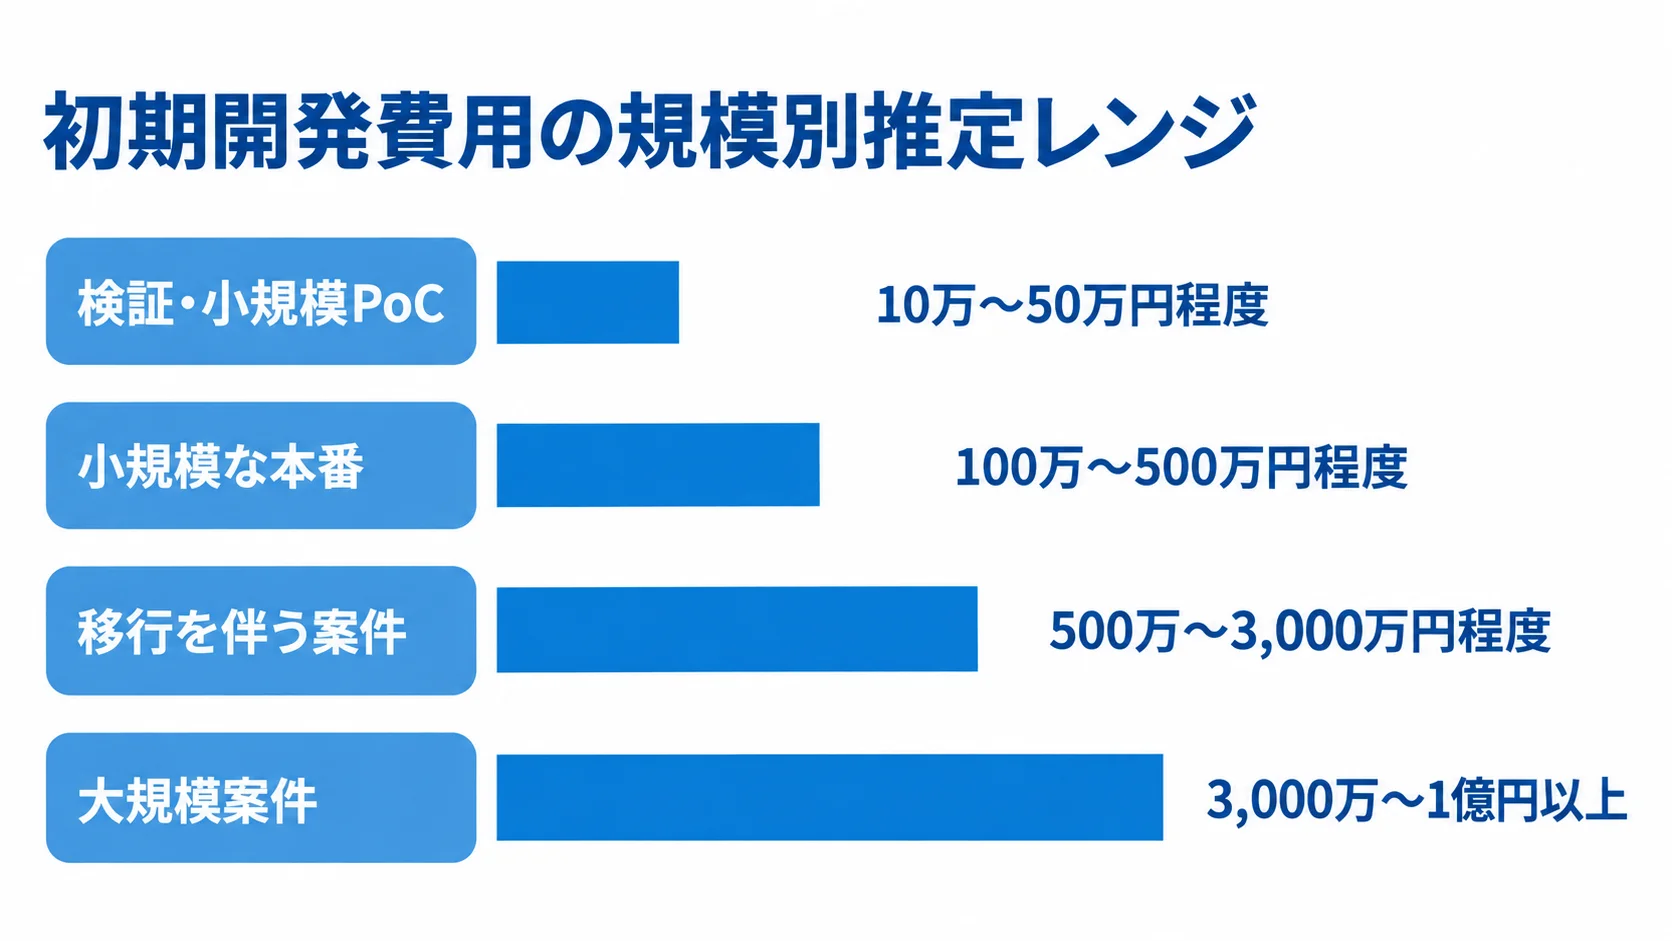
PoCから大規模案件まで、初期費用と開発期間は、規模や移行範囲に応じて幅が広がります。
- 検証・小規模PoC:10万〜50万円程度、2〜6週間
- 小規模な本番:100万〜500万円程度、3〜6か月
- 移行を伴う案件:500万〜3,000万円程度、6〜12か月以上
- 大規模案件:3,000万〜1億円以上、12〜18か月以上
PoCは小規模なコンテナ化、最小クラスタ、簡易CI/CDを想定します。ただし、業務機能の本開発や本番運用設計を含まない場合があります。
金額は、リサーチノートと一般的なクラウド型・スクラッチ型システムを参考にした推定です。
小規模な本番では、ランディングゾーン、IAM、ネットワークを想定します。監視やバックアップ、デプロイ自動化、数個の業務サービスも含みます。
既存システムのコンテナ化やマイクロサービス化が必要かどうかで、見積もりが変わります。複数環境やデータ移行、性能試験の有無も影響します。
複数リージョンや高可用性、規制対応を含む場合は、大規模案件として見積もります。GPUなどを使う場合も、大規模案件として見積もります。
いずれも、要件に基づく受託開発の推定レンジで、GKEの公式価格ではありません。
GKE以外の項目を含めた月額クラウド費用
課金の単位と無料枠の適用条件を分けて確認すると、月額の見落としを防げます。
- クラスタ管理料:1クラスタ毎時0.10ドル
- Autopilot:PodのvCPU・メモリ使用量で課金
- Standard:ノードのCompute Engine料金が中心
- 共通の追加費用:ストレージ、通信、DB、監視、バックアップ
クラスタ管理料は、1クラスタを730時間稼働すると約73ドルです。請求アカウントごとに月74.40ドル相当の無料枠があります(出典:Google Cloud「Google Kubernetes Engine pricing」、2026年8月確認)。ただし、対象クラスタの条件があり、Compute Engineや他のSKUには適用されません。
一般的なAutopilotのPod課金例では、vCPUは毎時0.0445ドル、メモリはGiB毎時0.0049225ドルです。
たとえば、2 vCPUと8GiBを730時間使うと、CPU約65ドル、メモリ約29ドルです。管理料約73ドルを加えた合計は約167ドルで、1ドル150円なら約2万5,000円ですが、リソースを常時確保する限定試算です。
ディスク、ロードバランサ、NATは別料金です。さらに、ログとバックアップ、外部通信、DBも別料金です。
為替と料金は変動するため、契約前にGoogle Cloud Pricing Calculatorで再計算します。
Standardは、ノード数やマシンタイプによって変わります。リージョンや稼働時間でも変わります。さらに、開発・検証・本番の複数クラスタも見積もります。
また、Cloud SQLやSpanner、Cloud Storageも加えます。Cloud Load Balancing、Cloud Armor、Cloud NATも、見積もりに入れます。
ログや監視、Artifact Registryも見積もります。バックアップやデータ転送も、見積もりの対象です。
クラウド利用料、運用人件費、サポート・保守費を分けて見ると、増額の原因を追えます。
Google Kubernetes Engineの見積もりを取る際のポイント
見積もりは、クラスタ構築だけか、アプリ開発から運用定着まで含むかで変わります。そのため、作業と成果物、前提と対象外をそろえて比べます。どこまでを誰が受け持つかと、検収条件も比べる項目に含めます。
要件定義書に書く負荷・環境・運用条件
見積もりに必要な条件と範囲をそろえて提示します。
- 負荷・データ:利用者数、ピーク、処理量、データ増加
- 環境・運用:環境数、クラスタ、リリース頻度、オンコール
- 成果物:設計、IaC、CI/CD、テスト、移行、運用手順
許容レスポンスタイムや稼働時間、RTO・RPOも提示します。対象リージョンや個人情報の有無、Namespaceも伝えます。未確定項目は「未定」と明記し、見積上限と追加条件を記載します。
受け取る書類として確認するのは、要件定義書や基本・詳細設計書、ネットワーク構成図です。IAM・RBAC一覧やIaCコードも確認します。
実装面では、Dockerfileやマニフェスト、CI/CD定義、テスト仕様書を確認します。移行計画や運用手順書、障害対応フローも確認します。教育資料も確認します。
IaCとCI/CDが納品されないと、環境追加や復旧を都度ベンダーへ頼むことになり、定着段階の費用が膨らみやすくなります。
複数社の技術と運用の責任分界の比較
複数社を比べるときは、技術体制、運用でどこまでを誰が受け持つか、費用内訳を同じ条件で確認します。
- 対応体制:アプリ、移行、データ、SRE、セキュリティ、内製化
- 責任分界:障害対応時間、GKEとDBの支援範囲、納品形式
- 費用条件:工数配分と保守に含む作業範囲
挙げた領域を、同じ担当体制で支援できるかを確認します。
AutopilotとStandardを案件ごとにどう使い分けるかを質問します。IaCやソースコードの納品形式、クラウド費用の月次レビューも確認します。
工数配分の参考値は、要件定義が10〜15%、設計が25〜35%、実装が30〜40%です。テストは15〜20%、移行・教育は5〜10%程度です。比率は固定相場ではありません。
設計やテストが極端に少ない場合は、非機能要件や運用設計が別料金か確認します。
年間保守は初期開発費の10〜20%程度を目安に示される場合があります。24時間対応や脆弱性対応、アップグレード、費用の見直しの有無で、内容が変わります。
過小見積もりになりやすいリスク
追加費用になりやすい原因と、業務側で確認すべき条件を整理します。
- アプリ移行:コンテナ化、状態保持、DB接続、外部APIの制約
- 運用条件:バッチ再実行、時刻・文字コード、秘密情報、接続元
- データ保護:権限、ネットワーク、個人情報、ログ、復旧
セッションやファイルのローカル保存、DB接続数、外部API制限は、追加費用の原因です。移行品質や過剰なログも、原因になります。障害時の責任者も決めます。
マネージドサービスを使っても、安全性は自動では確保されません。そのため、Workload Identity Federation、Secret Manager、NetworkPolicyも設計対象です。
個人情報の保存場所、アクセスレビュー、ログの保存期間は、業務・法務担当者と確認します。委託契約や削除請求、バックアップの保持期間も、確認が必要です。ログ収集やインシデント対応も、利用者側の設計対象です。
よくある質問(FAQ)
GKEを採用するか迷う段階では、業務要件、費用、運用体制を整理して相談します。よくある質問への回答も判断材料になります。
GKEとCloud Runはどちらを選べばよいですか?
コンテナ配置やネットワークを細かく制御したい場合は、ノードやKubernetes APIまで扱えるGKEが候補です。
Cloud Runは、クラスタ運用をできるだけ減らし、リクエスト単位で公開したい場合に適する可能性があります。
サービス数や常時稼働の有無、特殊な権限やGPUを踏まえて選びます。社内のKubernetes運用者の有無も、判断の材料です。
既存のJavaやNode.jsの業務システムをGKEへ移行できますか?
移行できる可能性はあります。ただし、ソースをコンテナに入れたうえで、既存の動きを見直す必要があります。見直す対象は、ファイルやセッション、バッチです。
さらに、DBや外部接続、ログも見直します。設定値や時刻処理も、見直しの対象です。
段階的な移行や並行稼働を設計します。モノリスを一度に分割するとリスクが上がるため、先にコンテナ化して安定させ、業務境界を見て分割する方法もあります。
GKEならインフラ担当者は不要になりますか?
GKEを使っても、利用者側に残る運用と担当分担は明確にしておきます。
- 継続運用:IAM、RBAC、ネットワーク、脆弱性、更新
- 日常管理:監視、バックアップ、費用、障害対応
- 担当分担:内製、開発会社、マネージドサービス
GKEはコントロールプレーンやノード運用の負担を軽減します。Google Cloudの事例では、米国のMercariチームが専任インフラ担当者を置かず運用できたと紹介されています。
ただし、これはアプリ設計や支援体制、チームの習熟が整った事例です(出典:Google Cloud「Mercari Case Study」、2026年8月確認)。
最初に何を準備して開発会社へ相談すればよいですか?
業務フローや利用者と権限、既存構成を整理します。連携先やピーク負荷、データ量も整理します。
時期と予算上限、運用担当者も伝えます。仕様が未確定でも、業務課題と必須条件は分けて伝えます。
開発会社には、GKEの採否とモード比較、PoCの範囲を分けた提案を依頼します。費用も、初期費用と月額費用、保守費用を分けて示してもらいます。
まとめ
GKE開発の範囲は、クラスタ構築より広く、要件の整理から運用設計までを含みます。まず、要件を整理して採用理由を確認し、モードを選びます。アプリやデータ、認証、ネットワークを運用設計に含め、監視とバックアップも対象にします。
6フェーズごとの完了条件の設定
要件整理では業務要件と非機能要件を分けて確認し、選定ではCloud Runなども比べます。設計・開発では、IaCやCI/CD、最小権限を検討します。マネージドDBを使うかどうかも、判断の対象です。
テストでは、負荷や障害を実測し、復元や切り戻しも確認します。稼働後は、SLOや費用、障害、リリースを定期的に振り返って改善します。
各フェーズの完了条件は、担当者が実行できることや目標値を満たすことまで定めます。
着手前の費用と責任分界の整理
開発会社へ依頼する前に、初期開発費、月額クラウド費用、保守・運用費を分けます。
そのうえで、GKEやアプリ、DBの担当範囲をまとめます。ネットワークやセキュリティ、データ移行の担当範囲も加えます。
GKEを採用しても、自動的に安く、安全で、運用不要になるわけではありません。そのため、小さなPoCでコンテナ化と非機能を検証し、本番範囲を決めると、過剰投資や後戻りを抑えられます。
▼全体ガイドの記事
・Google Kubernetes Engineのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。