
Helmのシステム開発は、要件整理から定着まで6つの段階を順に進めます。中心になるのは、基盤と運用方式の選定、設計開発、稼働です。各段階で成果物と判断基準を確かめておくと、環境差分を管理したまま運用まで定着させられます。
全体像、6つの開発フェーズ、費用と見積もりの順にたどります。
▼全体ガイドの記事
・Helmのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Helmのシステム開発の全体像
Helmは、コンテナ化したアプリをKubernetesへ再現性高く配置するパッケージマネージャーで、業務アプリケーションやKubernetesクラスターそのものではありません。システム開発では、Helmを配布とリリース管理の共通の層として位置付けます。
Chart・Release・valuesによる環境差分の管理
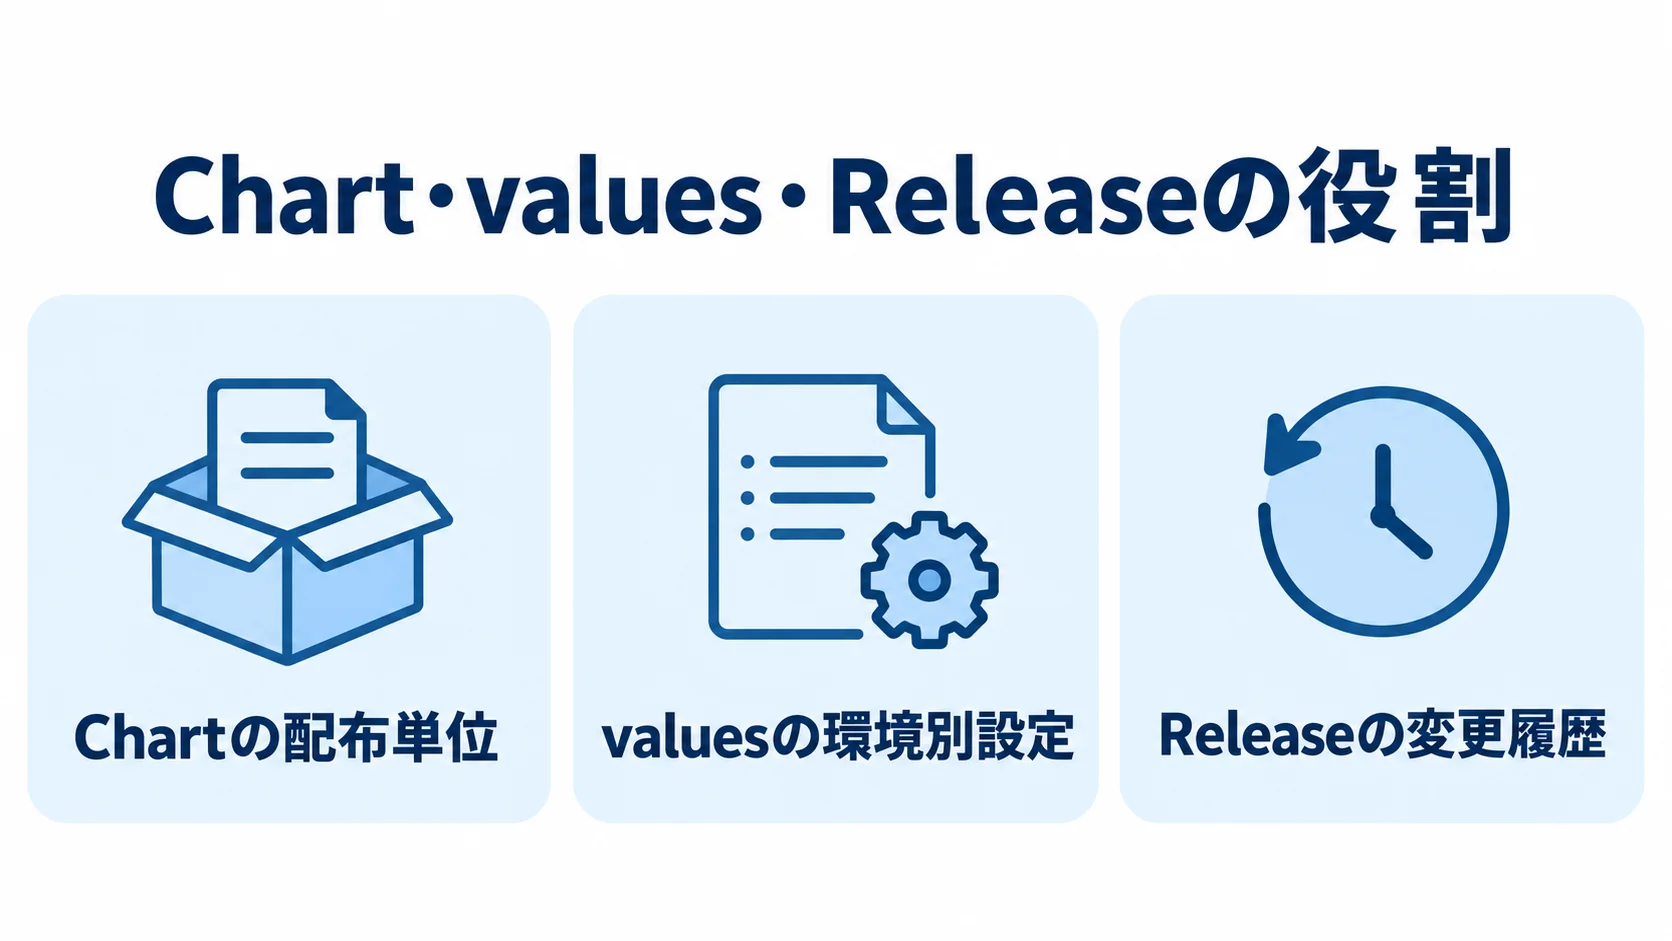
Helmでは、Chart、values、Releaseを組み合わせて環境ごとの差分を管理します。役割を分けておくと、配布内容と変更履歴をたどりやすくなります。
- Chart:Deployment、Service、Ingress、ConfigMap、Secret参照などを含む配布単位。
- values:環境別のイメージタグ、レプリカ数、接続先などを指定する設定。
- Release:特定のChartを指定した値でnamespaceへ導入した実体。履歴から変更を確認したり、ロールバックしたりできます。
Chartに全機能を詰め込むと、値の依存関係や変更の影響を追いにくくなります。そのため、サービス境界と依存Chartを先に決め、責任範囲を小さく保ちます。namespace、Secretの管理者、リリース単位も、あわせて決めておきます。
HelmとKubernetesが向くシステムの見極め
HelmとKubernetesを採用するかは、環境の再現性や運用負荷といった要件を基準に判断します。
- 適合しやすい要件:サービス数が多く、頻繁なデプロイや水平スケールが必要なケース。
- 展開先:環境を何度も作る場合や、複数クラウド・クラスターへ同じ構成を展開する場合。
- 代替案も検討:小規模Webアプリが1つで、頻度と担当者が少ない場合。
CNCFの2026年1月公表の調査では、コンテナ利用者の82%が本番環境でKubernetesを使っています(出典: CNCF Annual Cloud Native Survey、2026年)。
Kubernetesが広く使われていても、採用すれば必ず得をするとは限りません。代替案の条件に当てはまる場合は、Cloud Run、Amazon ECS、Azure App Serviceの方が運用負荷を抑えられることがあります。
停止許容時間とピーク負荷を比べ、サービス数と運用人員も確かめたうえで、Helmを使うかを決めます。
Helmのシステム開発の進め方
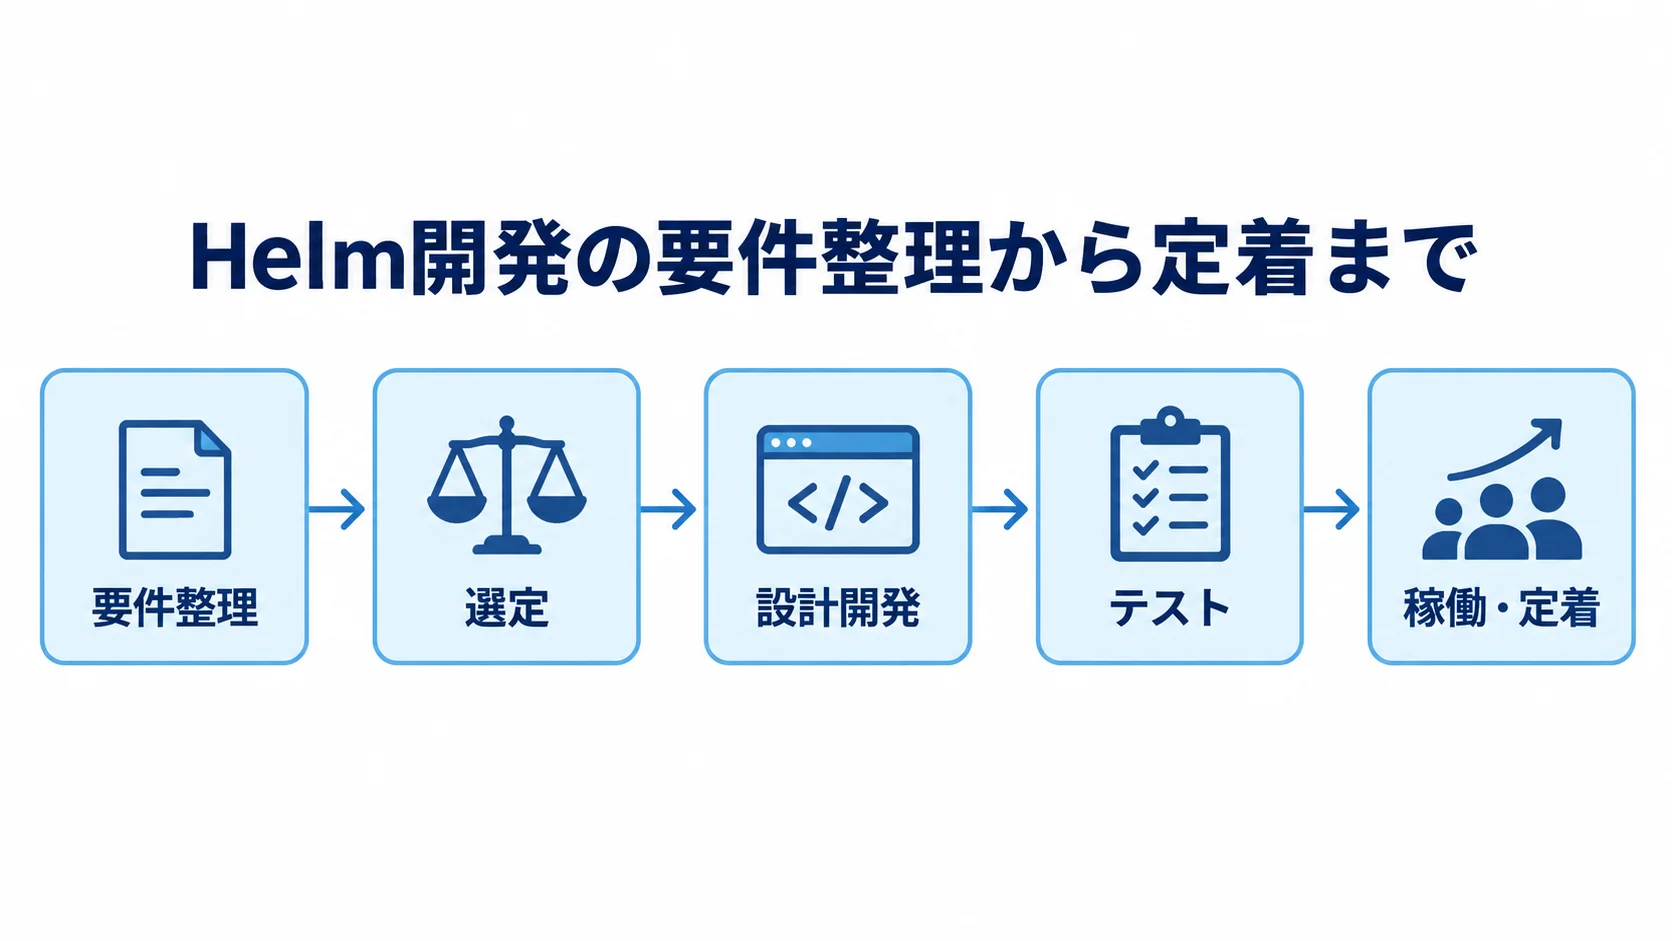
Helmのシステム開発では、Chartを書く前に業務要件と運用要件を決めておきます。要件整理から定着までの各段階で、成果物と判断基準を確かめながら進めます。
1. 要件整理での業務と非機能の数値化
最初に、業務を誰が行うのか、どんな内容で、どのデータを、どのくらいの頻度で扱うのかを整理します。
- 対象範囲:サービス、利用者数、ピーク時リクエスト数、既存DB。
- 接続と情報:認証方式、外部API、個人情報の保存場所。
- 停止・復旧:停止可能時間、目標復旧時間(RTO)、目標復旧時点(RPO)。
- 導入目的:デプロイ標準化、チームの独立性向上、複数環境の再現。
可用性は、月次締め中の停止回避や、障害から30分以内の復旧といった具体的な基準で評価します。「高可用性」とだけ書いても、何をもって満たしたとするかが定まりません。
目的が曖昧なままKubernetesを採用すると、YAMLと監視の管理だけが増えてしまいます。業務フローとデータ移行の責任者は発注者側で確定させ、運用対応時間と監査ログの保存期間も、同じ段階で決めておきます。
2. 選定でのクラウドと運用方式の比較
選定では、基盤とHelmの管理方法を比べたうえで、運用負担と将来の人材確保も見ます。
- 基盤:EKS、GKE、AKS、オンプレミスの比較。
- Helmの管理:Helm単体、CI/CD連携、Argo CDやFluxによるGitOps。
- 基盤との境界:TerraformやOpenTofuは基盤、HelmはKubernetes上のアプリ。
- 比較項目:初期費用、更新、障害対応、権限管理、人材確保。
EKSはAmazon、GKEはGoogle Cloud、AKSはAzureのKubernetesサービスです。オンプレミスを含めて、これらを比べます。
マネージドKubernetesは、コントロールプレーンの管理や一部の更新を任せられます。一方で、ノードやロードバランサー、ストレージは別途設計します。ログ、転送、監視も、対象に含まれます。
閉域網や特殊なハードウェア、データ主権などの明確な理由がなければ、まずマネージドサービスを候補にします。
3. 設計開発でのアプリとChartの責任範囲の分離
設計と実装では、アプリとChartそれぞれの責任範囲を分けて定めておきます。
- 設計:イメージ、Chart、values、namespace、Ingress、Secret参照。
- 運用設定:リソース要求量、オートスケール、ログ・メトリクスの出力先。
- 実装とCI/CD:環境別valuesをGit管理し、承認、スキャン、テスト、デプロイ、復旧を組み込む。
アプリを無理にマイクロサービスへ分割せず、デプロイ単位と障害単位が業務の実態に合っているかを確認します。
DBを外部のマネージドサービスで運用するか、クラスター内で運用するかは、バックアップと復元の責任を含めて決めます。
Chartのテンプレートは小さく保ち、環境差分はvaluesに寄せます。CIでは、脆弱性スキャンとChart lintに加え、レンダリング確認と単体テストを行います。
CDでは、承認からロールバックまでを一連の手順にします。その間に、デプロイとヘルスチェックを行います。
4. テストでの構成と復旧の検証
構成と復旧の両面からテストし、画面表示だけでは見つからない問題を確かめます。
- 構成:異なるvaluesでレンダリングし、権限、公開ポート、Secretの平文出力、リソース上限の不足を確認。
- 各種テスト:機能、API連携、負荷、脆弱性、権限を検証。
- 障害・復旧:ローリング更新と、Pod・ノード・外部DBの障害を、RTO・RPOに照らして試す。
- 復旧記録:別担当者が手順書を使い、所要時間、判断条件、連絡先、整合性を記録。
Release履歴があっても、DBのスキーマ変更や外部サービスのデータが自動で元に戻るとは限りません。そのため、ロールバックとバックアップ復元は、それぞれ個別に確かめます。
テストの完了は、担当者の感覚で決めるのではなく、証跡と合格基準で定義します。
5. 稼働での段階移行と責任分界の確認
本番稼働では、全機能を一度に切り替えず、業務の停止を抑えられる方式を選びます。
- 移行方式:低リスクのサービスや限定ユーザーから開始。並行稼働、カナリア、機能フラグも選択肢。
- 切り替え確認:DNS、証明書、外部API、監視通知、バックアップ、窓口、中止条件。
- 責任分界:発注者、開発会社、クラウド事業者、運用担当者の承認・対応・更新担当。
- 納品物:Chart、values、CI/CD、インフラコード、設計・テスト・監視・運用・復旧資料。
Go-Live判定では、リリースの承認者と夜間の一次対応を担う人を文書に残します。クラウド障害の連絡や、Chart・イメージの更新担当も、同じ文書に書いておきます。
6. 定着での更新と教育の運用への組み込み
稼働後は、Helm本体とKubernetesの更新周期を決めます。クラウドのアドオン、ベースイメージ、依存Chartについても、同じ考え方で周期を定めます。更新は、互換性を確かめてから段階的に進めます。
- 互換性確認:既存Chart、プラグイン、Kubernetes、CI/CDとの動作を検証して更新。
- 運用教育:values変更、ログ、アラート、ロールバック、Secret申請、脆弱性連絡。
- 定期確認:月次または四半期ごとにデプロイ頻度、変更失敗率、復旧時間、未対応の脆弱性、費用、不要リソースを点検。
Helm公式ブログによると、Helm 4.0.0は2025年11月12日に公開されました。2026年6月時点では、Helm 3のサポート終了に向けた評価を案内しています(出典: Helm公式ブログ、2025〜2026年)。
納品して終わりにせず、業務側が自分で判断できる状態になったときを、定着の完了条件とします。
Helmのシステム開発の費用相場とコストの内訳
Helm本体はオープンソースのため、原則としてライセンス購入費はかかりません。費用は、基盤とアプリ改修、CI/CDの範囲で変わります。監視やセキュリティ、データ移行も、費用に加わる要素です。教育と保守も、費用を構成する要素です。
次に示す金額は、2026年時点の一般的な業務システムやコンテナ基盤の工数感による概算です。Helm単体の公定価格ではありません。
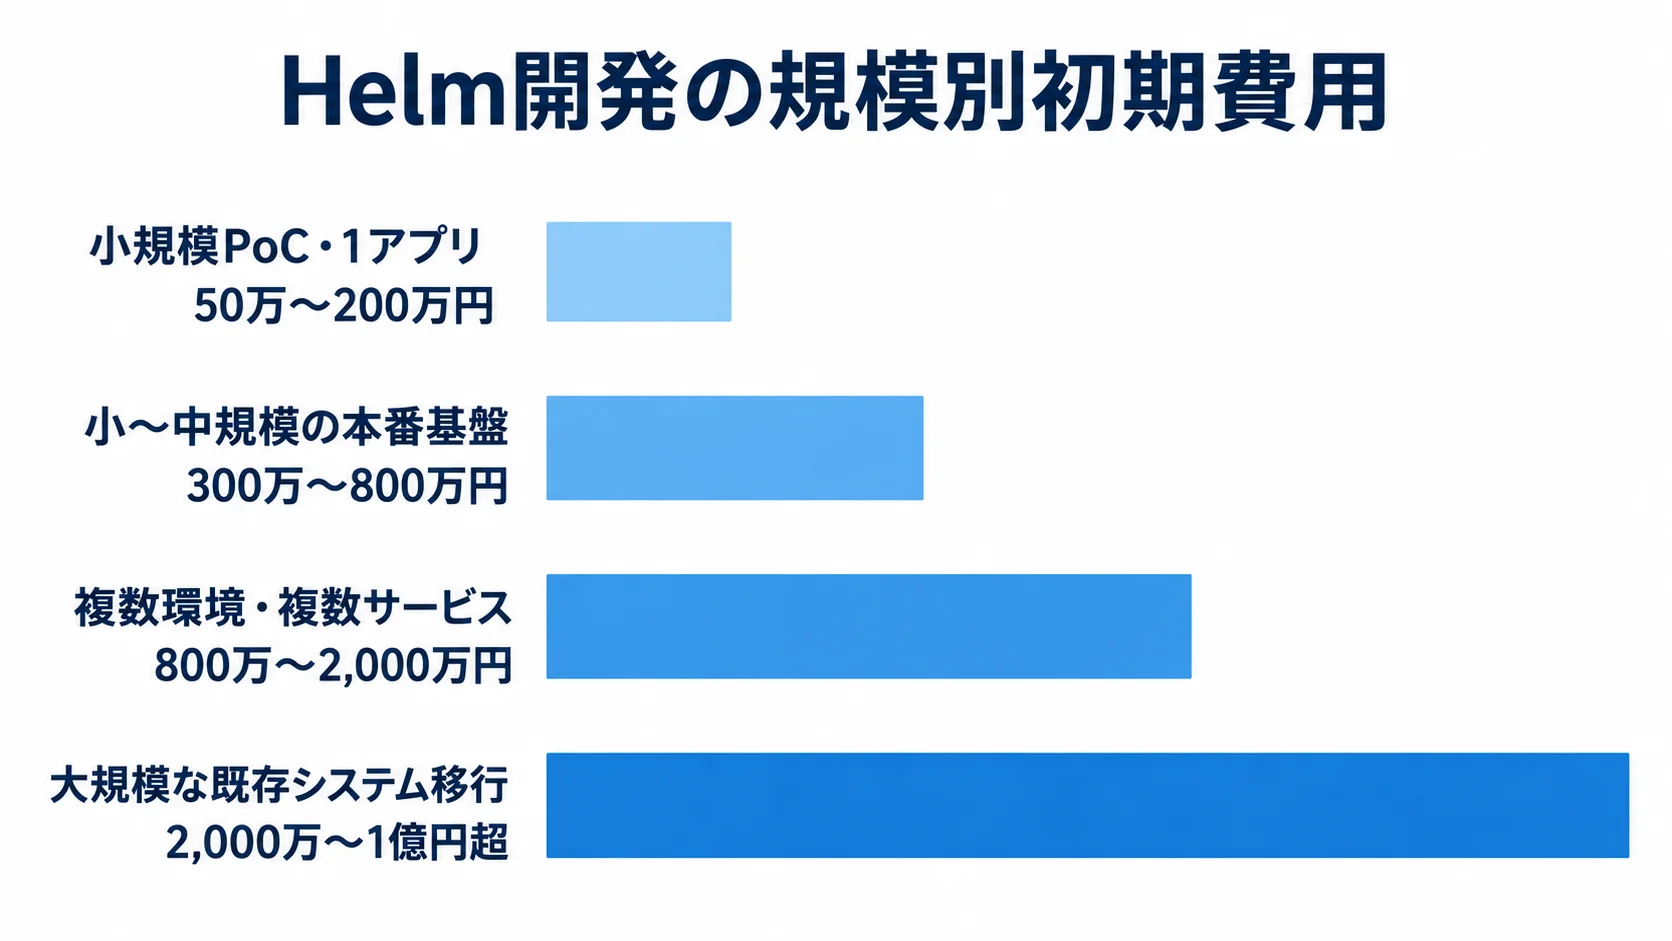
規模別の初期費用の幅(50万円から1億円超)
初期費用と期間は、規模や含める作業範囲によって変わります。
- 小規模PoC・1アプリ:学習用PoCやChart化なら50万〜200万円、1〜2か月。Chart、開発環境、基本CI、簡易テストを含む想定。
- 小〜中規模の本番基盤:EKS・GKE・AKSのいずれかに数個のサービスを載せ、300万〜800万円、2〜4か月程度。
- 複数環境・複数サービス:GitOps、権限、脆弱性対応、移行、教育を含み、800万〜2,000万円、4〜8か月程度。
- 大規模な既存システム移行:コンテナ化、マイクロサービス化、データ移行を含み、2,000万〜1億円超、6〜18か月程度となる可能性。
金額は、ネットワーク、レジストリ、監視の範囲と、バックアップや検証環境、既存コードの改修量によって変わります。可用性や連携数、移行方式によっても、金額は変わります。価格だけでは、提案の優劣は判断できません。
初期費用と分けたクラウド費用と保守費用
クラウド料金と保守範囲を分けて見積もると、継続費用の前提がそろい、比較しやすくなります。
- クラウド費用:管理料、ノード、CPU・メモリ、ストレージ、ロードバランサー、パブリックIPv4。
- 運用基盤費:バックアップ、ログ保持、監視、データ転送。
- 保守範囲:監視のみ、平日日中または24時間365日、脆弱性修正や更新の有無。
AWS公式料金では、EKSは標準サポートで1クラスター毎時0.10米ドル、延長サポートで毎時0.60米ドルです。EC2、EBS、IPアドレスなどは別料金です(出典: AWS「Amazon EKS pricing」、2026年)。
GKEも、管理料は1クラスター毎時0.10米ドルです。請求先アカウントには月74.40米ドル相当の無料枠がありますが、リージョンクラスターや計算資源などに条件があります(出典: Google Cloud「Google Kubernetes Engine pricing」、2026年)。
為替や利用量によって円換算は変わるため、円の固定額とは断定できません。
一般的な業務システムでは、初期開発費の年15〜20%程度を保守費用の目安とする考え方もあります。ただし、実際の費用は対応時間とSLAを前提に、改めて計算します。
Helmを無料と見ないための総保有コスト
総保有コストでは、導入後の人員・運用費と、標準化によって減る工数の両方を見ます。
- 発生する費用:Chart管理、Kubernetes障害、脆弱性対応、監視調整、クラウド利用。
- 削減の可能性:複数環境への再現や手作業デプロイの削減、履歴から戻すことで工数を減らせる場合があります。
- 比較期間:初期費用に加え、3年程度の人件費、クラウド、保守、移行費。
2026年5月には、IIJがEKSの導入検討と初期構築から、運用までを一体で支援するサービスを発表しました。監視、セキュリティ、コスト管理に加え、更新や脆弱性対応も対象に含まれます(出典: IIJプレスリリース、2026年5月28日)。
発注時は、Chart制作だけでなく、継続運用を含むサービス範囲も比較の対象になります。
Helmのシステム開発で見積もりを取る際のポイント
「Kubernetes環境構築一式」のような見積もりでは、会社間の違いを比べられません。そのため、作るもの、移行対象、運用の担当と時間、受け取る成果物を分けて示し、同じ条件で複数社へ依頼します。
見積もりの前提となる要件定義と非機能要件
RFPには、機能と非機能の要件、既存環境、見積もりの条件を記載します。
- 対象と負荷:アプリ・サービス数、ユーザー数、ピーク負荷、環境数。
- 運用条件:クラウド、リージョン、可用性、RTO・RPO、対応時間。
- 情報管理:データ分類、外部連携、認証、監査ログ、バックアップ保持期間。
- 既存環境:ソース、Dockerfile、DB、デプロイ手順、障害履歴、ミドルウェアの版。
- 要件区分:画面・APIは機能、複数AZや暗号化、監視、復元試験は非機能。
情報が不足している項目は、「調査後に再見積もり」と明記しておきます。曖昧なまま固定価格にしないことが、発注側にとって安全です。
非機能要件を「標準対応」とだけ書いてある提案は、対象範囲と測定方法、合格基準を確かめます。
Chart以外の納品物と引き継ぎ範囲の確認
納品物と引き継ぎの合意は、見積もりと契約の両方に含めておきます。
- 開発物:Chart、Chart.yaml、values、依存定義、イメージビルド、CI/CD、GitOps、インフラコード。
- 運用資料:構成図、権限一覧、監視設計、テスト結果、バックアップ・復旧手順。
- 権利と移管:ソースの納品か発注者リポジトリへの移管か、第三者ライセンスの扱いを契約書に記載。
- 保守契約:定例、脆弱性修正期限、基盤更新、問い合わせ応答時間を含めるか確認。
開発会社の担当者しか元に戻せない状態を避けるため、運用を担う担当者が、ステージングでデプロイや設定変更、ログ確認、障害切り分け、復旧を行います。手順書を直してから、本番へ進みます。
複数社の同条件での比較と、技術・運用の実績の確認
同じRFPをもとに、各社の価格、技術実績、運用範囲、セキュリティ対策を比べます。
- 費用内訳:初期構築、アプリ改修、移行、クラウド、保守、教育。
- 運用条件:Chart保守者、Helm 4評価、GitOps範囲、脆弱性修正期限、24時間対応、責任分界。
- 納品範囲:納品後のソースコードと設計書の所有者。
- Chartの安全性:提供元、版、依存、イメージdigest、権限、NetworkPolicy、Secret保管先、SBOM、署名・検証方法。
Kubernetesの実績が公開情報で確認できても、Helm固有の実績や、自社案件への適用の可否は個別に確かめます。
公開Chartは、そのまま導入せず、提供元や依存関係、必要な権限を確かめてから使います。
Helm公式ドキュメントのProvenance and Integrityでは、署名と検証によってパッケージの完全性や出所を確かめる仕組みが説明されています(出典: Helm公式ドキュメント)。
セキュリティを追加オプション扱いにしている提案には、注意が必要です。
Helmのシステム開発でよくある質問(FAQ)
Helmを使った開発では、技術的に可能かどうかに加えて、費用や既存システム、運用体制をどう判断するかも問われます。
Helmのシステムとは何ですか?
厳密にいうと、Helmのシステムとは、Helmを使ってKubernetes上にアプリを配布・更新・管理する構成のことです。ChartというパッケージとRelease履歴によって、環境差分を管理します。
Kubernetesや業務アプリ自体は、Helmとは呼びません。
既存の業務システムをHelmで移行できますか?
移行できる可能性はありますが、既存アプリをコンテナで動かすための改修が必要になります。OSやミドルウェアへの依存、ファイル保存、セッション、バッチを調べ、DB接続、ライセンス、外部連携も確かめます。
全体を一度にマイクロサービス化せず、段階的に移す方法も検討します。
AWSのヌーラボ事例では、既存サービスを段階的にコンテナ化し、ECSからEKSへ約2年かけて移行したと説明されています(出典: AWS導入事例「株式会社ヌーラボ」)。
Helmを使えばシステム開発費は安くなりますか?
Helm自体のライセンス費は原則不要ですが、導入すれば必ず安くなるわけではありません。Chart設計や基盤、CI/CDには費用がかかります。監視やセキュリティ、教育、継続更新も、費用の対象です。
複数環境への展開、頻繁なデプロイ、ロールバックを標準化できれば、手作業や障害対応の工数を抑えられる可能性があります。
3年程度の総保有コストで、Helmを導入しない案と比較してください。
Helm 4へすぐ移行した方がよいですか?
まずは本番移行を急がず、Chart、プラグイン、Kubernetesのバージョン、CI/CD、GitOps、ロールバック手順を検証して、段階的に判断します。
Helm公式は、既存Chartやワークフローとの互換性が期待されると案内しています。ただし、自社の依存関係まで保証されるわけではありません。
検証環境で導入や更新、失敗時の復旧、監査ログを確かめたうえで、移行計画と戻し方を決めます。
開発会社へ相談するとき何を準備すればよいですか?
対象業務、利用者数、既存構成、移行対象を、まず整理します。そのうえで、希望クラウド、環境数、可用性、RTO・RPO、対応時間を書き出します。予算上限と希望時期も伝えます。
公開Chartか自社Chartか、アプリ改修の範囲、運用を内製するか外部に委託するかも、明確にしておきます。
納品対象については、Chart、values、CI/CD、インフラコードを含めるかを伝えます。設計書、テスト結果、復旧手順も含めるかを伝えると、各社の提案を比べやすくなります。
まとめ:運用から逆算するHelmのシステム開発
Helmのシステム開発は、Chart作成を目的にせず、業務と運用の要件から逆算します。RTO、RPO、監査、データ移行、対応時間を整理し、Kubernetesを使わない案も比べます。
設計開発ではアプリとChartの責任範囲を分け、テストと復旧確認を経て段階的に稼働します。
発注前の5つの確認
発注前に確認する5点を、共通のRFPにまとめて3社以上へ相談すると、価格だけでなく提案の前提と品質を比べられます。
- 基盤:Kubernetesが本当に必要か、対象サービスと環境数が明確か。
- 費用:クラウド費用と保守費用が分かれているか。
- 保守:Chartとvaluesの保守者が決まっているか。
- 安全性:脆弱性、権限、Secret、バックアップの基準があるか。
- 復旧:障害時の責任分界と復旧手順が契約に含まれるか。
小さく検証してからの本番展開
最初から全社移行せず、1サービスのPoCでChart、CI/CD、監視、ロールバック、復元を検証します。結果は、本番計画に反映します。
Helm 3から4への移行、クラウドの選択、マネージド運用も、検証環境で確かめてから決めます。技術、費用、体制を一体で評価すると、属人化やベンダーロックインを防げ、業務成果にもつながります。
▼全体ガイドの記事
・Helmのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。