
Helmのシステム開発は、Kubernetesを使うかどうかを先に決め、Chartの設計を整えたうえで、複数の環境へ同じ手順で配布と更新ができる状態をつくる取り組みです。
Helmの基本、向き不向き、進め方、費用、運用で確認することを、発注側の視点でまとめました。詳しくは、下の関連記事をご覧ください。
▼関連記事一覧
・Helmのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Helmのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Helmのシステム開発の見積相場や費用/コスト/値段について
・Helmのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Helmのシステムの概要
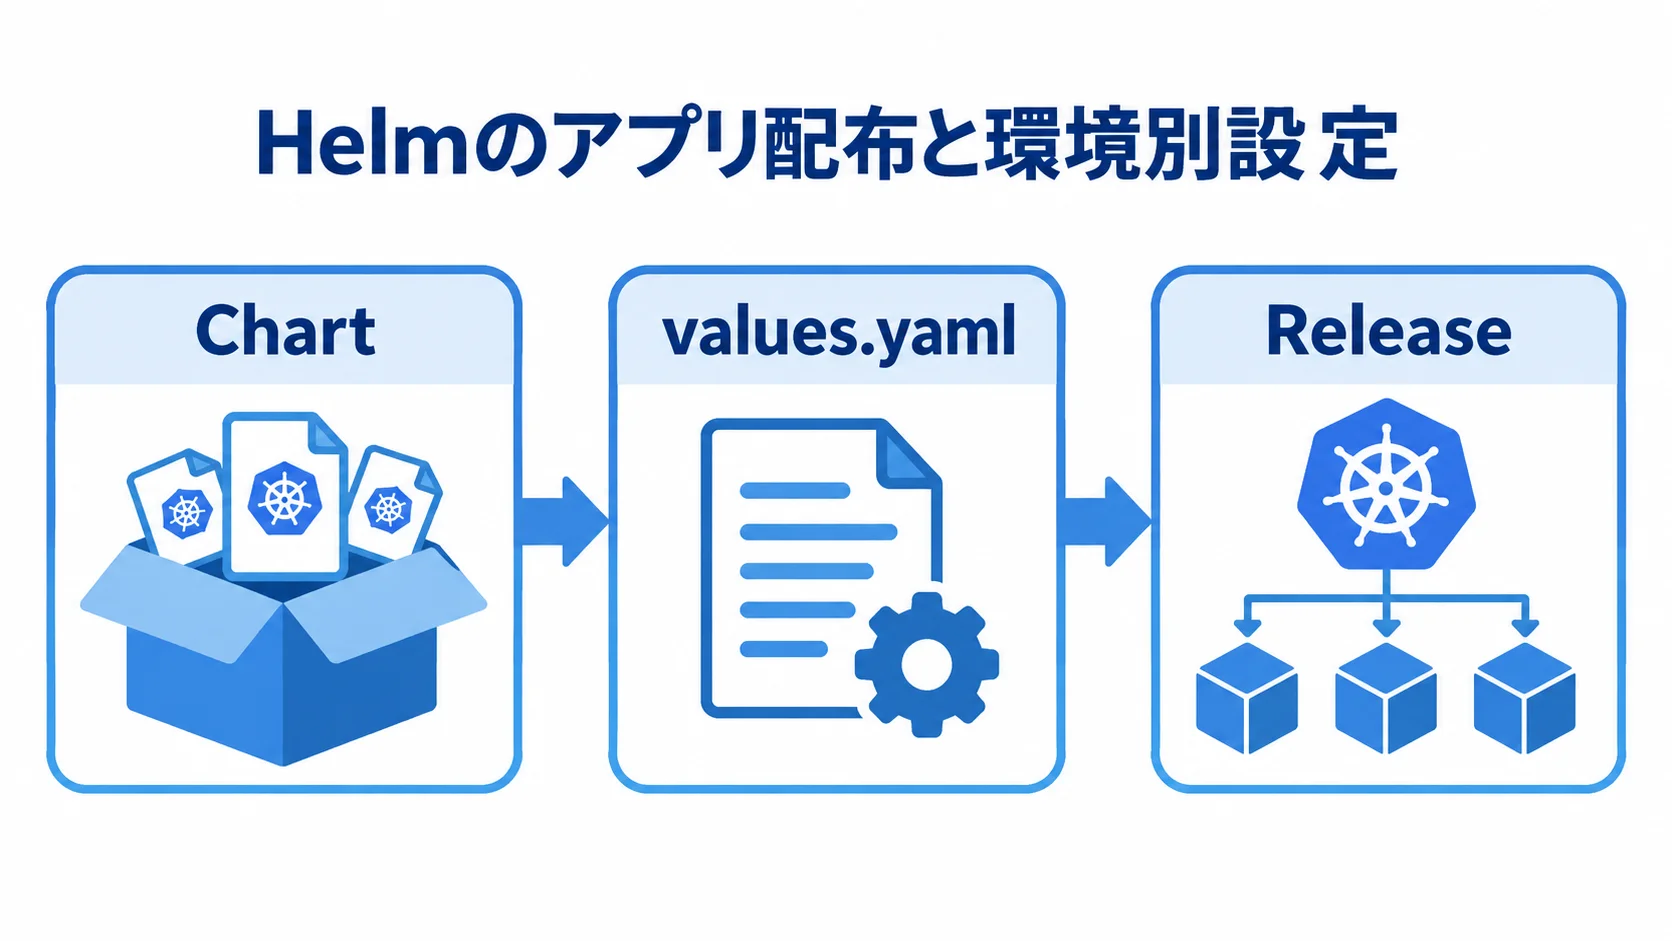
Helmは、コンテナ化したアプリを指定した値でKubernetesへ配置するパッケージマネージャーで、業務アプリやKubernetesクラスターそのものではありません。Kubernetesを「アプリを動かす実行基盤」、Helmを「その基盤へアプリを配る梱包・リリース手段」と考えると、両者の関係を理解できます。
ChartとReleaseの基本単位
Chartは、DeploymentやService、ConfigMap、Ingressなどのマニフェストをテンプレート化した配布単位です。
環境ごとに異なるレプリカ数、イメージタグ、接続先などは、values.yamlで外から渡せます。そのため、開発・検証・本番で同じChartを使いながら、設定だけを環境ごとに分けられます。
Releaseは、Chartを指定した値でクラスターのnamespaceへ入れた実体です。リリース名と履歴が残るため、更新前後の差分確認やロールバックを判断しやすくなります。
Helmで解決しやすい運用課題
環境ごとにYAMLをコピーして手作業で直していくと、修正漏れが生じがちです。Helmを使う主な目的は、こうした手作業を減らすことです。
テンプレート、設定値、Chart版を分けておくと、どの環境へ何を変えたかを追跡できます。また、複数のマイクロサービスを同じ手順で展開する場合や、複数のクラスターへ同じ構成を配る場合にも役立ちます。
Helmのシステムが向いているケース・向かないケース
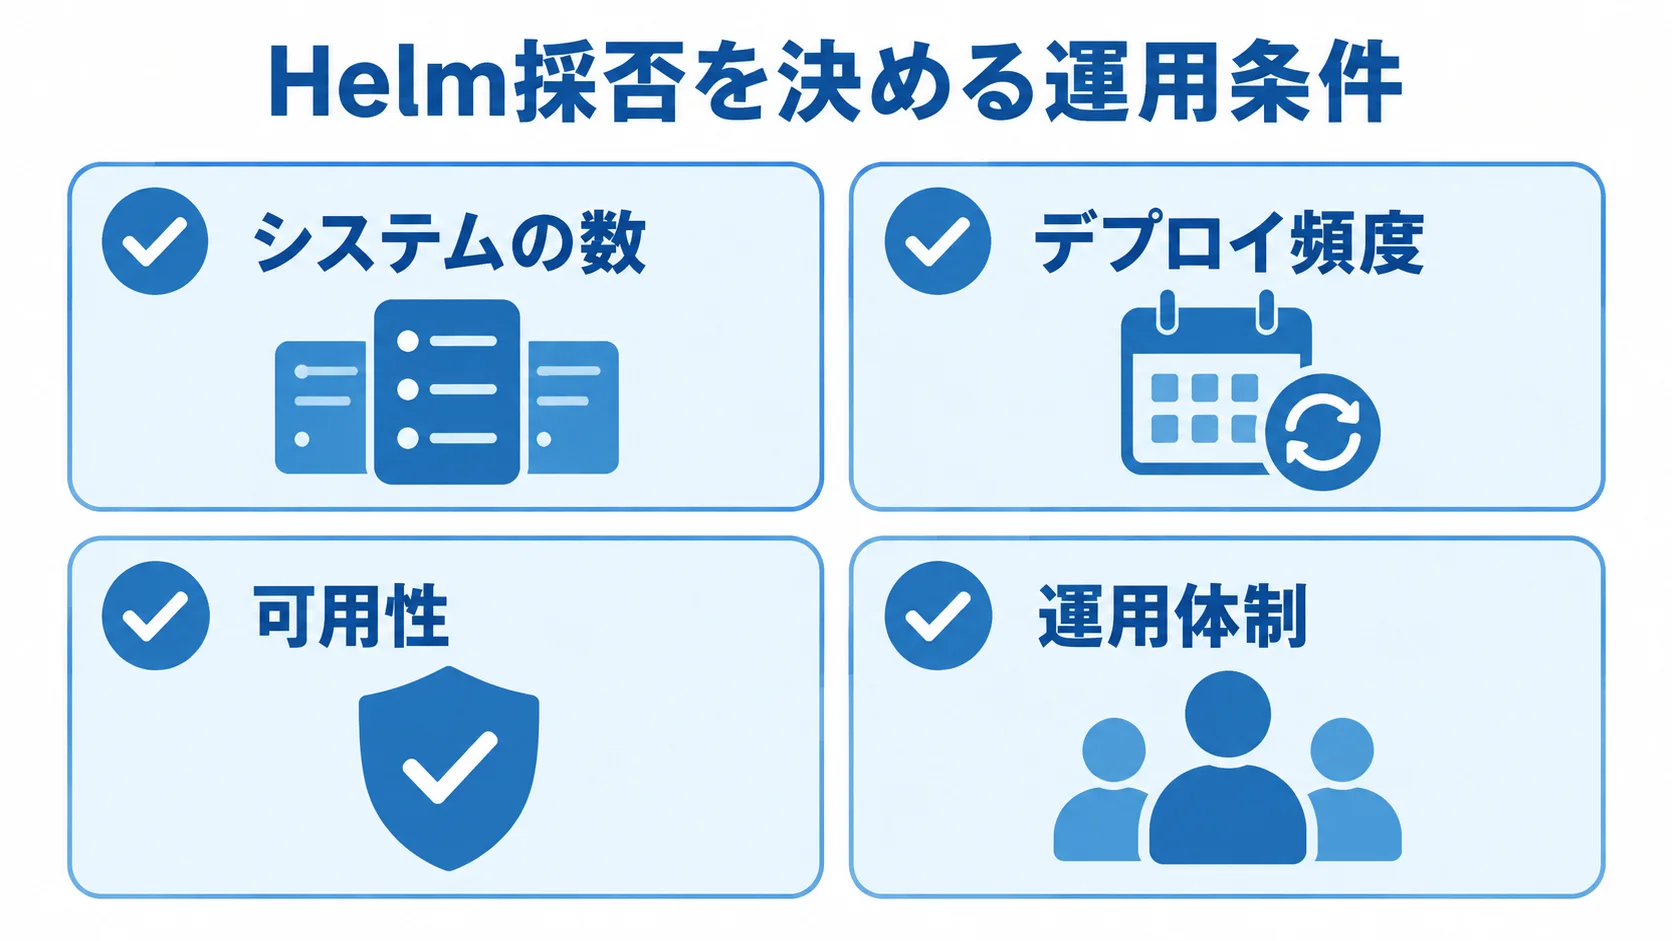
Helmを採るかどうかは、流行に合わせるより、運用条件から判断します。
- システムの数:対象となるサービスが一つか、複数あるか。
- デプロイ頻度:リリースをどのくらいの間隔で行うか。
- 可用性:必要な稼働水準がどの程度か。
- 運用体制:学習、監視、更新を担える人がいるか。
Kubernetesは、学習・監視・更新にもコストがかかります。要件が小さい場合は、別のコンテナ実行サービスやアプリ実行基盤のほうが合理的なこともあります。
複数サービス・複数環境の運用
Helmは、複数のサービスを継続してデプロイする業務システムに向いています。たとえば、フロントエンド、API、バッチ、ワーカー、監視用コンポーネントを、開発、検証、本番の順に展開する場合が該当します。
レプリカ数や外部接続先が環境ごとに異なっても、Chartを共通化したうえで、valuesを切り替えて対応できます。また、障害が起きたときは、直前のReleaseへ戻す運用も整えられます。
単一の小規模アプリでの過剰な導入
対象が小規模なWebアプリ一つだけで、デプロイは月に数回、担当者も少ないといった場合は、KubernetesとHelmの組み合わせが過剰になることがあります。
小規模なアプリでは、マネージドなアプリ実行サービスや、より管理範囲の小さいコンテナサービスを選ぶと、クラスターの更新やノード設計の作業を減らせます。
Helmを使わない選択は、要件に対して運用を増やさないための設計判断にあたります。
Kubernetesの必要性の事前判断
判断では、まずピーク時のアクセスとサービスの増減から、水平スケールの必要性を確かめます。そのうえで、複数環境の分離、停止を許容できる時間、将来のクラウド移行を見ます。
「将来使うかもしれない」という理由だけでKubernetesを先に入れると、設計、教育、監視の費用が初期の段階で先に発生します。
複数チームが同じ実行基盤を使い、頻繁なリリースと標準化が必要な場合は、Helmを含むKubernetes基盤の効果が出やすくなります。
Helmのシステムを構成する要素と設計ポイント
Helmの導入がうまくいくかどうかは、コマンドを実行できるかより、Chartの責任範囲と設定値の境界を設計できるかで決まります。
まず、サービスのライフサイクル、依存関係、権限、環境差分を文書にまとめ、そのうえで構成要素に分けます。
Chartとvaluesの分離と変更範囲の明確化
Chartには、DeploymentやServiceなどの構造を置きます。一方で、valuesには、レプリカ数やリソース要求、イメージdigestといった環境差分を置きます。ホスト名や機能フラグも、ここに含めます。たとえば、開発はレプリカ数1、本番は3としても、Chartを複製せず値だけで分けられます。
Secretの実際の値は、valuesに平文で保存せず、外部の秘密管理サービスや暗号化設定を参照する形にします。
依存関係と責任範囲を絞った設計
Chartの分割と管理ツールの境界を決めるには、次の設計を確かめておきます。
- Chartの分割:DBやメッセージキュー、監視などを一つの巨大Chartにまとめると、変更の影響がどこまで及ぶか見えにくくなります。
- 依存関係:アプリChartと共通基盤Chartを分け、依存Chartの版を固定したうえで、更新時に互換性を試験します。
- 基盤管理:クラウドのネットワークとクラスターは、TerraformまたはOpenTofuなどのインフラコードで扱います。
- 責任分界:Helmでアプリを配布し、管理境界を関係者と合意して、どこまでを誰が受け持つかを明確にします。
納品物をChartだけにしないこと
外注や社内開発では、Chartとvaluesに加えて、CI/CD定義やインフラコードも納品範囲に含めます。設計書とテスト仕様も、同じ範囲に入れておきます。
リリースとロールバックの手順や監視項目も対象です。障害時の連絡先やバージョン更新方針も、納品の対象に含まれます。
作成者にしかテンプレートの意図を説明できない状態が続くと、Helm導入後のロックインにつながります。そのため、契約の前に、ソースコードの権利、レジストリの管理者権限、依存Chartの更新担当を確かめておきます。
Helmのシステム開発の進め方
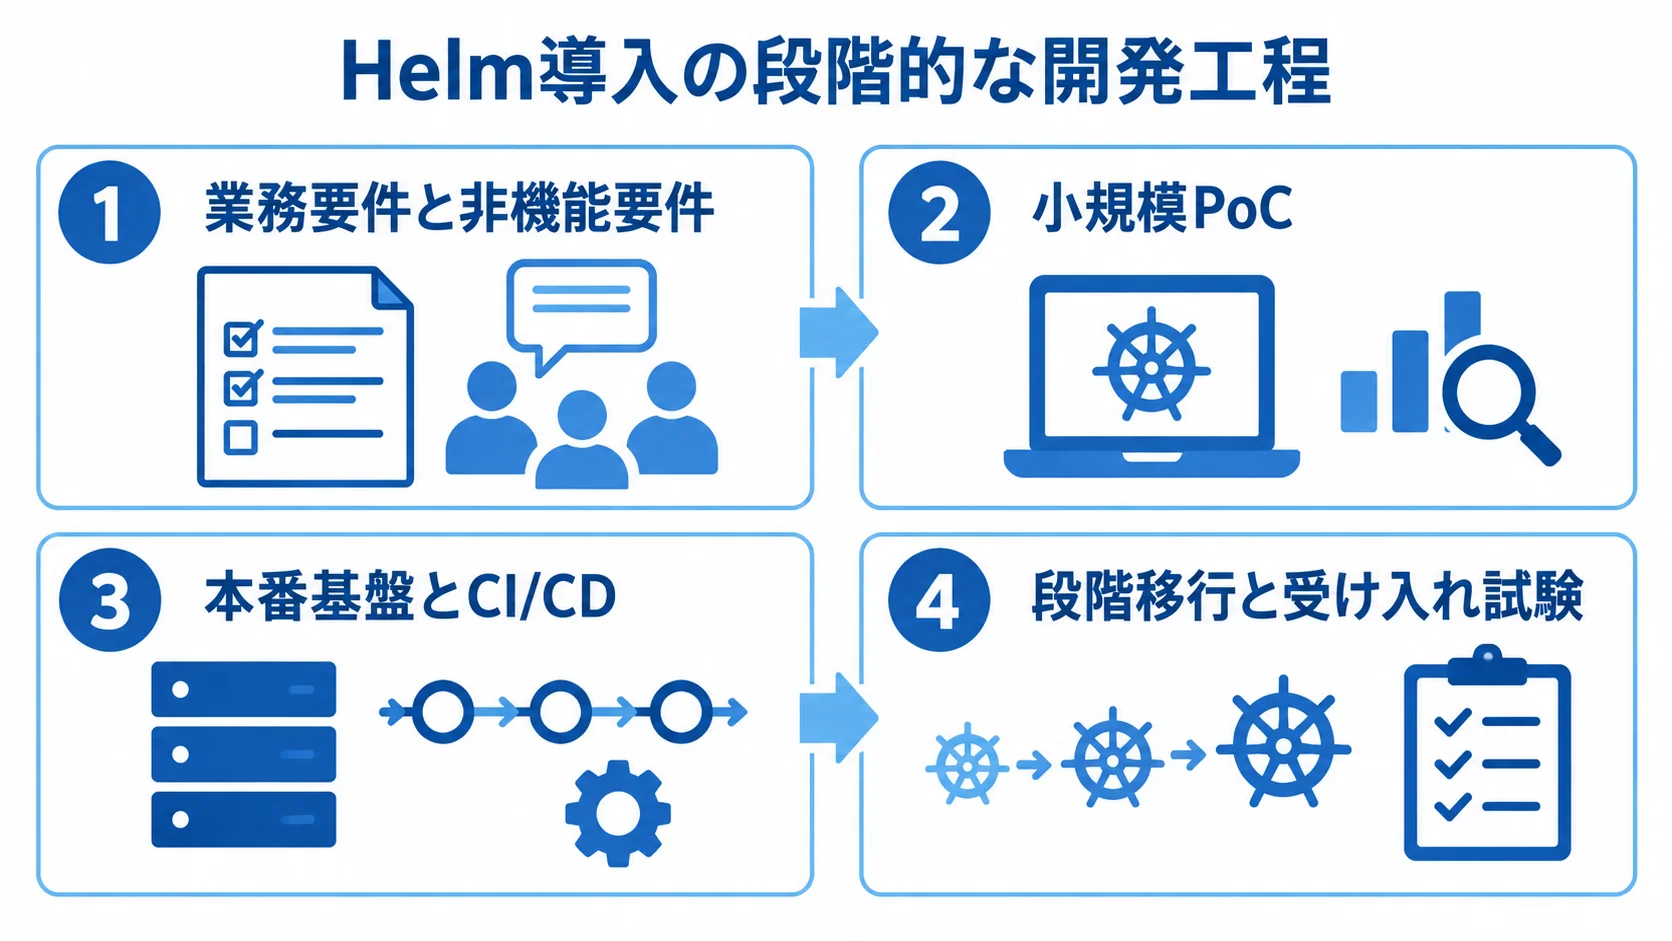
Helmの開発は、まず業務要件と非機能要件を定義するところから始めます。Kubernetesの採否と移行範囲を決め、運用体制と完成条件を定めてから、段階的に進めます。
まず小さなPoCで技術面の不確かさを確かめ、そのうえで本番基盤へ広げると安全です。
▶ 詳細はこちら:Helmのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
1. 業務要件と非機能要件の整理
最初に、利用者と業務フローを整理し、既存アプリやデータベース、外部APIを洗い出します。認証方式、ピークアクセス、許容停止時間も、この段階で揃えておきます。
非機能要件では、RTO(目標復旧時間)とRPO(目標復旧時点)を決めます。ログ保存期間や監査要件のほか、個人情報の保管場所と対応時間帯も、同じ段階で定めます。
ここが曖昧なままだと、後から冗長化やバックアップが追加になります。監視やデータ移行も加わるため、見積もりと納期が大きく変わります。
2. 小規模PoCによるリスク確認
代表的な一つのサービスをコンテナ化してChart化し、イメージをビルドして開発環境へデプロイします。そのうえで、設定値の切り替え、ログ確認、ロールバックまで試します。
既存アプリがファイルシステムや固定ホスト名に依存していないか、外部接続がネットワークポリシーに阻まれていないかを確かめます。起動時間がヘルスチェックに合うかも、この段階で見ておきます。
PoCの完了条件には、「画面が表示される」ことに加えて、再デプロイの再現性と復旧手順の実行も含めます。
3. 本番基盤とCI/CDの整備
PoCで確かめた構成をもとに、マネージドKubernetesのクラスターやネットワーク、コンテナレジストリを設計します。あわせて、権限、監視、バックアップも決めておきます。
CI/CDでは、イメージのビルド、脆弱性スキャン、Chart lintを順に流します。テンプレートのレンダリング確認、テスト、承認を経て、デプロイまでを連続させます。
GitOpsを採用する場合は、リポジトリの変更をデプロイの正とするかどうか、緊急時の手動操作をどう記録するかまで決めます。
4. 段階移行と受け入れ試験
既存業務システムを移行する場合は、影響範囲の小さい機能から段階的に進めます。全機能をいきなりマイクロサービス化する進め方は避けます。
受け入れ条件には、機能テストに加えて、負荷試験と障害注入を含めます。そのうえで、バックアップからの復元と権限確認を確かめ、ログの追跡やデータ整合性、リリース後のロールバックも条件にします。
業務部門が見る画面や帳票と、運用担当が見るメトリクスやアラートを分けて試験項目にすると、稼働後の見落としを減らせます。
Helmとクラウド・他方式の選び方
クラウドは、既存の認証・ネットワーク・運用体制と、必要な可用性・データ保管要件をもとに選びます。Helmは、Kubernetes上のアプリケーションを管理する層で、クラウドとは役割が別です。
マネージドKubernetesでも、ノードやロードバランサー、ストレージの費用は残ります。ログ、転送、セキュリティに関わる費用と運用も残ります。
EKS・GKE・AKSの運用範囲と既存環境による比較
主要なマネージドKubernetesから、既存環境と運用範囲に合うものを選びます。
- EKS
- GKE
- AKS
比較では、クラスター管理の範囲と、ノードやPodの課金方式を見ます。リージョンとネットワーク接続も確かめ、監視、ID連携、アップデートの選択肢も比べます。
既存クラウドの認証・請求・監査基盤を使える場合は、導入後の運用をそろえられます。複数クラウドではアプリ配布をHelmで共通化できる一方、ネットワークと監視の差分は増えます。
Helm・Kustomize・マニフェスト直書きの使い分け
3つの方式は、目的によって役割が分かれます。
- Helm:Chartを版管理し、Release単位で配布・更新します。
- Kustomize:マニフェストに環境差分を重ねて、テンプレートを複雑にしすぎないよう管理します。
- マニフェスト直書き:小規模では分かりやすい一方、環境数やサービス数が増えると重複・修正漏れが起きやすくなります。
方式を混ぜて使う場合は、リソースごとに、どのツールが管理するかを決めておきます。
Helm 4の互換性検証と段階的な採用
Helm 4へ切り替える場合は、リリース情報に加えて、互換性と運用の準備を確かめます。
- 公開日:Helm 4.0.0は2025年11月12日に公開(出典:Helmプロジェクト公式ブログ、2025年)。
- 注目機能:Server-Side Apply、リソース状態の把握、Chartビルドの再現性。
- 互換性:既存のChart、プラグイン、CI/CD、Kubernetesの版は、同じ条件で動くとは限りません。
- 事前検証:代表Chartを検証環境でレンダリングし、導入・更新・削除・ロールバック・監査ログを試します。
- 移行時期:新機能に加えて、保守期間と社内スキルも含めて判断します。
Helmのシステム開発費用相場と期間
Helm本体はオープンソースなので、原則としてライセンス購入費はかかりません。ただし、実際の費用はChartの作成だけでは決まりません。
費用は、既存アプリのコンテナ化やクラスターの構築、CI/CDと監視を含め、項目ごとに分けて見積もります。残りのセキュリティ、データ移行、教育、保守も、同じ考え方で分けて見ます。
次に示すのは、Helmを含む業務システムやコンテナ基盤開発の一般的な概算です。公定価格ではないため、参考の数字として捉えます。
▶ 詳細はこちら:Helmのシステム開発の見積相場や費用/コスト/値段について
規模別の初期費用と開発期間の目安
規模ごとの初期費用と期間を、Chartの試行から大規模移行まで順に並べます。
- 小規模PoC:1アプリのChart化、開発環境、基本CI、簡易テストで50万〜200万円、1〜2か月。
- 本番クラスター1環境:ネットワーク、レジストリ、CI/CD、監視、バックアップ、Chart数個を含み300万〜800万円、2〜4か月。
- 複数サービス基盤:本番・検証分離、GitOps、権限、ログ・メトリクス、脆弱性対応、移行、教育を含み800万〜2,000万円、4〜8か月。
- 大規模な既存システム移行:アプリ改修、データ連携、段階移行、冗長化、性能試験を行い、2,000万円〜1億円超、6〜18か月となる場合があります。
実際の金額は、人月単価と対象範囲によって変わります。
クラウド料金と保守費の考え方
クラウドと保守の費用は、項目を分けて確かめます。
- クラウド利用料:クラスター数・稼働時間のほか、ノード、ストレージ、ロードバランサー、転送、ログ、監視、バックアップで構成されます。
- EKS管理料:標準サポートは1クラスター毎時0.10ドル、延長サポートは毎時0.60ドルです(出典:EKS料金表、2026年8月参照)。
- GKE管理料:1クラスター毎時0.10ドルです。無料枠やモードによる条件があります(出典:GKE料金表、2026年8月参照)。
- 周辺サービス料:EKSとGKEのどちらも、ワーカーや周辺サービスの料金が別に発生します。
- 保守費:対応範囲と契約条件を含めて見積もります。
保守費は、障害対応の時間帯や、KubernetesとHelmの更新の範囲で変わります。脆弱性修正とバックアップ復元試験の扱いも、保守費に関わります。月次レポートや問い合わせ窓口の有無も、金額に影響します。
一般的な業務システムでは、初期開発費の年15〜20%程度を保守費とみなす考え方もあります。一方で、24時間365日対応や高いSLOの場合は、別途見積もりが必要です。
初期費用と月額の両方を、環境数と運用時間ごとに示してもらいます。
見積書の作業項目の分解
見積書では、要件定義と現状調査を分けます。さらに、アプリ改修、コンテナイメージ作成、クラスター構築も、項目ごとに分けます。
Chart設計やCI/CD、監視も、項目別に分けます。セキュリティとテスト、データ移行も、個別の項目にします。教育、リリース支援、保守についても、別々の項目として記載します。
「環境構築一式」や「運用一式」と書かれていると、何が含まれるのか比べにくくなります。開発、ステージング、本番の環境数とサービス数は、数量で書いてもらいます。データ移行の回数や夜間対応、納品物も、数で示してもらいます。
Helmのセキュリティ・運用・障害復旧の確認事項
Helmはデプロイを標準化しますが、脆弱性や過剰な権限を自動で解決する仕組みではありません。そのため、Chartとコンテナイメージを点検し、Kubernetesの設定とクラウドIAMも確かめます。
ネットワークやログ、秘密情報も確かめ、更新の担当と時期を運用ルールに定めます。
Chartとイメージの完全性の確認
公開Chartや依存Chartを使う場合は、提供元とバージョン、変更履歴を確かめます。加えて、脆弱性、必要な権限、外部通信先も見ておきます。
対策としては、Chartの署名と検証、OCIレジストリのアクセス制御を組み合わせます。さらに、イメージのdigest固定、SBOMの保管、CIでの脆弱性スキャンも加えます。
latestのように更新で内容が変わるタグを本番で使うと、同じChartでも実行されるイメージが変わるため、再現性が損なわれます。
権限・Secret・監査ログの最小構成
サービスアカウントとRBACは、namespaceや操作対象ごとに、必要最小限の権限にします。
Secretの値は、Chartリポジトリに平文で置きません。外部管理や暗号化、短い有効期限、ローテーションを組み合わせて守ります。
Releaseの変更者、デプロイ値、承認の有無を追跡できるようにします。そのためには、CI/CDとGitの監査ログに加えて、Kubernetes APIとクラウド側の監査ログも一定期間保存します。
ロールバックだけでは戻せない障害への備え
Helmのロールバックは、Releaseのマニフェストや設定を以前の状態へ戻す手段です。
しかし、データベースのスキーマ変更や外部サービスへの副作用が残る場合は、ロールバックだけでは復旧できません。削除された永続ボリュームや、互換性のないメッセージも、ロールバックでは元に戻りません。
アプリとDBの変更を後方互換にしたうえで、バックアップからの復元やデータ補正の手順を事前に試験します。緊急時に手動で切り戻す手順も、併せて試しておきます。
更新計画と責任分界の契約への明記
導入後は、KubernetesやHelmのほか、Chartと依存イメージも更新が必要になります。
更新の頻度と検証環境への反映を決めておきます。脆弱性が見つかった場合の初動、緊急パッチの承認者、サービス停止を伴う作業の時間帯も、あらかじめ定めます。
開発担当、インフラ担当、クラウドの契約者、業務部門のあいだで、どこまでを誰が受け持つかが曖昧だと、障害時に調査が止まります。そこで、月次の更新会議や運用レポートを契約に含めておくと有効です。
Helmの開発会社・ベンダーの選び方
Helmの案件では、Helmの操作に加えて、Kubernetesやクラウドネットワーク、アプリ改修を扱える体制かどうかを見ます。あわせて、CI/CD、セキュリティ、運用設計にも対応できるかを確かめます。
公開実績に「Helm」とあるかは、判断材料の一つにすぎません。Chartの設計と保守、障害時の対応範囲を、具体的に確かめます。
Kubernetesと運用の実績の確認
実績を聞くときは、クラスターを作った経験に加えて、似たサービス数や環境数、アクセス規模を確かめます。データ移行の有無や可用性要件、監視時間、障害対応の範囲も聞きます。
可能であれば、匿名化した設計書や運用手順のサンプル、検証から本番へ進める判定基準を見せてもらいます。納品後に、Helm Chartを自社で変更できるかどうかも、技術力と引き継ぎの品質を見極める材料になります。
同じRFPによる複数社の比較
比較の前に、環境数、対象サービス数、ピークアクセス、SLOを同じRFPに記載して、前提をそろえます。移行対象や保守時間、納品物、予算上限も、あわせて記載します。
提案は、初期費用に加えて、3年程度の総額で比べます。総額には、クラウド料金と月次保守、追加変更、夜間対応、更新を含めます。3社以上へ同じ前提で依頼すると、作業範囲や過剰な構成が見えてきます。
提案時に確認する質問
提案の場では、設計と運用の責任範囲を、質問を通して確かめます。
- 責任範囲:Chartとvaluesは誰が担当しますか。
- Helm 4対応:対応方針と検証方法は何ですか。
- GitOps:正となるリポジトリはどれですか。
- 脆弱性対応:依存Chartとイメージを誰がいつ修正しますか。
- 障害復旧:ロールバックで戻らない障害には誰が対応しますか。
納品範囲も、提案の段階で確かめます。ソースコードや設計書、テスト結果などをどこまで納めるかに加えて、契約終了後の引き継ぎ条件も含めます。
▶ 詳細はこちら:Helmのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Helmのシステム開発の発注/外注/依頼/委託方法について
Helmのシステム開発でよくある質問
Helmの導入を迷う段階では、技術用語より、費用や既存システムとの相性、運用の責任範囲が気になるものです。発注の前によく寄せられる質問に、順に答えます。
Helmは無料なのでシステム開発費も無料ですか?
いいえ、Helm本体のライセンス費が原則不要でも、システム開発費は発生します。Chart設計やコンテナ化、クラスター、CI/CDの費用に加えて、監視、セキュリティ、移行、教育、保守の費用が必要です。
クラウド料金も別に発生します。そのため、無料なのはソフトウェアの一部で、運用全体が無料になるわけではありません。
既存の業務システムをHelmで運用できますか?
可能ですが、既存アプリをそのまま移せるとは限りません。固定ホスト名やローカルファイル、セッション、バッチの実行時間を、事前に調べます。
DB接続や外部API、ライセンス、データ移行の条件も確認します。その結果、コンテナで動くよう改修が必要になる場合もあります。
まず影響の小さい機能でPoCを行い、移行対象と対象外を分けてから本番計画を作るのが安全です。
自社運用とマネージドKubernetesはどちらがよいですか?
クラスターの更新、可用性、障害対応を担える人員が十分でなければ、マネージドKubernetesを第一候補にします。
一方で、自社運用を検討するのは、閉域・データ主権・特殊なハードウェアなどの明確な理由があり、クラスターの更新と復旧を担う体制を確保できる場合です。
どちらを選んでも、アプリのChart、監視、権限、バックアップの責任は残ります。
Helm 4へすぐに移行した方がよいですか?
すぐに全環境を移行する必要はありません。まずは、利用中のChartや依存Chart、プラグイン、Kubernetesのバージョンを検証環境で確かめます。
CI/CDとGitOpsも検証します。問題がなければ、対象を絞って段階的に移行します。
移行時期は、サポート期限や脆弱性、社内の運用スキルを比べて決めます。更新による改善効果も、判断材料に含めます。
開発会社には何を渡して相談すればよいですか?
開発会社へは、業務フローと現行構成図、対象アプリとDBを、まず資料にして渡します。あわせて、利用者数やピークアクセス、停止許容時間、RTO・RPOを示します。データ分類、既存クラウド、移行希望時期、予算感も、同じ資料にまとめます。
さらに、環境数、サービス数、保守時間、必要な納品物、社内で引き継ぎたい範囲を明記します。情報が揃っていなくても、未確定の項目を一覧にして渡せば、調査と要件定義を分けた見積もりで提案してもらえます。
まとめ
Helmのシステムは、Kubernetes上のアプリケーションをChartとして標準化し、環境ごとの差分を管理しながら、安全にリリースする仕組みです。
複数のサービスや環境を頻繁にデプロイし、再現性のある運用が必要な業務システムでは、有力な選択肢になります。一方で、単一の小規模アプリでは、より管理範囲の小さい実行基盤のほうが合う場合があります。
意思決定で押さえる3つの要点
意思決定で押さえる要点を、順に並べます。
- Helmより先に、Kubernetesの必要性を要件から判断します。
- 費用をChart、アプリ改修、クラスター、クラウド、監視、移行、保守に分解します。
- Chartやvaluesだけでなく、CI/CD、設計書、テスト、復旧手順、更新方針も納品・運用の条件にします。
次に行うこと
Helm導入の判断は、次の順で具体的に進めます。
- 現行システムの構成、停止許容時間、データ移行、運用体制を整理し、代表サービスのPoCでコンテナ化とChart化を検証します。
- 同じRFPを複数候補へ渡し、初期費用、クラウド費用、保守費用、納品物、障害対応を同じ条件で比較します。
- Helmを入れるかどうかより、業務を止めずに更新し続けられる仕組みを作れるかで、最終判断します。
▼関連記事一覧
・Helmのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Helmのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Helmのシステム開発の見積相場や費用/コスト/値段について
・Helmのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。