
ICTシステムの導入で「思ったほど効果が出なかった」という声は後を絶ちません。原因の多くは技術ではなく、事前に防げたはずの落とし穴です。
本記事は、ICTシステム開発・導入の失敗・課題・注意点・リスクを「失敗特化」で深掘りします。進め方や費用感をまだ把握していない方は、まずICTシステムの完全ガイドで基礎を押さえてから読むと、対策を立てやすくなります。
▼全体ガイドの記事
・ICTシステムの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
データ移行と見積もりの甘さによる失敗
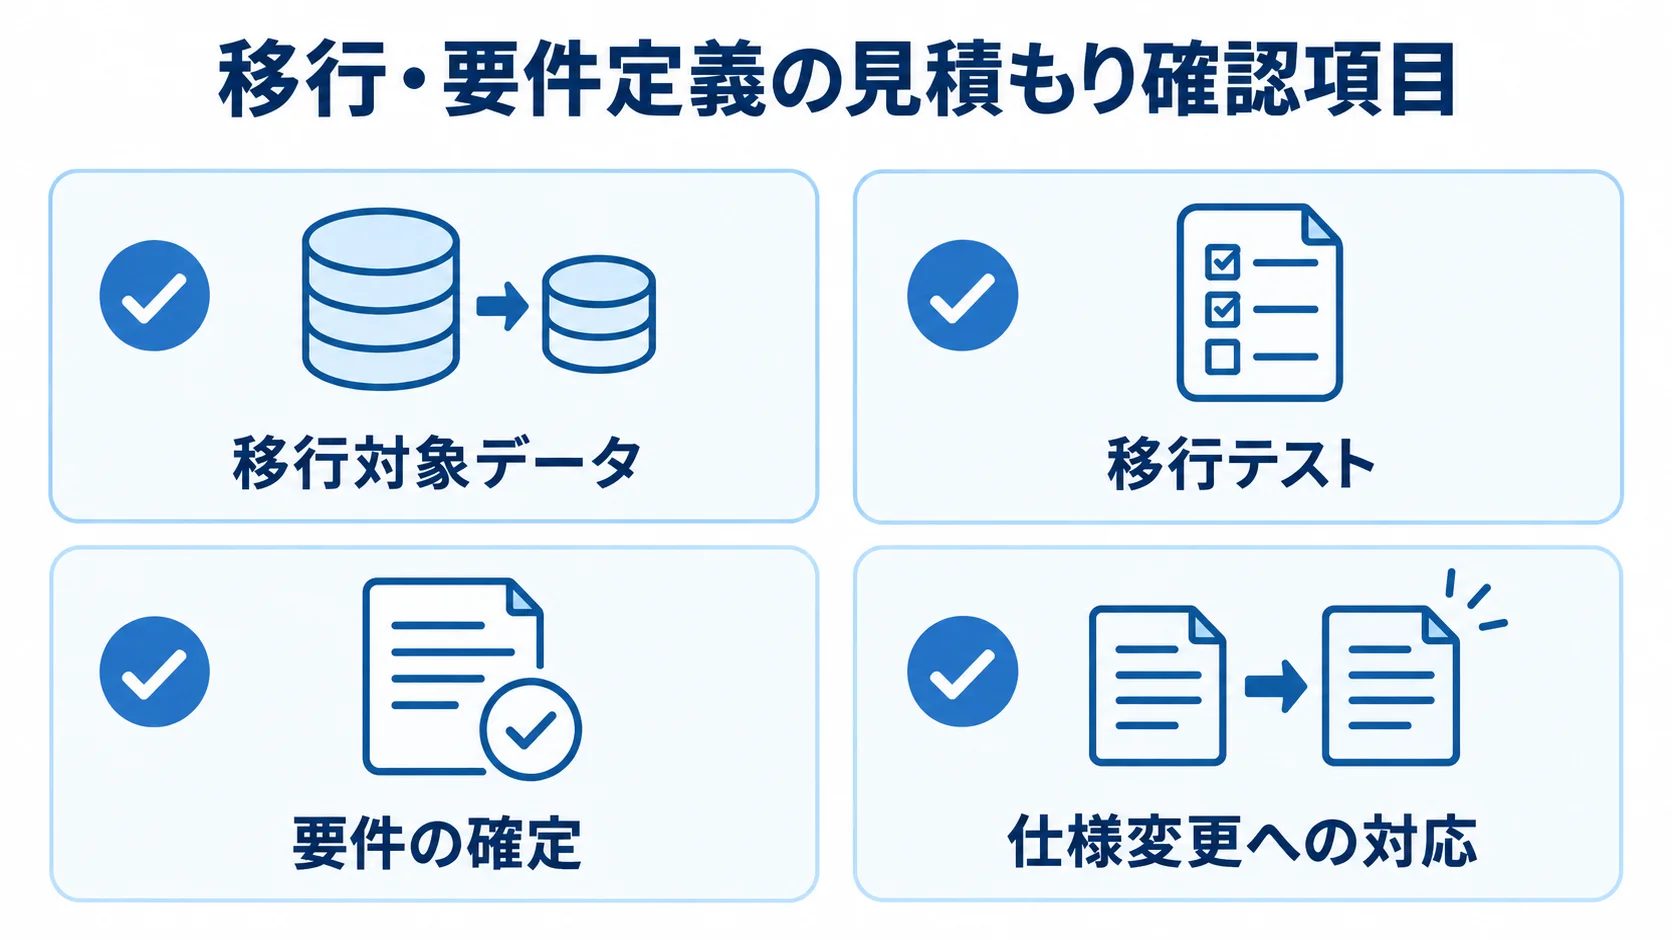
ICTシステム導入の失敗で最も多いのは、見積もりの甘さに起因するものです。とくにデータ移行は見落とされやすく、後から費用が膨らみやすい領域です。たとえば「とりあえず移せばいい」と軽く見積もった結果、想定の何倍もの工数と費用がかかり、プロジェクト全体が予算超過に陥るケースが頻発します。
データ移行の見積もりを甘く見た失敗
従業員50〜100名規模のオンプレミスからクラウドへの移行では、設計・構築に100万〜400万円がかかり、それに加えてデータ移行だけで20万〜80万円がかかるのが相場です(出典:ripla)。
ところが、この移行コストを軽視して全体予算を組むと、移行の段階で「データの形式変換が必要」「不整合データのクレンジングに時間がかかる」といった想定外が噴出し、費用も納期も超過します。
データ移行は、量だけでなく質(既存データの汚れ具合や形式のばらつき)が工数を左右するため、事前の調査が欠かせません。また、ICT開発は費用の約80%が人件費であるため(出典:ripla)、移行作業の工数を甘く見ると、そのまま予算超過に直結します。
移行は「最後のおまけ」ではなく、プロジェクト初期から計画すべき重要工程です。回避策は、移行対象データを洗い出し、要件定義の段階で移行の難易度を見極めたうえで、見積もりに反映することです。
- 移行対象データ:どのデータを、どの形式で、どこまで移すかを明確にしておきます。
- 移行テスト:本番の前に移行を試し、リスクを潰しておくことが欠かせません。
要件の詰め不足が招く仕様変更コスト
見積もりの甘さは、要件定義の詰め不足からも生まれます。要件が曖昧なまま開発に入ると、進行中に「これも必要だった」という追加要望が次々と出て、仕様変更のたびに費用と納期が膨らみます。
とくに非機能要件(可用性・性能・セキュリティ)の詰めが甘いと、後から構成を作り直すことになり、影響範囲が大きくなります。要件定義の精度こそ、仕様変更コストを抑えるうえで最も効く要素です。
失敗を避けるには、要件定義に時間とコストをかけることを惜しまない姿勢が欠かせません。PM費用は、開発費の10〜20%(300万円案件で30万〜60万円)が目安です(出典:ripla)。
また、要件定義の費用を削って進行管理まで手薄にすると、かえって仕様変更の混乱で総額が膨らみます。要件定義を急いで開発に入ることは、ICTシステムでもっとも高くつく失敗パターンの一つだと押さえておくべきです。
- 要件の確定:機能と非機能の範囲を、発注側と開発会社で揃えておきます。
- 仕様変更への対応:変更が出るたびに、費用と納期への影響を確かめます。
もう一つの見積もりの落とし穴が、安い見積もりに飛びつく失敗です。極端に安い提案には、PM費用が計上されていなかったり、移行や連携といった重い工程がスコープから抜けていたりするケースがあります。
ICT開発はシニア・アーキテクトの単価が月100万円超になることもあり(出典:ripla)、安さには必ず理由があります。さらに、RFPで前提・スコープ・非機能要件を揃えないまま見積もりを比較すると、後から「これは別料金です」と追加され、結局高くつきます。
見積もりは金額だけでなく内訳の妥当性まで読むことが、失敗回避の基本です。
過剰スペックと隠れコストの落とし穴
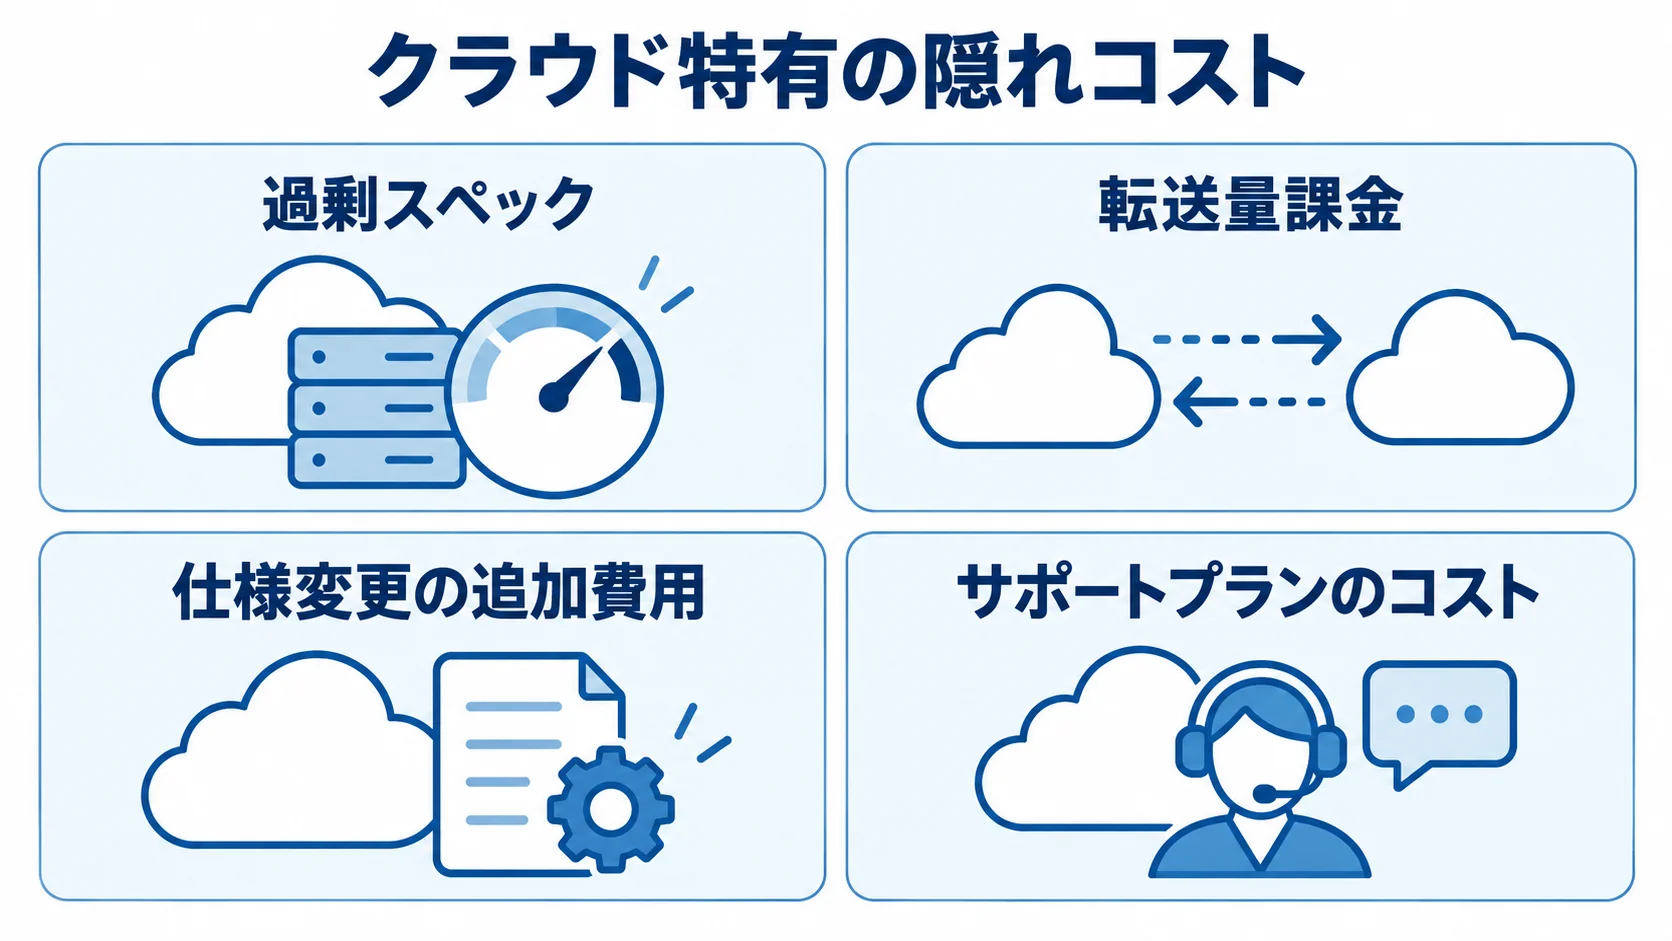
見積もりの甘さとは逆に、「念のため」で過剰なスペックを組んでしまう失敗もよくあります。さらに、クラウド特有の隠れコスト(転送量課金や仕様変更費)を見落とすと、運用フェーズで想定外の出費が続きます。そのため、コストは構築時だけでなく、運用しながら継続的に発生することを忘れてはいけません。
「念のため」の過剰スペックで膨らむ固定費
性能要件を曖昧にしたまま「念のため大きめに」とインスタンスを選ぶと、使われない処理能力に毎月お金を払い続けることになります。
仮想サーバーは構成によって料金が変わり、Linux 2コア約8GBでも月60〜80ドル前後です(出典:ripla)。これを必要以上に大きくすれば、無駄な固定費が積み上がります。インフラ月額は中規模で3万〜10万円が目安ですが、過剰スペックだとこの額が膨らみ、効果が出ないまま運用コストだけが重くのしかかります。
回避策は、想定負荷に見合ったスペックから始め、稼働状況を監視しながら見直していく運用です。クラウドの利点は、後からスペックを柔軟に変えられる点にあります。
最初から最大を見込むのではなく、小さく始めて足りなければ増やすやり方が、過剰スペックを防ぐうえで効きます。サーバーレスを使えば、アイドルコストをゼロに近づけられるため、過剰スペックのリスクそのものを減らせます。「使いながら下げる」運用設計こそ、過剰スペックの失敗を防ぐ要点です。
- 想定負荷の見極め:「念のため」で大きめに見込まず、負荷の想定を具体的にしておきます。
- 稼働状況の監視:稼働を見ながらスペックを増減できる運用を組みます。
転送量・仕様変更という隠れコスト
クラウドで見落とされやすいのが、データ転送量の課金です。アクセスやデータのやり取りが急増すると、想定していなかった課金が発生し、月額が跳ね上がることがあります。
構築費だけを見て発注し、運用フェーズで転送量や仕様変更の追加費用に苦しむのは典型的な失敗です。保守運用は、年間で開発費の10〜20%が継続的にかかる前提で(出典:ripla)、ランニングコスト全体を見積もっておく必要があります。
隠れコストを防ぐには、要件定義の段階で運用後のコスト上限を設定し、転送量を含めたランニング費用をシミュレーションすることです。さらに、サポートプランのコストも含めて総額で把握しておくと、後の想定外を防げます。AWS・Azureのビジネス向けは月額最低100ドルからで、エンタープライズでは月15,000ドル以上のケースもあります(出典:ripla)。
ICTシステムのコストは、初期費用だけでなく運用にかかる費用まで含めて判断することが、失敗を避けるうえで欠かせません。
- アクセス増加時の費用:想定を超えるアクセスがあった場合の費用を、事前に試算します。
- サポートプランの料金:契約の前に総額に含め、後から想定外にならないようにします。
コスト管理の失敗を防ぐには、利用状況を見える形にし、予算アラートを使うことが有効です。クラウドは便利な反面、各部門が自由にリソースを立ち上げると、誰も全体のコストを把握できなくなり、気づいたら月額が膨らんでいたという事態が起こります。
監視ツール(Datadogはホストあたり月15〜23ドル)で稼働状況を把握できるようにし、予算のしきい値を超えたら通知する仕組みを入れておけば、コストの異常を早期に検知できます(出典:ripla)。さらに、CCoEのような専門チームがコストを全社で管理すれば、無駄なリソースの放置を防げます。隠れコストは、統制の仕組みで先回りして抑えるのが定石です。
ベンダーロックインとPoC不在の本番化リスク
ICTシステムの失敗には、構築時には表に出ず、後から効いてくるタイプもあります。代表的なのは、特定のクラウドへの過度な依存(ベンダーロックイン)と、検証を飛ばして本番化したことによる手戻りです。どちらも、目先の便利さや速さを優先した結果、将来の自由度や安定性を失う失敗です。
独自サービス使いすぎによるロックイン
クラウド各社の独自マネージドサービスは便利ですが、使いすぎると他社クラウドへの移行が事実上不可能になり、ベンダーロックインに陥ります。後から「料金が上がった」「もっと適したクラウドがある」と思っても、独自サービスに依存した構成は簡単には移せません。値上げや仕様変更に対する交渉力を失い、言い値で使い続けざるを得なくなる点に、ロックインの怖さがあります。
回避策は、ロックインのリスクを構築前に評価し、許容範囲を決めておくことです。差別化に効かない汎用部分はコンテナで可搬性を保ち、標準的な技術で組めば、将来の移行余地を残せます。
すべての独自サービスを避ける必要はありません。便利さとロックインのリスクを比べながら、どこまで依存するかを意図的に選ぶことが大切です。ロックインは、起きてから対処するのではなく、設計の段階で先回りして手当てすべきリスクです。
- 独自サービスの範囲:使う範囲を構築前に絞り、移行の難しさを見積もります。
- 依存の見直し:構築後も、依存の度合いが広がっていないかを定期的に確かめます。
ロックインのリスクが現実の問題になりやすいのが、料金改定や為替変動の局面です。クラウドの料金はドル建てで設定されることが多く、円安が進めば実質的な負担が増えます。さらに、独自サービスに深く依存していると、他社への乗り換えで対抗する手段を持てず、値上げをそのまま受け入れざるを得ません。
複数クラウドの料金(仮想サーバーで月62〜80ドルといった水準)を比べられる状態を保つと、値上げを見極めやすくなります(出典:ripla)。また、必要なら移行できる構成にしておけば、交渉力を保ち、コスト上昇のリスクに備えられます。
PoC不在で本番化して手戻りする失敗
新しい技術や大規模な構成を、検証なしでいきなり本番に投入するのも危険な失敗パターンです。PoC(実証実験)を飛ばして本番化すると、「想定した性能が出ない」「既存システムと連携できない」といった問題が本番で発覚し、大きな手戻りが発生します。本番でのトラブルは、検証段階での失敗と比べて、はるかに大きなコストと信用の損失を伴います。
回避策は、本番化の可否を左右する論点に絞ってPoCを行い、合格基準を事前に定めることです。性能が出るか、連携できるか、コストが収まるかを、CPU使用率やネットワークI/Oといった具体的な指標で検証します。
PoCにかかるコストは、本番での手戻りに比べれば小さく、リスクを見極めるための投資として極めて有効です。「なんとなく動いたから本番化」という曖昧な判断が、ICTシステムの大きな失敗を招きます。
- 合格基準:性能、連携、コストそれぞれについて、合格の目安を事前に決めておきます。
- 本番化の条件:基準を満たして初めて、本番に進みます。
サーバーレス不適合領域を見誤る失敗
ベンダーロックインやPoC不在の本番化と並んで、近年は「とりあえずサーバーレスにすれば安くなる」という思い込みからの失敗も増えています。サーバーレスは、アクセスがまばらで処理が短いワークロードでは抜群に効きますが、常時高負荷で稼働し続けるシステムや、長時間の連続バッチ処理には不向きです。
常に一定の負荷がかかる処理をサーバーレスに載せると、かえって料金がかさんだり、実行時間の上限に引っかかって処理が途中で止まったりします。技術の流行に乗ること自体が目的になると、自社のワークロードに合わない構成を選ぶ失敗に陥ります。
回避策は、ワークロードの特性ごとに構成を使い分けることです。アクセスの増減が大きいフロント部分はサーバーレス、常時稼働のコア部分はコンテナや仮想サーバーというハイブリッド構成にすれば、それぞれの強みを引き出せます。
常時一定の負荷があるなら、リザーブドインスタンスで常時起動のサーバーを割安に確保したほうが、トータルコストは下がります。「どの処理をどの構成に載せるか」を見極めずに一律で寄せることが、サーバーレスをめぐる典型的な失敗といえます。
- ワークロードの特性:アクセスの増減や処理時間の長さを見て、構成を選び分けます。
- 料金の比較:常時一定の負荷がある処理は、サーバーレスと常時起動の料金を比べて選びます。
セキュリティ・コンプラ違反と運用設計の欠落
ICTシステムの失敗のなかでも、もっとも影響が大きいのが、セキュリティ・コンプライアンス違反と運用設計の欠落です。前者は事故時の損害が甚大で、後者は「作ったのに使い続けられない」という形で投資を無駄にします。どちらも、構築だけに目が向き、運用まで設計できていないことが根本原因です。
責任共有の誤解とコンプラ要件の見落とし
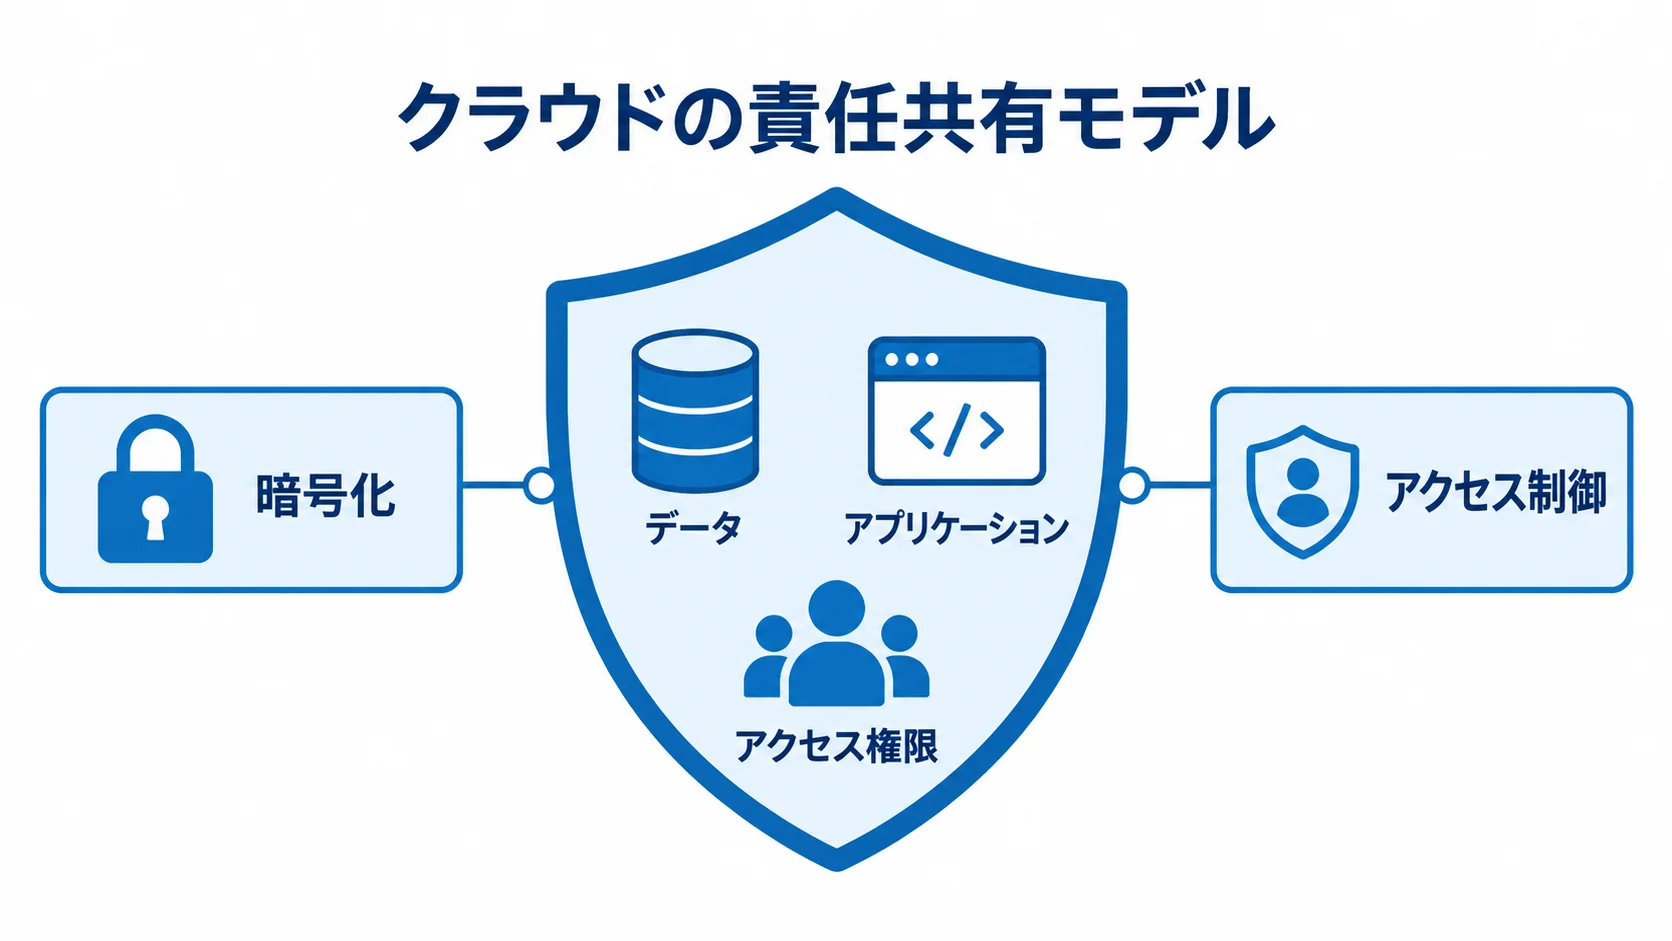
「クラウドにすればセキュリティは事業者が守ってくれる」という誤解は、重大な失敗を招きます。クラウドの責任共有モデルでは、データ、アプリケーション、アクセス権限の保護は利用者の責任で、この部分を放置すると情報漏えいにつながります。
さらに、金融のFISC安全対策基準や、医療の3省2ガイドラインといった業界ごとのコンプライアンス要件もあります。また、製造業の業界要件などの業界別コンプラを見落としたまま構築すると、基準を満たさず作り直しになったり、規制違反のリスクを抱えたりします。
回避策は、責任共有モデルを正しく理解し、自社が守るべき範囲のセキュリティ対策(暗号化・アクセス制御・ゼロトラスト)を要件として明示することです。業界コンプラについては、自社の監査部門と連携し、満たすべき基準の条項まで具体化して要件定義に落とし込みます。
セキュリティとコンプラは、構築後に付け足すのではなく、要件定義の段階から組み込むべき最優先事項です。
- 責任の範囲:自社が守る部分と、事業者に任せる部分を切り分けて確かめます。
- 業界の基準:守るべき条項を、要件として具体的に書き出します。
運用・内製化を設計せず孤立する失敗
最後に挙げる失敗パターンは、運用設計の欠落です。構築だけに注力し、誰がどう運用・改善し続けるかを設計しないと、システムは作った瞬間から陳腐化していきます。とくに、すべてを外部委託したまま社内にノウハウが残らないと、ちょっとした改修でも都度発注が必要になり、運用コストが膨らみ続けます。
連携を省いて1日100件超のデータを手入力し続け、現場が疲弊した失敗事例も、運用視点の欠落が招いたものです(出典:ripla)。回避策は、構築の段階から運用・内製化を見据えることです。
委託の過程にスキルトランスファーを組み込み、CCoE(Cloud Center of Excellence)のような専門チームを立ち上げます。また、クラウド人材を育成します。監視・障害対応・コスト最適化を自社で回せる体制をつくれば、システムを長く価値あるものに保てます。
riplaは、フルスクラッチ受託とクラウド構築・運用の伴走という立場から、これらの失敗パターンを先回りして潰し、構築から運用・内製化までを見据えた設計を支援しています。失敗は技術の問題ではなく、計画と運用設計の問題だと捉えることが、回避の第一歩です。
- 委託と内製の線引き:外部に任せる作業と、社内で回す作業を分けて決めます。
- 運用の担い手:監視、障害対応、コスト最適化を、誰が担うかを決めておきます。
運用設計の欠落を防ぐうえで、もう一つ意識したいのは、「絶対止めない運用(ITIL型)」から「許容範囲を決めて改善に資源を回す運用(SRE型)」へ移ることです。すべての障害をゼロにしようとすると運用コストが際限なく膨らみますが、SLO(サービスレベル目標)を設定して、どこまでの停止を許容するかを決めれば、過剰な作り込みも避けられます。
障害対応を自動化し、繰り返し発生する手作業(トイル)をなくしていけば、少人数でも安定した運用を回せるようになります。運用文化そのものを設計に織り込めるかどうかが、長期の運用コストを左右します。
まとめ
ICTシステム導入の失敗は、データ移行と見積もりの甘さ(移行だけで20万〜80万円を軽視)、過剰スペックと転送量・仕様変更の隠れコストという形で表れます。ほかに、独自サービス使いすぎによるベンダーロックインとPoC不在の本番化、セキュリティ・コンプラ違反と運用設計の欠落があり、全体は4つの領域に集約されます。
いずれも技術そのものではなく、計画と運用設計の不足が原因で、要件定義の精度を上げ、コストを総額で見積もり、検証を経て本番化し、運用・内製化まで設計すれば、多くは未然に防げます。失敗のパターンには再現性があるからこそ、先回りの対策が効きます。
構築時のコストだけでなく運用の隠れコストまで見積もり、責任共有モデルと業界コンプラを要件に組み込み、スキルトランスファーで内製化を見据えることが大切です。これらを初期から計画すれば、ICTシステムは長期にわたって価値を生み続けます。
riplaはフルスクラッチ受託とクラウド構築・運用の伴走を組み合わせ、失敗パターンを先回りして潰す設計を支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。