
インシデント管理システムの費用は、対象範囲と運用時間によって変わります。連携と通知の方式によって、初期30万円から独自開発の1,000万〜3,000万円以上まで幅が広がります。
全体像を先に知りたい場合は、インシデント管理システム開発の完全ガイドが参考になります。
▼全体ガイドの記事
・インシデント管理システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
インシデント管理システムの全体像
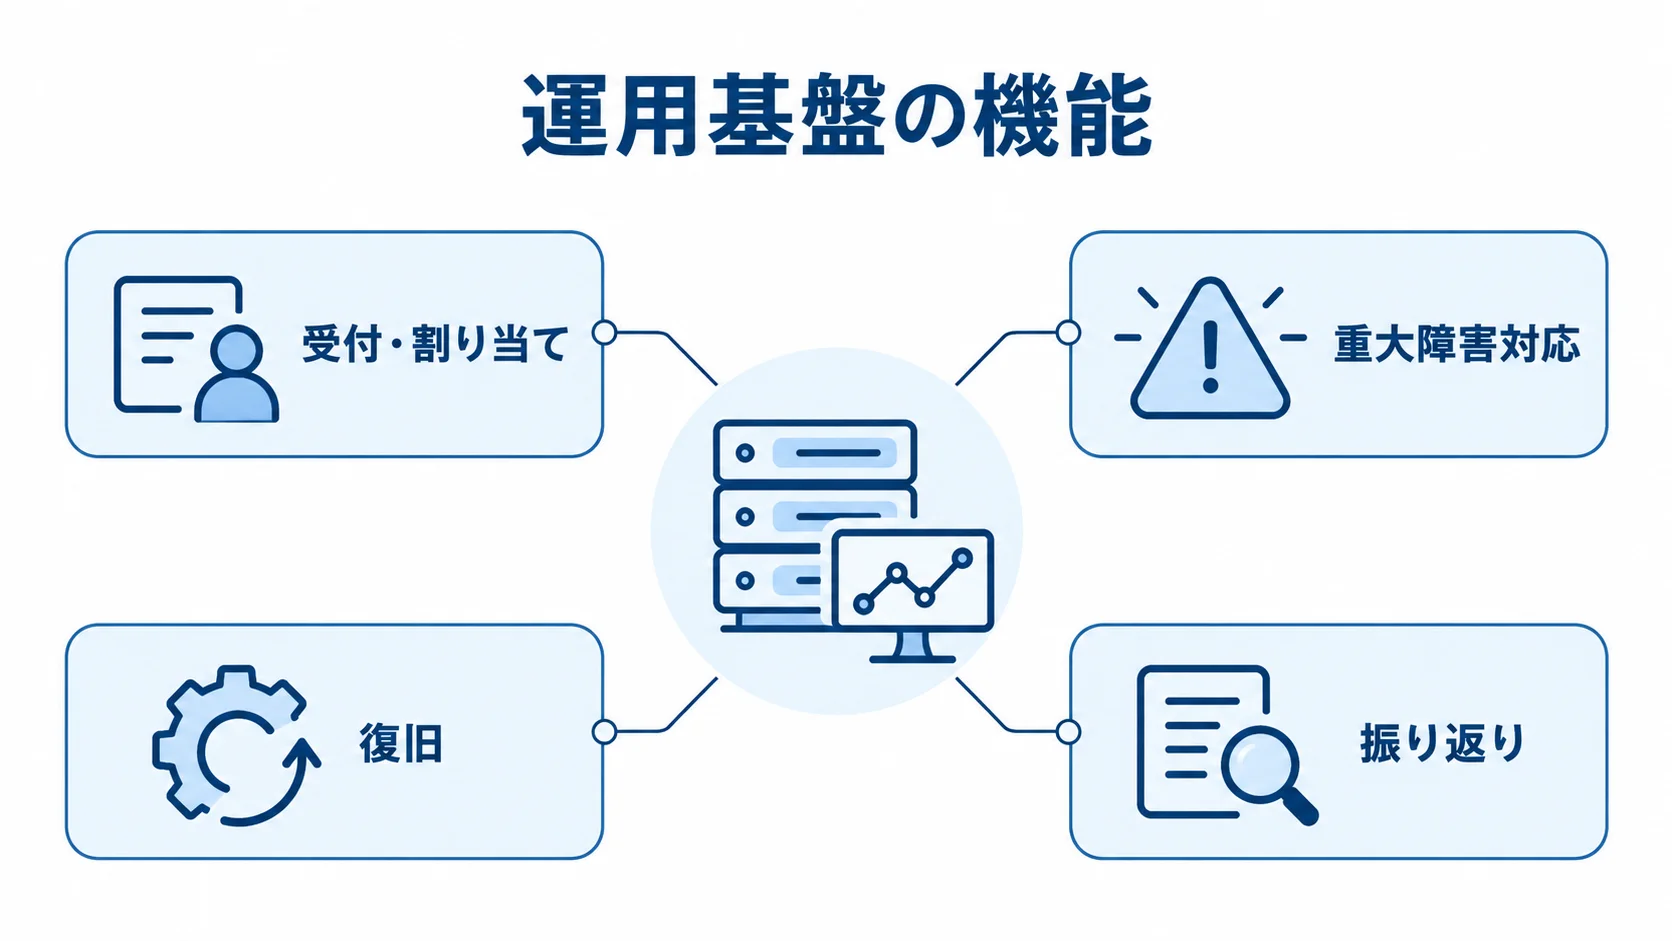
インシデント管理システムは、障害・サービス停止・性能劣化・ITの問い合わせをまとめて管理し、受付から復旧、振り返りまで追跡する業務基盤です。通常のサービスを早く復旧させ、業務への影響を抑えることが目的になります。
ITILのインシデント管理では、原因究明よりも、サービスの迅速な復旧を目的とします。そのため、フォームやチケットの記録だけに留めず、監視や通知、エスカレーションを、復旧からポストインシデントレビューまでつなぎます。
障害の記録だけでなく復旧を速める仕組み
受付から改善までの流れを支えるには、窓口の集約から復旧後の分析まで、機能を一続きで備える必要があります。
- 受付・割り当て:メール、Webフォーム、チャット、電話、監視ツール、APIからの受付と、担当グループへの割り当て。
- 重大障害対応:当番への通知、段階的な連絡、責任者の指名、状況共有を含みます。
- 振り返り:復旧後の指標の集計と、次の改善への活用。
受付時にはカテゴリや緊急度を付けておき、担当グループへの割り当てはシステムが自動で行います。重大な事案では、電話やSMS、プッシュ通知による呼び出しから、インシデントコマンダーの指名、ステータスページへの告知まで連携させます。
改善の効果は、復旧後のMTTA(検知・受付から認知までの平均時間)・MTTR(復旧までの平均時間)・SLA達成率・再発率で測ります。
SaaS・パッケージ・スクラッチ別の費用構造
導入方式が違うと、初期費用と運用費用のかかり方も変わります。
- SaaS:月額ライセンスを払い、標準のワークフローを設定して使います。
- パッケージ:自社プロセスへの適合とデータ移行を進めます。
- スクラッチ:独自画面や複雑な業務ルールに合わせて作ります。
パッケージ導入では、ITIL、CMDB、変更管理を整えていく過程で、導入コンサルティングとデータ移行の費用が加わります。
スクラッチ開発は自社への適合性を高められる一方で、権限や監査証跡、通知と当番、バックアップ、高可用性の工数が積み上がります。そのため、方式を先に決めず、既存ツールや運用時間、セキュリティ要件、将来の拡張性を比べます。
インシデント管理システム開発・導入の進め方
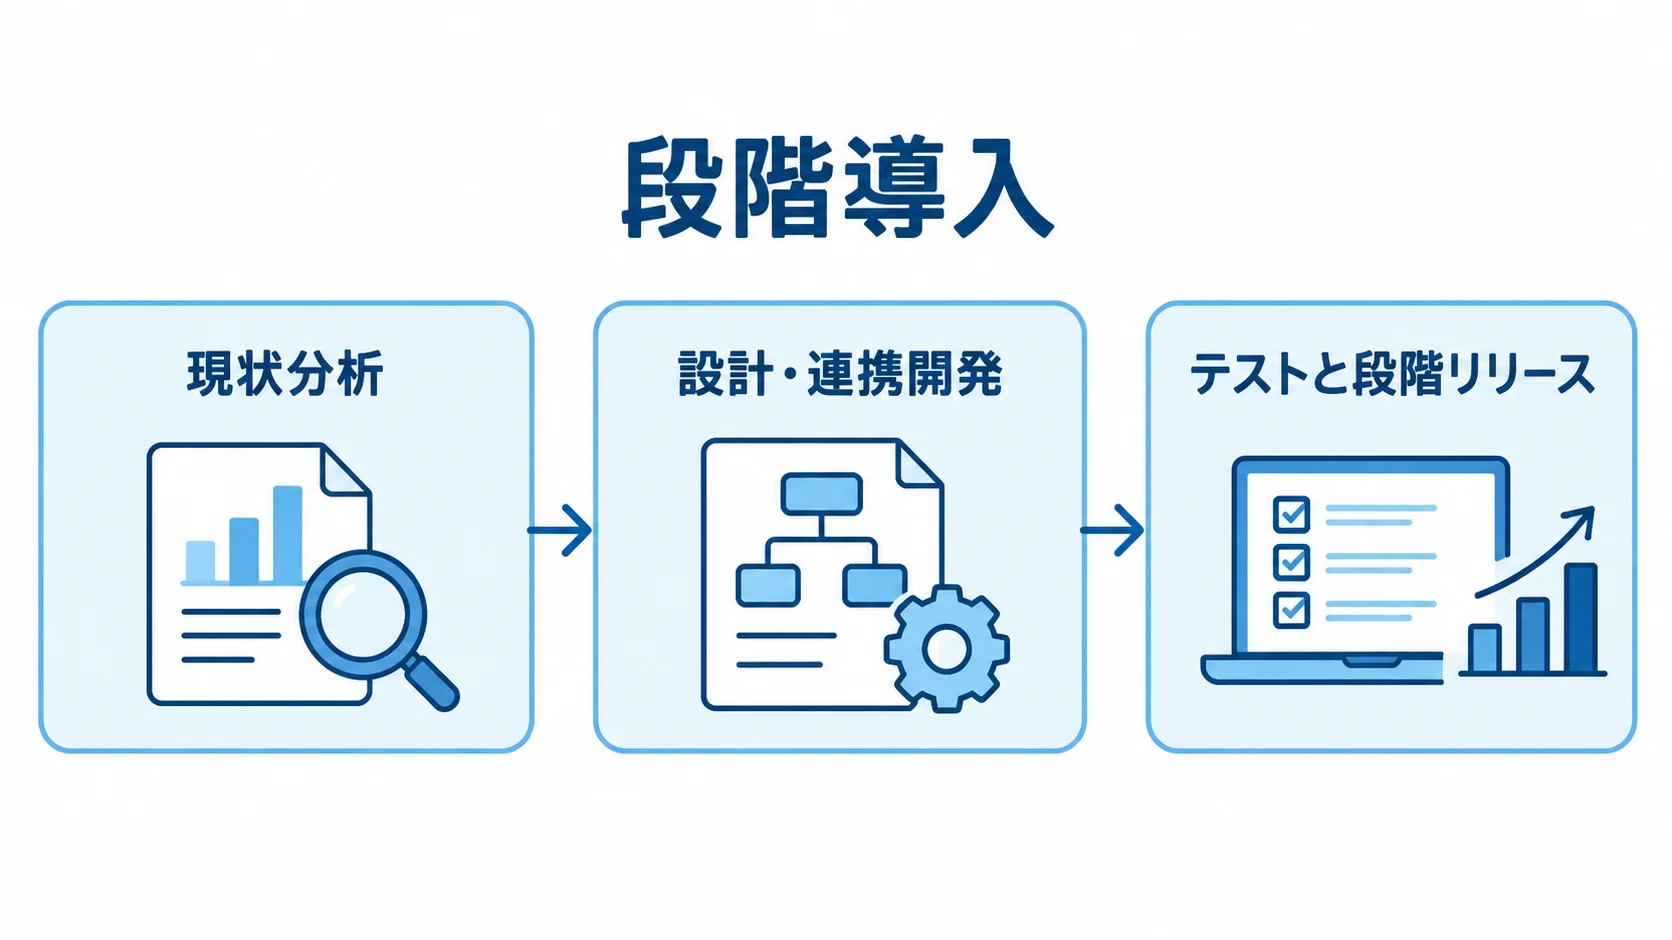
費用を抑えたいなら、製品を先に決めず、まず現在の障害対応を洗い出してから要件を作ります。
過去3〜6か月の障害や問い合わせを一覧にし、受付経路、影響サービス、重大度を書き出します。担当・通知先・復旧時間・再発状況まで整理すると、必要な機能と不要なカスタマイズを見分けられます。
期間の目安は、標準設定で2〜6週間、連携を含むSaaS導入で1〜3か月です。ITSMプロセスやCMDBまで整える場合は、3〜6か月が一つの目安になります。
現状分析とMUST・WANTの切り分け
最初に確かめたいのは、インシデントがどの経路から入ってくるかです。監視アラートや顧客の電話が別々に届き、営業のメールや開発チームのチャットにも分かれていると、状況を追いにくくなります。そこで、受付を一か所にまとめ、対応状況を追える形にします。
要件は必須機能と追加候補に分けて、初期リリースで何を入れるかをはっきりさせます。
- MUST:受付をまとめ、重大度と担当を決め、通知や履歴、SLA計測を備えます。
- WANT:候補は、AI要約、自動修復、顧客向けページ、高度な予測です。
MUSTとWANTを混ぜると、初期リリースには要らない機能の開発費まで見積もられやすくなります。
設計・連携開発での復旧フローの具体化
設計では、重大度1から軽微な問い合わせまでを振り分ける判定基準を決めておきます。
- 連絡条件:指揮役や管理職、顧客へ連絡する条件を定めます。
- イベント処理:重複抑制、情報付与、チケット作成、当番通知の流れ。
- 記録の保管:時刻、判断、復旧、承認者をシステムに残します。
- 初期連携:SSO、SCIM、MFA、監査ログ、CMDB、開発チケットとのAPI接続の確認。
連携は、後から付け足すと再設計が発生しやすくなります。また、SlackやMicrosoft Teamsは協働の場として使い、記録はシステム側に残す役割分担にします。
テストと段階リリースによる現場定着の確認
テストでは、通常の問い合わせに加えて、夜間の重大障害や担当者不在、通知失敗を確かめます。さらに、通知を受けた人が何を見て、誰に引き継ぎ、いつ復旧と判断するかも訓練の対象になります。
- 障害訓練:大量アラートや外部サービス停止のときの引き継ぎを試します。
- 段階導入:小規模なチームなら、一つのサービスと当番表から始めます。
- 効果測定:MTTA、MTTR、SLA達成率、重複率、再発率、自己解決率を導入前と比べます。
1〜2か月運用してから対象を広げると、安全に進められます。その結果を見て、機能追加の優先順位を決めます。
インシデント管理システムの費用相場と内訳
費用は月額の安さだけで見ず、TCOで比べます。TCOには、初期設定や連携、移行、教育に加えて、通知や保守、改善も含めて考えます。
開発費は、対象専用の公開統計ではなく、リサーチノートにある類似業務システムの費用と必要要件をもとにした推定です。
必要要件には監視と通知、SSO、CMDBが含まれます。実際の費用は、見積もりの条件をそろえたうえで個別に確かめます。
SaaSのライセンス料金の目安(月額3,000〜8,000円前後)
比べるときは、エージェント数だけでなく、通知先や当番表もそろえます。アラート件数やデータ保存期間も同じ条件にしておくと、料金の差が正しく見えます。
- Atlassian Standard:3エージェントまでは無料で、以降は1エージェントあたり月額20ドルです。
- Atlassian Premium:1エージェントあたり月額51.42ドルで、高度なAIOpsなどが含まれています。
- PagerDuty:5ユーザーまで無料です。年契約表示での1ユーザーあたり月額は、Professionalが21ドル、Businessが41ドルです。
公開価格の例として、AtlassianのService CollectionにはStandardとPremiumのプランがあります。出典は、Atlassian公式料金ページとPagerDuty Incident Management Pricingで、2026年8月に確認しています。
Premiumには、リアルタイム監視、インシデント・問題管理、変更管理も含まれます。なお、1ドル150円で換算すると、Standardは1人月約3,000円、Premiumは約7,700円です。
金額は、為替や税、契約期間、追加機能によって変わります。SSOや高度な認証は、別契約が必要になる場合もあります。
PagerDutyの月払い価格は、1人あたり月額25ドルと49ドルです。SMSや電話通知、AIOpsは追加費用になる場合があります。ステータスページやAI機能、関係者向けライセンスも、追加費用がかかることがあります。
初期設定・連携・独自開発の費用の幅(数十万円から数千万円)
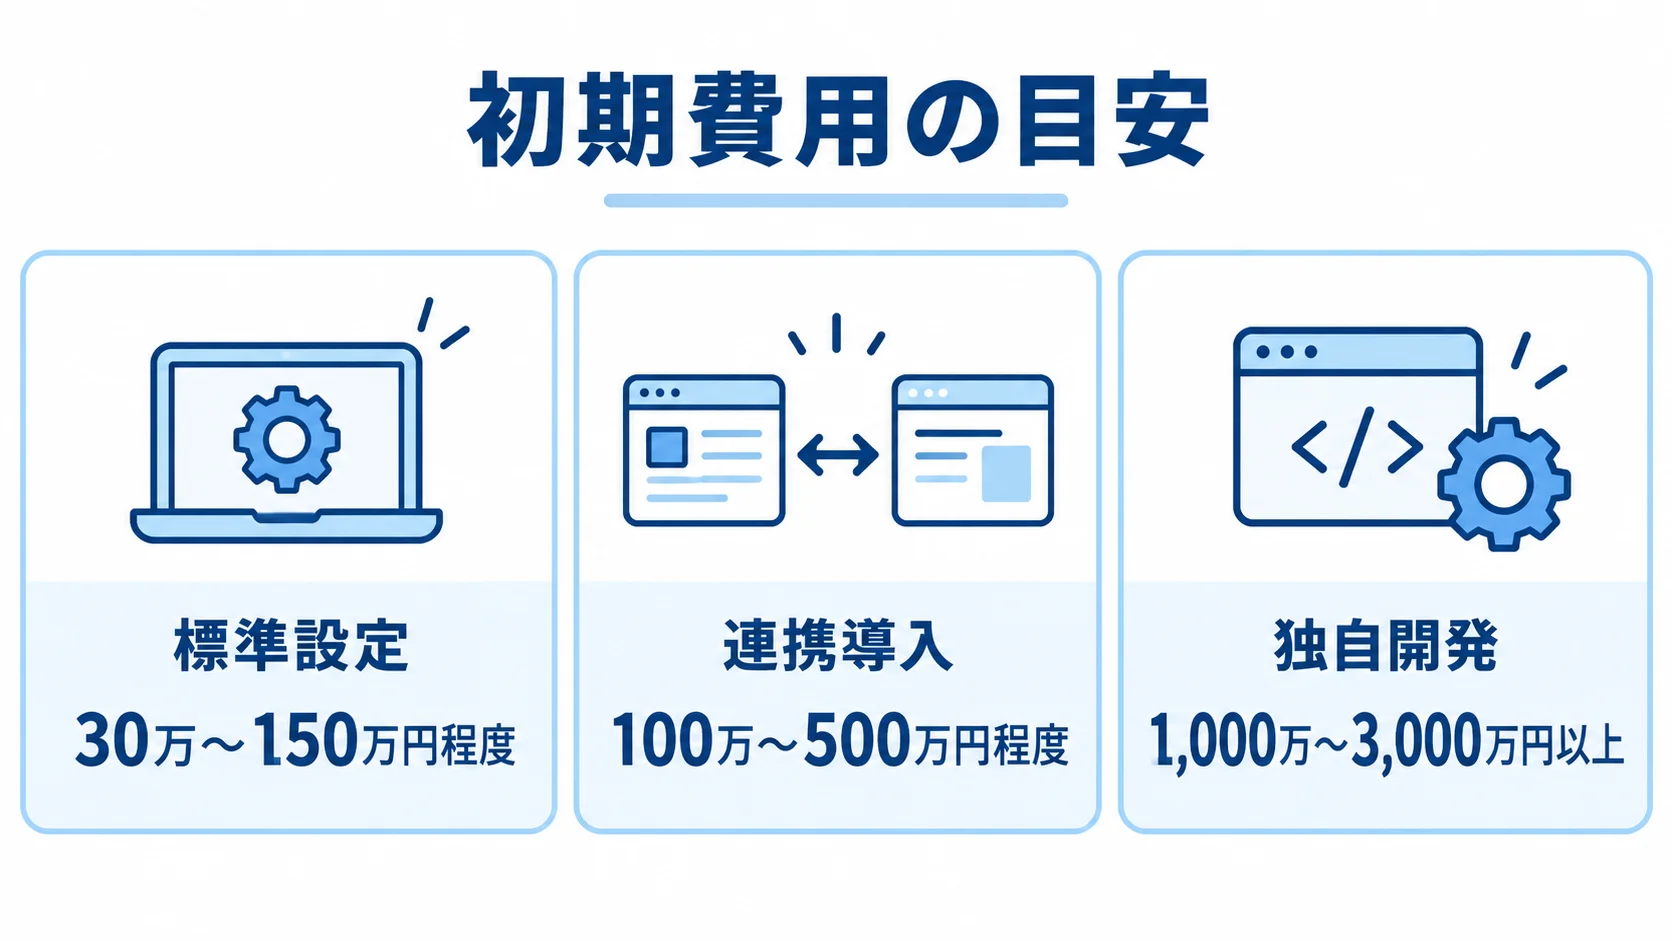
SaaSの標準設定は、受付フォーム、重大度、キュー、SLAの設定を含みます。基本通知と権限設定も含め、初期30万〜150万円程度が目安です。
監視ツールとログ基盤、SlackやTeamsを連携する場合は、初期100万〜500万円程度が推定レンジです。SSO、開発チケット、CMDBとの連携も、同じ推定レンジに含めて考えます。
これらは定価ではなく、類似の業務システム費用から見積もった推定値です。
- 標準設定:初期30万〜150万円程度で、ライセンス費は別に必要です。
- 連携導入:初期100万〜500万円程度の推定レンジ。
- 独自開発:小規模でも1,000万〜3,000万円以上が目安です。
運用ルールと対象サービスが絞られていれば、標準設定は下限に近づきます。一方で、複数部署の承認や複数拠点、顧客向けの告知を含めると、上限に近づきます。移行、マニュアル、教育まで委託する場合も、上限側に寄ります。
連携では、重複排除やサービス名の変換、自動割り当てを作り込むほど工数が増えます。代替通知も含めると、さらに増えます。中規模以上の独自システムや、高可用性を含む構成では、上振れする可能性もあります。
ランニング費用の内訳(通知・保守・運用改善)
月額ライセンス以外にも、利用量に応じて増える費用があるため、見積もりに入れて確かめておく必要があります。
保守費は、問い合わせ窓口に加えて、どこまでの作業を含むかで大きく変わります。
- 通知・従量費:電話、SMS、AI、アラート・イベント量、CMDBオブジェクト数、ステータスページの購読者数、データ保管、サポート費。
- 24時間対応:監視、夜間受付、オンコール、重大障害支援は、別途見積もります。
- 保守範囲:OSやAPIの変更、権限、改善、レポート、訓練を含むかどうか。
AWS Systems Manager Incident Managerの料金は、既存顧客向けの体系でした。レスポンスプラン1件あたり月額7ドルで、SMSや音声通知は月100件まで含まれていました。
AWSは2025年11月7日に新規顧客への提供を終えており、2026年時点では新規の導入候補にはできません。出典は、AWS Systems Manager公式料金ページ(2026年8月確認)です。
サービスの提供終了や統合も、TCOに影響します。そのため、契約前に確かめておきます。
自社で一次対応を行い、ベンダーには二次対応と月次改善を頼むなど、どこまでを誰が受け持つかを明記すると、過剰な委託を抑えられます。
費用を左右する変動要因とコスト最適化のポイント
同じ製品でも費用が変わるのは、対象サービス数や監視イベント量、対応時間が違うためです。セキュリティ基準や既存データの状態によっても、差が出ます。
ライセンスが安くても、連携開発や通知、教育が膨らむと総額は高くなります。そのため、自動化する運用の範囲と、対応までの目標時間を見積もりで確かめます。
連携数とデータ品質による開発工数の違い
監視ツールが一つで、サービス名や担当者情報も整っていれば、標準コネクタやAPI設定で進めやすくなります。
- 連携先の多さ:複数クラウドや監視系が混在すると、変換と重複排除が要ります。
- CMDB整備:依存関係、所有者、重要度、変更履歴の整備まで含みます。
連携の対象には、ログ基盤やEDR、ネットワーク監視のほか、顧客向けサービスも含まれます。また、古い台帳の補正や欠損データの確認が、連携開発より大きな工数になることもあります。
セキュリティ・可用性・BCP要件の初期段階での整理
インシデント票には、顧客情報や障害ログ、担当者の連絡先、セキュリティ状況が含まれる場合があります。
高可用性や複数リージョン、災害時の切り替えに加えて、24時間受付を求めると、SaaSでも費用は上がります。
重要なサービスには厳しい要件を適用し、開発環境や重要度の低いサービスには標準設定を使う方法が現実的です。
- 情報保護:保管地域、暗号化、権限、SSO・MFA、監査、削除の決め方。
- 管理範囲:通常障害と切り分けるか、SOC・SIEM・SOARと連携するかどうか。
- 事業継続:復旧、連絡体制、演習、代替チャネルを用意します。
委託先からのアクセス範囲やバックアップも、要件に含めます。出典は、IPA「中小企業の情報セキュリティ対策ガイドライン第4.0版」(2023年)です。
平常時のライセンスだけを安く抑えると、障害時に通知が届かないリスクが残ります。
標準機能・段階導入・運用内製化による費用の最適化
費用を抑えるには、標準機能を使う範囲を先に決めます。そのうえで、重大度・担当割り当て・通知・履歴・SLA計測を優先します。
契約時には、ユーザー数やイベント量が増えたとき、費用がどう変わるかを必ず確かめます。
- 自動化:発生件数が多く、ルールが明確で、失敗時に人が止められる業務から始めます。
- PoC:重要サービスで、通知の到達率、MTTA、MTTR、入力の負荷、誤分類を確かめます。
- 契約確認:増加費用、価格改定、データ出力、API、移行支援の条件。
重複アラートの抑制や担当の振り分けは自動化しやすい一方で、復旧の告知や本番変更の承認には、人の確認を残しておきます。
効果が確認できた機能から広げると、初期費用の負担を分けられます。また、履歴や添付資料は取り出せる形式で保存し、業務ルールと設定も社内に残します。
見積もりを取る際のポイント
見積もりは合計金額だけで比べず、同じ成果が含まれる条件でそろえて比較します。「インシデント管理一式」とだけ書かれていると、設定や連携の範囲が分かりません。テスト、教育、保守も含まれるかどうかが見えにくくなります。
見積もりを依頼するときは、対象サービス数・ユーザー数・当番人数・監視ツール数・イベント量を示します。通知先・保存期間・SLA・対応時間もそろえて伝え、初期費用と月額費用は分けて見積もってもらいます。
見積書の初期費用と継続費用の分解
初期費用は、現状分析、要件定義、基本設計、設定、カスタマイズに分けて見ます。API連携や移行、テスト、教育、マニュアル、リリース支援も、別々に確認できる形にします。
過去のアラート量をもとに、平常月と障害集中月の両方で試算しておくと、予算超過を防ぎやすくなります。
仕様変更のたびにベンダーへ依頼していると、初期開発が安くても、数年後のTCOが高くなる場合があります。また、社内で一次切り分けができる体制を持つことも、長期的な費用の抑制につながります。
- 初期費用:分析、設計、設定、連携、移行、テスト、教育の内訳。
- 継続費用:ライセンス、通知、保管、従量料金、監視、保守を、それぞれ確認します。
- 独自開発:人月に加えて、クラウドや監視、バックアップなどの費用が要ります。
継続費には、問い合わせや更新、改善、24時間対応も含めて見ます。メール通知が無料でも、電話やSMSは別料金の場合があります。独自開発では、脆弱性対応や証明書更新、待機、保守改修の単価も確かめます。
納品物には、ソースコードや設計書、API仕様を含めます。運用手順やテスト記録も、納品物として受け取る形にします。
複数社の同一要件での比較と得意領域の見極め
相談先には、製品ベンダーと、導入や連携、運用を支援するSIerがあります。両者は役割が異なります。
ServiceNowのような大規模ITSMと、Jira Service Managementで開発と連携する場合とでは、必要な経験が異なります。
PagerDutyの当番やエスカレーション、監視基盤やOpsRampとのAPI連携でも、必要な技術の領域は変わります。
TISはITSMクイックスタートパッケージで、最短約3か月の導入を案内しています。アラートをまとめて管理することや、運用を見えるようにすることも支援しています。短期間の導入でも、標準機能が中心か、CMDB移行や24時間運用まで含むかを確かめます。
出典は、TIS公式発表(2024年)です。
候補会社は、次の観点で比べます。
- 製品・連携経験:ITSM、Jira、PagerDuty、監視基盤、OpsRampとの経験。
- 運用実績:ITIL・CMDB、セキュリティ、24時間運用、移行の実績。
- 支援体制:内製化への支援、保守窓口、担当者の障害対応経験を見ます。
初回リリースの範囲と、次の段階で追加する機能は、分けて見積もります。
導入後のリスクと効果に関する質問事項
見積もりの前に、代替の受付方法や、通知が失敗したときの確認担当を尋ねておきます。重大度の変更履歴、情報の出力形式、データ保管地域についても確かめます。
AtlassianのiFood事例では、Jira Service Managementへの移行後に応答時間が74分から17分になりました。解決時間も、150分から55分になったと紹介されています。
出典は、Atlassian公式導入事例(2025年)です。企業規模や運用条件が異なるため、同じ効果が出るとは断定できません。ただ、測定指標を事前に合意しておく際の参考にはなります。
- 継続・データ:終了時の移行支援、出力形式、保管地域の確認。
- AI利用:誤分類の承認や有人連絡、データ利用範囲、監査ログを押さえます。
- 効果測定:MTTA、MTTR、SLA、重複率、再発率、自己解決率の記録。
効果測定の基準値には、チケット件数ではなく、導入前の各指標を使います。
よくある質問(FAQ)
費用に加えて、既存の監視や開発、チャット運用との連携、導入後に現場が使い続けられるかも、判断の材料になります。
インシデント管理システムはSaaSとスクラッチ開発のどちらが安いですか?
標準SaaSは安く始めやすい一方で、監視やSSO、CMDB、電話通知、独自の承認を加えると費用が増えます。比べるときは、独自業務との適合やデータ保管、利用者数、保守体制も含めた3〜5年TCOで見ます。
小規模企業が導入する場合の費用はいくらですか?
受付や担当割り当て、基本通知、履歴管理に絞った標準設定は、初期30万〜150万円程度が目安です。
要件を絞った概算と、将来拡張した場合の追加見積もりは、分けて取ります。
- 標準設定:初期30万〜150万円程度に、月額ライセンスが加わります。
- 連携あり:監視、Slack・Teams、SSOを含めると、初期100万〜500万円程度です。
金額は、ユーザー数や対象サービス、イベント量によって変わります。通知方式や教育の有無も影響します。
費用を抑えてインシデント管理を始める方法はありますか?
無料または小規模な有料プランなら、受付や重大度、当番、通知、復旧記録をまず試せます。
バックアップや代替の連絡手段を削ると、障害時のリスクが高まります。そのため、重要度に応じて残す要件を決めます。
- 小さく試す:重要サービス一つで、入力の負荷と効果を確かめます。
- 自動化する:頻度が高く明確な重複抑制や担当割り当てから始めます。
- 費用を抑える:標準機能、既存コネクタ、段階導入、社内一次対応を活用します。
24時間365日の運用を委託すると費用はどう変わりますか?
夜間・休日の一次受付やオンコール代行、電話・SMS、重大障害時の技術支援を加えるため、保守費は高くなります。
見積もりは、対応時間や対象サービス、一次切り分け、エスカレーション先に分けて取ります。現地対応や月間件数も、別の項目として示してもらいます。
自社当番と外部委託を比べたうえで、MTTAやSLA達成率が改善する条件を確かめます。
まとめ
SaaSの標準設定は初期30万〜150万円程度で、監視やAPI、SSO、チャット連携を含むと100万〜500万円程度が目安になります。
独自開発は1,000万〜3,000万円以上が目安ですが、固定の価格ではなく推定レンジです。金額は、機能範囲や対象サービス、通知方法によって変わります。セキュリティや24時間運用、移行、教育、保守でも変わります。
本体価格ではなくTCOと復旧効果による判断
判断では、ライセンスだけでなく、設定や連携、通知の費用まで合算します。移行や教育、保守、更新、サービス終了時の移行も、合計に含めます。
MTTA、MTTR、SLA達成率、アラート重複率、再発率を目標値として設定し、減らしたい業務への影響をはっきりさせます。このシステムは、復旧を速めて再発を減らす運用基盤であり、障害票を増やすためのものではありません。
重要サービスから始める要件と概算の整理
要件と概算は、いきなり全体を対象にせず、重要サービスに絞って固めるのが進めやすい方法です。
費用に見合う成果に近づくには、現場が使い続けられる運用を設計することが近道です。
- 要件整理:過去3〜6か月の記録をもとに、MUSTとWANTを分けます。
- 小規模検証:重要サービス一つで、受付から復旧記録までを試します。
- 相見積もり:同じ条件のRFPを複数社に渡し、費用、期間、受け持ちの範囲、移行、改善範囲を比べます。
必要な連携だけを足し、条件をそろえておくと、根拠のある予算を作りやすくなります。
導入では、監視から通知、協働、復旧、PIR、問題・変更管理までをつなぎます。
▼全体ガイドの記事
・インシデント管理システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。