
インシデント管理システムは、障害や問い合わせの受付から、担当者への通知、復旧、振り返りまでを一つの流れで扱い、業務への影響を抑えるための仕組みです。
機能の範囲、導入方式、進め方、費用、開発会社の選び方は、発注の前に一つずつ確かめておきたい項目です。
▼関連記事一覧
・インシデント管理システム開発の進め方/やり方/流れや方法/手法/工程/手順
・インシデント管理システム開発でおすすめの開発会社/ベンダー6選と選び方
・インシデント管理システム開発の見積相場や費用/コスト/値段について
・インシデント管理システム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
インシデント管理システムの概要
インシデント管理システムは、システム障害や性能劣化、サービス停止、IT問い合わせを記録し、影響度に応じて担当者へ割り当てて、復旧まで追跡します。
主な目的は、通常のサービスを早く取り戻し、利用者と事業への影響を抑えることです。
単なる問い合わせ管理との違い
問い合わせ管理は受付の記録が中心ですが、インシデント管理は、復旧までの流れを案件ごとに追います。機能ごとの違いは、次の項目で確かめられます。
- 問い合わせ管理:誰からどのような依頼を受けたかを記録する仕組みです。
- インシデント管理:影響サービス、影響度、復旧期限、担当者を案件ごとに持ちます。
- 対応機能:フォームやチケット一覧のほか、重大度判定、エスカレーション、オンコール、告知、復旧後レビューまで含みます。
- 監視連携:監視ツールが異常を検知したら、同じ原因の大量アラートをまとめ、影響サービスの責任者へ知らせます。
- 復旧後の流れ:担当者が状況を更新し、必要に応じて責任者や広報へ順次連絡したうえで、再発防止課題へ引き継ぎます。
問題管理・変更管理・セキュリティ対応との関係
障害対応を再発防止までつなぐには、インシデント、問題、変更の役割を分けて、互いに連携させる必要があります。また、情報漏えいやアカウント侵害、ランサムウェアなどのセキュリティインシデントは、通常の障害対応と重なる部分があります。
- インシデント管理:サービスの復旧を担います。
- 問題管理:再発の根本原因を特定して、恒久対策へつなぎます。
- 変更管理:恒久対策を、安全に本番環境へ反映する仕組みです。
- セキュリティ対応:証拠保全や権限分離、法務・広報への連絡、外部機関への報告が要る場合があります。
インシデント票を問題・変更チケットへ関連付けると、障害の再発を減らせます。
セキュリティ案件を同じデータモデルで扱うか、専門基盤と分けて連携するかは、要件定義で決めます。
インシデント管理システムの主要機能と必要な設計
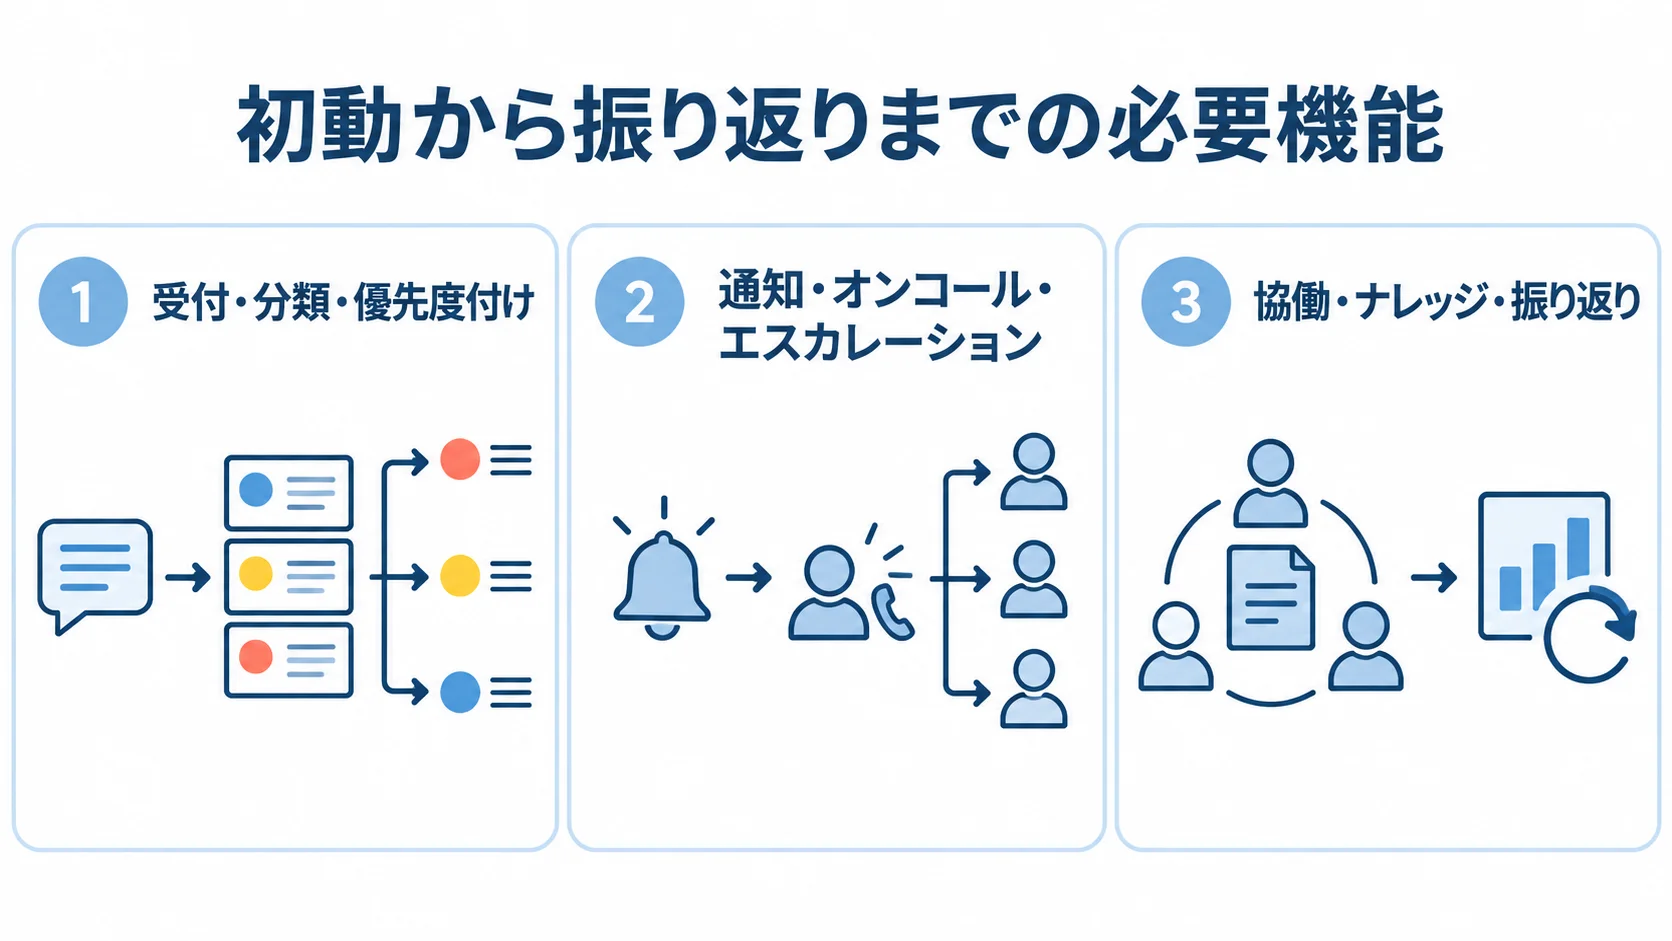
自社に必要かどうかは、機能の一覧を見るだけでは判断しにくいものです。そこで、受付、判断、通知、協働、復旧、振り返りの各場面で、誰がどの情報を入力し、次に誰へ渡すのかを先に決めます。
便利な機能を増やすほど入力項目や運用ルールも増えるため、最初は復旧に直結する最小構成から始めます。
受付・分類・優先度付け
受付情報と優先度の基準をそろえておくことで、担当者は初動の判断を同じ基準で行えます。
- 受付経路:Webフォーム、メール、チャット、電話、監視ツールのAPIから届く依頼を、一つの台帳にまとめます。
- 人による起票:発生時刻、影響サービス、利用者への影響、事象、暫定対応を記録します。
- 監視からの起票:アラート名に加えて、環境、サービス、重要度、関連する構成情報を渡します。
- 優先度の判定:緊急度と影響範囲を組み合わせて判定し、全社認証の停止は最上位、一部機能の遅延は中位とする例を基準表に示します。
- 初動の基準:担当者の経験だけに頼らないよう、重大度ごとの期限、連絡先、エスカレーション条件を定めます。
通知・オンコール・エスカレーション
夜間や休日でも初動が遅れず、通知が漏れないよう、当番体制と連絡経路を設計します。
- 当番体制:当番表、代替担当、通知手段、応答期限を、システムに登録します。
- 段階的な通知:プッシュ通知、SMS、電話、チャットを使い分け、応答がなければ次の担当者へ連絡する流れです。
- 通知の整理:同じ原因のアラートをまとめ、低優先度の通知は抑えて、人の判断が必要なものに絞ります。
- 定期テスト:電話番号、休日の例外、当番交代、通信障害時の代替経路を、定期的に試します。
協働・ナレッジ・振り返り
重大なインシデントの協働と復旧後の振り返りでは、役割と記録を明確にしておきます。
- 役割分担:技術担当、サービス責任者、顧客対応、経営層、広報それぞれの役割を定めます。
- 対応記録:インシデントコマンダー、技術調査、連絡、記録を分けて担当します。議論や判断はタイムラインに残し、重複や認識違いを減らします。
- ナレッジ:手順書、既知エラー、ランブック、過去の振り返りを、検索できる状態にします。
- 再発防止:個人を責めず、検知・判断・連絡の課題と、対策担当者、期限を書き残します。
インシデント管理システムの種類
選択肢は大きく、クラウド型SaaS、パッケージを自社向けに設定する型、自社で開発・運用する型に分けられます。
ITSM型は問い合わせやITILプロセスを広く扱うのに対し、運用対応型はオンコール通知やアラート集約に強みがあります。
ITSM型と運用対応型を連携させる構成もあります。
クラウド型SaaS
短期間で始められる点が強みです。ただし、必要な機能や利用量を含めた年間費用は、事前に確かめておく必要があります。
- 始めやすさ:サーバー構築やアップデートを自社で抱えず、比較的短期間で導入できます。
- 標準機能:受付フォーム、キュー、SLA、通知、レポート、チャット・監視連携などを備えています。
- 向いている企業:情シスの人数が少ない企業や、現状を見える形にしたい企業に合います。
- 利用量と契約条件:利用者・エージェント数、アラート量、SMS・電話通知、AI利用量、構成情報件数の扱いを契約で確かめます。
- 年間費用:SSO、データ保管地域、サポート時間に加え、上位プラン限定の重大対応、監査ログ、複数地域、長期保存も含めて比べます。
パッケージ・マネージドサービス型
標準プロセスを自社ルールに合わせやすい一方、委託範囲や契約後に自社で回せるかも確かめておく必要があります。
- 業務への適合:ITILに沿って、インシデント、問題、変更、構成管理を設定します。
- 組織への適合:大規模組織や複数拠点、厳格な承認・監査がある組織では、標準プロセスと自社ルールを組み合わせます。
- 運用委託:24時間365日の監視まで任せれば、社内の夜間当番の負担を軽くできる場合があります。
- 契約前の確認:管理者権限、設定書、API仕様、データ出力、引き継ぎ研修を、将来の内製化に備えて見ておきます。
導入を支援者に任せきりにすると、契約後に設定変更やデータ取得が難しくなり、現場が仕組みを理解できないおそれもあります。
スクラッチ・ハイブリッド型
標準機能では難しい要件には独自開発が候補になりますが、運用の維持まで含めて範囲を決めます。
- 独自開発に向く要件:特殊な承認、顧客向けの状況画面、複数組織の権限、基幹システムとの深い連携などが該当します。
- 維持する仕組み:通知の再送、当番交代、監査証跡、バックアップ、代替連絡、アップデートも、自社で担う必要があります。
- ハイブリッド型:受付・チケット・通知はSaaSやパッケージに任せ、独自部分をAPI、ローコード、連携サービスで補います。
- 段階導入:スクラッチでも、対象サービスと重大度を絞れば、開発費と運用リスクを抑えられます。
インシデント管理システムの導入・開発の進め方
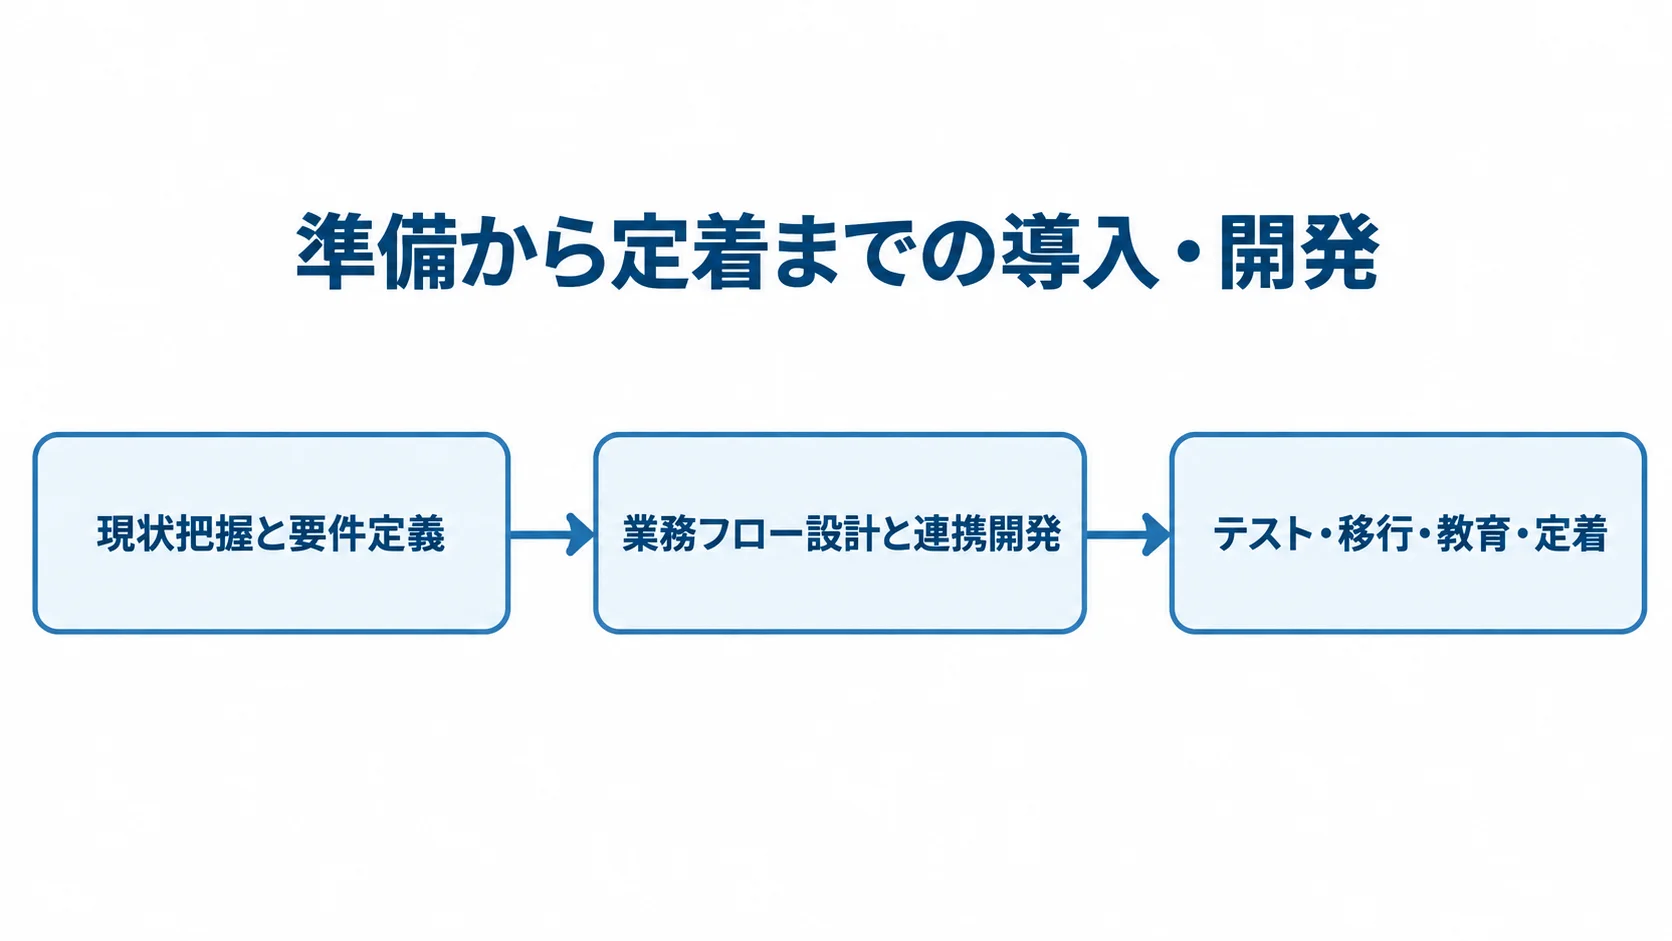
成功しやすいプロジェクトは、製品を先に決めず、過去の障害と現在の運用を整理するところから始まります。
進め方は、要件定義、設計・開発、テスト・移行・定着の順です。
どの段階でも、現場の担当者と実際の障害シナリオを一緒に確かめることが欠かせません。
▶ 詳細はこちら:インシデント管理システム開発の進め方/やり方/流れや方法/手法/工程/手順
現状把握と要件定義
過去の対応記録から課題を洗い出し、必要な要件と導入後の希望を分けて、導入範囲を決めます。
- 過去記録の確認:過去3〜6か月の障害、問い合わせ、監視アラートを一覧にします。
- 課題の把握:受付経路、重複件数、重大度、担当部署を整理します。初動・復旧時間、夜間対応、再発も課題として洗い出します。
- 既存環境の整理:メール、表計算、チャット、開発チケット、監視・ログ基盤が、どうつながっているかを図に描きます。
- 要件の優先度:MUSTとWANTに分けて、導入範囲を絞ります。
MUSTには、受付をまとめる仕組みと優先度、担当割当を含めます。通知と履歴、SLAに加え、権限と監査ログもMUSTに入ります。
WANTには、AI要約や自動修復を置き、予測分析や顧客向けステータスページなども候補にします。
最初に改善する指標は、一つから三つに絞ります。
業務フロー設計と連携開発
業務フローでは、受付から復旧後の引き継ぎまで、案件の状態と各システムとの連携を整えます。
- 状態設計:「受付」「判定中」「対応中」「監視中」「解決」「クローズ」の状態を定め、それぞれで変更できる人を決めます。
- 関連要件:エスカレーションも含めて、重大度や担当グループをサービスやSLAと結びつけて設計します。
- 重大度に応じた運用:コマンダーを置くのは重大度が高い案件だけにし、全案件を重い手順にはしません。
- イベント連携:監視・ログ・EDRのイベントを受けて、重複やノイズを抑えたうえでインシデント票を作ります。
- 対応後の連携:オンコールへ通知し、チャットで協働します。復旧後は、問題・変更管理やナレッジへつなぎます。
API仕様書には、認証や再送、タイムアウトの扱いを明記します。重複判定、障害時のキュー、個人情報の扱いも、併せて明記します。
テスト・移行・教育・定着
テストでは画面表示だけでなく、実際の障害対応を再現します。
- シナリオテスト:自動起票と重大度判定、当番通知を確かめます。未応答時の連絡や権限、復旧後の検索も、同じ流れで見ます。
- 移行対象:残すデータは、未解決案件や既知エラーを優先して決めます。重要障害や再発防止策も対象に含めます。
- 移行時の注意:メールやチャットをすべて移すと検索性が落ちるため、移す対象を絞ります。
- 小規模試行:小規模に試し、入力項目や通知が多すぎないか、現場が以前の方法へ戻っていないかを見ます。
- 運用レビュー:月次で、KPIと具体的な案件を振り返ります。
手順書は更新し続け、当番交代時の確認や重大インシデント演習、管理者向けの設定教育を重ねます。
利用者への受付方法の周知も行い、使われる状態を保ちます。
インシデント管理システムの費用相場とコストの内訳
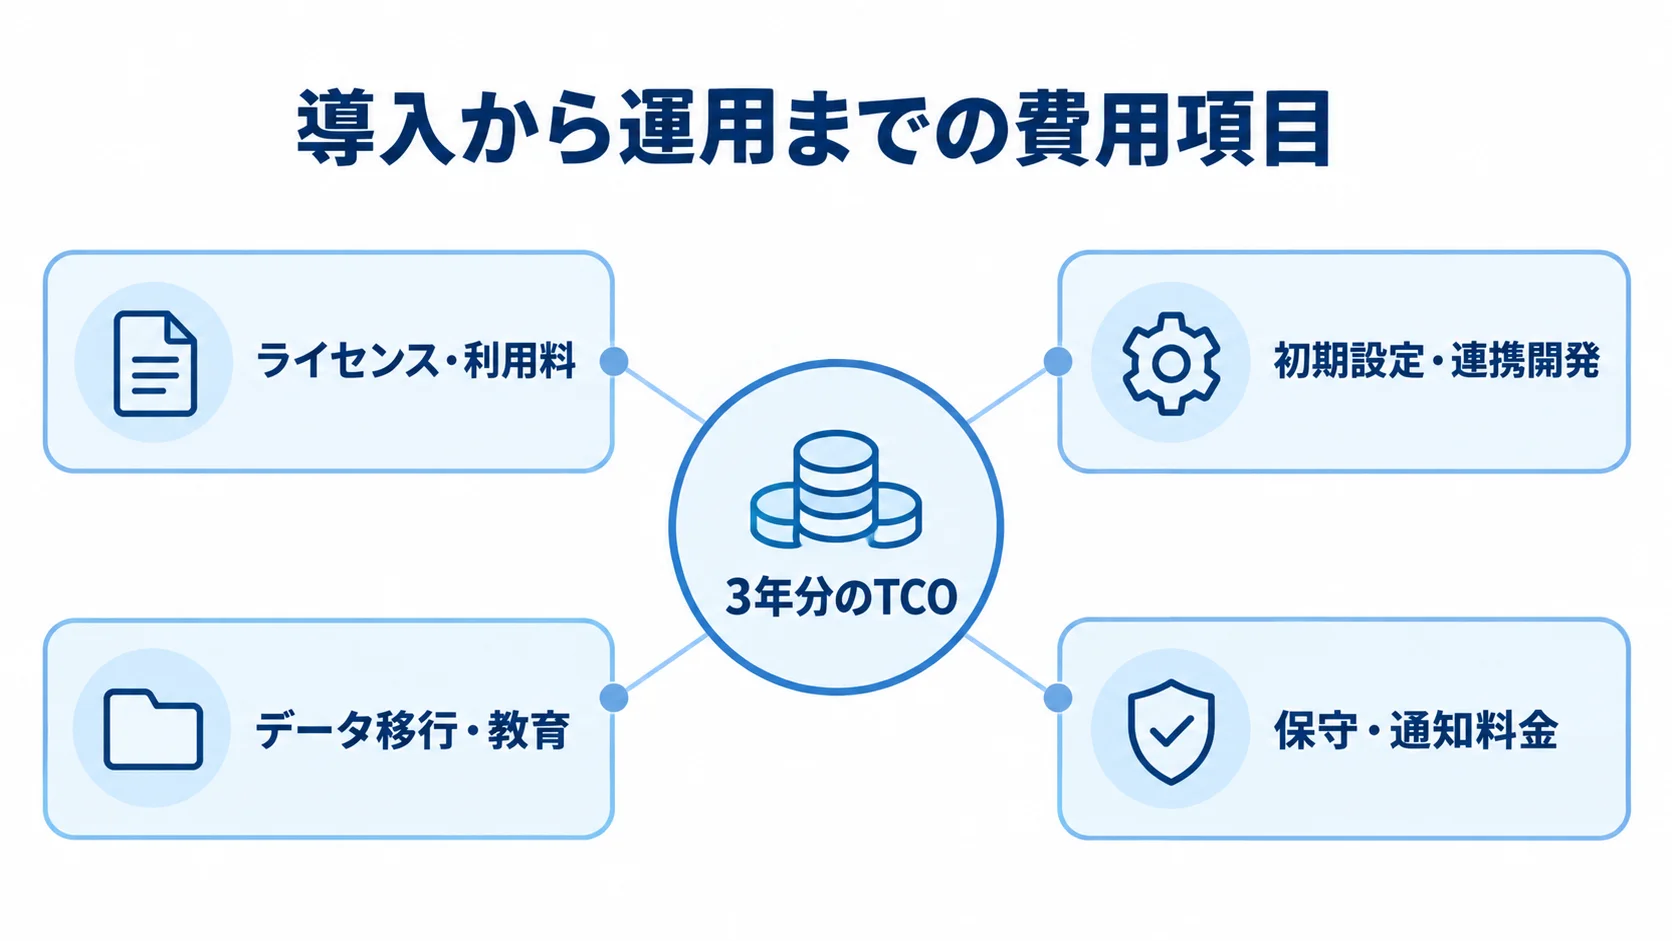
費用は、ライセンスや利用料に加えて、初期設定や連携開発を含めて考えます。データ移行や教育も対象になります。保守や通知料金も、見落とさずに含めます。
公開価格のあるSaaSは比較しやすい一方、導入支援や監視連携の費用が別になることがあります。
独自開発は、運用を何年続けるかを含めた総保有コストで判断します。
▶ 詳細はこちら:インシデント管理システム開発の見積相場や費用/コスト/値段について
ライセンス・初期設定・連携の費用
ライセンス費と初期費用は別々に見積もります。通知量や連携範囲も、あわせて確かめます。
- ITSMライセンス:無料枠やエージェント単価、上位機能まで、範囲を比べます。
- オンコール料金:ユーザー単価に加えて、SMS・音声、当番表、エスカレーションの別料金も見ておきます。
- 初期導入費:標準設定と運用設計か、監視・API・チャット・SSO連携を含むかで、見積もりが変わります。
- 上振れ要因:構成情報の移行や複数拠点の権限、複雑な連絡が、費用を押し上げやすい要因です。レポート、教育、対象サービス数、連携本数も確認します。
2026年8月確認のITSM公式料金では、3エージェントまで無料、標準は1エージェント月額20ドル、高機能は月額51.42ドルです。
高機能には高度なアラート相関、リアルタイム監視、インシデント・問題・変更管理が含まれます(出典: ITSMサービス公式料金ページ、2026年8月確認)。
1ドル150円で換算すると、1人あたり月額は約3,000円から7,700円です。ただし、為替や契約期間、税、追加機能によって変動します。
オンコール専門サービスの例では、5ユーザーまで無料で、年契約の表示で標準が1ユーザー月額21ドル、上位は同41ドルです。
月間のアラート数と通知数をもとに、試算を依頼します(出典: オンコールサービス公式料金ページ、2026年8月確認)。
初期費用の目安は、標準設定と運用設計で30万〜150万円、監視・API・チャット・SSO連携を含む導入で100万〜500万円程度です。ただし、これは公開された類似業務システムからの推定で、範囲によって変わります。
独自開発の費用相場と開発期間
独自開発の費用と期間は、規模や必要な運用機能によって変わります。画面以外の要件も含めて見積もります。
- 小規模:300万〜700万円程度です。
- 中規模:700万〜1,800万円程度です。
- 大規模:1,800万〜4,000万円以上が目安です。
- 開発範囲:通知と当番、監査証跡、権限、API、検索、バックアップと冗長化も、開発に含めます。
期間の目安は、標準設定が2〜6週間、連携を含むSaaS導入が1〜3か月です。ITSM・構成管理は3〜6か月、独自開発は6〜12か月以上になります。
24時間365日運用や複数拠点、高可用性を含む場合は、要件定義とテストに十分な期間を確保します。顧客向け画面やセキュリティ連携を含む場合も、期間には余裕を持たせます。
見落としやすいランニングコスト
比べる対象は、利用量や契約条件を含めた3年分のTCOです。初年度の価格は、その一部として見ます。
- 利用料金:本体、エージェント、顧客・閲覧者の料金を分けます。通知やアラート処理量、AI利用量、構成情報件数の料金も分けて見ます。
- 運用費用:SSO・ID連携や保管地域、監査ログの扱いを確かめます。バックアップ、サポート、保守、教育、設定変更の費用も見ておきます。
- 契約の変化:2年目から追加機能や利用量で高くなる場合もあるため、3年分のTCOを同条件で比べます。
- 提供状況:既存利用者と新規導入で選べる内容が異なるサービスもあります。その場合は、終了や改定、移行先、データ出力を確かめます。
クラウド基盤のIncident Managerでは、1レスポンスプランが月額7ドルでした。また、SMS・音声通知は100件まで無料でした。
新規顧客向けの提供は、2025年11月7日に終了しています(出典: クラウド基盤公式料金ページ・提供告知、2026年8月確認)。
インシデント管理システムの開発会社・ベンダーの選び方
開発会社・ベンダー選びでは、製品の提供会社と、導入設計・連携・移行・運用を支援する会社を分けて考えます。重大度の設計や現場教育が合わなければ、製品が高機能でも定着しにくくなります。
導入支援者の提案力が高くても、データ保管やAPI、通知、将来の料金が合わなければ、長期運用の負担になります。
製品と導入支援の役割分担
製品機能と導入支援の実績は、分けて確かめます。そのうえで、見積もりでどこまで対応するかを明確にします。
- 製品機能:受付、キュー、SLA、通知を確かめます。オンコールや監視連携、問題・変更・構成管理を見ます。ナレッジ、レポート、API、SSO、監査ログも見ます。
- 導入支援:現状分析やITIL設計、移行、連携開発の実績を確かめます。テストや教育、稼働後の改善、24時間運用の実績も見ます。
- 提案範囲:標準機能、設定、追加開発、運用で補う部分を、分けて示してもらいます。
- 類似実績:導入社数だけでなく、規模や運用時間、監視対象が近い案件かを確かめます。既存ツールやセキュリティ要件の近さも見ます。
- 障害シナリオのデモ:アラート受信から招集、関係者への告知、復旧、振り返りまでを見せてもらいます。
要件書・見積書で比較する項目
価格を比べる前に要件をそろえ、見積もりの作業範囲と追加料金を突き合わせます。
- 前提条件:対象サービス、人数、月間アラート数、受付・通知、当番、重大度を整理します。SLA、既存ツール、連携数、移行量、権限、保守時間も書き出します。
- 費用と期間:初期費用、月額、追加利用料、導入期間をそろえて見ます。
- 作業と受け入れ:作業範囲、成果物、検収条件が中心です。
- 保守と契約終了:障害時の応答目標、設定変更単価、契約終了時のデータ返却を確かめます。
- 比較方法:定額に含む範囲と別料金をそろえます。要件が曖昧なままだと、後から開発やオプションが増えることがあります。
保守体制・セキュリティ・ロックインの確認
基盤停止への備え、情報管理、将来のデータ移行は、契約前に確かめておきます。
- 基盤停止時の連絡:電話・メール、ステータス通知、バックアップ、復旧目標、障害報告が、契約に含まれるかを見ます。
- 連絡経路の分離:基盤障害と業務システム障害が、同じ連絡手段に頼らないようにします。
- 情報保護:保存地域や暗号化、SSO・MFA、管理者権限を確かめます。監査ログ、バックアップ、個人情報の保持、委託先、脆弱性対応も確認します。
- データ出力:終了や料金改定に備えて、履歴、添付、構成情報、ナレッジを標準形式で取り出せるかどうか。
- 移行の難しさ:データ取得と移行の難しさを把握し、ベンダーロックインを防ぎます。
▶ 詳細はこちら:インシデント管理システム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:インシデント管理システム開発の発注/外注/依頼/委託方法について
セキュリティ・BCP・運用定着の要件
インシデント管理システムには、顧客情報やログ、連絡先、復旧手順も蓄積されます。そのため、平常時のアクセス制御と、緊急時の迅速な共有を両立させる設計が要ります。
中小企業向けガイドライン第4.0版は、情報漏えいや停止への対応・復旧を示しています。自社の事業継続計画と要件をつなげます(出典: 情報セキュリティ対策ガイドライン第4.0版、2026年8月確認)。
権限・認証・監査証跡
機密情報を守りながら緊急対応できるよう、権限と操作記録を設計します。
- 役割別権限:閲覧者、起票者、担当者、コマンダー、管理者、監査担当に分けて、権限を与えます。
- 認証と特権:SSO、MFA、退職者の停止、緊急時の特権付与を要件に含めます。
- 監査証跡:変更日時や操作者、変更項目、通知先を記録します。編集できるタイムラインでは、履歴や承認も保存します。
- AIの記録:要約や重大度推定の元データ、生成結果、承認者、修正履歴を残しておきます。
BCPと代替連絡手段
主系の連絡手段が止まる場合に備え、代替経路とサービスごとの復旧目標を決めます。
- 代替連絡:電話、SMS、別系統のメール、紙の連絡網を用意し、起動する担当も決めます。
- 演習と更新:連絡先は定期的に更新します。少なくとも年に一度は、通信障害を想定した演習を行います。
- 復旧目標:サービスごとに、RTO、RPO、許容停止時間、優先する利用者を設定します。
- 影響範囲:サービス台帳や構成情報とインシデントを関連付けます。決済や認証と社内ツールを、同じ基準で扱わないようにします。
運用定着とKPI
登録件数だけでなく、初動・復旧・再発などの指標を導入前後で比べます。
- 初動と復旧:MTTAは検知・受付から担当者の認知まで、MTTRは復旧までの平均時間です。
- 品質:重大インシデントのSLA達成率、アラート重複率、再発率、ナレッジによる自己解決率を測ります。
- 推移の確認:導入前の基準値を残し、月次か四半期で数字を追います。
- 改善対象:重大度、当番、手順書、権限、振り返りも、ツールと合わせて見直す対象です。
一社の導入事例では、対応時間が74分から17分へ、解決時間が150分から55分へ短縮しています。ただし、自社の効果を約束する数字ではありません(出典: ITSMサービス公式導入事例、2025年確認)。
2026年時点の最新動向と導入効果
2026年時点では、クラウド化、AIOps、生成AI、サービス統合、データレジデンシーが選定に影響しています。さらに、AIでアラートをまとめ、状況報告やレビューの下書きを作る機能も広がっています。
自動化の範囲を広げる場合は、誤判定時の承認と人へのエスカレーションが必要です。
AI・AIOpsの活用:判断支援と自動復旧の順序
AIは、まず判断支援として使い始めます。自動操作を加える場合は、実行条件と監査方法を決めておきます。
- 先行する支援:類似アラートの集約、案件・ランブック検索、タイムラインの要約、関係者向け文案の作成が中心です。
- 自動操作の制御:対象を限定し、承認者、実行条件、ロールバック、ログ、停止ボタンを設けます。
- 段階導入:誤復旧の影響を評価し、低リスクの定型作業から自動化します。
- データ管理:参照データの時点、外部学習の設定、保存地域、プロンプトや生成結果の保持期間、利用者権限を確かめます。
- 効果測定:AIを入れたかどうかより、判断時間と記録品質の改善を見ます。
クラウド統合とデータレジデンシー
連携するときは、データの基準を決めておきます。クラウド環境では、保存・委託・閲覧の条件も確かめます。
- 統合する情報:サービス依存関係、デプロイ履歴、アラート、インシデントを一連で参照できるようにします。
- データの基準:連携前に正のデータ源を決め、IDとサービス名を統一します。
- クラウド条件:保存地域、海外移転、委託先、バックアップ、削除、監査を確認します。
- 情報へのアクセス:顧客情報やセキュリティログは必要に応じてマスキングし、閲覧範囲を分けます。
- 責任分界:クラウドとオンプレミスを決めつけず、責任範囲と運用能力を比べます。
導入効果の経営・現場での評価
現場と経営の指標は分けて見ます。導入初期は記録が増えるため、その点も踏まえて評価します。
- 現場の指標:案件検索や同じ質問への回答時間、深夜の呼び出し、アラート重複率を確認します。
- 経営の指標:停止時間、重大案件のSLA達成率、顧客影響、再発率、復旧工数を見ます。
- 初期評価:記録増加で一時的に数値が悪化しても、見える化の結果であれば、すぐに失敗とは判断しません。
- 改善時期:3か月程度で基準値を作り、半年程度を目安に、通知や初動、再発防止の完了率などを見てから、フォームや流れを調整します。
よくある質問(FAQ)
インシデント管理システムは、製品を導入すれば運用が自動的に整うものではありません。導入前によくある疑問を、選定と運用の両面から見ていきます。
小規模な情シスでもインシデント管理システムは必要ですか?
必要です。人数が少ない組織ほど、担当者の記憶や個人のメールに頼っていると、休暇や退職のときに対応が止まりやすくなります。
まずは受付をまとめ、重大度、担当割当、通知、履歴を備えた最小構成から始めます。そのうえで、無料枠や小規模プランで運用を試しながら、必要な機能を増やします。
ITSMとセキュリティインシデント対応は一つにまとめるべきですか?
一つにまとめる形のほかに、分けて扱う構成も現実的です。たとえば、通常の障害はITSMのインシデント管理で扱い、セキュリティ案件は専門の対応基盤で証拠保全や権限分離を行いながら、共通の識別子で関連付けます。
組織の責任者や報告義務、扱う情報、既存の監視・検知基盤を確かめたうえで、分離と連携の境界を決めます。
導入前に最初に整理すべきことは何ですか?
まず、過去3〜6か月の障害や問い合わせを集めます。そのうえで、受付経路、影響サービス、重大度、初動時間、復旧時間を整理し、再発状況や夜間対応も見ます。
担当者は、最初に改善するKPIとMUST要件を決めます。監視、チャット、開発チケット、認証基盤との連携には、優先順位を付けます。
製品を比べるのは、この整理が終わってからにします。そうすると、過剰な機能や不要な開発を選びにくくなります。
導入と独自開発はどちらを選ぶべきですか?
標準的な受付、通知、SLA、レポートで足りる場合は、SaaSやパッケージを設定して使う方法が適しています。
独自の承認、顧客向け画面、複数組織の権限、既存基幹システムとの深い連携が事業上不可欠な場合は、追加開発やスクラッチを検討します。
まず標準機能で小さく始め、差分が明確になってから独自開発へ進む段階導入が、費用と失敗リスクのバランスを取りやすい方法です。
まとめ
インシデント管理システムは、検知から受付、重大度判定、担当者の招集、協働、復旧までをつなぐ運用基盤です。さらに、振り返りと再発防止まで扱います。
機能数だけでなく、自社のサービスや運用時間、体制、セキュリティ要件に合う流れを作れるかが重要です。
導入前に決める三つのこと
第一に、インシデントの対象と、重大度ごとに呼ぶ人を決めます。
第二に、監視やチャット、開発チケット、構成情報、ナレッジを、どの順番でつなぐかを決めます。
第三に、MTTA、MTTR、SLA達成率、アラート重複率、再発率などの効果指標を決めます。
費用と選定の注意点
費用は、無料枠や本体料金だけで決めず、初期設定、連携、通知、教育、保守、移行を含むTCOで比べます。
- 契約終了時の移行:データを取り出し、次の環境へ移す費用も含めます。
- ベンダー確認:標準機能と追加開発の境界、重大障害時の支援、セキュリティ、データ出力を確認します。
- 小規模な試行:実際の障害シナリオで試し、現場が使えるかを確かめてから、対象を広げます。
製品や運用を継続して改善するには、対象を段階的に広げていきます。
▼関連記事一覧
・インシデント管理システム開発の進め方/やり方/流れや方法/手法/工程/手順
・インシデント管理システム開発でおすすめの開発会社/ベンダー6選と選び方
・インシデント管理システム開発の見積相場や費用/コスト/値段について
・インシデント管理システム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。