
インシデント管理システム開発は、要件整理、製品選定、設計、テスト、段階稼働、定着の順に進めると、受付から復旧と再発防止までをつなげられます。
各フェーズの中身と費用相場、見積もりの取り方は、この記事で扱います。全体像は、インシデント管理システム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・インシデント管理システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
インシデント管理システム開発の全体像
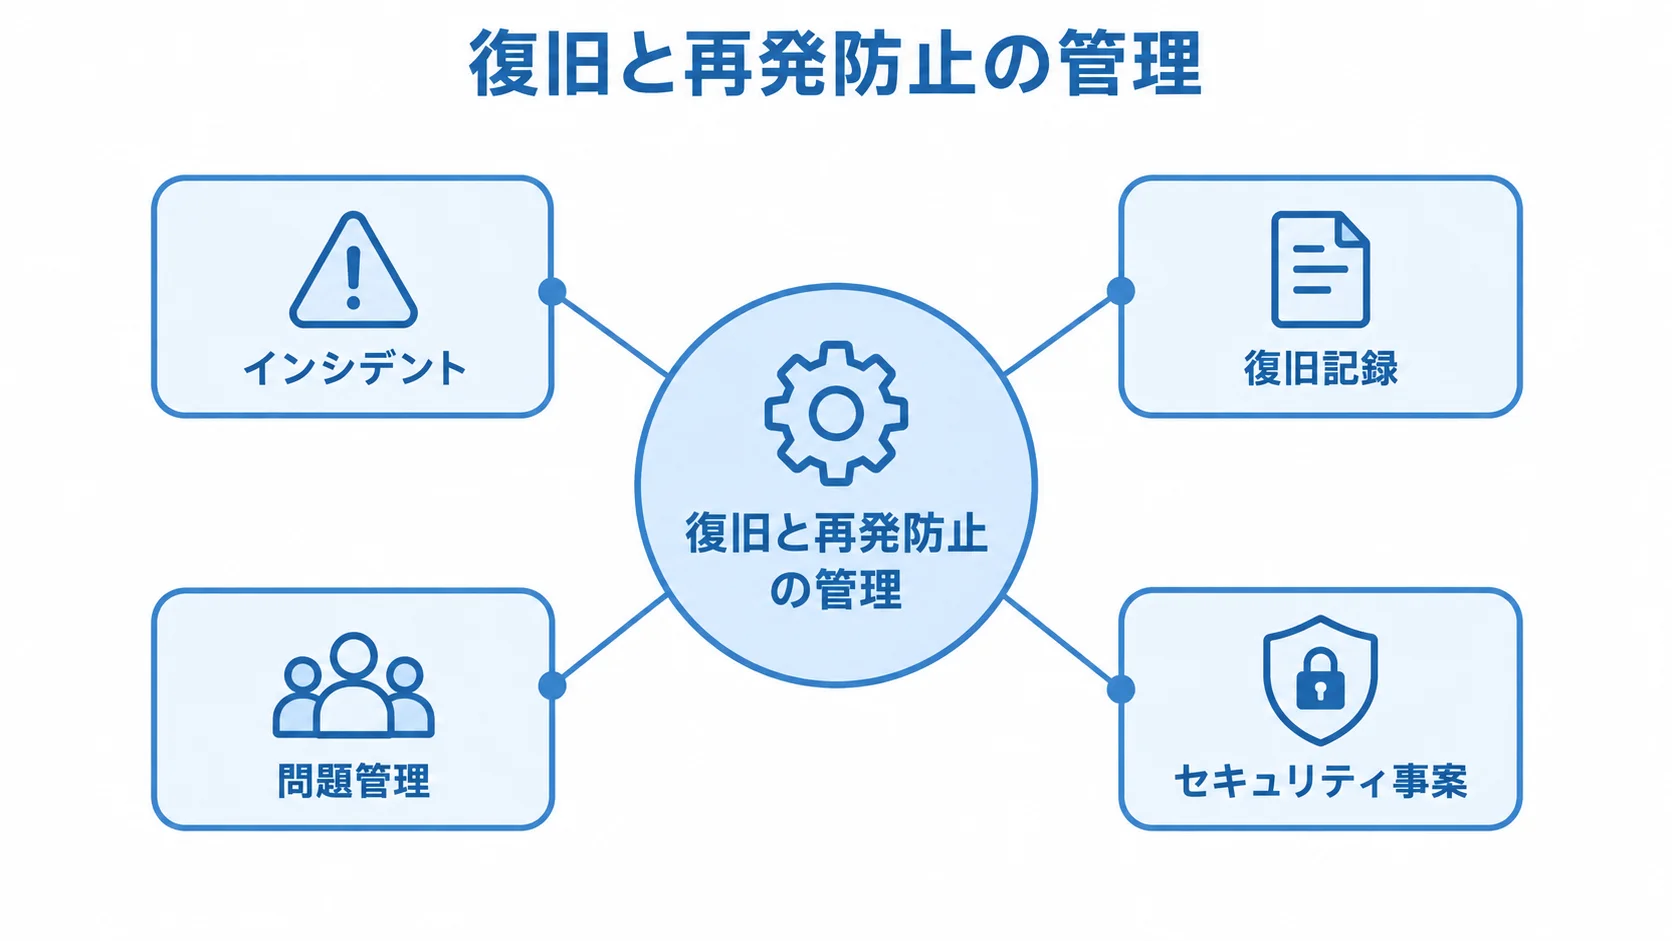
インシデント管理の目的は、原因の究明より通常サービスの早期復旧を優先することです。これにより、利用者と事業への影響を小さくします。
原因の分析は問題管理へつなぎ、リリースや設定変更の統制は変更管理で扱います。こうした分担により、復旧と再発防止を分けて進められます。
インシデント管理と問題管理を分けた設計
障害対応では、通常サービスを妨げる事象の復旧と、根本原因の分析を分けて扱います。
- インシデント:停止、性能劣化、エラー、IT問い合わせなどを受け付けます。
- 復旧記録:影響度と緊急度の判定、担当への割り当て、経過と判断の記録を行います。
- 問題管理:再発原因と恒久対策を扱い、関連チケットを分けて紐付けます。
- セキュリティ事案:受付・重大度・エスカレーションに加え、証拠保全や報告も含みます。
1件のインシデント票に原因究明まで詰め込むと、サービスの復旧が遅れることがあります。特にセキュリティ事案では、法務・広報への連絡、外部機関への報告、アクセス遮断も必要になります。
同じ画面で扱うか、SOC・SIEM・SOARの側で別管理するかは、要件整理で決めてください。
受付・通知・復旧・振り返りのつながり
受付から振り返りまでをつなぐ機能は、運用時間や連携先に応じて決めます。まず、必要な機能を一覧にします。
- 受付と記録:メール、Webフォーム、チャット、電話、監視ツール、APIに対応します。
- 割当と計測:カテゴリ、影響範囲、緊急度、優先度、担当を決め、自動振り分けとSLAを管理します。
- 24時間運用:オンコール表、電話・SMS・プッシュ通知、段階的なエスカレーションを備えます。
- 重大障害対応:重大インシデント用の指揮系統を用意します。
復旧後は、監視アラート、チケット、SlackやMicrosoft Teamsの会話を関連付けます。さらに、ランブックや既知エラー、構成情報も結び付けます。こうして残した記録は、ポストインシデントレビューに再利用できます。
運用の成果は、チケット数に加えて指標で確かめます。指標には、MTTA、MTTR、重大障害のSLA達成率、アラート重複率、再発率、ナレッジによる自己解決率があります。
運用条件に合わせた方式の選び方
方式を絞るときは、規模より運用条件を基準に考えます。
- 受付の集約:情シスが数名で受付経路をまとめたい場合、Jira Service ManagementなどのSaaSが現実的です。
- オンコール重視:大規模な開発組織でSRE運用を重視するなら、PagerDutyのような通知・エスカレーションに強いサービスも検討します。
- 複雑な運用:複数拠点、厳格な監査、CMDB、24時間365日運用にはITSMパッケージや導入SIerも比較します。
自社開発では、独自画面や業務ルールを実装できます。一方で、通知、権限、監査ログの運用を継続して担う必要があります。さらに、バックアップ、脆弱性対応、代替連絡手段も、自社で担うことになります。
まず標準SaaSとAPI連携で足りる範囲を確かめ、そのうえで追加開発が妥当かを判断してください。
インシデント管理システム開発の進め方と6フェーズ
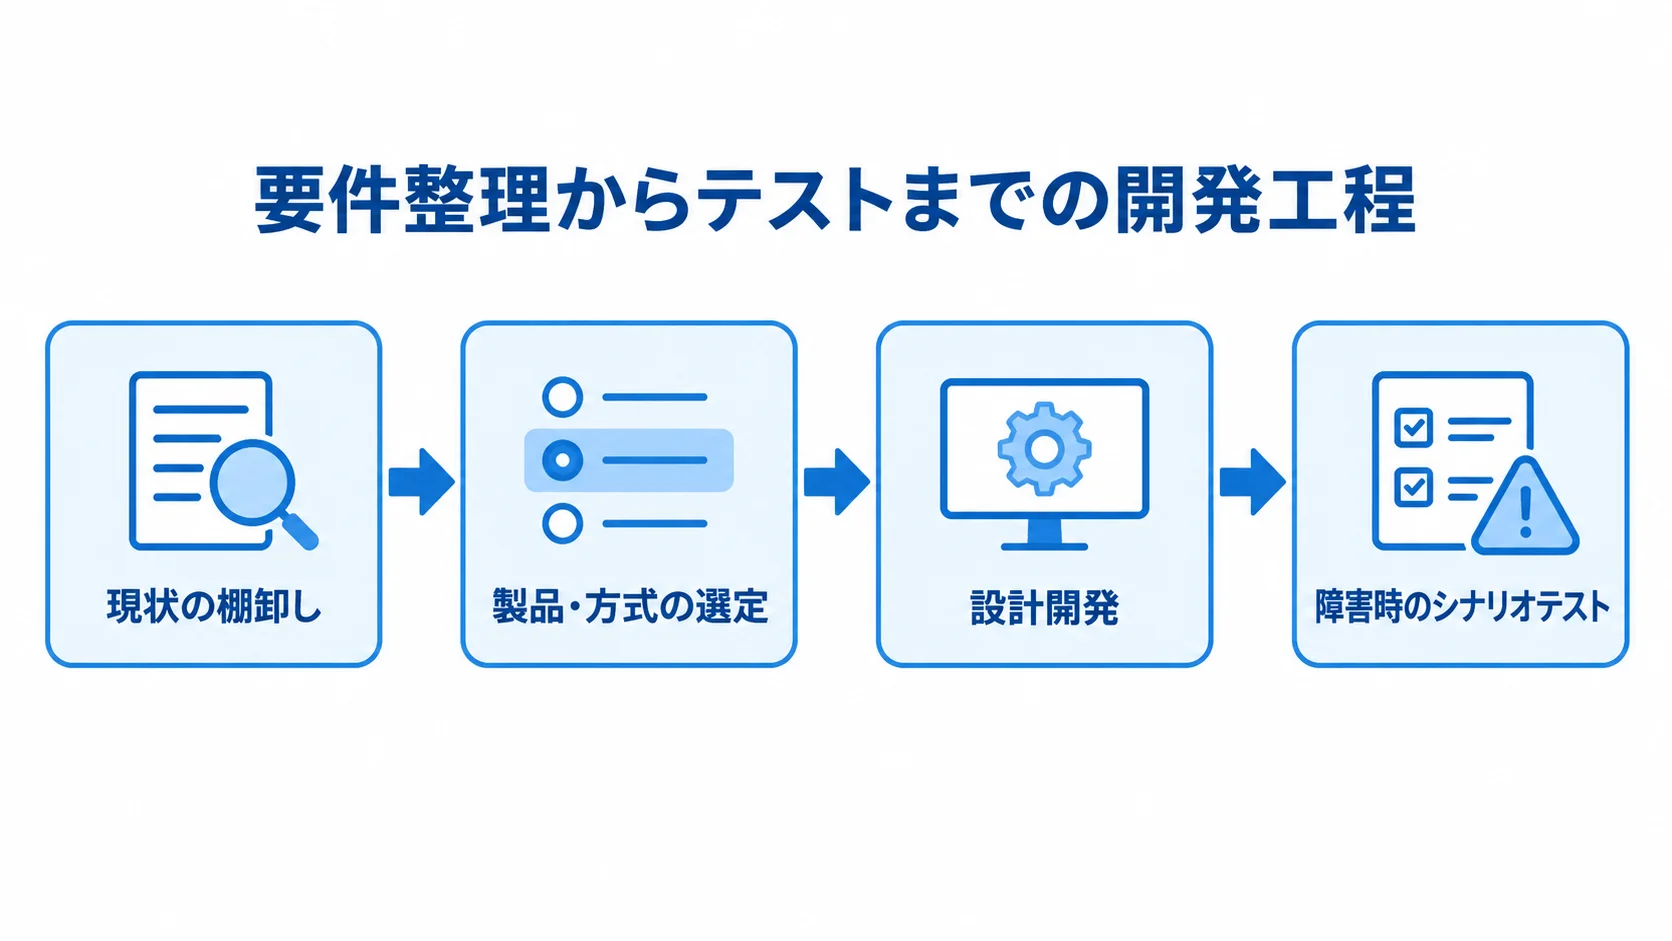
製品や開発会社を選ぶ前に、過去の障害と担当者の動きを整理しておきます。各フェーズに完了条件を置いておくと、経営層、情シス、開発、現場、ベンダーが同じ基準で進捗を判断できます。
フェーズ1:障害対応の現状と目標をそろえる要件整理
要件整理では、まず現状の記録と重大度を定め、次に初回範囲と完了条件を決めます。
- 現状の洗い出し:直近3〜6か月の障害、問い合わせ、監視アラートを一覧にします。
- 重大度と優先度:影響範囲と緊急度を組み合わせて、判定基準を決めます。
- 初回範囲:MUSTとWANTを分け、初回導入の対象を絞ります。
- 完了条件:対象、責任者、復旧目標、事案の切り分け、MUSTの承認を定めます。
受付経路、影響サービス、発生・認知・復旧の時間を集めます。さらに、担当、エスカレーション、再発状況も拾い出します。記録がなければ、メール、チャット、監視ログ、リリース履歴を突き合わせ、それでも数字が得られない点は課題として扱います。
重大度は、1を顧客向け主要機能の停止、2を一部顧客への大きな影響、3を回避策のある限定的な障害などと定義します。
MUSTには、受付をまとめる仕組み、担当割り当て、通知、履歴、SLA、検索を置きます。一方、WANTには、AI要約、自動修復、公開ステータスページ、高度な予測などを置きます。
初回範囲が決まらないまま製品比較を始めると、機能の多さだけで選ぶことになります。
完了条件には、対象サービス一覧、重大度表、責任者、インシデントコマンダーを含めます。加えて、復旧目標、セキュリティ事案との切り分け、初回MUST項目の承認も必要です。
フェーズ2:運用との適合性で選ぶ製品・方式
候補は、SaaSやITSMパッケージ、オンプレミスなどの方式に分けて比べます。自社開発や複数サービスの組み合わせも候補に加えます。比較表には、次の項目を入れます。
- 受付と対応:受付チャネル、監視連携、重複排除、担当の自動割当、オンコール、エスカレーション。
- 管理機能:SLA、ナレッジ、CMDB、問題・変更管理、PIR。
- 連携と統制:API、SSO、MFA、監査ログ、データエクスポート。
標準機能、追加オプション、個別開発、運用代行を分けて、各社に回答してもらいます。
デモでは、監視アラートをどの項目に変換するか、同じ原因の通知をどうまとめるかを確かめます。
担当者が不在のとき、何段階で誰へ通知するかも、実際に確かめてください。
価格のほか、解約時のデータ返却、API制限、保管地域、障害時の連絡手段も比べます。
AWSは、AWS Systems Manager Incident Managerを2025年11月7日から新規顧客へ提供しないと案内しています。さらに、新機能も追加されません(出典:AWS公式「Incident Manager」、2026年確認)。
現在の機能だけでなく、サービス統合や提供終了時の移行方法も確認してください。
フェーズ3:受付データ・通知・権限・連携の設計開発
設計では、票に何を記録するか、通知をどの経路で送るかを決めます。連携先と権限も、この段階で定めます。
- 票の項目:発生日時、検知元、影響サービス・範囲、重大度、優先度、担当グループを記録します。
- 通知:重大度1は電話・SMS、2はプッシュ・チャット、3はキューを使い分けます。
- 連携:監視、ログ、SlackやMicrosoft Teams、メール、SSO・SCIMなどの優先順位を付けます。
- APIと権限:同期仕様を定め、権限を絞り、変更を監査ログに残します。
票には、コマンダー、現在の状況、暫定対応、顧客告知、復旧日時の欄を持たせます。
関連する問題、変更、構成情報も記録します。集計用の選択項目と、判断理由を書く記述欄を組み合わせます。
監視・ログ・EDRのイベント相関や重複排除で、ノイズを抑えます。そのうえで、未達時の再送、当番不在時の代替担当、通信障害時の電話連絡を、異常系として確認します。
連携先には、CMDB、ナレッジ、開発チケット、ステータスページも含まれます。APIでは、認証と送受信項目、同期方向を定めます。さらに、再送、重複判定、保留データの扱いも決めます。
重大度の変更や復旧宣言を誰が行ったかは、監査ログで追えるようにします。
フェーズ4:障害時のシナリオを通すテスト
テストでは、チケットの登録と終了に加えて、監視の発報からPIR作成まで、次の業務シナリオを一通り通します。
- 監視アラートを受け、重複排除と優先度判定を行う。
- 担当割当とオンコール通知を行い、未応答ならエスカレーションする。
- チャットで協働し、復旧宣言と顧客告知を行う。
- PIRを作成し、記録を振り返りに利用する。
異常系には、大量の同一イベントや担当者の未設定、夜間の当番交代を含めます。さらに、SMSやメールの遅延、SSO停止、API連携先の停止も想定します。
重大度1の場合は、チャットが使えないときの電話会議、ステータスページの更新、経営層・顧客・委託先への連絡経路も確かめます。
テストの結果には、期待と実際の結果、証跡、残課題、期限、リリース可否の判定者を記録します。MTTAとMTTRは、導入前と比べられる測定方法に固定しておきます。
テストデータに個人情報や実顧客の情報を使うなら、マスキングと削除の手順も定めてください。
フェーズ5:パイロット運用から始める段階稼働
段階稼働では、まず試行部門で使い始め、そこから対象を広げていきます。その間に、切替条件と利用の準備を整えます。
- 展開順:情シス・開発から代表部門、24時間運用・規制対象部門へ広げます。
- 稼働判定:旧経路を閉じる時期、データ移行範囲、切り戻し条件を決めます。
- 利用案内:登録対象、緊急連絡先、進捗確認先を知らせ、管理者操作を演習します。
- 初週確認:登録、分類漏れ、通知未達、未応答、重複、認知時間、問い合わせを毎日見ます。
全社一斉に切り替えると、重大度の解釈や通知量の問題が広がります。そのため、障害対応の頻度が高く協力を得やすい部門を、試行先に選びます。
管理者は、重大度や担当の変更、当番の交代、顧客告知、監査ログの確認を演習しておきます。
「項目が多い」「通知が多い」「担当が分からない」といった声は、利用者側の問題として片づけず、設計改善の材料にします。
フェーズ6:KPIと演習による運用の定着
定着させるには、役割、KPIの確認、演習、AI利用の統制を、運用の仕組みに組み込みます。
- 役割:管理者、サービスオーナー、コマンダー、当番、広報、問題管理担当を定めます。
- 月次KPI:重大度別件数、MTTA、MTTR、SLA、エスカレーション、重複率、未完了PIRを見ます。
- 演習:四半期ごとに、重大インシデントを想定した訓練を行います。
- AI活用:要約、分類、類似事例、PIR下書きから始め、承認と監査を設けます。
AIが出す重大度や手順の提案を無条件に採用すると、誤判定が影響を広げる可能性があります。
そのため、自動化の前に、人の承認箇所、誤判定時の連絡先、入力データの保管場所、監査ログを決めておきます。
Atlassianは2025年7月、iFoodの事例を公開しました。Jira Service Managementへの移行後、応答時間は74分から17分になりました。解決時間は150分から55分と報告されています。
(出典:Atlassian「How iFood accelerated incident resolution with Jira Service Management」、2025年公開)
これはベンダーが紹介する個別事例のため、同じ効果を断定できません。Slackの会話と開発チケットを分断せず、アラートから対応記録まで統合する検討材料として扱います。
IPAは2026年3月、「中小企業の情報セキュリティ対策ガイドライン第4.0版」を公開しました。経営者向けの指針、現場向けの手順、インシデント対応の手引きを掲載しています。
(出典:IPA「中小企業の情報セキュリティ対策ガイドライン」、2026年確認)
ツールを入れて終わりにせず、バックアップ、連絡先、復旧判断、サプライチェーン対応を含む事業継続訓練へつなげます。
インシデント管理システムの費用相場とコストの内訳
費用は、ライセンス数やアラート量、通知方法、連携先によって変わります。CMDBの規模、移行、教育、24時間保守も、費用を動かす要因です。
専用の国内統計は限られるため、ここに示すのは、類似業務システムの公開目安に監視・通知・SSO・CMDBの要件を加味した推定です。
公開定価と推定の開発費は分けて見てください。そのうえで、要件を添えて個別見積もりを取ります。
SaaSのライセンス費と標準導入費の目安
主要SaaSの公開料金と、標準導入の推定費用を分けて確認します。
- Atlassian:3エージェントまで無料。Standardは1エージェント月額20ドル、Premiumは1エージェント月額51.42ドルです。
- PagerDuty:5ユーザーまで無料。年契約のProfessionalは1ユーザー月額21ドル、Businessは同41ドルです。
- 標準導入:SaaS設定・運用設計は初期30万〜150万円、2〜6週間が推定レンジです。
Atlassianの料金は1エージェントあたりで、Enterpriseは個別見積もりです。
PremiumにはAIOps、リアルタイム監視、インシデント・問題・変更管理が含まれます。
(出典:Atlassian公式Service Collection料金表、2026年確認)
1ドル=150円で換算すると、Standardは1人月約3,000円、Premiumは約7,700円です。ただし、為替、契約期間、税、追加機能によって変わる予算目安です。
PagerDutyの料金は年契約表示です(出典:PagerDuty公式Incident Management料金表、2026年確認)。課金の対象が対応者か通知先全員かは、製品ごとに確かめてください。
受付フォーム、重大度、キュー、SLA、通知、権限設定は短期間で済みやすい一方で、現状分析や部門合意、教育を含めると上振れします。そのため、ライセンス、支援、連携は分けて見積もります。
監視・API・SSO連携を含む導入費の目安
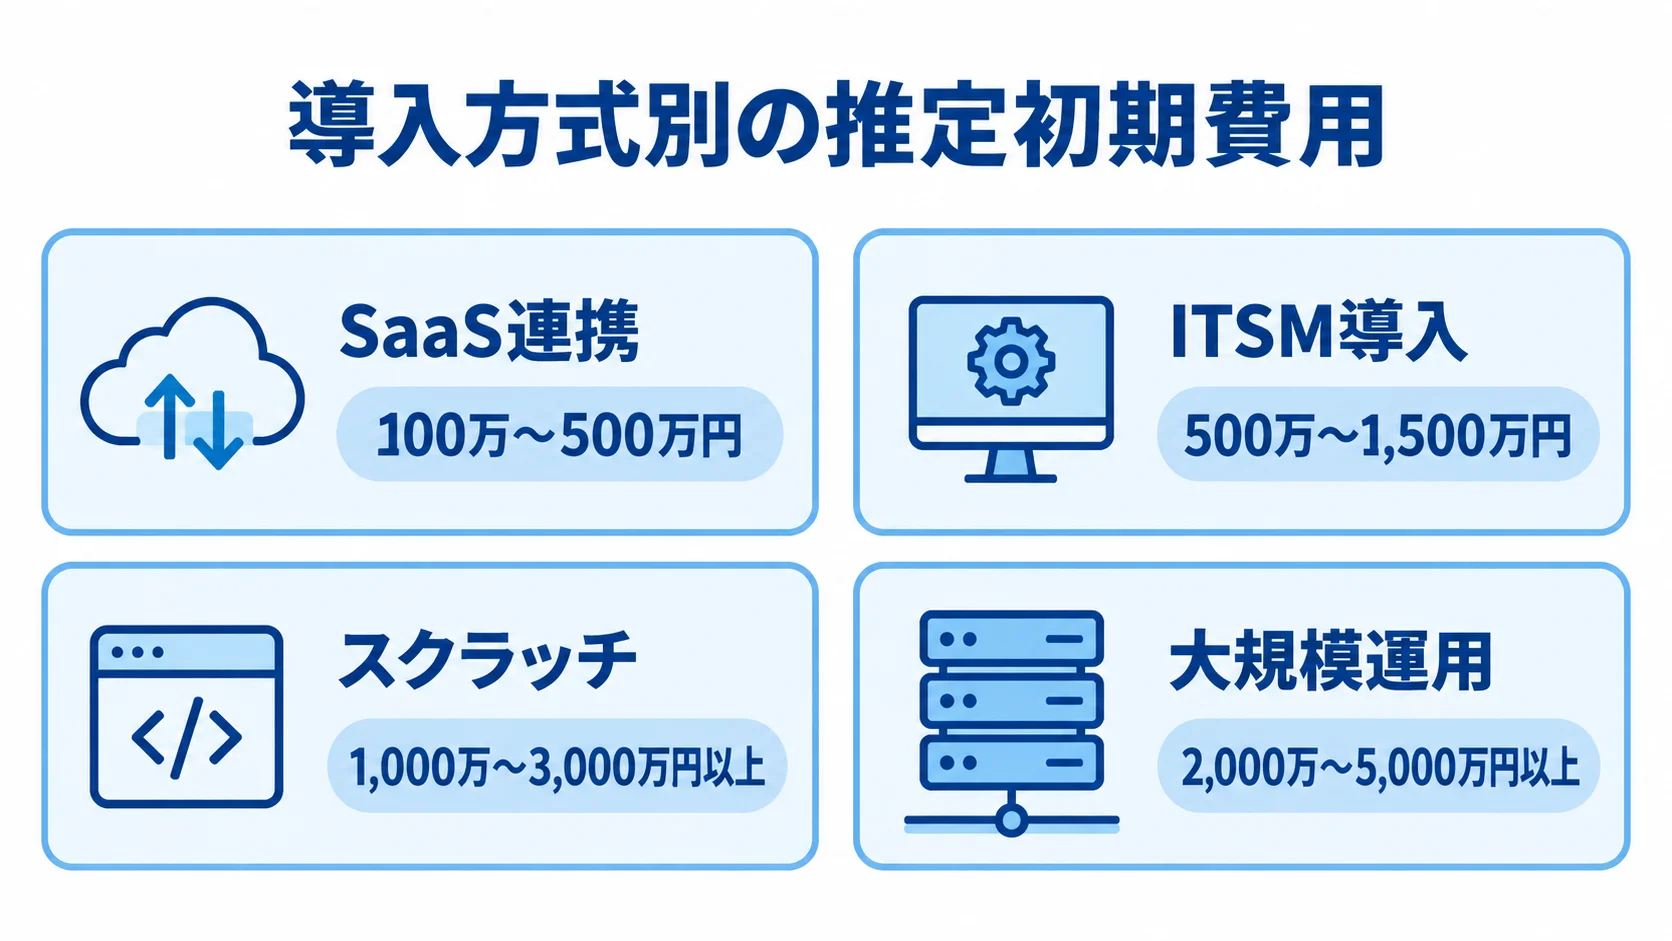
連携導入、ITSM導入、スクラッチ開発では、範囲に応じて費用と期間が異なります。
- SaaS連携:監視、API、Slack・Teams、SSOは初期100万〜500万円、1〜3か月程度です。
- ITSM導入:CMDB、教育、移行などを含む場合、初期500万〜1,500万円、3〜6か月程度です。
- スクラッチ:独自画面や連携を含む小〜中規模で1,000万〜3,000万円以上、6〜12か月程度です。
- 大規模運用:24時間365日運用や冗長化、運用委託を含めると2,000万〜5,000万円以上の可能性があります。
重複排除、自動割当、オンコール、認証、通知の異常系、テストは、単純なWebhook連携より工数がかかります。加えて、API制限や既存データの品質も費用を左右します。
ITSMの費用は、CMDBとサービスカタログを含む場合の目安です。そのほか、目安に含めるのは次の項目です。
- 問題・変更管理
- レポート
- 教育
- データ移行
CMDBは登録数を増やすだけでなく、重要サービスと依存関係を正しく保つ運用が必要です。入力の責任者を決めないまま作ると、稼働後に古い情報が残ります。
スクラッチの費用は、独自画面、ワークフロー、顧客向けステータスページ、高可用性、複数拠点、SOC・SIEM連携まで開発する場合の目安です。
大規模運用を含め、いずれも公開定価ではなく、要件から算出した推定です。
本体料金ではなくTCOでの比較
TCOでは、初期費用、利用量に応じた料金、継続運用の工数を合わせて比べます。CMDBオブジェクトやセキュリティレビューも、総額に含めます。
- 初期・基盤:設定、ライセンス、監視・ログ、SSO、CMDB、移行、教育を含めます。
- 継続費用:通知、電話・SMS、AI、マニュアル、保守、委託、レビュー、バックアップを計上します。
- 運用工数:KPI、PIR、当番表、ナレッジ整備の担当時間を見積もります。
無料プランであっても、将来のエージェント数とアラート量を前提に、1年目と3年目を試算します。メールだけなら安くても、夜間の電話やSMS、ステータスページ、外部顧客への通知を加えると従量費が変わります。
障害時の代替手段も計上します。運用の担当工数が確保できないと、導入後の改善が止まってしまいます。
インシデント管理システムの見積もりを取る際のポイント
相見積もりでは、同じRFPと障害シナリオを各社に渡します。そのうえで、標準機能の範囲、運用担当、稼働後の内製化を、価格と合わせて比べます。
一式見積もりでも、連携、移行、テスト、教育、通知、保守が別料金になる場合があります。そのため、どの項目を含み、どれを含まないかを確かめてください。
RFPに記載する利用者・対象サービス・障害シナリオ
RFPには、利用者数、対応者数、対象サービス数、月間のインシデントとアラートの件数を記します。さらに、ピーク時の通知量、稼働時間、対象地域、既存環境、保存したい過去データも用意します。
- 規模:利用者・対応者、サービス、月間件数、ピーク通知量、稼働時間、対象地域。
- 障害シナリオ:重大度1の顧客影響、夜間不在、大量アラート、SSO・API停止を記載します。
- 非機能要件:可用性、復旧目標、ログ保存期間、監査、権限、MFA、保管地域、暗号化を定めます。
既存の監視、チャット、チケット、認証基盤と保存対象データも記します。
脆弱性対応、障害時の連絡先、終了時のデータ返却も確認します。加えて、休日や夜間に管理者が使えるか、通信経路が一つに依存しないかも確かめます。
製品ベンダーと導入・運用会社を分けた評価
製品提供会社と、要件整理、設定、連携、移行、教育、保守を担う会社は役割が異なります。標準機能に詳しくても、既存の監視や認証を設計できるとは限りません。
- 会社の実績:対応製品、ITIL・ITSMの実績、監視連携、CMDBの経験。
- 運用支援:24時間運用、内製化支援、責任分界、契約後の保守窓口を質問します。
- 障害対応力:サンプル障害のデモで、重大度判定、招集、顧客公開情報、復旧後のレポートを確認します。
契約前に確認する追加費用と運用リスク
契約前には、費用と責任の範囲が後から変わりうる点を確かめておきます。
- 追加課金:ユーザー、アラート、電話・SMS、AI、CMDB、容量、API、環境、データ移行件数の増加条件。
- サービス変更:価格改定、機能統合、提供終了、保管地域変更の通知期間と移行支援。
- 障害時の分担:一次切り分け、ベンダー問合せ、復旧、原因分析、再発防止、顧客説明。
納品時は、設定、連携仕様、権限、テスト証跡、運用手順、連絡網を受け取ります。加えて、バックアップと復旧の手順、管理者教育の記録も受け取ります。
インシデント管理システム開発でよくある質問
導入前には、対象範囲、SaaSの適否、費用、現場での利用について疑問が生じやすいものです。選定の際によく挙がる質問に、順に答えます。
インシデント管理システムはSaaSで十分ですか?
受付をまとめる、担当を割り当てる、通知、履歴、基本的なSLAが目的なら、SaaSの標準機能で始められるケースが多いです。
24時間365日の当番や、監視・CMDB・開発基盤との深い連携が必要なら、方式を比べます。厳格な保管要件や独自のワークフローがある場合も、追加設定、パッケージ、スクラッチの費用と運用責任を比べる判断材料になります。
インシデント管理システムの開発費はいくらですか?
標準SaaS設定・運用設計は初期30万〜150万円、監視・API・SSO連携を含む導入は100万〜500万円が推定レンジです。
ITSMとCMDB・教育を含む導入は500万〜1,500万円です。独自開発、高可用性、24時間運用は1,000万〜3,000万円以上の可能性があります。
これらは、専用の公的統計や一律の価格ではなく、要件を加味した目安です。
Slackや既存のチケット管理と二重管理になりませんか?
正式なインシデント記録先を一つ決め、役割を分けます。チャットは協働、監視は検知、開発チケットは修正、ナレッジは再利用に使います。
チャットから票を自動で作成し、状態や重要な更新を同期すれば、現場の操作を増やさずに履歴を残せます。そのうえで、どの画面を正とするかは導入前に合意しておきます。
AIでインシデント対応を自動化しても安全ですか?
AIは、アラートの要約や類似事例の検索、担当候補の提示、PIR下書きなど、判断を助ける使い方から始めると、安全性を確かめやすくなります。
通知の停止、設定変更、サービスの再起動は、対象を限定します。人の承認、ロールバック、監査ログ、誤判定時の連絡先を用意したうえで、段階的に導入します。
導入効果はどのKPIで測ればよいですか?
MTTA、MTTR、重大障害のSLA達成率、アラート重複率、未応答率、再発率を、導入前後で比べます。
自己解決率、PIR完了率、重大度の再分類率、顧客への初回告知時間、担当者の入力時間も見ると、復旧の速さ以外の運用負荷も評価できます。
まとめ
インシデント管理システムは、監視から受付、重大度判定、担当割当、オンコール、復旧、告知までを、問題・変更管理やPIRとつなぐ運用基盤です。
開発は、要件整理、選定、設計開発、テスト、稼働、定着の6段階に分け、各段階の完了条件を決めます。
最初に整理する受付経路と重大度
製品を選ぶ前に、過去3〜6か月の障害と問い合わせを一覧にします。そのうえで、影響サービス、認知時刻、復旧判断を確認します。
MUSTとWANTを分けたうえで、入力の手間を増やさずに正式な記録を残す受付の流れを設計します。費用は、連携、通知、移行、教育、保守、人件費を含むTCOで比べます。
稼働後のKPIと演習までを含めた計画
導入効果は、MTTA、MTTR、SLA達成率、重複アラート、再発率、PIR完了率などで確かめます。
通知の多さや二重管理が起きたときは、重大度、受付項目、連携、自動化、役割分担を見直します。小さく稼働させ、定例レビューと演習で改善を続けます。
▼全体ガイドの記事
・インシデント管理システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。