
ITシステムのアップデート対応は地味で後回しにされがちですが、失敗すると深刻なインシデントや業務停止に直結します。
代表的な失敗は、パッチの放置、検証不足での適用、サポート終了への駆け込み、外部SaaSの追従漏れです。全体像はITシステムアップデート対応の完全ガイドでご確認ください。
▼全体ガイドの記事
・ITシステムアップデート対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
パッチ放置で脆弱性を突かれる失敗
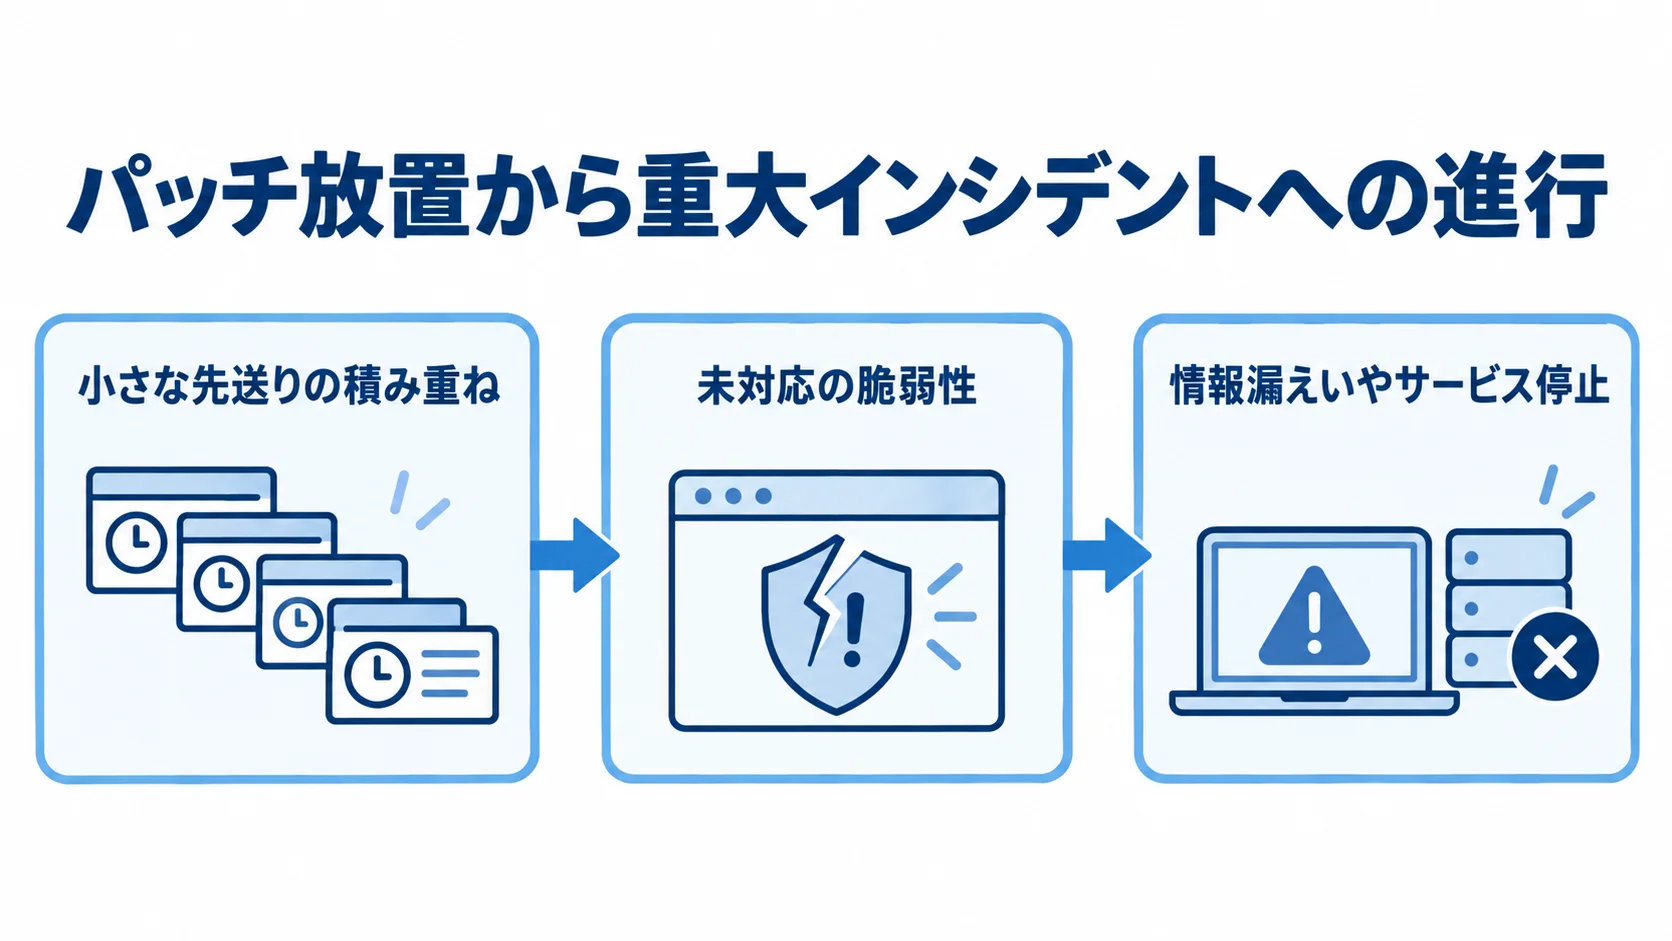
アップデート対応でもっとも代償の大きい失敗は、必要なパッチを当てずに放置し、既知の脆弱性を突かれるパターンです。攻撃の多くは、修正パッチがすでに公開されているのに当てられていない脆弱性を狙います。
「動いているから触りたくない」という心理が更新を先送りさせ、その隙を攻撃者が突きます。この問題は、技術力よりも運用の規律に関わります。
先送りの正当化による脆弱性の蓄積
パッチ放置の失敗は、一度に起きるのではなく、小さな先送りの積み重ねで進みます。「今は忙しい」「動いているから後で」という判断が毎回正当化され、当てていない脆弱性が少しずつ溜まっていきます。
やがて、いくつもの未対応の脆弱性を抱えた無防備なシステムができ上がります。そして、そのどれか一つが突かれた瞬間に、情報漏えいやサービス停止という重大インシデントが現実になります。
この失敗を防ぐ鍵は、適用要否を担当者の感覚に任せず、明文化された基準で判断することです。
たとえば、脆弱性の深刻度ごとに期限を決めておけば、「触りたくない」という心理に任せた先送りを防げます。基準を決めたら、それを規律として回し続けることが、放置という失敗への最大の防御になります。
- 深刻度ごとの期限:脆弱性の深刻度に応じた、適用までの期限
- 重大な脆弱性への初動:初報応答15分、暫定対応4時間以内(SLA実値の例、出典:ripla)
従量契約で費用を惜しんで放置する罠
費用の面からパッチ放置に陥ることもあります。アップデート対応を作業量に応じて払う従量課金で契約していると、「対応するとお金がかかる」という意識が働き、発注側が必要な更新をためらいがちになります。
コストを抑えたつもりでも、脆弱性を放置して大きなインシデントを招けば、結果的にはるかに高くつきます。これは、費用を最適化したつもりが本末転倒になる典型です。
この罠を避けるには、契約形態にかかわらず「セキュリティ上必須の更新は確実に当てる」という運用ルールを別に持つことです。費用を惜しんで脆弱性を放置する失敗は、契約設計と運用ルールの両面で防ぐべきものです。
- 従量型の場合:重大な脆弱性への対応を費用で止めない原則を契約に明記
- 月額定額型の場合:対応頻度が高いなら、追加の脆弱性も枠内で扱える契約
放置の代償は、インシデント発生後の対応費用として、何倍にもなって返ってきます。
情報漏えいやサービス停止が起きると、原因調査、復旧作業、利用者への謝罪と補償、信用の回復に費用がかかります。その額は、平時にパッチを当てる費用とは桁が違います。
目先の数万円の対応費を惜しんだ結果、数百万円規模の事後対応に追われる、というのが放置の現実です。
アップデートの費用は、将来のインシデント費用を前払いで抑える保険と捉えれば、放置という失敗を避ける助けになります。
検証不足で本番を壊すアップデート失敗
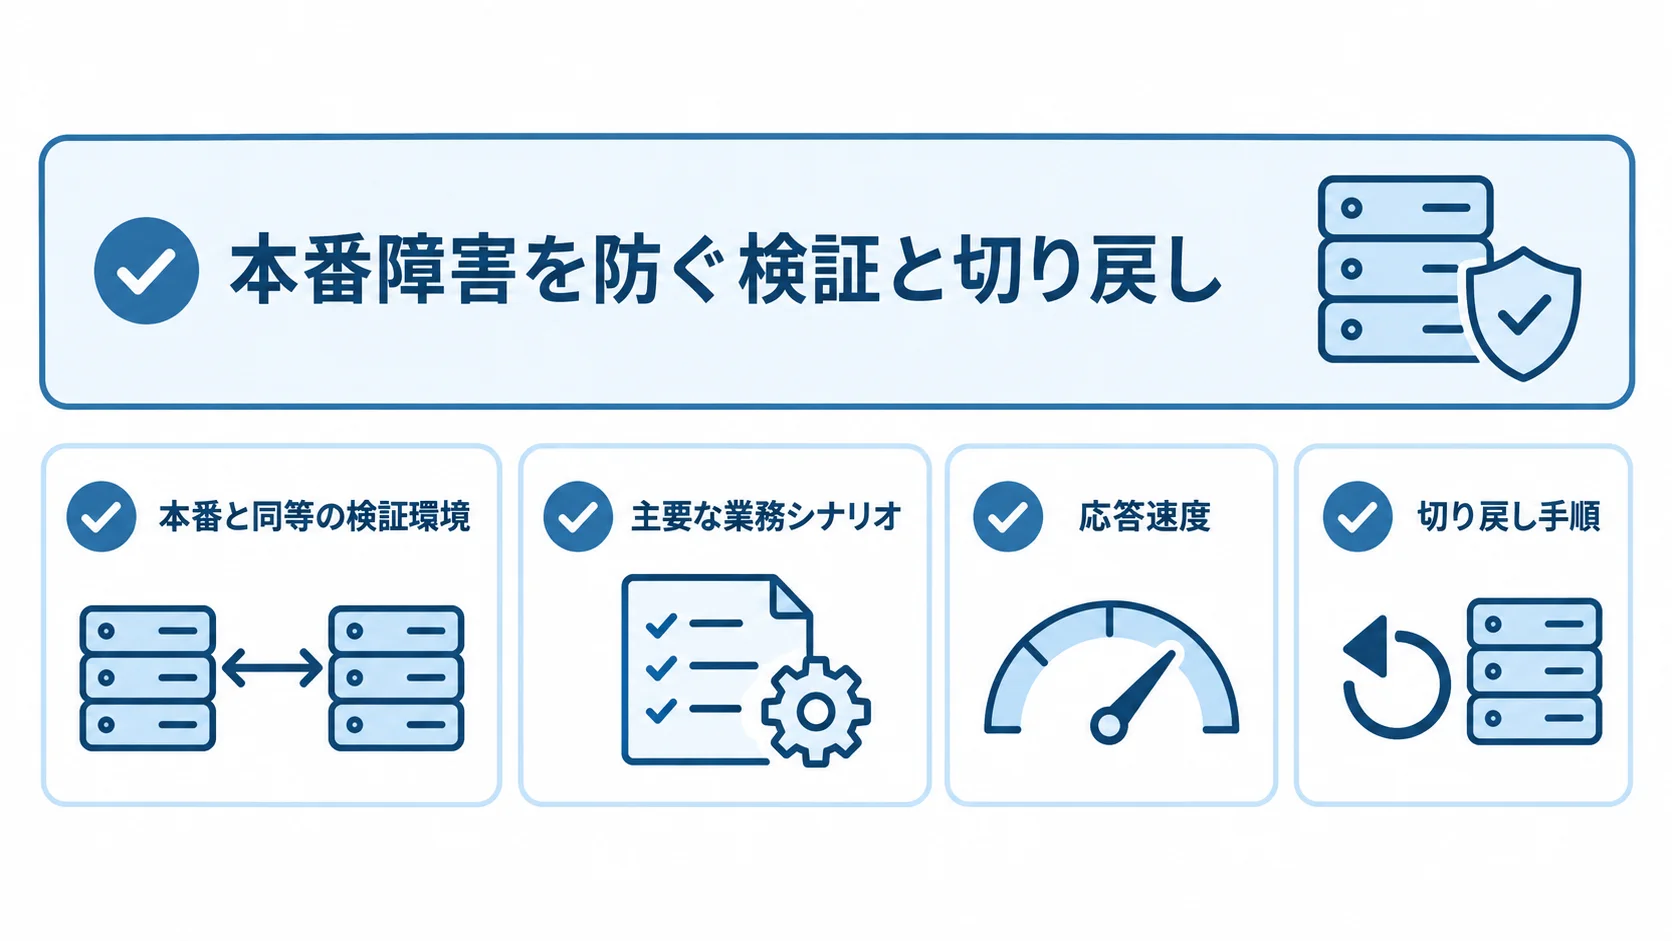
パッチ放置とは逆方向の失敗が、十分な検証をせずに更新を当てて本番システムを壊すパターンです。
アップデートは機能を変えない作業に見えますが、バージョンが上がると、これまで動いていた機能が想定外に変わったり、性能が劣化したりします。
検証を省いて本番に当てると、その変化がそのまま業務障害として表面化します。
検証環境を省いた直接適用の代償
本番と同等の検証環境で先に当てて確認する手順を省き、いきなり本番に適用すると、既存機能の破損や性能劣化が利用者の前で起きます。
OSやライブラリの更新は、依存している自社アプリの挙動に影響を及ぼすことがあります。その影響は、実際に動かしてみないと分かりません。
検証環境で主要な業務シナリオを通しておけば事前に摘めた不具合を、本番でいきなり踏んでしまう。それが、この失敗の構造です。
検証が省略されがちなのは、毎回手作業でゼロから確認すると工数がかさみ、「今回は大丈夫だろう」と省く誘惑に負けるからです。
これを防ぐには、検証を毎回の重い手作業にしない仕組みが要ります。仕組みがあれば、低コストで安全性を確認でき、検証を省く動機そのものがなくなります。
- テスト観点:検証すべき項目をまとめた一覧
- 主要シナリオの自動テスト:アップデートのたびに実行できるよう用意しておく仕組み
更新後は、性能などの非機能特性が劣化していないかの確認も欠かせません。
機能が動くことだけを見て安心すると、応答速度の低下に気づかず、利用者から「最近重い」という声が上がって初めて発覚します。
RFPで「全画面の応答3秒以内」といった処理速度の要件(RFP例、出典:ripla)を定めているなら、更新後もその水準を満たしているかをテスト観点に含めます。
機能と非機能の両面を検証して初めて、本番障害を防げる状態になります。
切り戻し手順がなく被害が拡大する失敗
本番障害が起きたときに被害を拡大させるのが、切り戻し(ロールバック)手順を用意していない失敗です。
更新後に不具合が判明しても、元の状態に戻す段取りが決まっていないと、現場は手探りで復旧を試みることになります。そのため、復旧までの時間が大幅に延び、その間も業務は止まり続けて損害が膨らみます。
切り戻し手順がないことは、別の失敗も連れてきます。「失敗しても戻せない」という恐怖が担当者のアップデートを躊躇させ、結果として前述のパッチ放置や塩漬けを招くのです。
逆に、戻し方が決まっていれば、担当者は安心して更新に踏み切れます。
リリース手順と切り戻し手順を手順書として明文化しておくことは、検証不足による障害の被害を抑え、塩漬けも防ぐ二重の効果があります。検証と切り戻しの軽視は、本番障害の入り口です。
- 切り戻し手順:元の状態に戻す段取りを、リリースとセットで用意
- 手順書:リリースと切り戻しの両方を、事前に文書として残す
サポート終了への駆け込み対応で割高になる失敗
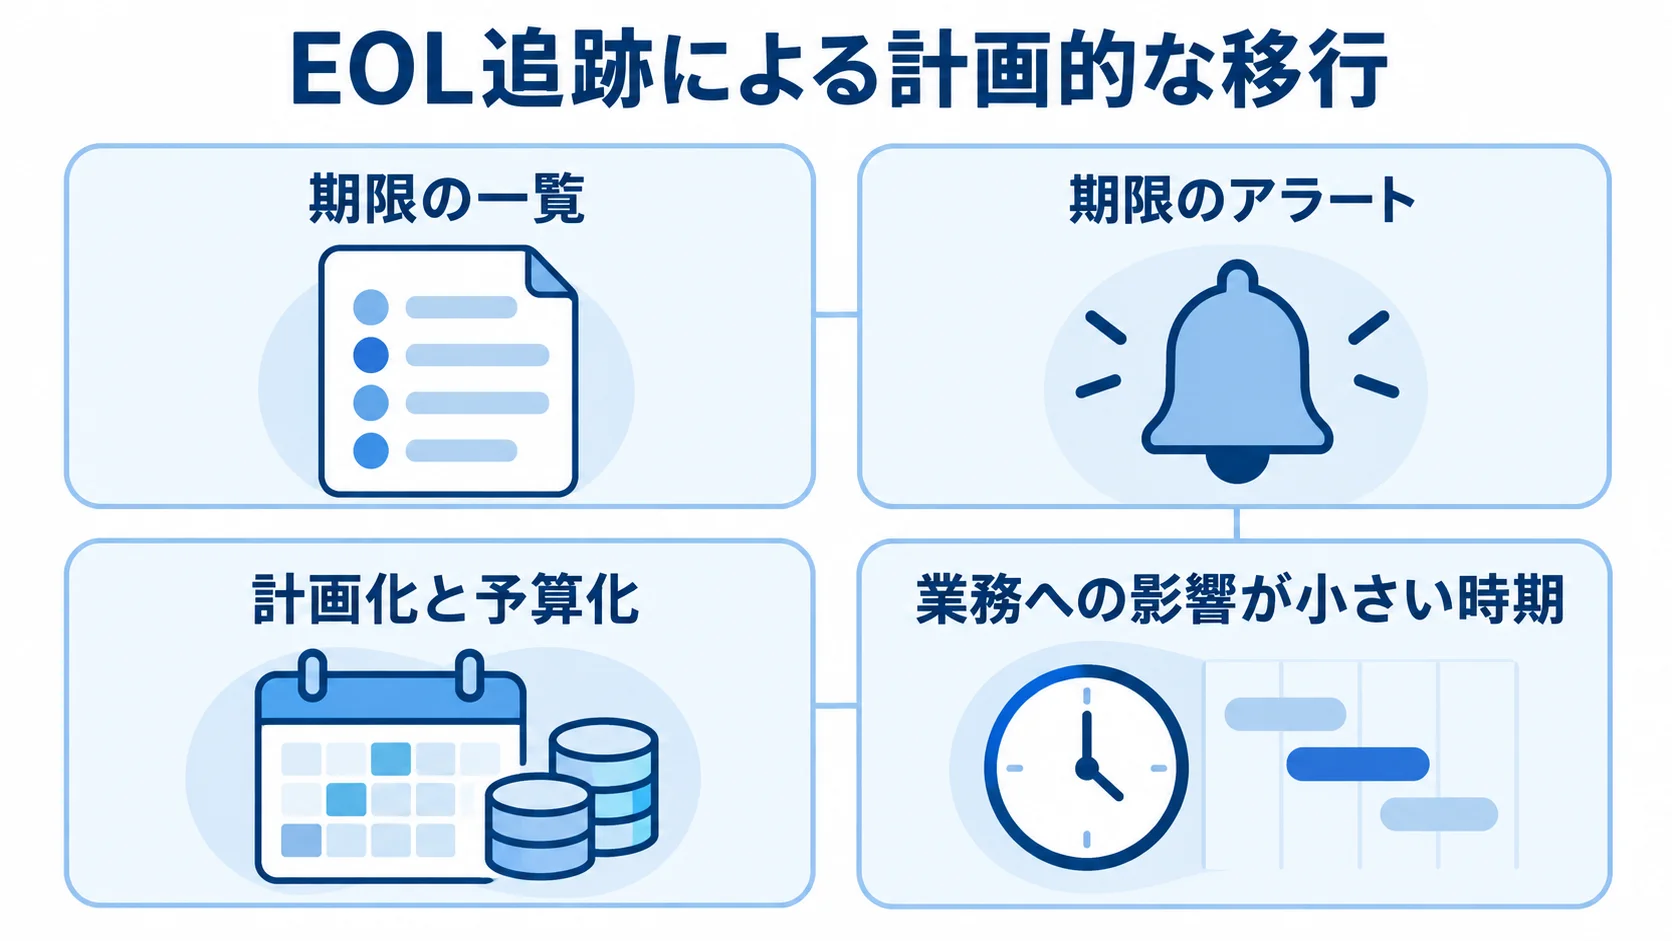
更新を計画的に行わないことで生じるのが、サポート終了(EOL)への駆け込み対応という失敗です。
たとえば、OSやデータベースのサポート期限が迫っているのに放置し、期限直前に慌てて大型のバージョンアップを実施するケースがあります。
この駆け込みは、平時に計画的に進める場合と比べて、検証も移行も短期間に詰め込むことになり、割高で危険な対応を強いられます。
EOL追跡の不在による緊急移行
駆け込み対応の根本原因は、サポート期限を追う仕組みがないことです。
各コンポーネントのEOLが見えていないと、期限が近づいていることに気づかず、ある日突然「来月でサポートが切れる」と慌てることになります。
期限が見えていれば、検証期間も予算も前もって確保できます。本来は計画的な定期保守(保守費内訳の20〜30%が目安、出典:ripla)として進められたはずの対応が、緊急の臨時対応に変わってしまうのです。
この失敗を防ぐには、期限を追う仕組みを持つことです。期限が分かっていれば、駆け込みではなく計画的に移行でき、検証も十分に取れます。
EOL追跡は、アップデートを場当たり的な緊急対応から、予算化された計画業務へ変えるうえで欠かせません。追跡の不在が、割高で危険な駆け込みを生む起点になります。
- 期限の一覧:各コンポーネントのサポート期限と外部APIの廃止予告日
- 期限のアラート:期限が近づいたものを知らせる仕組み
計画化と予算化による割高化の回避
駆け込みが割高になるのは、短期間での集中対応が要員の確保や残業を伴い、検証も圧縮されてリスクが高まるからです。
これを避けるには、EOLが見えた時点で対応を計画に組み込み、予算化しておくことです。
開発費の15〜20%が年間保守費の相場とされ(出典:ripla)、計画して予算を確保しておけば、価格交渉も検証期間の確保も余裕を持って行えます。
計画化のもう一つの利点は、利用部門との調整がしやすくなることです。停止を伴う移行作業は業務への影響が小さい時期を選んで実施したいものですが、駆け込みではその余裕がなく、繁忙期に無理な移行をする羽目になります。
- 保守費の見通し:年間保守費の相場と、大型更改の別途見積もり
- 移行の時期:業務への影響が小さい時期と、利用部門の合意
サポート切れの製品を使い続けること自体が、それ以降は脆弱性が修正されなくなるという重大なリスクを背負う点も見逃せません。
期限を過ぎると、新たな脆弱性が見つかってもパッチが提供されず、無防備なまま使い続けることになります。
だからこそEOLでは、「いつまでに対応すべきか」という時間軸の管理が欠かせません。追跡の仕組みがあれば、駆け込みとサポート切れ放置の両方を防げます。
外部SaaS仕様変更への追従漏れという失敗
モダンなIT環境のアップデート対応で、とくに見落とされやすいのが、外部SaaSの仕様変更への追従漏れという失敗です。
決済・地図・認証・通知などで外部サービスのAPIに依存しているシステムは、提供元が自社の都合と無関係に旧APIを廃止すると、ある日突然連携が止まります。
自社のOSやミドルウェアだけを見ていると、この外部起因の障害を見逃します。
旧API廃止に気づかず連携が止まる失敗
外部SaaSは事前に旧APIの廃止を予告しますが、その通知を受け取る体制がないと、廃止日を見逃して連携が突然止まります。
決済が通らない、地図が表示されない、通知が届かないといった障害は、業務や顧客に直接の損害を与えます。
しかも原因が外部にあるため、自社のシステムログを見ても異常が分かりにくく、発見と原因特定に時間がかかります。
この失敗を防ぐには、どの外部サービスのどのAPIに依存しているかを一覧にし、それぞれの変更通知を確実に受け取れる体制を作ることです。
アップデート対応の監視対象は、自社のOSやミドルウェアだけでなく、外部依存まで含めて初めて漏れがなくなります。依存先の仕様変更に伴う調査や軽微な改修(保守費内訳の10〜15%が目安、出典:ripla)を平時から対応の枠に織り込んでおくことが、追従漏れへの備えになります。
- 変更通知の受け取り:提供元の廃止予告を確実に受ける窓口と担当
- 調査と軽微改修の枠:依存先の仕様変更に備えた、平時からの保守の枠
外部起因の障害で責任が宙に浮く失敗
外部SaaSの仕様変更で連携が止まったとき、その対応が誰の責任で、どの費用で行われるのかが契約で曖昧だと、対応が宙に浮きます。「外部のせいだから自社の保守範囲外」とベンダーに言われかねません。
「追従もアップデート対応に含まれる」と扱われるのかが決まっていないと、障害が起きてから押し付け合いが始まり、復旧が遅れます。
これは、ベンダーのコントロール外の事象を、契約で切り分けていなかったことに起因する失敗です。
防ぐには、契約段階で「外部サービスの仕様変更に伴う調査・改修を保守費に含めるか、別契約とするか」を明確にしておくことです。
コントロール外の事象について、誰が一次対応し、どの費用で改修するかを定義しておけば、いざというときに迷わず動けます。
riplaはフルスクラッチ受託と国内運用保守の立場から、外部依存まで視野に入れたアップデート対応と、どこまでを誰が受け持つかを明確にした契約設計を支援しています。
外部SaaSへの追従漏れは、監視対象の狭さと責任分界の曖昧さが重なって起きる、モダンな環境特有の失敗です。
- 一次対応の担当:コントロール外の事象で、最初に動く担当者
- 改修費の出どころ:外部起因の改修を、保守費と別契約のどちらで扱うか
更新作業の属人化と記録不在の失敗
アップデート対応を続けるうえで、じわじわと効いてくるのが、更新作業が特定の担当者に属人化し、記録が残らないまま運用される失敗です。
誰がいつ何をどのバージョンに更新したかが記録されず、手順もその人の頭の中だけにあると、担当が替わった瞬間に対応の質が崩れます。さらに、過去の経緯も追えなくなります。
これは派手な障害ではないぶん、気づきにくい失敗です。
適用台帳がなく現状を把握できない失敗
適用台帳は更新の記録を残す台帳で、これがないと、現在のシステムの版数を誰も正確に把握できなくなります。
この状態では、次にどの更新が必要かを判断できず、脆弱性が自社に影響するかどうかを仕分けるのも困難になります。台帳の不在は、アップデート対応の判断そのものを揺るがす失敗です。
適用台帳は、保守費内訳でも管理報告(5〜10%が目安、出典:ripla)として正規に位置づけられる業務です。
台帳があれば、現状把握も次の更新計画も容易になり、ベンダーを変える際の引き継ぎもスムーズになります。
台帳を「面倒な記録作業」と軽視して省けば、その場は楽でも、後から現状把握のために膨大な調査工数を払うことになります。記録を残すことは、未来の自分やチームへの投資です。
- 記録する項目:いつ、何を、どのバージョンに更新したか
- 現状の把握:各コンポーネントが今どのバージョンで動いているか
手順書なき更新が担当交代で止まる失敗
手順書が残っていないと、その作業は担当者個人の経験と勘に頼ることになります。その人が休んだり退職したりすれば、誰もアップデートを当てられず、対応が止まります。
委託している場合も、ベンダー任せで手順を自社に残していなければ、ベンダーを変えようとしたときに引き継ぎが難航し、ロックインの一因になります。
この失敗を防ぐには、誰が担っても同じ品質で対応できる状態を作ることです。
内製でも委託でも、手順とナレッジを自社にも残すことが、属人化と引き継ぎの難航を防ぎます。アップデート対応を一過性の作業で終わらせず、組織の力として続けるには、記録と手順書の整備が欠かせません。
更新作業の属人化と記録不在は、時間をかけて維持管理を少しずつ弱らせる静かな失敗です。
- 手順書の中身:適用、検証、切り戻しの手順と、過去のトラブルへの対処
- 委託時の注意:ベンダー任せにせず、手順とナレッジを自社にも残す
まとめ
ITシステムのアップデート対応の失敗は、「パッチを放置して脆弱性を突かれる」「検証不足で本番を壊す」「サポート終了への駆け込みで割高になる」「外部SaaSの仕様変更への追従が漏れる」のいずれかに集約されます。
放置と過剰適用は正反対に見えて、どちらも明文化された判断基準と検証・切り戻しの型がないことに根本原因があります。
EOL追跡の不在や外部依存の見落としも、監視と計画の仕組みの欠如という同じ原因から生じています。
失敗を避ける鍵は、深刻度別の適用基準を決めて守ることにあります。そのうえで、検証環境と切り戻し手順を整えておくことが欠かせません。
EOLと外部APIの廃止を追跡する仕組みを持ち、コントロール外の事象について、どこまでを誰が受け持つかを契約に明記しておくことも重要な備えです。重大な脆弱性は初報15分・暫定4時間(SLA実値の例、出典:ripla)といった基準を運用に落とし込み、規律として回し続けることが防御の中心になります。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、こうしたアップデート対応の失敗を構造的に防ぐ進め方を支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。