
ITシステムのサーバー監視の事例では、停止の損失を金額で示して投資を通し、検知の自動化と初動の標準化でMTTRを縮めています。
本記事は、ITシステムのサーバー監視の導入・開発・活用・成功の各事例を、発注企業(情報システム部門)の視点から掘り下げる「事例特化」の解説です。自社の規模や運用体制に近い事例ほど、投資判断の精度を高めてくれます。
夜間・休日の対応は外部委託で補い、SLA(サービス品質保証)は事業への影響に合わせて見直しています。費用相場など全体像は、ITシステムサーバー監視の完全ガイドで確認できます。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ダウンタイム削減とMTTR短縮を実現した事例
事例で最も分かりやすい成果が出るのは、ダウンタイム(停止時間)の削減です。
監視が手薄な企業では、サーバーが止まったことに気づくのが、ユーザーからの問い合わせになっているケースも珍しくありません。
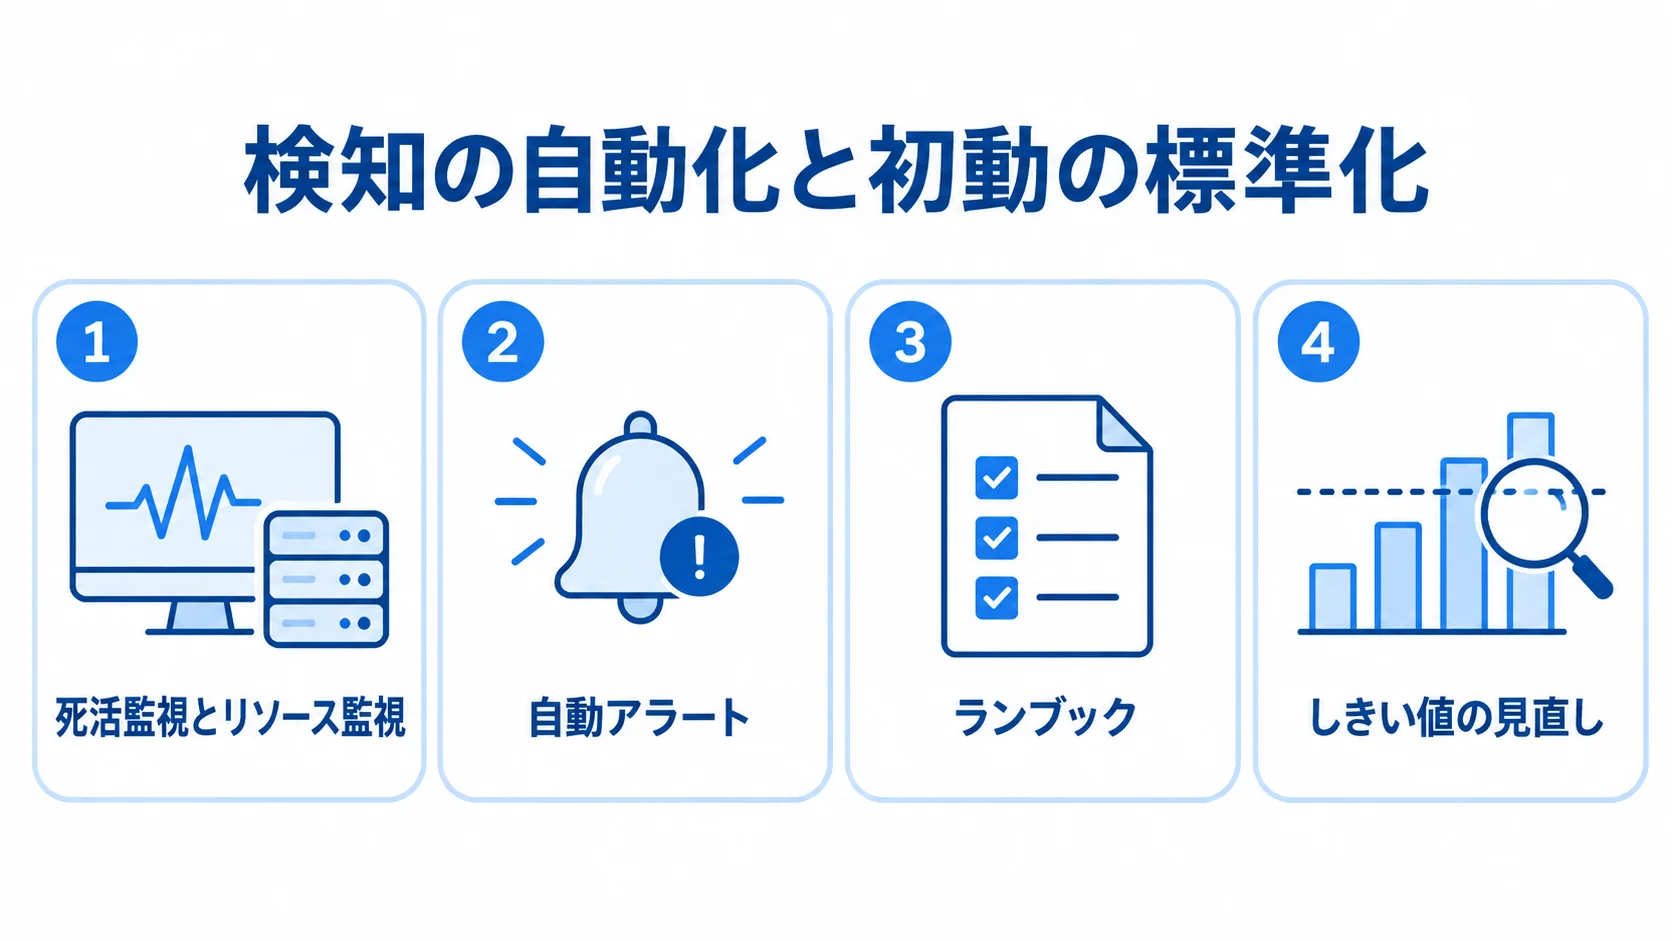
死活監視とリソース監視を組み合わせ、異常をしきい値で自動検知できるようにすれば、検知から復旧までの時間が変わります。事例を読むときは、停止回数とMTTRがどれだけ改善したかを確認してください。
停止5分で1,200万円という損失を可視化した事例
サーバー監視への投資を社内で通すには、停止が生む損失を金額で示すことが効果的です。
総務省の2025年版の調査では、金融・医療・EC系で5分以上の停止が1回あたり平均1,200万円の機会損失につながるとされています。
また、Gartnerの2024年の試算でも、ダウンタイムは1分あたり約5,600米ドルの損失とされています。停止時間が事業損失に直結することを、数字が裏づけています。
ある中堅のEC事業者では、これらの統計を自社のトランザクション量に当てはめました。そのうえで、「年間の想定停止時間×1分あたりの売上」という式で、監視投資の費用対効果を稟議に示しています。
損失を漠然と語らず、出典のある統計を自社の数字に置き換えて定量化した点が、投資判断を後押しした決め手でした。
損失額を稟議に載せるときは、どこまでを損失として数えるかと、監視の費用をどう並べるかを押さえておきます。
- 試算に入れる項目:売上の機会損失に加え、復旧対応の人件費や信頼低下による解約リスク
- 費用との比べ方:月額20万円弱の監視ツールと24時間体制の費用を、停止1回で失う損失と並べて見る
監視の遅れは、一時的な停止損失にとどまらず、セキュリティインシデントの発見遅延という長期的な損害にもつながります。たとえば、IBMの2024年の調査では、データ漏洩の検知までに平均204日を要し、平均被害額は445万米ドルに達するとされています。
監視投資を「保険」として位置づける根拠を、複数の統計から多面的に組み立てた点が、この事例の説得力を支えました。
検知の自動化でMTTRを半減させた事例
MTTR(平均復旧時間)は、障害を検知してから正常に戻すまでの平均時間を指し、サーバー監視の成熟度を測る代表的な指標です。検知が遅いと、復旧作業に入る前の「気づくまでの時間」だけで数十分を失います。
ある業務システム運用の事例では、ユーザー通報頼みだった検知を、死活監視とリソースしきい値による自動アラートに切り替えました。その結果、検知ラグはほぼゼロになっています。
事例では、アラートと一次対応の手順書(ランブック)を連動させ、「どのアラートが鳴ったら誰が何をするか」を明文化しました。
事例を読むときは、改善の効果をどう比べたかと、夜間に起きた障害の扱いに注目します。
- 改善前後の比べ方:検知の自動化を入れる前と後で、MTTRを同じ条件で比べているか
- 夜間の障害:夜間に起きた障害が、翌朝までに復旧しているか
検知の自動化と初動の標準化を組み合わせたことで、MTTRはおおむね半減しました。
ツールを入れるだけでなく、検知後の動き方まで設計して初めてMTTRが縮む、という点がこの事例から学べます。
しきい値チューニングで誤検知を減らした事例
検知を自動化した直後によく起きるのが、アラートの鳴りすぎです。CPU使用率のしきい値を低く設定しすぎると、一時的な負荷の上昇でも頻繁にアラートが飛び、担当者は次第に通知を無視するようになります。
これは「アラート疲れ」と呼ばれ、重要な障害を見逃す原因になります。そこでこの事例では、しきい値の見直しを進めました。
しきい値の見直しでは、瞬間的なスパイクではなく「5分間継続して90%を超えたら通知」といった持続条件を加え、誤検知を減らしています。
しきい値を見直すときは、どの数字を基準にするかと、どの通知を重く扱うかを確かめます。
- しきい値の根拠:運用開始から数週間分の実測データと、平常時の変動幅
- 通知の分け方:対応が必要な重大アラートと、参考情報として記録すればよい軽微なアラート
検知の自動化は出発点で、しきい値の調整を続けてこそ、現場が信頼して動けるサーバー監視になります。
夜間・休日の障害対応を立て直した事例
サーバー監視の悩みが集中しやすいのが、夜間・休日の障害対応です。日中は担当者がいても、深夜や休日にサーバーが止まると対応が遅れ、被害が拡大します。
24時間365日(24/365)の死活監視と緊急対応をどう確保するかは、内製と外部委託の両方で工夫が要る領域です。
事例を読むと、自社の人員規模に応じて現実的な体制を組んだ企業ほど、無理なく運用を続けられています。
24時間緊急対応を月額委託で確保した事例
自社で夜間当番を回そうとすると、監視オペレーターの人件費は人月60万〜80万円が相場です。24/365を自前で組むには複数名のシフトが必要になるため、中小企業では現実的ではないケースがほとんどです。
多くの企業が選ぶのは、サーバー監視と障害対応の外部委託です。
費用例では、サーバー監視が月3万円程度、24時間の緊急障害対応が月10万〜20万円という水準で、自社で人を抱えるより圧倒的に安く済みます。
夜間の体制を外部に任せるときは、誰がどの時間帯を受け持つかと、費用がどう決まるかを並べて見ます。
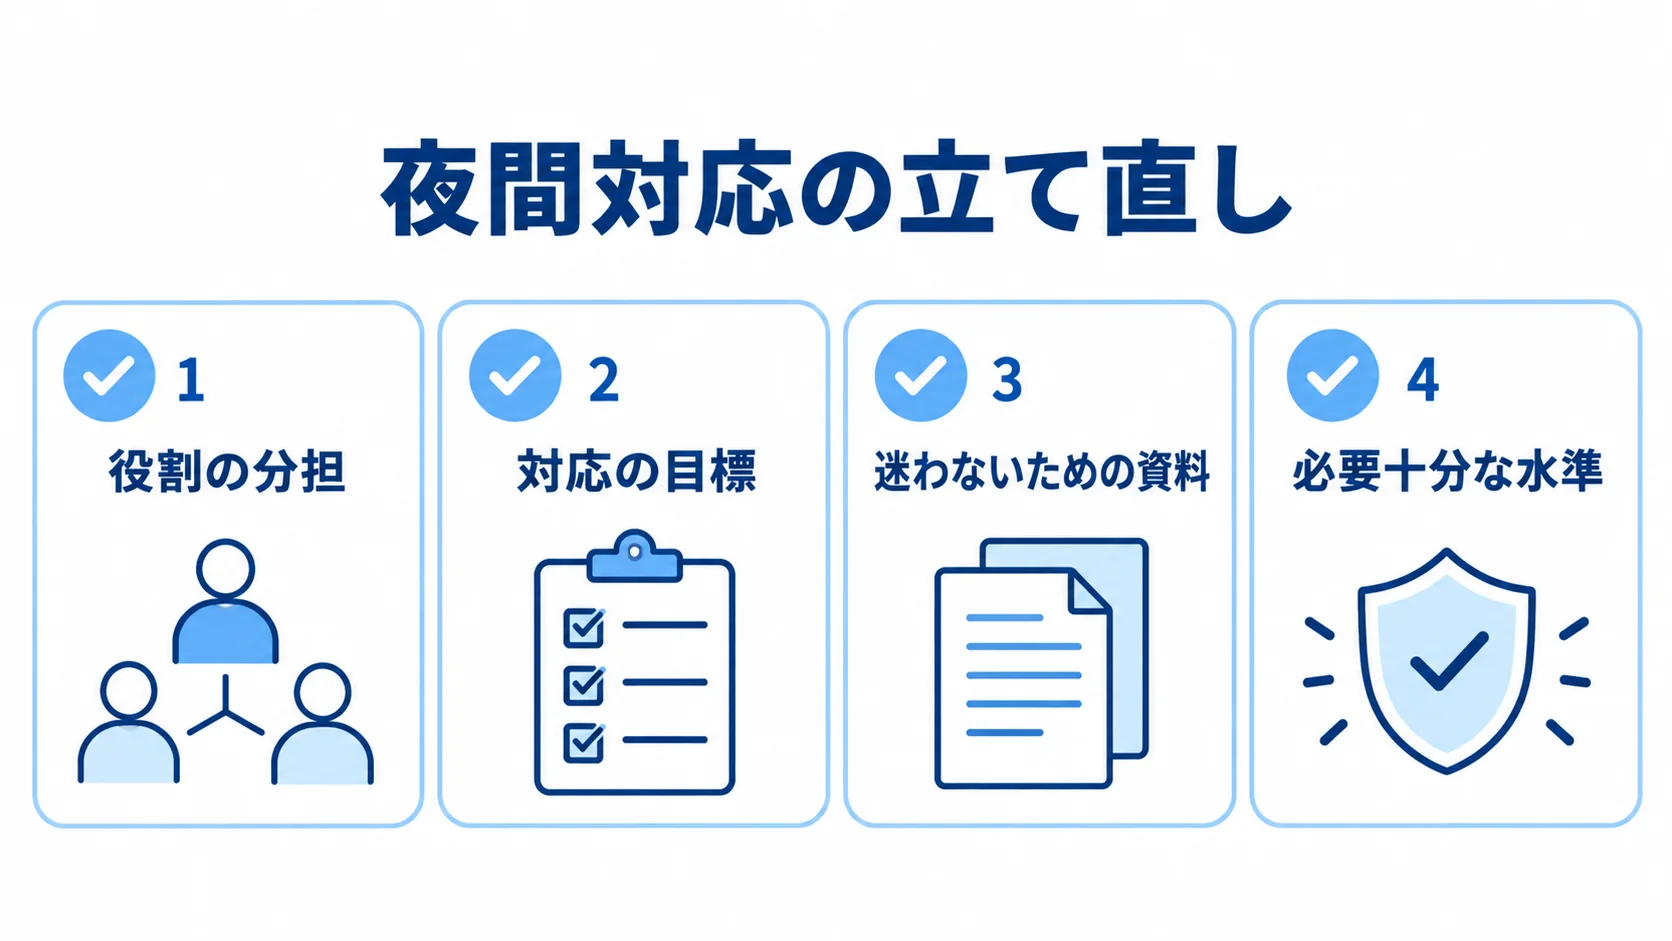
- 役割の分担:平日日中は社内、夜間・休日は外部のMSPが一次対応を担う
- 料金の段階:監視のみ5,000円/台、障害対応込み10,000円/台、フルマネージド20,000円/台という台数課金
対象サーバーの重要度に応じて使い分けたことで、夜間の検知漏れがなくなり、社内担当者は本来の開発・改善業務に集中できるようになりました。
エスカレーション経路を再設計した事例
夜間障害でつまずく企業の多くは、ツールよりも「鳴ったあと誰に上げるか」が決まっていません。
ある事例では、アラートを外部委託先が一次で受け、影響度に応じて社内のオンコール担当へ引き継ぐ流れにしました。さらに重大障害では、情報システム責任者と経営層へ段階的に連絡する経路を文書化しています。
この再設計で押さえた点は、技術的な検知だけでなく、ビジネス部門や経営層への状況報告まで初動に組み込んだことです。サーバーが復旧しても、関係者への報告が遅れれば現場は混乱します。
夜間に迷わず動くには、初動の時間を決めておくことと、夜間でも確認できる手順を用意しておくことが欠かせません。
- 対応の目標:重大障害は2時間以内に対応を開始し、原則24時間以内に完全解決する
- 迷わないための資料:報告テンプレートと連絡先一覧をランブックに含め、夜間でも参照できるようにする
サーバー監視の立て直しは、検知の自動化と、人の動き方の設計をそろえて進めることが条件だと、この事例は示しています。
事例では、委託先のSLA(サービス品質保証)も事業に合わせて選んでいます。
サービス会社の例では、重大障害を15分以内に一次対応する保証を掲げる事業者や、検知から60分以内に通知し12時間で復旧する水準を示す事業者があります。
官公庁の仕様例のように、1時間以内に現地到着・対処を開始し、原則4時間以内に完全復旧するといった厳格な水準もあります。ただし、自社の停止許容度に対して過剰なSLAは、費用がかさむ原因になります。
夜間対応の立て直しでは、検知と復旧の速さを、自社にとって必要十分な水準で契約することが、この事例の教えです。
ひとり情シスがサーバー監視を委託で回した事例
中小企業では、情報システム担当者が1人だけの「ひとり情シス」体制が珍しくありません。この立場でサーバー監視まで自前で抱えると、休暇も取れず、属人化が会社のリスクになります。
事例を見ると、ひとり情シスほど監視と一次対応を外部に切り出し、自分は重要な意思決定に集中する設計が有効です。属人化の解消と事業継続の両立が、テーマになります。
属人化を解消し休暇を取れる体制にした事例
ある製造業の事例では、ひとり情シスが社内サーバー数台の監視・障害対応をすべて1人で抱え、深夜のアラートに自宅から対応する状態が続いていました。
これは本人の負担だけでなく、その人が休めば監視が止まるという、事業継続上のリスクでもあります。
会社は、監視と一次対応をフルマネージドの委託先に切り出し、20,000円/台前後の費用で常時監視を任せる構成に変えました。
その結果、担当者は深夜のアラートから解放され、休暇も取れるようになりました。
委託を丸投げにしないためには、どこまで委託先に任せるかの線引きと、委託先から連絡が来る条件を、委託先と合意しておく必要があります。
- 監視の範囲:監視項目としきい値を自分で定め、委託先と合意しておく
- 連絡の基準:委託先から自分に連絡するのは、判断が必要な場面に限る
こうした設計で、品質を保ったまま負担だけを下げられました。ひとり情シスの事例は、外部委託が単なるコストではなく、事業継続のための保険になることを示しています。
費用面でも、この切り分けは合理的でした。仮に夜間も対応できる監視オペレーターを自社で採用すると、人月60万〜80万円の人件費に加え、シフトを回すための複数名分の固定費がかかります。
委託に切り替える場合は、対象サーバーの台数と必要なSLAに応じて、月数万円から十数万円の変動費に置き換えられます。
ひとり情シスにとっては、人を増やすより外部の監視サービスを使うほうが、コストと安心の両面で理にかなっていたのです。
この事例で見落とせないのが、引き継ぎ資料の整備です。ひとり情シスの体制では、その人が退職や長期離脱をした瞬間に監視の知見が失われます。
委託に切り出す過程で、サーバー構成図・監視項目一覧・過去の障害履歴を文書化したことで、会社としての運用ナレッジが残りました。
属人化の解消は、当番を外に出すことにとどまらず、運用の暗黙知を形式知に変える作業でもあります。
過剰SLAを適正化してコストを削減した事例
サーバー監視のコストを押し上げる要因の一つが、過剰なSLAです。稼働率99.9%は年間8.76時間の停止を許容しますが、99.99%にすると許容停止は年52.6分まで縮みます。
「9」が1つ増えるごとに、冗長構成や監視頻度のコストは段階的に跳ね上がります。ある事例では、社内システムに対し当初99.99%を求めていましたが、その必要性を検証しました。
事業影響度を見直した結果、夜間に数十分停止しても業務への実害は限定的だと判明し、SLAを99.9%へ適正化しました。これにより、監視・運用の費用を月数万円圧縮できています。
情シスがビジネス部門に「この稼働率は本当に必要か」を問い、影響度に応じてSLAを下げる調整を行ったことが鍵でした。
過剰なSLAを見直すときは、システムごとに求める稼働率を分けて考え、停止の影響を並べて確かめます。
- 対象の分け方:基幹の受発注は高い稼働率を維持し、社内の情報共有ツールは低めのSLAで足りる
- 判断の材料:停止が何分続くと、どの業務にどんな実害が出るかを、システムごとに並べて見る
SLAの適正化を進める際、現場では「停止したらどうするんだ」という反発が起きがちです。
担当者は、この見方を使って関係者と話し合い、合意を取りつけました。
一律に高いSLAを敷くより、システムの重要度ごとに監視の手厚さを変えるほうが、限られた予算でも実効性のあるサーバー監視になります。事業影響度に見合った水準へ最適化することが、コストと品質の両立につながると、事例は示しています。
クラウドサーバー監視を自衛策込みで設計した事例
国内エンタープライズ・システム市場のクラウド比率は2022年時点で約5割に達していると、IDC Japanの調査は示しています。
サーバーがクラウドに移ると、物理層の監視はクラウド事業者の責任になりますが、その分「監視がブラックボックス化する」という新たな課題も生まれます。
事例を見ると、クラウド前提でも自社で何を監視し、何を自衛するかを設計できた企業ほど、基盤障害の影響を小さく抑えています。
SaaS型監視ツールを導入した事例
あるWebサービス事業者の事例では、クラウド上のサーバー群を監視するために、SaaS型のDatadogを導入しました。
クラウド型監視ツールはホスト数やメトリクス量に応じた従量課金で、中規模では月数万〜数十万円が目安です。
OSSのZabbixと比べてライセンスは有料ですが、構築・維持の工数を自社で抱えずに済むため、ひとり情シスや小規模チームには現実的な選択でした。
Webサービス事業者は、サーバーの中身と外からの見え方の両面で監視を組んでいます。
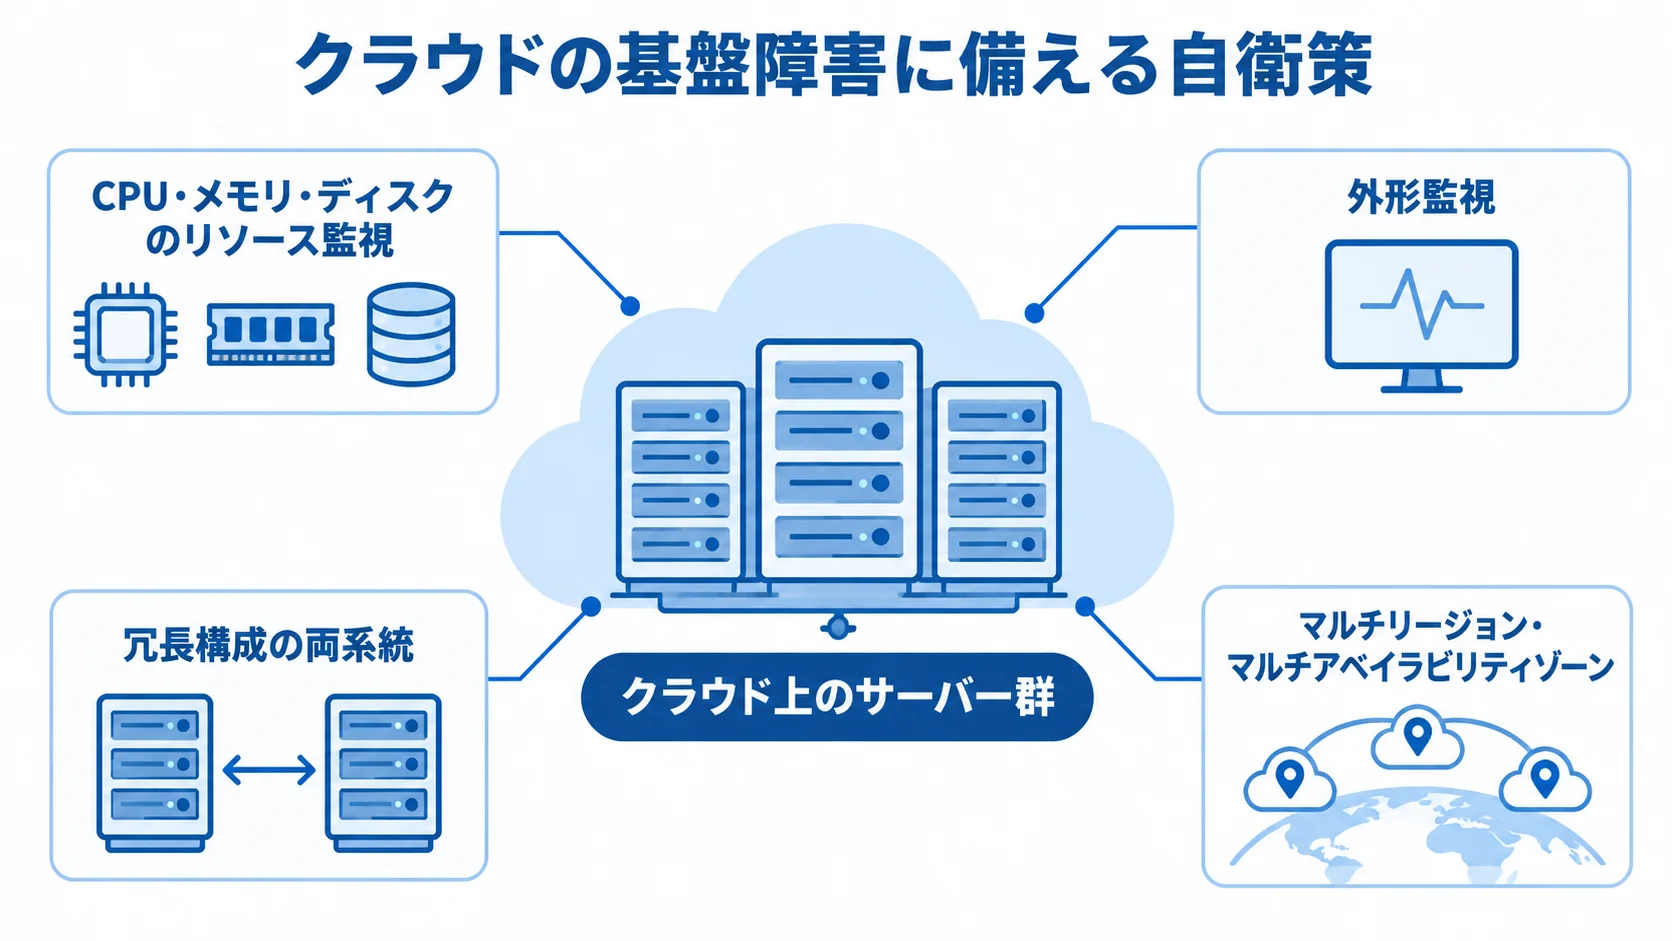
- 監視の組み合わせ:CPU・メモリ・ディスクのリソース監視に、外形監視(外部からのアクセス可否)を併用する
- 外から見る対象:自社サービスが外部から正常に応答しているか。基盤側の障害に気づく入口にもなる
クラウド基盤側の障害はユーザー側で手出しできず、サービスクレジット以上の補償は期待できません。
だからこそ、基盤障害の発生をいち早く検知できる体制を組みました。クラウドだから任せきりにせず、自衛の監視が要るという発想です。
冗長化で基盤障害の影響を抑えた事例
クラウドの基盤障害に備える自衛策として、ある事例では重要サーバーをマルチリージョン・マルチアベイラビリティゾーンで冗長化しました。片方のリージョンで障害が起きても、もう片方で稼働を続けられる構成です。
ただし冗長化には隠れコストもあります。サーバー台数が増えれば監視対象も増え、台数課金の監視費用や運用工数が積み上がります。
冗長化を組むときは、どこまでを冗長化するかと、片系の障害をどう捉えるかを確かめます。
- 冗長化の対象:停止が事業に直結する基幹部分だけに絞り込む
- 監視の対象:冗長構成の両系統を監視し、片系が落ちた時点でアラートを上げる
冗長化したことで、基盤障害がそのままサービス停止になる事態を防げました。
クラウドサーバー監視の事例から学べるのは、責任共有モデルを正しく理解したうえで、自社が監視すべき範囲と冗長化すべき範囲を費用とのバランスで見極める設計力だと言えます。
まとめ
事例を振り返ると、成果はいずれも、停止の損失を金額で捉えて投資を通し、検知の自動化と初動の標準化でMTTRを縮めたうえで、自社の規模に見合った体制を外部委託も使って組む、という点に集まります。
停止5分で1,200万円、1分5,600米ドルという統計を自社の数字に置き換えれば、監視投資の費用対効果は明確に示せます。
夜間・休日の対応はMSP(マネージドサービスプロバイダー)への委託で確保し、ひとり情シスは属人化を解消します。過剰なSLAは事業影響度に応じて適正化しており、これらが共通する成功パターンです。
事例を読むときに大切なのは、「どれだけ手厚くしたか」ではなく「事業への影響に対して適切な監視ができたか」という視点です。
自社のサーバー構成と停止時の影響度を起点に、まずは死活監視とリソース監視の自動化から、現実的な一歩を踏み出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作ったあとの監視・障害対応まで継続して伴走します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。