
ITシステムサーバー監視は、死活・性能・ログの各監視を組み合わせ、オンプレミスからクラウドまでを横断してサーバーの稼働状態を把握する取り組みです。
マルチクラウドやハイブリッド環境の広がりで、監視対象が分散して全体像をつかみにくくなっています。24時間365日の監視を自社だけで賄えない悩みも増えています。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
- ITシステムサーバー監視の進め方/やり方/流れや方法・手順
- ITシステムサーバー監視でおすすめの開発会社・ベンダー6選と選び方
- ITシステムサーバー監視の見積相場や費用・コスト・値段について
- ITシステムサーバー監視の発注・外注・依頼・委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステムサーバー監視の全体像
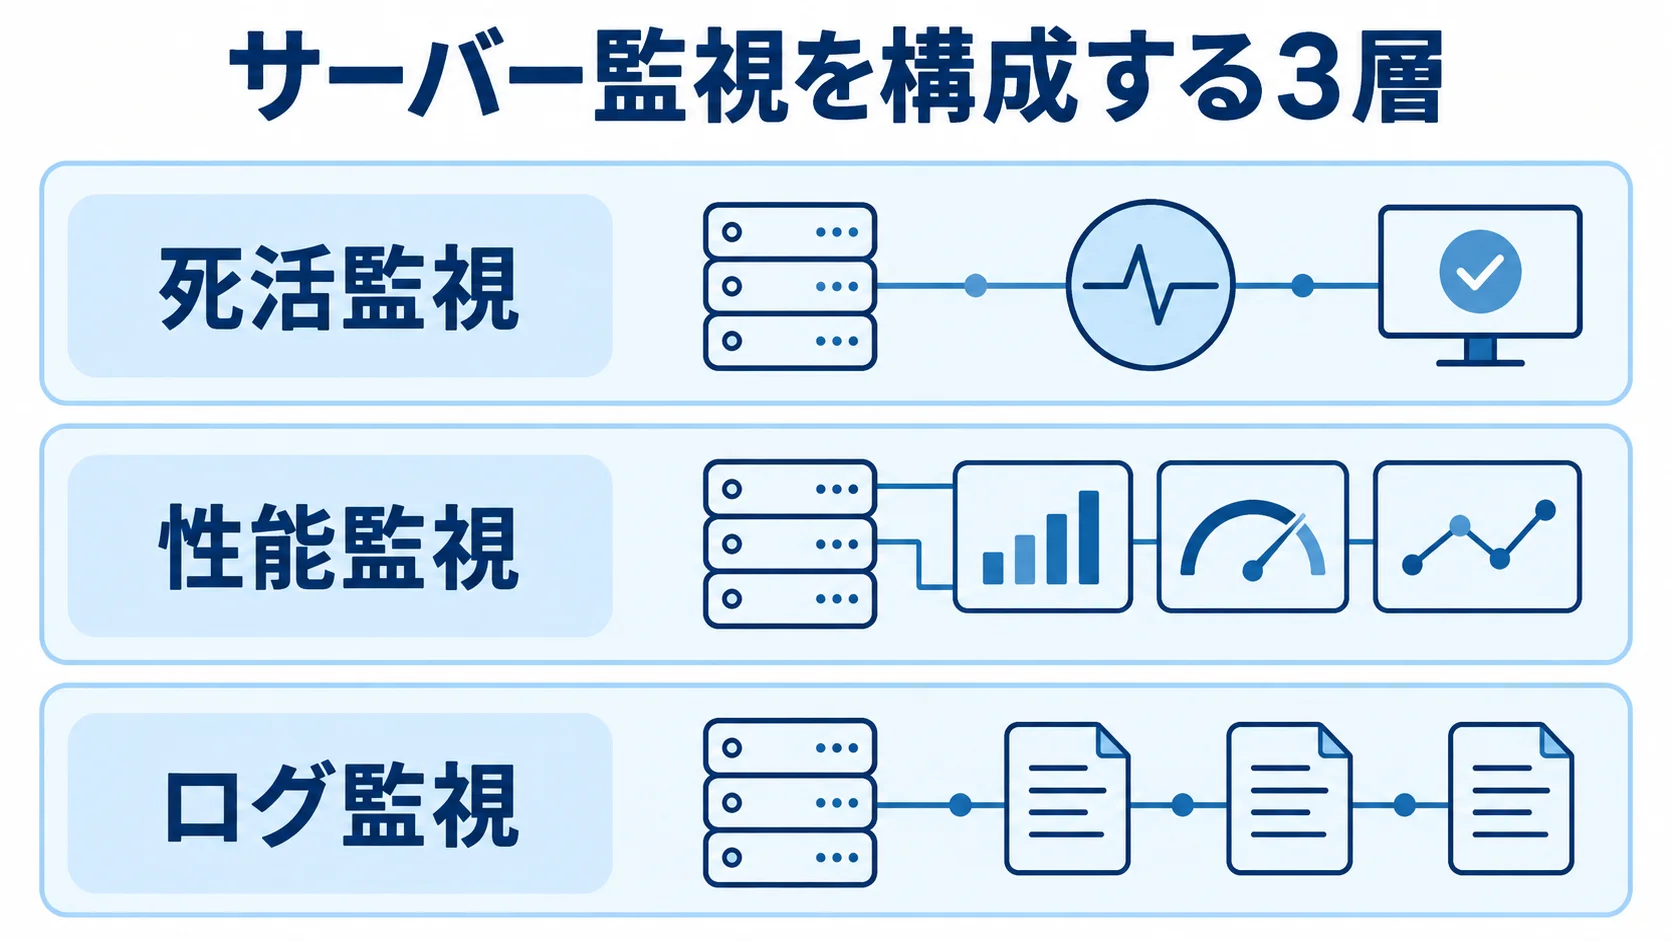
サーバー監視とは、サーバーが正常に稼働しているか、リソースが逼迫していないか、エラーが起きていないかを継続的に確認する活動です。死活監視・性能監視・ログ監視という3つを統合し、オンプレミスとクラウドにまたがるサーバー群を一元的に把握するところに特徴があります。
監視は、単一のWebサーバーやデータベースにとどまらず、ネットワーク機器やコンテナ基盤まで含めた広い範囲で設計する必要があります。
死活・性能・ログを統合する監視の3層
サーバー監視は、大きく3つの層で構成されます。1つ目の死活監視は、PingやSSH、ポート接続などでサーバーが応答するかを確認し、ダウンを即座に検知します。
2つ目の性能監視は、リソースの使用状況(CPU・メモリ・ディスク・ネットワーク)を継続的に計測し、障害の予兆を捉えます。3つ目のログ監視は、アプリケーションやOSが出力するログからエラーや異常な挙動を追跡します。
特に、3層は組み合わせて初めて価値を発揮します。たとえば、死活監視でダウンを検知し、性能監視のグラフでメモリ枯渇の兆候を確認し、ログ監視で具体的なエラー内容を特定するという流れです。そのうえで設計では、どの層をどの粒度で監視するかを、システムの重要度に応じて決めることが出発点になります。
監視からオブザーバビリティへの進化
近年は、従来の監視(モニタリング)から「オブザーバビリティ(可観測性)」への移行が進んでいます。監視が「何が問題か、どこに異常があるか」を示すのに対し、オブザーバビリティは「なぜそれが問題なのか、なぜ障害が起きたのか」を内部データから明らかにするアプローチです。
メトリクス・ログ・トレースを統合して分析することで、原因究明のスピードが大きく変わります。実際に、中規模SaaS企業がAPMとログ、メトリクス、トレースを統合可視化したところ、障害の原因特定時間が従来の3分の1に短縮された事例があります。
さらに、サーバー台数が増え、クラウドネイティブな構成が広がるほど、単なる死活確認では足りず、可観測性を前提とした監視設計が求められます。詳しい監視の全体像と進め方は、こちらの記事で確認できます。ITシステムサーバー監視の進め方/やり方/流れや方法・手順をご覧ください。
ITシステムサーバー監視の進め方
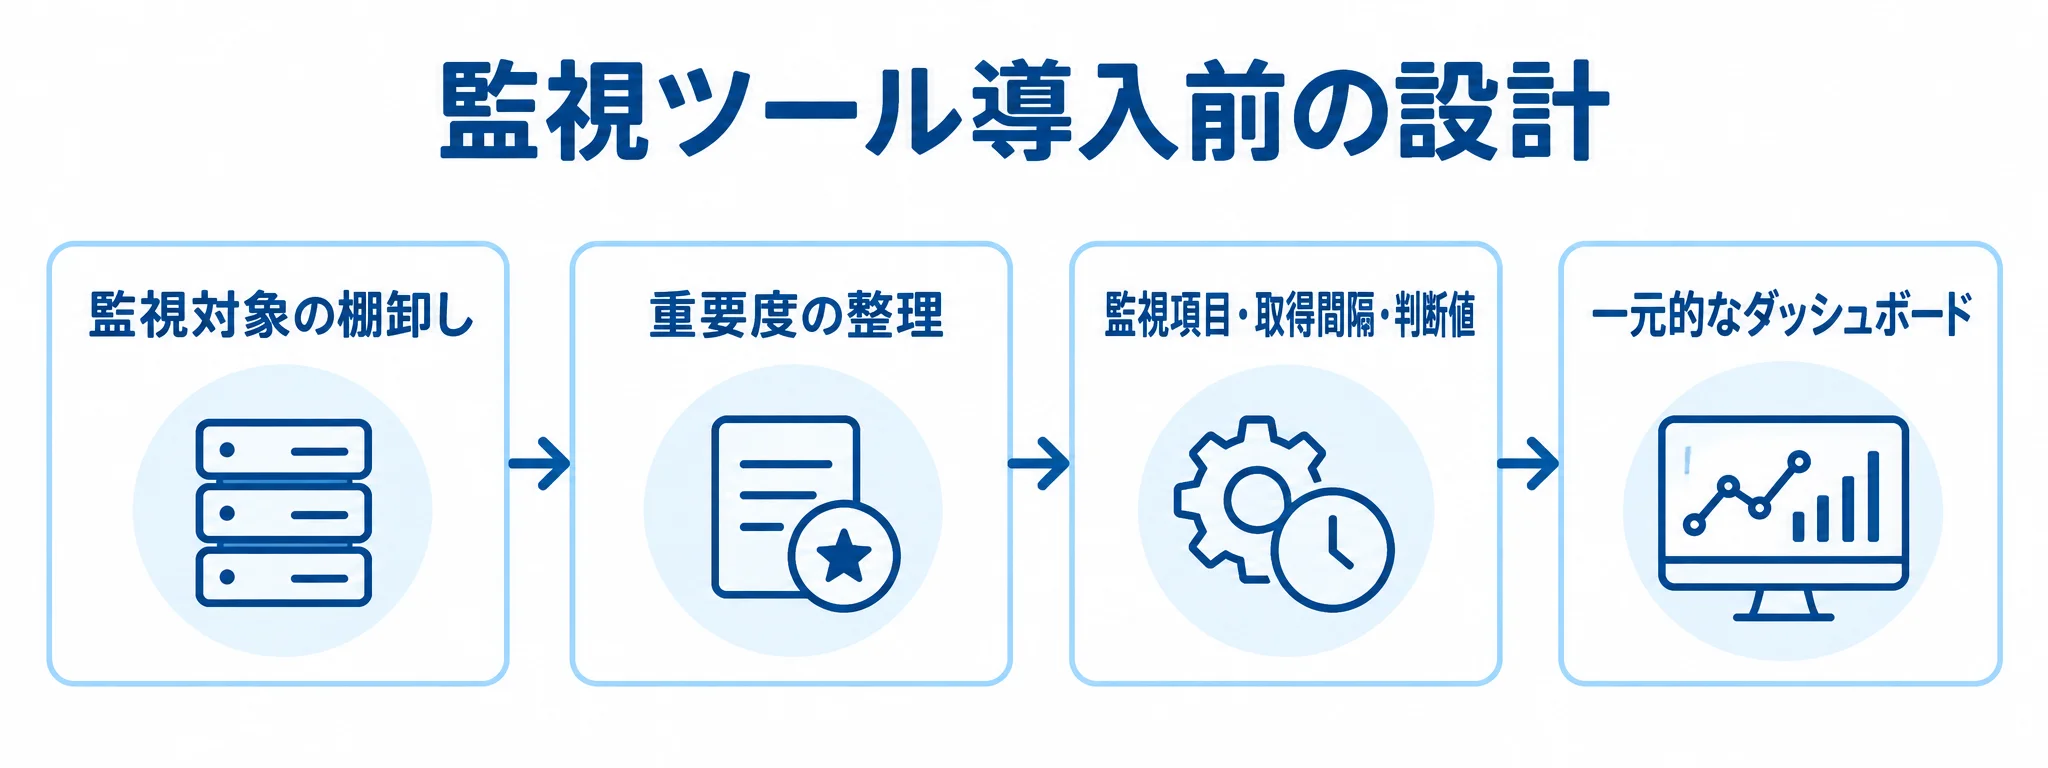
サーバー監視を導入するときは、ツールを先に入れるのではなく、監視対象の棚卸しと監視設計から始めます。とくにオンプレとクラウドが混在する環境では、どこに何があるかを一覧にしたうえで、統合的に監視できる仕組みを組み立てる必要があります。
監視対象の棚卸しと統合監視の設計
最初に行うのは、監視対象となるサーバーやサービスを一覧にすることです。オンプレミスの物理・仮想サーバーや、AWSやAzureなどのクラウドインスタンスをはじめ、コンテナ、ネットワーク機器をすべて洗い出し、それぞれの重要度を整理します。そのうえで、どの監視項目をどの間隔で取得するか、どの値で警告・障害と判断するかを決めます。
オンプレとクラウドが混在する場合、複数の管理画面に分かれてしまうと運用負荷が高まります。そのため、できる限り一元的に状態を確認できるダッシュボードを設計し、環境をまたいで統合的に監視できるようにします。また、特定のクラウドベンダーに依存しすぎないよう、OpenTelemetryのような標準化された仕組みを使っておくと、将来の移行や拡張に強い構成になります。
しきい値とアラート設計のベストプラクティス
監視の成否は、しきい値とアラート設計のシンプルさで決まるといっても過言ではありません。注意したいのは、複雑な条件分岐を作り込みすぎないことです。たとえば、「特定キーワードを含むログのみ通知」といった凝った条件を設定ミスし、重要なエラーログが通知されず障害発見が3時間遅延した失敗例もあります。
一方で、段階的な閾値の例として、Load Average(1CPU)は4以上で警告、8以上で軽度障害、12以上で重度障害とするのが参考になります。同様に、ディスクやInode使用量は80%超で警告、90%超で軽度障害、95%超で重度障害です。メールキューは500件超で警告、1,000件超で軽度障害、2,000件超で重度障害です。
さらに、過検知が続くと現場が通知を無視する「アラート疲れ」に陥り、本当に重要な障害を見落とすリスクが高まるため、シンプルで確実な設計を優先することが大切です。設計から運用定着までの手順は、こちらの記事で確認できます。ITシステムサーバー監視の進め方/やり方/流れや方法・手順をご覧ください。
サーバー監視の開発・運用会社の選び方
サーバー監視の構築や運用を外部に依頼する場合は、パートナー選びが成果を大きく左右します。そのため、どのような基準でパートナーを評価すればよいかを、考え方として押さえておくことが大切です。
おすすめ会社の具体的な比較は、後述の関連記事で詳しく解説しています。
実績と対応環境の確認ポイント
まず確認すべきは、自社と同規模・同業種のサーバー監視の実績です。とくに、オンプレとクラウドが混在するハイブリッド環境を統合監視した経験があるか、マルチクラウドに対応できるかは、重要な判断材料になります。
特定のクラウドや特定のツールしか扱えないパートナーだと、将来の環境変化に追従できず、結果的に、ベンダーロックインを招くおそれがあります。そのため、監視ツールの構築だけでなく、その後の運用や改善まで伴走できるかも確かめます。さらに、しきい値のチューニングや監視項目の見直しを継続的に行える体制があるかどうかが、導入後の長期的な運用品質を左右します。
運用体制とサポートの評価
24時間365日の監視を委託する場合は、NOC(ネットワークオペレーションセンター)の運用体制や一次対応の範囲、エスカレーションのフローを必ず確認します。そのうえで、障害検知後にどこまで自動・手動で対応してくれるのか、どのような連絡経路でアラートが届くのかを、契約前に具体的に詰めておくことが大切です。
SLA(サービス品質保証)の内容と報告体制の透明性も、評価の対象です。丸投げによってシステムがブラックボックス化しないよう、定例の報告や運用ドキュメントの共有が受けられるかを確認しましょう。このため、発注側がアーキテクチャ全体を把握し続けられる関係性こそ、健全な委託の条件です。
パートナー選びの具体例は、こちらの記事で確認できます。ITシステムサーバー監視でおすすめの開発会社・ベンダー6選と選び方をご覧ください。
ITシステムサーバー監視の費用相場
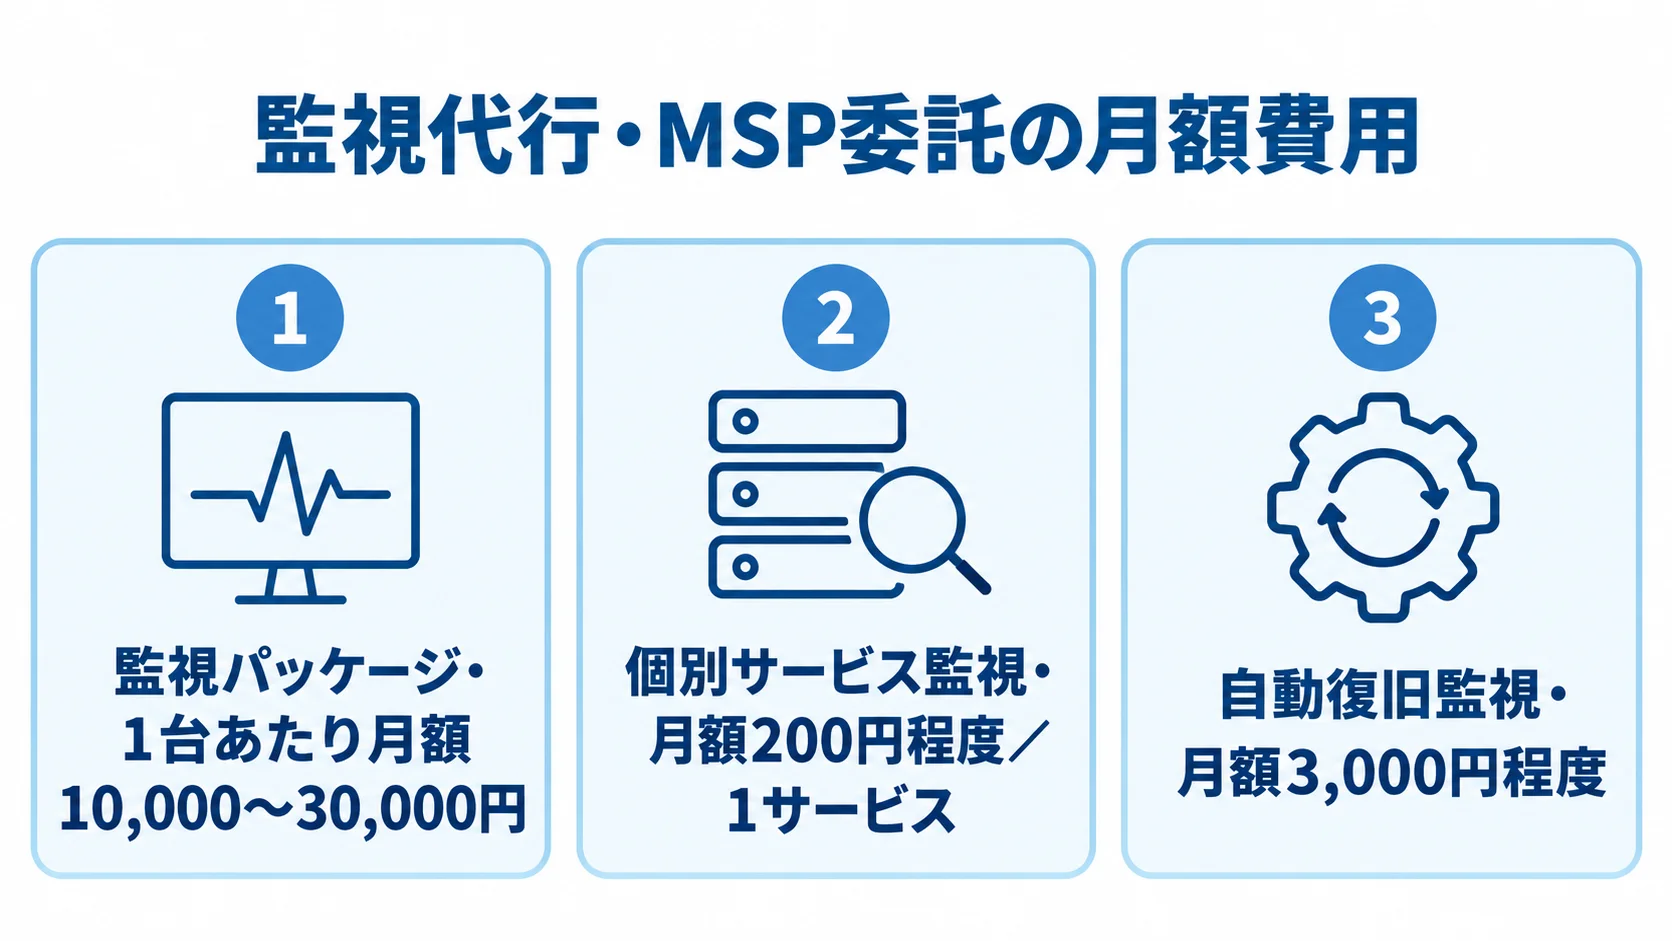
サーバー監視のコストは、自社でツールを導入して運用するか、MSPに委託するかで構造が変わります。そこで、ツールの予算別の目安と、監視代行の料金相場を分けて見ていきます。
費用の詳細な内訳やシミュレーションは、関連記事で深掘りしています。
予算別のツール選定とコスト目安
監視ツールは予算帯によって選択肢が分かれます。月額5万円未満で抑えたい場合は、初期コストゼロのOSSであるZabbixが有力です。また、月額5万〜20万円の範囲なら、従量課金のCloudWatch(取込$0.76/GB程度)がAWS環境に適しています。
月額20万円以上を投資できる場合は、ホスト課金のDatadog(月額$15程度〜/ホスト)で高度な統合監視が可能です。さらに、個別ツールの評価としては、2026年5月時点のITreviewでMackerelが機能満足度4.4・スタンダードプラン月額2,180円/台、DatadogやZabbixが満足度4.1といった水準にあります。
予算や監視環境に加えて、チームの技術レベルや監視範囲、アラート通知の柔軟性も含めて総合的に判断することが、後悔しないツール選定につながります。
監視代行・MSP委託の料金とROI
24時間365日の監視を外部委託する場合、一次対応を含む監視パッケージは1台あたり月額10,000〜30,000円が相場です。これに加えて、個別サービス監視が月額200円程度/1サービス、Apacheなどの自動復旧監視が月額3,000円程度といったオプション料金が積み上がります。なお、夜間・休日のみの時間帯指定オプションを使えば、必要な部分だけ委託してコストを抑えることもできます。
費用を経営層に説明する際は、ROI(投資対効果)の観点が有効です。サーバーダウンによる売上機会の損失やブランド毀損を金額換算し、監視・MSP導入でどれだけのダウンタイムを防げるかを示すことで、決裁が通りやすくなります。
そのうえで、月額コストとリスク回避効果を並べて比較する計算ロジックを用意しておくとよいでしょう。費用の詳しい内訳は、こちらの記事で確認できます。ITシステムサーバー監視の見積相場や費用・コスト・値段についてをご覧ください。
ITシステムサーバー監視の発注・外注方法
サーバー監視の外注は、丸ごと任せるか、一部だけ委託するかで進め方が変わります。そこで、NOC/MSPへの委託を検討するときは、契約形態や偽装請負のリスク、ブラックボックス化を避ける工夫を理解しておくことが欠かせません。
契約形態と偽装請負の回避
監視業務を委託する契約は、請負・準委任といった業務委託契約と、労働者派遣契約に大別されます。業務委託では、発注側が作業担当者に直接指揮命令を行うと偽装請負と判断されるリスクがあるため、運用上の注意が必要です。
近年はSlackなどで常時つながる運用が一般的になり、どこまでが適正なコミュニケーションかの線引きが難しくなっています。たとえば、管理責任者宛のメールを作業担当者にCC送付すること自体は違法ではありませんが、実質的な作業手順の指示が含まれたり、担当者へ直接返信を求めたりすると、指揮命令とみなされるおそれがあります。
とくに発注者の事業所で請負労働者が1人で作業する場合、その担当者が管理責任者を兼任すると、発注者の注文が直接の指揮命令とみなされやすくなります。そのため、契約形態に合わせた適正な運用ルールを整えておくことが欠かせません。
ハイブリッド運用と内製化への移行
夜間・休日の一次対応だけをMSPに任せ、平日日中は自社で対応するといったハイブリッド運用は、コストと内製ノウハウを両立させる手段として有効です。また、将来的に内製化を進める場合も、その逆に外注比率を高める場合も、移行ステップを段階的に設計しておくと無理がありません。
そこで大切なのは、外注しても発注側が手放してはいけないスキルを明確にしておくことです。具体的には、SLAを定義する能力やアーキテクチャ全体を把握する力は、たとえMSPに監視を任せても、情報システム部門が担保し続けるべき領域です。
「MSPに丸投げした結果、自社システムを理解できる社員がゼロになった」という構造的失敗を避けるため、最低限のスキルと知見を社内に残す設計を意識しましょう。発注・外注の進め方は、こちらの記事で確認できます。ITシステムサーバー監視の発注・外注・依頼・委託方法についてをご覧ください。
サーバー監視で失敗しないためのポイント
サーバー監視は、導入後も継続的に改善していくことで真価を発揮します。そこで、よくある失敗パターンを反面教師にしながら、ロックイン回避や改善サイクルの仕組みを最初から組み込んでおくことが、長期的な安定運用の鍵になります。
よくある失敗パターンとロックイン回避
典型的な失敗の一つが、「高価なSaaS型監視ツールを導入したものの、誰もダッシュボードを見なかった」というケースです。ツールの導入が目的化し、運用に組み込む設計が伴わないと投資が無駄になります。そのため、監視結果を誰が、いつ、どう確認し、どのアクションにつなげるかまで決めておくことが必要です。
もう一つ意識したいのが、ベンダーロックインの回避です。特定のSaaS型ツールに深く作り込むほど、後から別のツールへ移行する際のスイッチングコストが膨らみます。そこで、OpenTelemetryのような標準仕様で計装しておけば、ツールを切り替えても収集データの互換性を保ちやすく、ロックインのリスクを下げられます。
ポストモーテムによる継続的改善
障害が発生したら、検知・通知・復旧だけで終わらせず、ポストモーテム(振り返り)を行うことが欠かせません。具体的には、「なぜ障害が起きたのか」「アラートは適切に鳴ったのか」「検知が遅れた原因は何か」を冷静に分析し、監視システム自体をアップデートしていきます。
この改善サイクルを回すことで、同じ障害の再発を防ぎ、監視の精度を高め続けられます。あわせて、AIでログやメトリクスから異常を予測するAIOps、障害時に自動復旧するセルフヒーリングといった高度化技術も視野に入ります。
一方で、AIOpsやセルフヒーリングには限界もあり、十分な学習データが必要だったり、想定外のエッジケースには対応できなかったりします。そのため、最新トレンドを取り入れつつも、人による設計と振り返りを欠かさない姿勢が、現実的な運用につながります。
まとめ
ITシステムサーバー監視は、死活・性能・ログの3層を統合し、オンプレミスからクラウドまでを横断して稼働状態を把握する取り組みです。
全体像と進め方に加えて、会社の選び方、費用相場、発注・外注の方法を見てきました。さらに、失敗しないためのポイントも確認しました。
シンプルなアラート設計とベンダーロックインの回避が、サーバー監視を成功させる共通の鍵です。また、ハイブリッド運用と内製化のバランス、ポストモーテムによる継続的改善も押さえておきたい点です。
各テーマの詳細は、以下の関連記事で確認できます。自社の環境・予算・体制に合った監視のあり方を検討する手がかりにしてください。
- ITシステムサーバー監視の進め方/やり方/流れや方法・手順
- ITシステムサーバー監視でおすすめの開発会社・ベンダー6選と選び方
- ITシステムサーバー監視の見積相場や費用・コスト・値段について
- ITシステムサーバー監視の発注・外注・依頼・委託方法について
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。