
ITシステムのサーバー監視は、役割の異なる機能の組み合わせです。大きくは次の4つに分けられます。
- 死活監視:サーバーやサービスが応答しているかを確認する機能
- リソース監視:CPU・メモリ・ディスクなどの使用状況を測る機能
- ログ・外形監視:ログの異常と、利用者から見た応答を捉える機能
- 通知・一次対応:検知した異常を対応へつなげる機能
どの機能を、どのしきい値で、どう通知するかを決めないまま導入すると、異常を見逃したり、アラートが鳴りすぎたりします。費用相場や契約形態まで含む全体像は、ITシステムサーバー監視の完全ガイドで確認できます。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
業務システム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
死活監視とリソース監視という基本機能
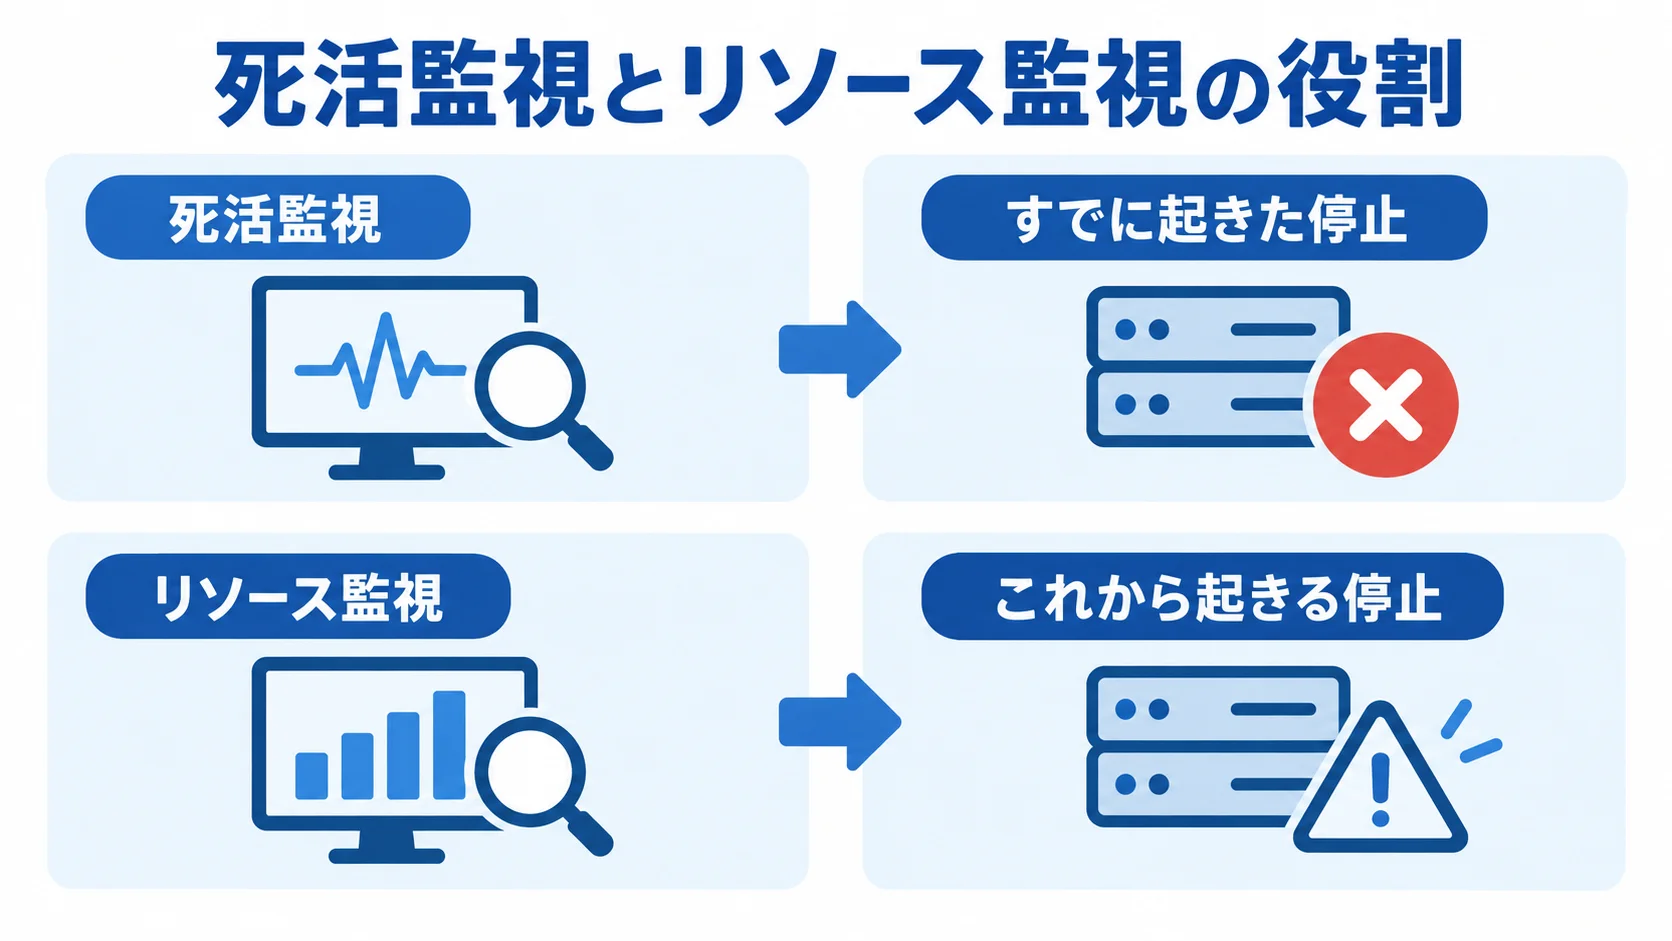
サーバー監視の基本は、死活監視とリソース監視です。どちらも、多くの監視ツールで標準機能として提供される、もっとも基本的な領域です。
死活監視は、サーバーが応答するかを定期的に確認する機能です。一方で、リソース監視は、CPU・メモリ・ディスク・ネットワークといった資源の使用状況を継続的に計測する機能です。この2つがそろって初めて、「落ちていないか」と「落ちそうではないか」の両方を捉えられます。
死活監視が担う「生きているか」の確認
死活監視は、pingやポート監視、プロセス監視といった手段で、サーバーやサービスが応答する状態にあるかを一定間隔で確認します。応答がなければダウンと判定し、すぐにアラートを上げます。これにより、利用者からの問い合わせで初めて停止に気づくという最悪の事態を避けられます。
死活監視を設計するときは、「どの単位で生死を見るか」を決めることが欠かせません。サーバー本体が起動していても、その上で動くWebサービスやデータベースのプロセスだけが止まっていれば、利用者にとっては停止と同じです。だからこそ、サーバー単位だけでなく、サービス単位・プロセス単位まで死活を監視することが求められます。
応答がない状態が一定時間続いたら通知するといった条件を加えれば、一時的な変動による誤検知も抑えられます。なお、24時間365日(24/365)の死活監視は、運用・監視サービスの基本メニューとして提供されることが多く、サーバー監視の費用例でも月3万円程度から組み込まれています。
リソース監視が支える「落ちる前の予兆検知」
リソース監視は、CPU使用率・メモリ使用量・ディスク空き容量・ネットワーク帯域などを継続的に計測し、しきい値を超えたらアラートを上げる機能です。落ちる前の予兆を捉えて先回りで手を打てるのが、この機能の強みです。ディスク、CPU、メモリでは、停止の前に次のような兆しが現れます。
- ディスクの空き容量:逼迫してきた段階で通知が届けば、満杯になってサービスが停止する前に、不要ファイルを削除したり容量を増設したりできます。
- CPU使用率:慢性的に高止まりしていると、いずれ処理が詰まり、レスポンスが悪化します。
- メモリ使用量:メモリリークで右肩上がりに増えていれば、放置するとやがてサーバーが応答不能になります。
リソース監視の価値は、性能劣化の早期発見にもあります。死活監視が「すでに起きた停止」を捉えるのに対し、リソース監視は時系列の傾向から「これから起きる停止」を防ぎます。両者は補完関係にあります。
リソース監視で見る指標は対象のシステムによって変わり、Webサーバーならネットワーク帯域や同時接続数、データベースサーバーならディスクI/Oやクエリの待ち時間を優先して見ることになります。「CPUとメモリだけ見ればよい」と一律に考えると、本当のボトルネックを見逃しかねません。そのため、自社のサーバーがどんな処理を担い、どの資源が枯渇しやすいかを把握して、監視する指標としきい値を選びます。
ログ監視と外形監視という応用機能
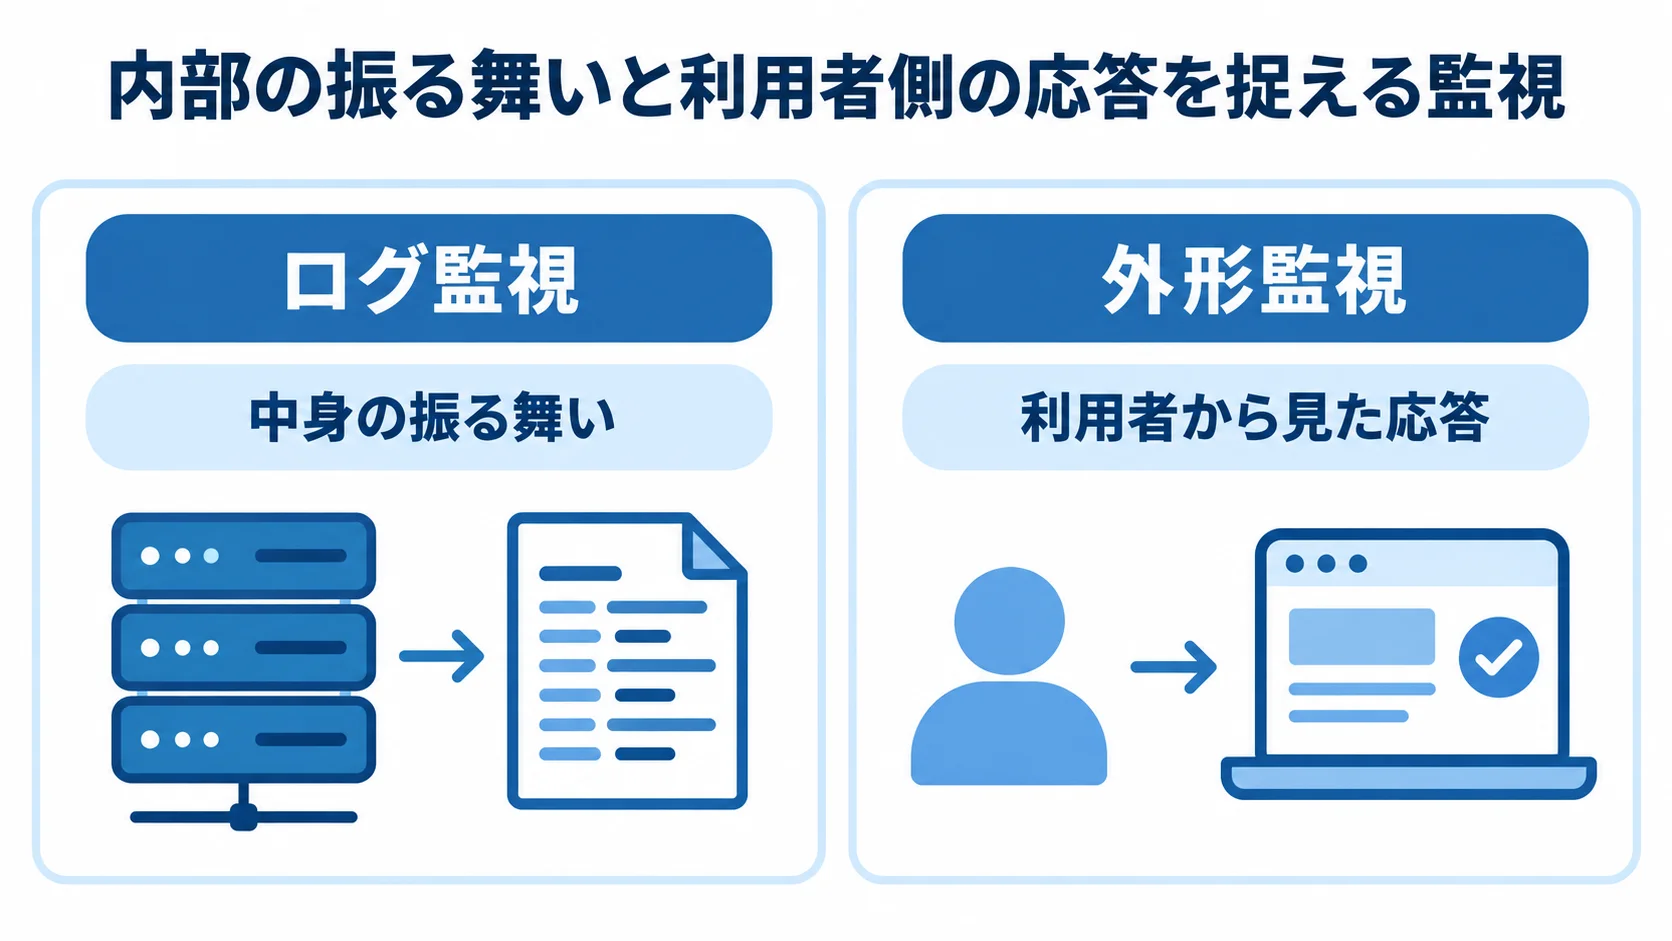
死活監視とリソース監視が「サーバーの状態」を見るのに対し、ログ監視と外形監視は「中身の振る舞い」と「利用者から見た応答」を見る機能です。サーバー自体が正常でも、アプリケーションがエラーを出していたり、外部から正しく応答していなかったりすれば、利用者にとっては障害になります。そのため、サーバー監視を実効性のあるものにするには、こうした応用機能まで含めて設計する必要があります。
ログ監視が拾うエラーの予兆とセキュリティ異常
ログ監視は、出力されるログを継続的に解析し、特定のエラーメッセージや異常なパターンを検出する機能です。たとえば、認証失敗が短時間に大量発生していれば不正アクセスの試行が疑われ、特定のエラーログが急増していれば障害の前兆かもしれません。リソース監視では捉えきれない振る舞いの異常を拾えるうえ、障害対応とセキュリティ対策の両方にまたがります。
IBMの2024年の調査では、データ漏洩の検知までに平均204日かかり、平均被害額は445万米ドルに達するとされています。ログから異常を早期に拾えれば、この検知遅延を短縮できます。また、SOC(セキュリティオペレーションセンター)では、SplunkのようなSIEM(ログ統合分析基盤)で多数のサーバーのログを横断的に監視し、相関分析で攻撃の兆候を検出します。
ログ監視で悩ましいのは、どのログを、どんな条件で拾うかです。すべてを通知すればノイズに埋もれ、絞りすぎれば重要なサインを見逃します。そのため、実務では対応が必要な致命的エラーや認証失敗の急増を優先し、それ以外は記録のみとするのが定石です。なお、SOCの料金例では、CECのSOCが月30万円から1,000台規模を対象とし、SHIFTのSOC運用支援は月9万円から提供されています。
外形監視が確かめる「利用者から見た応答」
外形監視は、外部の地点から実際にサービスへアクセスし、正しく応答が返ってくるか、応答時間が許容範囲内かを確認する機能です。サーバー内部のリソースが正常でも、ネットワーク経路の障害やDNSの不具合で利用者がアクセスできないことは起こり得ます。利用者が体験する状態を直接測るため、内部監視では見えない問題を捉えられます。
クラウド化が進んだ今、国内エンタープライズ・システム市場のクラウド比率は2022年で約5割に達し(IDC Japan)、クラウド基盤の障害は利用者側で手出しできません。だからこそ、自社サービスが外から正常に見えているかを独立して監視し、基盤障害をいち早く検知する自衛策が求められます。死活・リソース・ログ・外形の4つを組み合わせると、サーバーの内側から外側まで見落としの少ない監視になります。
応答時間も計測対象にし、アクセスはできても表示が極端に遅ければ、利用者は実質的に使えないと感じます。複数の地点から定期的にアクセスし、応答時間がしきい値を超えたら警告を出すよう設定すれば、性能劣化を利用者目線で捉えられます。さらに、内部のリソース監視と外形監視を突き合わせると、どこで遅延が生じているかを切り分けられ、立体的な把握につながります。
アラート通知と一次対応という機能
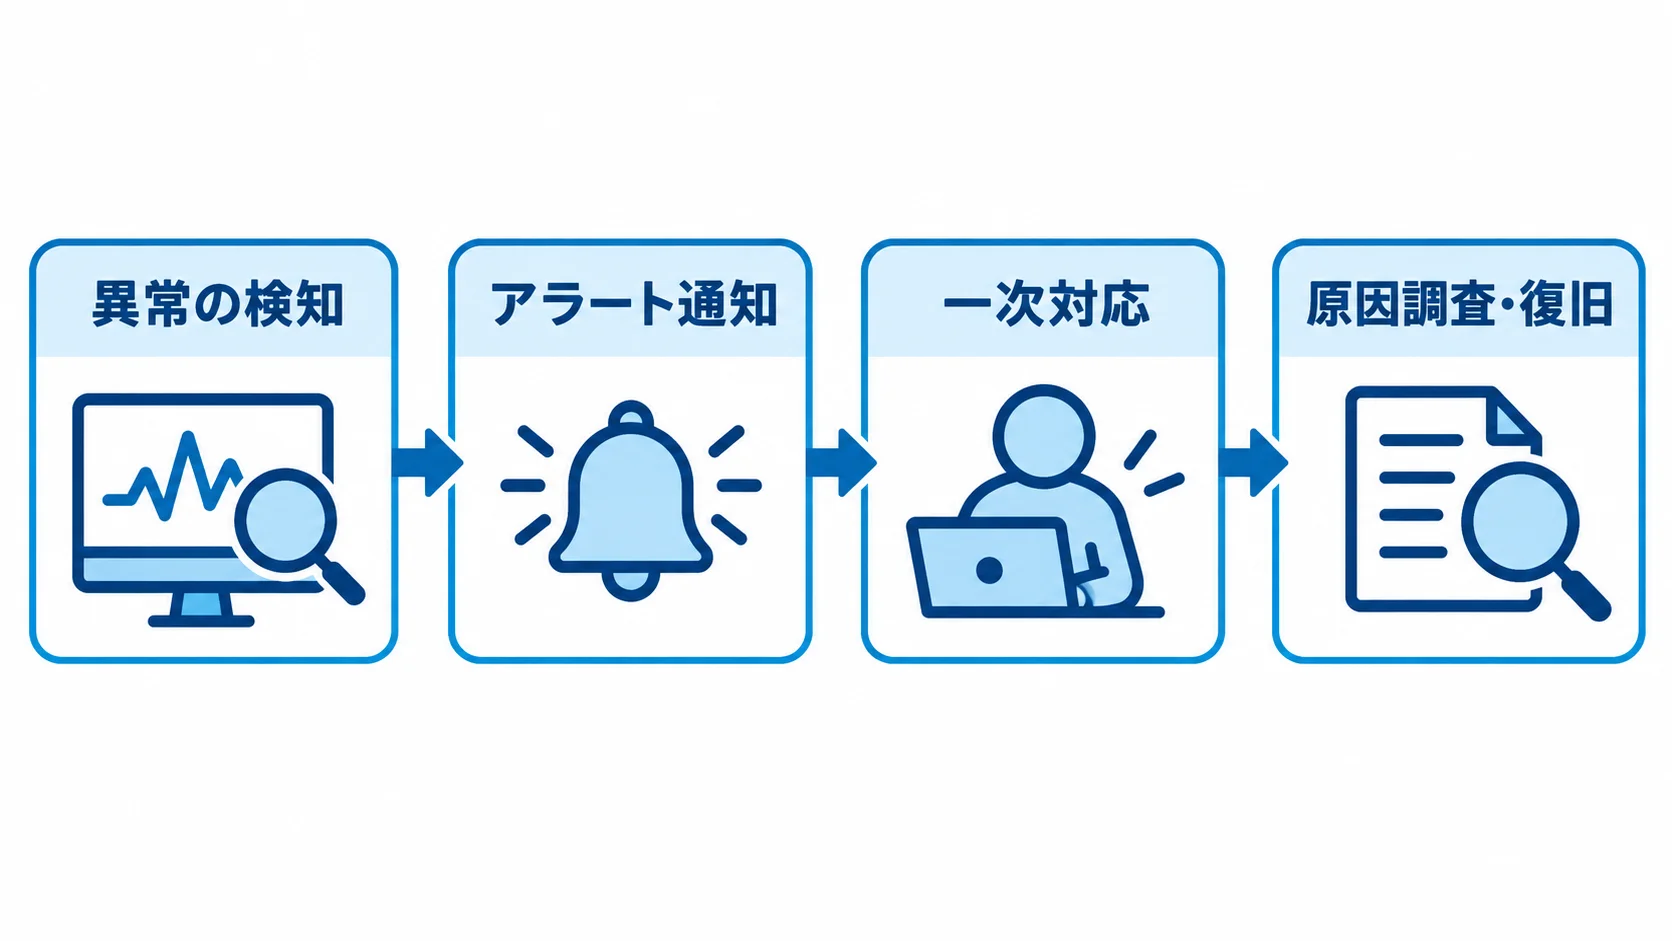
異常を検知しても、それが人に届き、適切な初動につながって初めて、監視は役立ちます。アラート通知と一次対応は、監視と障害の収束をつなぐ重要な機能です。
発注側と開発会社は、誰に、どの経路で、どのレベルの異常を通知するかを決めておく必要があります。さらに、通知を受けた側がどう動くかまで設計すると、サーバー監視は「見ているだけ」から「守れる」状態になります。
アラート通知とエスカレーションの機能
アラート通知機能は、検知した異常をメール・チャット・電話・専用アプリなど複数の経路で関係者に届けます。大切なのは、異常の重さに応じて通知の強さを分けることです。たとえば、軽微な警告は記録にとどめ、重大な障害だけを即時に電話まで上げるといった通知レベルの設計が、アラート疲れを防ぎます。
さらに、一次受けの担当者が応答しない場合に上位者へ自動的に通知を引き上げるエスカレーション機能があれば、夜間でも対応の取りこぼしを防げます。サービス会社の例では、重大なインシデントを15分以内に一次対応する保証を掲げる事業者や、検知から60分以内に通知し12時間で復旧する水準を示す事業者があります。
こうしたSLA(サービス品質保証)の数値は、通知から初動までのスピードを契約として担保するものです。通知の速さは、そのまま復旧の速さ、ひいては停止損失の小ささに直結します。アラート通知は、復旧時間を左右する中核機能だと言えます。
一次対応・原因調査・復旧という機能
アラートを受けた後の一次対応も、検知から復旧までをつなぐ運用・監視サービスの機能です。再起動やプロセスの再立ち上げ、ディスク容量の確保といった定型的な復旧は、手順書(ランブック)に沿って迅速に行われます。費用感は、営業時間内の障害対応が月3万〜8万円、24時間の緊急障害対応が月10万〜20万円、スポット対応が1件3万〜10万円が一般的です。
一次対応で復旧しなければ原因調査に進み、ログの精査やリソースの推移分析で根本原因を特定して恒久対策を講じます。特に、運用設計やインシデント分析を担う人材は監視オペレーターより高いスキルが必要で、人月80万〜120万円が相場とされます。一般的な目標として、重大障害は2時間以内に対応を開始し、原則24時間以内に完全解決する水準が置かれます。
一連の機能を内製するか委託するかは規模とコストで決まり、自社で監視オペレーターを雇えば人月60万〜80万円、24時間体制なら複数名が必要です。一方で、フルマネージドの委託なら、20,000円/台前後で検知から一次対応までを任せられます。一次対応機能は、自社で持つにせよ外注するにせよ、1台あたりのコストと停止時の損失を比べて設計する領域です。
レポート機能とAIOpsによる自動検知
サーバー監視を日々の運用改善につなげるのが、レポート機能と先進的な自動検知機能です。蓄積した監視データをグラフや一覧にまとめて傾向を読むと、増強のタイミングや潜在的なボトルネックが見えてきます。
さらに、AIOps(AIによる運用自動化)を取り入れれば、しきい値では捉えにくい異常も統計的に検出できます。これらは、標準機能の一歩先にある、運用の質を高める機能群です。
レポート・可視化機能が支える容量計画
レポート機能は、監視で集めたリソースの使用状況や障害の発生状況を、グラフや一覧にまとめる機能です。月次でCPUやディスクの使用推移を振り返れば、増強の時期を予測でき、計画的な投資判断につながります。また、障害件数やMTTR(平均復旧時間)の推移をレポートにすれば、運用改善の成果を経営層に説明する材料にもなります。
こうしたレポートは、SLA(サービス品質保証)の達成状況を確認する役割も果たします。稼働率99.9%は年間8.76時間の停止を許容しますが、実際の停止がこの範囲に収まるかをレポートで追跡すれば、契約目標を満たすかを客観的に判断できます。レポート機能は、過去を振り返るだけでなく、未来の容量計画とSLA管理を支える機能でもあります。
自社運用でも委託でも、レポートは透明性を担保します。委託先を使う場合は、月次レポートで障害件数や一次対応の所要時間、SLAの達成率を確認すると、契約どおりかが分かります。逆に、レポートが曖昧な委託先では対応の実態が見えにくく、トラブル時に「やったやらない」の議論になりがちです。そのため、発注側はどの項目をどの頻度でレポートしてもらうかを、契約段階で取り決めておくべきです。
AIOpsによる異常検知という先進機能
AIOpsは、機械学習を使って監視データから異常を自動で検出する仕組みです。固定しきい値では平常時の変動と異常を区別しにくい場面でも、過去のパターンを学習することで、通常と異なる振る舞いを統計的に捉えられます。これにより、しきい値設定の手間を減らしつつ、設定漏れによる見逃しも防げます。
AIOps相当の機能はSaaS型の上位プランで提供されることが多いため、自社の運用体制に合うツールを選ぶことが出発点になります。ツールごとに、費用の掛かり方と自社で負担する手間が大きく異なります。
- Zabbix(OSS):ライセンス無料で死活・リソース・ログ監視を一通り賄えますが、構築と維持の工数は自社で負担します。
- Datadog・New Relic:従量課金で、中規模なら月数万〜数十万円が目安です。
- Mackerel:サーバー監視に特化したサービスです。
AIOpsには、大量のアラートを相関分析でまとめ、対応すべき問題に絞り込むという代表的な役割もあります。一方で、JUAS(日本情報システム・ユーザー協会)の調査では、AI活用について約78%が検討中・未検討の段階にあり、現場ではまだ手探りの企業が多いのが実情です。
AIOpsは、すべての企業が一気に導入すべきものではありません。そのため、中小企業では、基本の死活・リソース監視を固めたうえで、既存の監視にAIOpsを部分的に取り入れ、効果を見極めながら範囲を広げるスモールスタートが現実的です。
まとめ
ITシステムのサーバー監視が提供する機能は、大きく4つのまとまりで捉えられます。基本となるのは死活監視とリソース監視で、内部の振る舞いと利用者から見た応答を見るのがログ監視と外形監視です。検知を行動につなげるのがアラート通知と一次対応、運用を改善するのがレポート機能とAIOpsです。
死活監視は「すでに起きた停止」を、リソース監視は「これから起きる停止」を捉えます。そして、ログ監視と外形監視が内部からは見えない異常を拾い、アラート通知と一次対応・原因調査・復旧が障害を収束へ導きます。
これらが連動して初めて、サーバー監視は実効性を持ちます。機能を選ぶときは、すべてを揃えることより、自社のサーバー構成と事業影響度に見合った組み合わせを見極めることが大切です。
そのため、まずは死活監視とリソース監視を固め、必要に応じてログ監視と外形監視、AIOpsへと段階的に重ねていくのが現実的です。riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムの特性に合った監視機能の設計から、作ったあとの運用までを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
開発を相談する前に、業務システム開発とAI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。