
サーバー監視を入れていたのに、いざ障害のときに役立たなかったという失敗は珍しくありません。落とし穴は、死活監視への過信、監視対象の漏れ、閾値の固定化、監視基盤そのものが止まることの四つです。
全体像から知りたい方は、先にITシステムサーバー監視の完全ガイドを読むのがおすすめです。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
死活監視への過信とリソース枯渇の見逃し
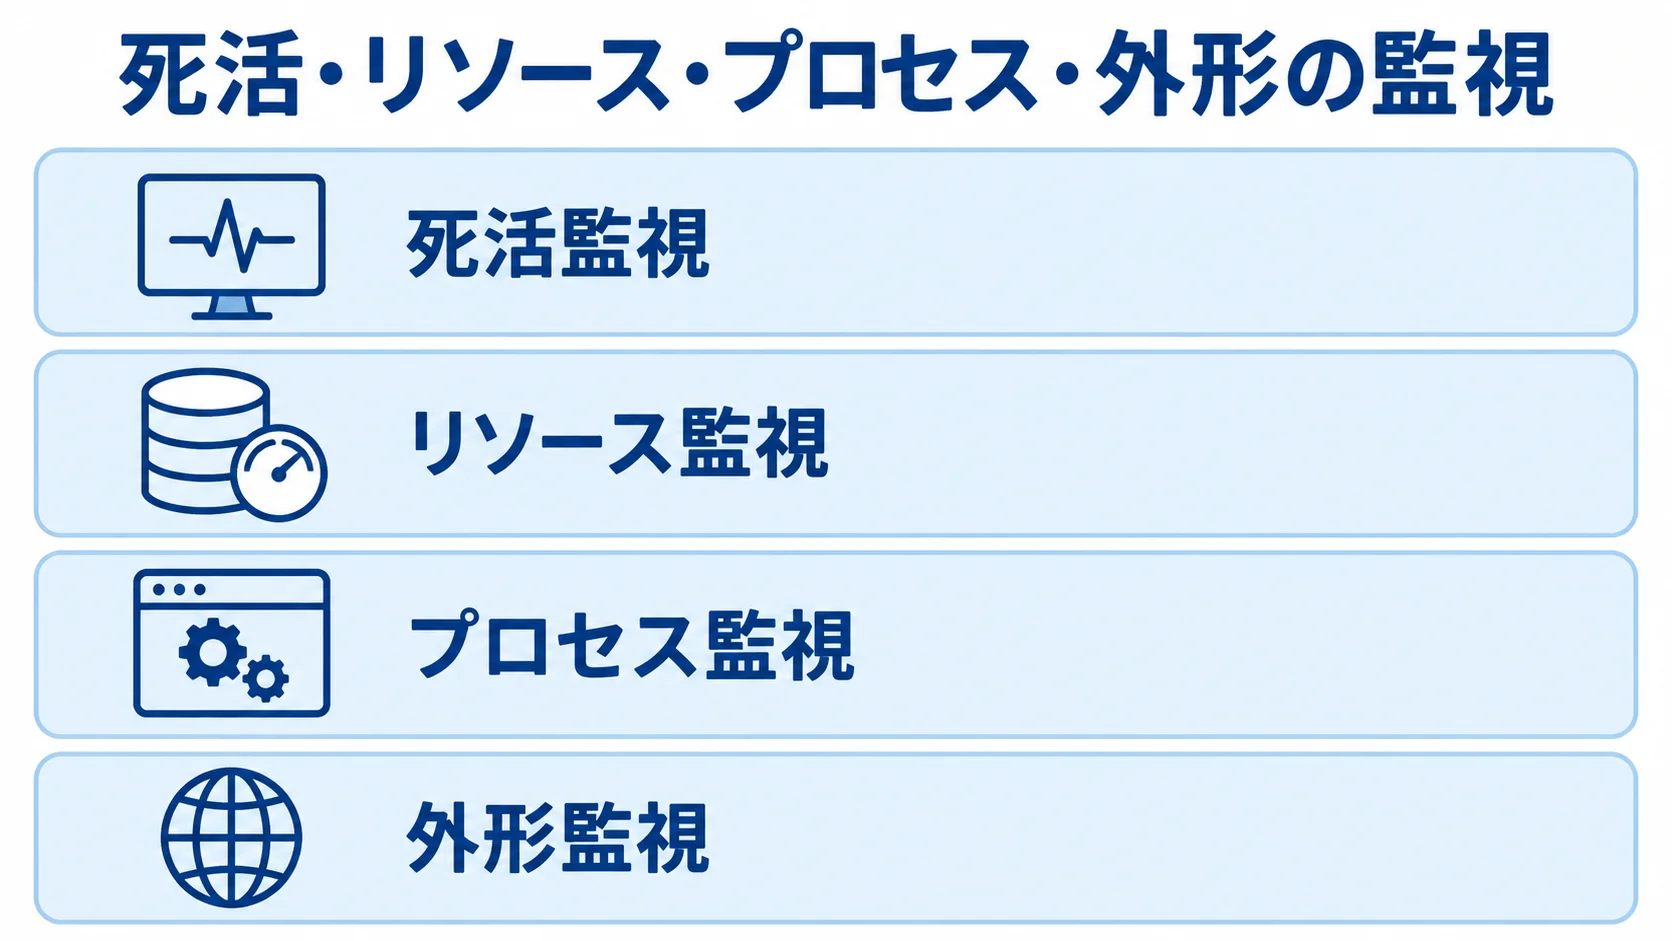
サーバー監視で多い失敗は、死活監視だけを入れて安心してしまうことです。「サーバーは生きている」という応答が返ってきても、その裏でリソースが枯渇しかけている兆候は見えません。
死活監視は最低限の確認にすぎず、落ちる前の予兆は捉えられません。厄介なのは、死活監視が緑を返している間、現場は問題なく稼働していると思い込んでしまう点です。
実際には、ディスクが満杯に近づき、メモリが逼迫していても、ping応答さえ返っていれば監視画面は正常に見えます。緑色の安心感が、かえって危険な兆候を覆い隠してしまうのです。死活監視への過信は、主に二つの見逃しにつながります。
ディスク満杯やメモリ枯渇を見逃す失敗
死活監視だけに頼ると、サーバーが応答している裏でディスクが満杯になり、ある瞬間に書き込みができずサービスが止まる、という失敗が起きます。
ログやテンポラリファイルが少しずつ溜まり、数週間後に容量を使い切ることもあります。死活監視は最後の瞬間まで「正常」を返し続けるため、誰も気づかないまま停止に至ります。
メモリ枯渇でプロセスが強制終了される場合も、生きているかどうかだけでは捉えられません。
この失敗を防ぐには、死活監視に加えてリソース監視を必ず組み合わせることが欠かせません。危険水域に近づいた段階でアラートを出せるよう、リソースの推移を継続して取得します。
停止1回あたりの平均損失は1,200万円(総務省2025年版)、1分あたりでは5,600米ドル(Gartner 2024)という統計があります。こうした損失を踏まえると、ディスク満杯を数日前に検知できる価値は計り知れません。
ディスク使用率とメモリ使用量を見ておくと、死活監視では見えない予兆を停止の手前でつかめます。
- ディスク使用率:増加の傾向を見て、満杯になる時期の目安をつかむ
- メモリ使用量:死活とは別に、逼迫していないかを確認する
プロセス停止をサーバー稼働と混同する失敗
もう一つの過信は、サーバーが起動していればサービスも動いていると思い込むことです。たとえば、サーバー自体はpingに応答していても、その上で動くアプリケーションのプロセスが落ちていれば、利用者から見ればサービスは停止しています。
死活監視はサーバーの電源が入っていることしか確認できず、肝心のサービスが提供されているかまでは見ていません。この層のずれが、検知の盲点を生みます。
この失敗を防ぐには、死活、リソース、プロセス、外形を多層で組むことが基本です。監視が「何を確認しているか」の層を意識していないと、生きているという表面的な確認で満足し、利用者が直面している障害に気づけません。中でも、サービスそのものが動いているかは、プロセス監視と外形監視で確かめられます。
- プロセス監視:サービスに欠かせないアプリケーションが動いているか
- 外形監視:利用者が使う入口が、正しく応答を返すかどうか
監視対象の漏れとスケールアウトの盲点
サーバー監視で見落とされがちな失敗が、監視対象そのものの漏れです。導入時には全サーバーを登録していても、運用が進むうちに追加したサーバーが監視から抜け落ちることがあります。
台数が増えるほど、こうした漏れが生じる場面も増えます。とくに、監視していないサーバーで障害が起きても、当然ながら誰も気づけません。
新設サーバーが監視登録から漏れる失敗
システムの拡張で新しいサーバーを追加したとき、監視ツールへの登録を忘れる失敗は頻繁に起きます。構築作業に追われるうちに稼働させることが目的になり、監視の設定が後回しになってしまいます。
新設サーバーは、監視されないまま本番に投入され、そこで障害が起きても検知できません。
台数あたりの課金(バルクサーバーの監視5,000円/台など)を意識するあまり、コスト削減で監視を意図的に省くと、その判断が後で痛手になることもあります。
この失敗を防ぐには、サーバーの新設・廃止と監視登録を連動させる手順を運用に組み込むことが大切です。監視は「最初に全部入れた」で終わりではなく、構成変更のたびに更新し続けてこそ網羅性を保てます。
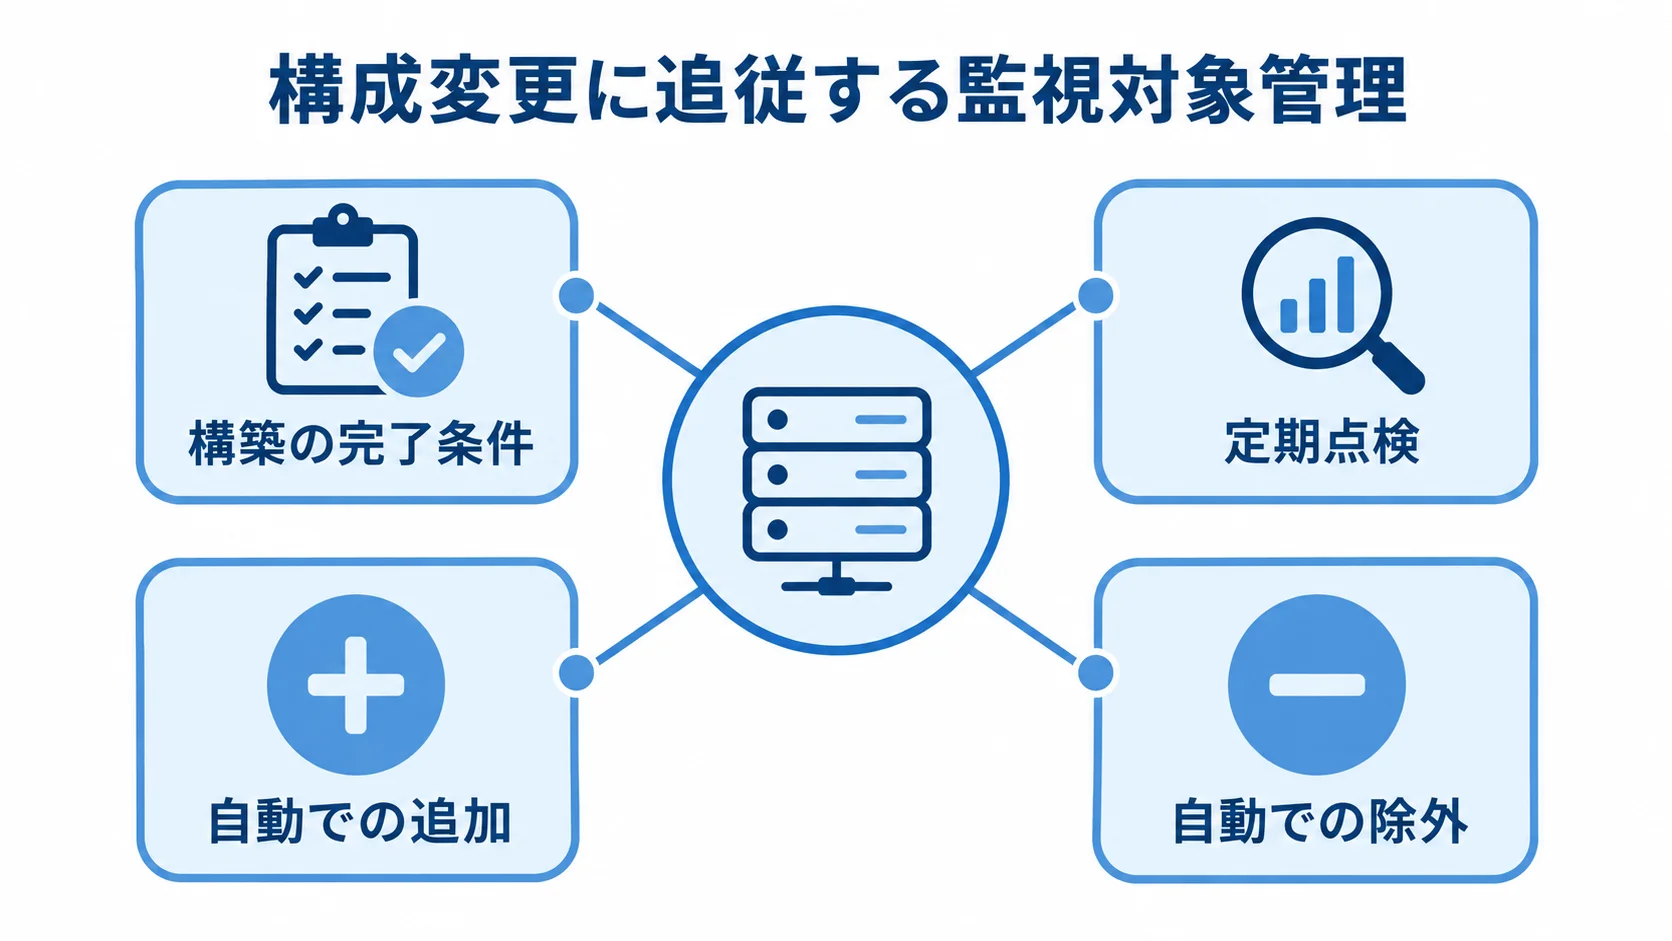
台数管理と監視管理を切り離すと、いつの間にか監視されないサーバーが増えていきます。漏れは、構築を終える時点と、定期的な点検の二つの場面で防げます。
- 構築の完了条件:監視登録の確認を、サーバー構築を終える条件に加える
- 定期点検:稼働中のサーバー一覧と監視対象一覧の差分を洗い出す
スケールアウトで増えたサーバーを取りこぼす失敗
クラウド環境では、負荷に応じてサーバーが自動で増減するスケールアウトが一般的です。その際に起きやすいのが、自動で立ち上がったサーバーが監視対象に組み込まれず、取りこぼされる失敗です。
監視の登録を手動で行う運用のままだと、自動で増えたサーバーの登録が追いつかず、ピーク時に増えたサーバーで障害が起きても気づけません。固定台数を前提にした監視設計は、動的な環境で破綻しやすいのです。
この失敗を防ぐには、サーバーの増減に監視が自動で追従する仕組みを整えることが大切です。手動運用に固執すると、動的にスケールする環境では必ず監視の穴が生まれます。
クラウドの俊敏さを活かすなら、監視も同じ速さで追従させる発想が欠かせません。静的な台数を前提に監視を組んだまま動的な環境に持ち込むことが、スケールアウト時代の典型的な落とし穴です。監視が追従するには、増えたサーバーを自動で加え、止まったサーバーを自動で外す、この二つが要ります。
- 自動での追加:立ち上がったサーバーが、リソース監視の対象に自動で加わる
- 自動での除外:停止したサーバーが、監視対象から自動で外れる
責任分界点の曖昧さで監視が空白になる失敗
クラウド環境では、監視対象の漏れが「責任の境界」のところで起きやすくなります。クラウドの責任共有モデルでは、基盤の可用性はクラウド事業者が担いますが、その上で動くOSやミドルウェア、アプリケーションの監視は利用者の責任です。
ところが「クラウドだから全部見てくれている」と思い込み、利用者責任の領域の監視を忘れてしまうケースが後を絶ちません。基盤は無事でも、自社アプリのプロセス停止やディスク逼迫を誰も見ておらず、障害に気づけない空白が生まれます。
この失敗を防ぐには、契約や利用規約で定められた責任分界点を正確に把握し、利用者側の領域に監視が行き渡っているかを点検することが欠かせません。
委託している場合も、この分界点の認識をベンダーと擦り合わせておく必要があります。そうしないと、双方が「相手が見ているはず」と思い込む空白地帯が生まれます。分界点の整理は、次のように進めます。
- 責任の一覧:どこまでがクラウド事業者の責任か、どこからが自社の責任かを分ける
- 自社領域の監視項目:一覧で自社の担当になった範囲に、監視項目を埋めていく
閾値の固定化とキャパシティプランニング不在
サーバー監視のもう一つの失敗は、最初に決めた閾値を固定したまま放置し、将来のキャパシティ計画につなげないことです。監視を「異常を知らせる仕組み」としか捉えず、蓄積したリソースの推移を増設判断に活かせていないケースは少なくありません。
閾値の固定化は誤検知や検知漏れにつながり、キャパシティ計画の不在は突然のリソース上限到達という後手の対応を招きます。この二つは別々の問題に見えますが、原因は同じです。どちらも、監視で得たデータを継続的に活かす運用が回っていないことから生じます。
導入時に設定して以降、誰もデータを振り返らないまま日々が過ぎると、閾値もキャパシティ計画も実態から取り残されていきます。監視を手入れし続けられているかどうかが、閾値と計画が実態に合うかを分けます。
成長に閾値が追いつかず誤検知が増える失敗
サーバーの負荷はサービスの成長とともに変わります。導入時に適切だったCPUやメモリの閾値も、アクセスが増えれば実態と合わなくなります。
これを放置すると、平常時でも閾値を超えて誤検知が頻発し、やがて担当者がアラートを無視し始める形骸化につながります。逆に、緩すぎる閾値のまま放置すると、危険水域に入っても検知が遅れます。固定された閾値は、時間が経つほどシステムの実態から乖離していきます。
この失敗を防ぐには、閾値を定期的に見直す運用を組み込むことが大切です。月次でリソースの推移を振り返り、平常時の水準が変わっていれば閾値を調整します。
閾値は一度決めて終わりではなく、継続して見直してこそ意味を持ちます。見直すときは、役割ごとに閾値を分けることと、委託先の契約範囲に見直しが入っているかを確かめます。
- 役割ごとの閾値:Webサーバーとデータベースサーバーに、同じ値を当てない
- 委託先との契約:閾値の見直しと改善提案が、契約の範囲に含まれているか
監視データを増設判断に活かさない失敗
サーバー監視で蓄積したリソースの推移データは、本来キャパシティプランニング、つまり「いつ増設すべきか」の判断材料になります。ところが、監視を異常通知だけに使い、推移の分析を怠ると、ある日突然リソースが上限に達し、慌てて増設する後手の対応になります。
計画的な増設なら余裕をもって進められたものが、緊急対応になればコストも障害リスクも跳ね上がります。監視データを使わないことは、見えるはずの未来を見ないことと同じです。
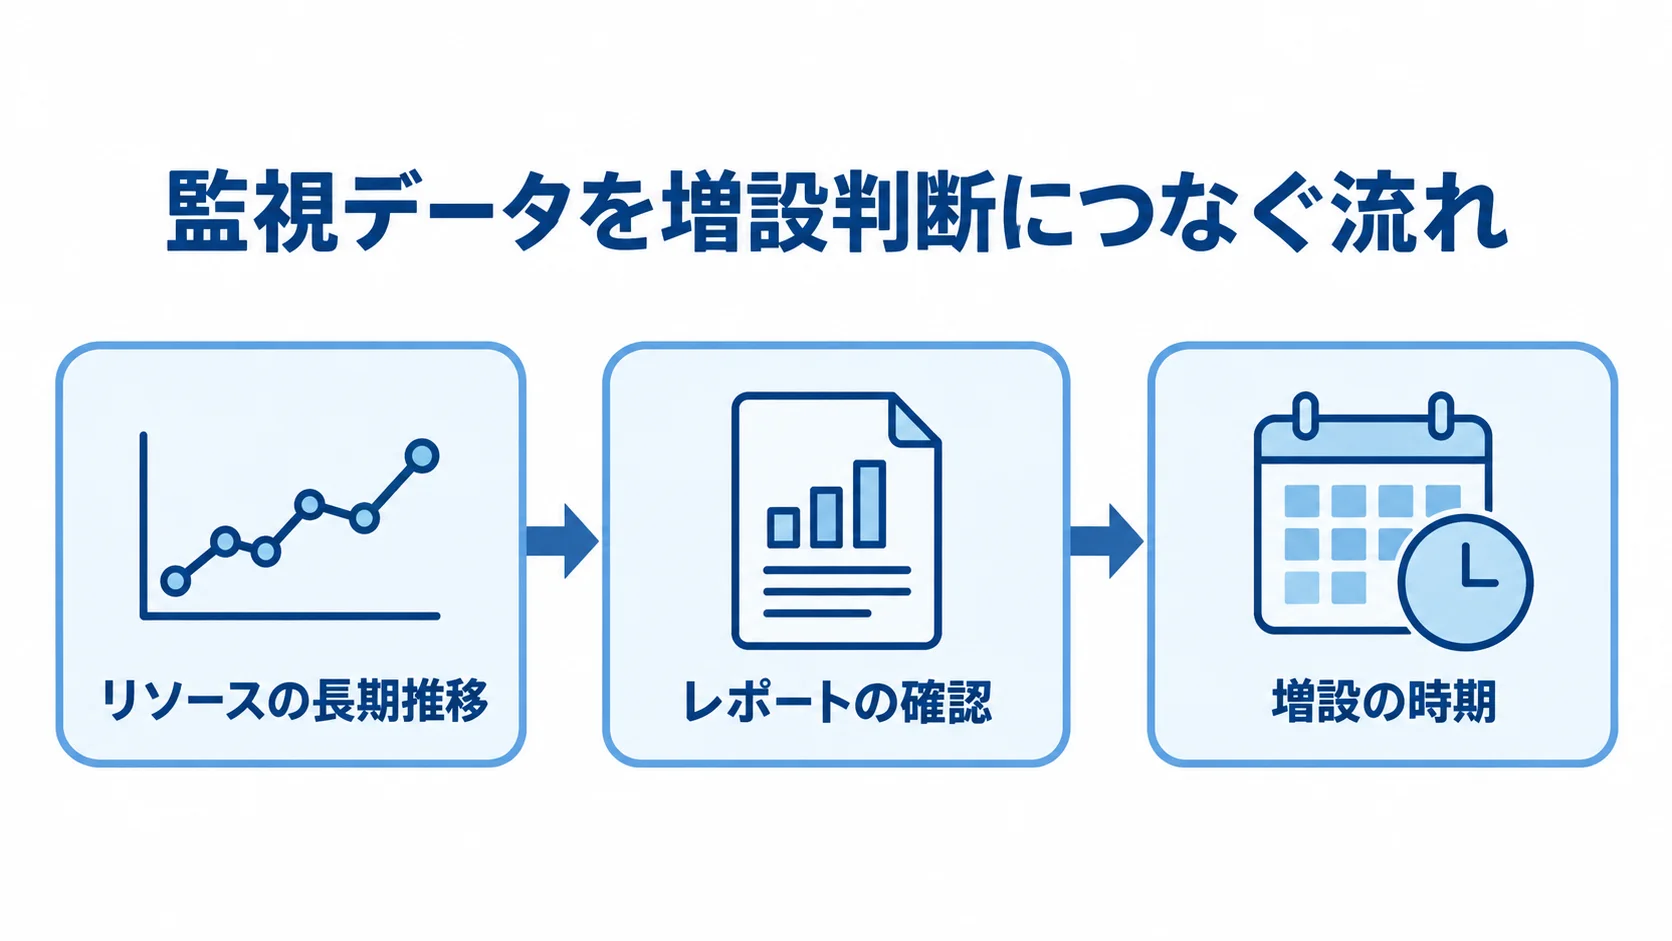
この失敗を避けるには、レポート機能でリソースの長期推移を追い、増設の必要時期を予測する運用を組み込むことが大切です。たとえば、ディスク使用率が右肩上がりなら、いつ満杯になるかを推計し、計画的に増設や整理を進めます。
監視は、いま異常かを知るだけでなく、この先どうなるかを読むためにも使えます。蓄積したデータを増設判断に結びつけられないと、サーバー監視の価値を半分しか使えていないことになります。推移データを増設判断に生かすには、レポートで先の見通しを立て、増設の時期を前もって決めておく必要があります。
- レポートの確認:リソースの長期推移を定期的に見返す
- 増設の時期:上限に達する前に、増設するタイミングを決める
監視基盤そのものの単一障害点化
最後に取り上げるのは、見落とされがちな失敗で、監視する側の基盤が落ちるリスクです。サーバーを監視する監視サーバー自身が停止すれば、何も検知できなくなります。監視は他のサーバーを見張る役割ですが、その監視サーバー自体を誰が見張るのか、という視点が抜け落ちがちです。
この失敗が怖いのは、起きていることに気づきにくい点です。監視対象のサーバー障害なら、利用者からの問い合わせなどで遅れても発覚しますが、監視基盤の停止は「アラートが鳴らない」という静けさとして現れます。
沈黙は問題がないことの証ではなく、監視そのものが止まっている可能性を含みます。見落としは、静かなリスクと、委託時に発注者が担うべき初動の責任の二つです。
監視サーバーが落ちて検知できなくなる失敗
監視サーバーやエージェントの集約基盤が停止すると、すべての監視が一斉に機能を失います。アラートが来ないことを「異常がない」と勘違いし、実際には監視自体が止まっていた、という最悪の失敗が起こり得ます。
沈黙は正常を意味しないのに、アラートが鳴らないことに安心してしまいます。これは監視の自己監視、つまり監視基盤自身の死活確認が抜けているために起きる落とし穴です。
この失敗を防ぐには、監視基盤そのものを別系統で監視する仕組みが必要です。監視サーバーが定期的に「自分は生きている」という信号を外部へ送り、その信号が途絶えたら別経路で通知する、という二重化です。
どちらの方法でも、監視の沈黙を疑える設計が欠かせません。自前構築かSaaS型かによって、監視の沈黙を疑う際に注意する点が変わります。
- 自前構築(OSSのZabbixなど):冗長化や自己監視も自社で設計し、構築・維持の工数が人件費に跳ね返る
- SaaS型:サービス自体の可用性に依存する前提を理解しておく
委託丸投げで検知後の初動が崩れるリスク
サーバー監視を外部に委託する場合の失敗は、検知後の初動まで丸投げできると思い込むことです。監視ベンダーがサーバーの異常を技術的に対応しても、社内の経営層や業務部門への報告、顧客への告知の判断は、発注者である情シスの役割です。
ここで「ベンダーが対応しているから大丈夫」と社内共有を怠ると、報告が遅れ、対外対応が後手に回って二次被害を招きます。安すぎる委託契約では、そもそも一次対応や原因調査が範囲外になっていて、検知だけして放置される場合もあります。
この失敗を避けるには、障害が起きる前に動き方を決めておくことが不可欠です。監視は「気づく仕組み」にすぎず、気づいた後にどう動くかは発注者の備えが担います。
運用・監視が月5万〜20万円、24時間緊急の障害対応が月10万〜20万円という相場を下回る提案は、対応範囲の欠落を疑うべきです。
riplaはフルスクラッチ受託と国内運用保守の立場から、サーバー監視の設計だけでなく、検知後の初動や報告フローまで継続して伴走しています。
失敗を避けるには、監視の導入と合わせて動ける体制まで整えておく必要があります。委託では、検知の後の対応範囲と、社内で誰が報告し判断するかを先に決めておきます。
- 委託範囲とSLA:検知の後の対応まで含むかを、契約の段階で明確にする
- 社内のエスカレーション:検知後に、誰へ報告し、誰が判断するかを平時に定める
まとめ
サーバー監視の失敗・リスクを振り返ると、落とし穴は四つに集約されます。死活監視だけに頼ってリソース枯渇やプロセス停止を見逃す過信と、新設やスケールアウト、責任分界点で監視対象が漏れる盲点です。
また、閾値を固定したままキャパシティ計画につなげない失敗と、監視サーバー自身が落ちて検知できなくなる単一障害点化があります。いずれも技術というより、監視設計・運用・社内体制の問題であり、事前に知っていれば避けられるものばかりです。
共通するのは、監視を一度組んで終わりにせず、構成の変化に合わせて手入れし続ける運用があるかどうかです。
失敗を避けるには、死活確認で終わらせず、リソースやプロセスまで多層で監視し、対象を網羅し、閾値を継続して見直し、監視基盤も自己監視することが必要です。検知後の初動体制まで一貫して整えることも欠かせません。
加えて、クラウドの責任分界点を正しく把握し、利用者責任の領域に監視の空白を残さないことも大切です。これらはいずれも、監視で得たデータを使い続けられるかにかかっています。
監視は気づく仕組みにすぎず、気づいた後に誰がどう動くかまで設計して初めて、事業継続に役立ちます。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムの構造を踏まえた監視設計から、障害時の初動と報告フローまでを一貫して支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。