
ITシステムのログ監視を導入しようと考えるとき、事例で見るべきなのは、ログが対応につながって成果を出したかどうかです。予兆検知や委託、ログ基盤の集約などの事例を、発注側の視点で紹介します。
全体像をまだ把握していない方は、まずITシステムログ監視の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステムログ監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ログの予兆検知で夜間障害を未然に防いだ事例
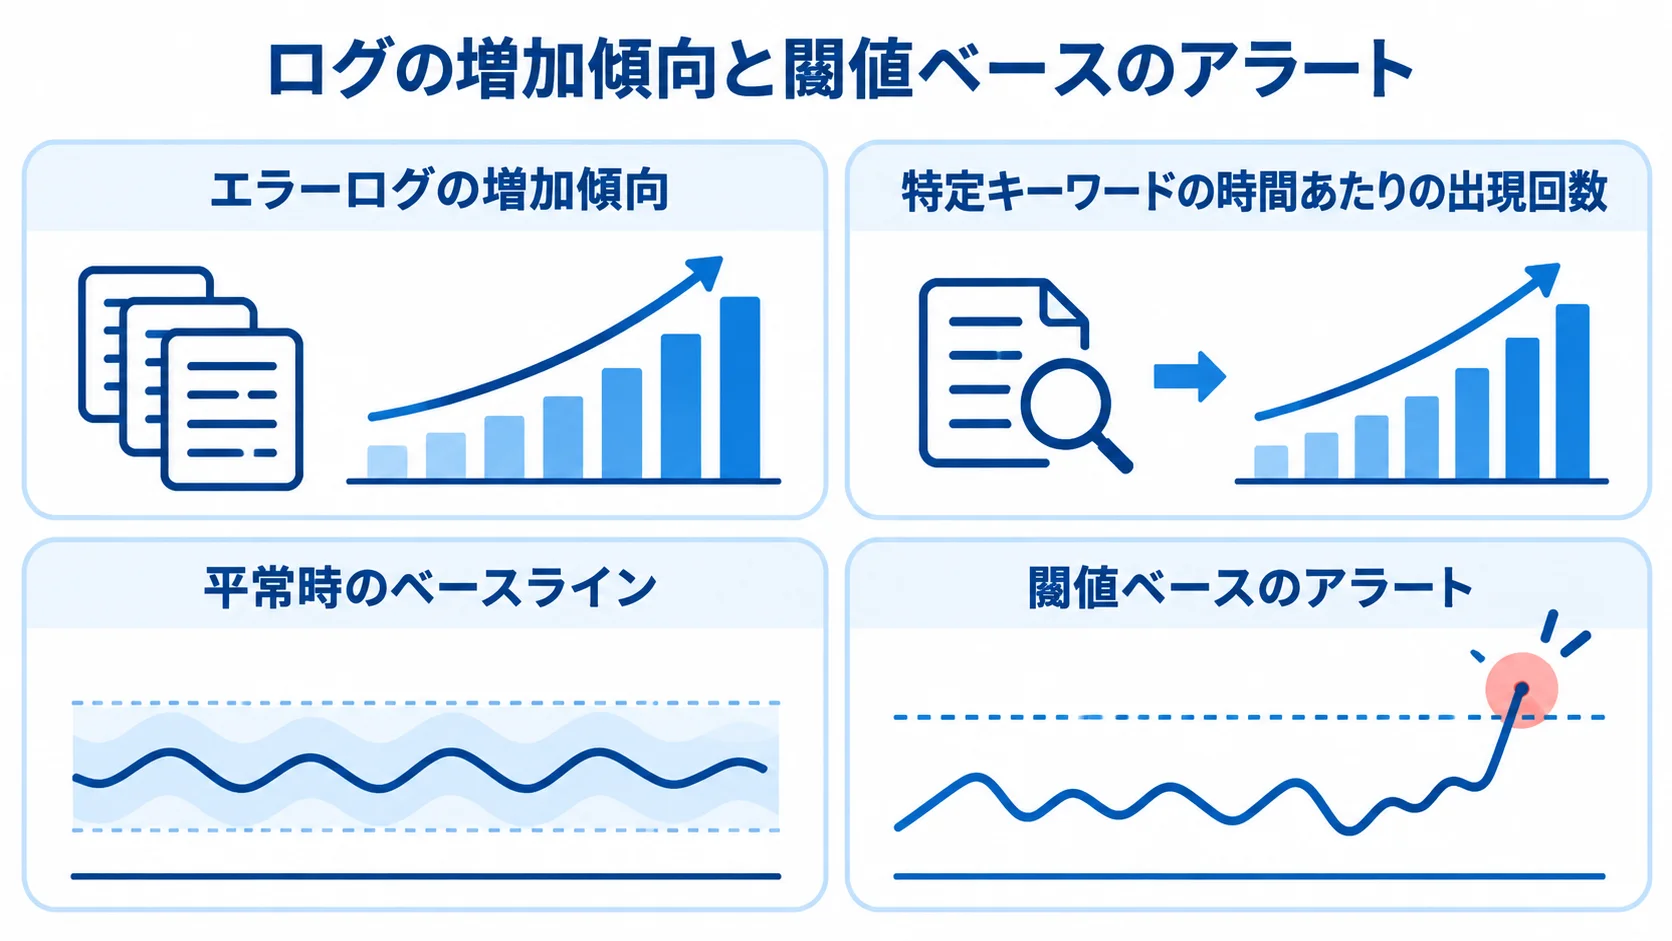
ログ監視でもっとも分かりやすい成果は、障害が表面化する前に予兆を捉えられることです。死活監視はサーバーが生きているかという結果を見るのに対し、ログ監視はエラーメッセージや警告の増加といった「結果に至る過程」を捉えます。この違いが、夜間や休日の無人時間帯で障害を未然に防ぐ決め手になります。
予兆検知が実際にどう機能したかを、事例で見ていきます。
エラーログの増加傾向からディスク枯渇を先回りした事例
あるECサイト運営企業の事例では、深夜のバッチ処理が出力する警告ログが、数日かけて少しずつ増えていく傾向を、ログ監視が捉えました。単発では見逃されがちな「ディスク使用率の警告」も、閾値ベースのアラートで担当者へ通知されました。
その結果、ディスクが完全に枯渇してサービスが止まる前に、増設の対応ができました。総務省2025年版の統計では、金融・医療・EC系で5分以上の停止が1回起きると、平均1,200万円の機会損失が生じるとされています。さらに、この未然防止の1回だけでも、監視費用を上回るリターンになりました。
この事例の特徴は、単一のエラーを検知したのではなく、ログの増加傾向というパターンを捉えた点にあります。一行ずつ見ていては気づきにくい緩やかな悪化も、件数を集計して傾向を見ることで浮かび上がらせられます。この点が、死活監視や性能監視だけでは得にくい先回りの価値になります。
ログの増加傾向を捉えるには、次の2つの設計が効きます。
- 集計:特定キーワードの時間あたりの出現回数
- 比較:平常時のベースラインから外れた時点でのアラート
無人時間帯のアラート自動通知で初動を早めた事例
夜間や休日に情シスが常駐しない中小企業では、ログに異常が記録されても誰も気づかない時間が致命傷になります。ある製造業の事例では、ログ監視ツールが特定のエラーパターンを検知した瞬間に、当番担当者のスマートフォンへチャットとメールで自動通知する仕組みを構築しました。
これにより、従来は翌朝の出社後に発覚していた障害の予兆を、発生から数分以内に把握できるようになりました。この事例で効果を大きくしたのは、通知の「絞り込み」でした。
すべてのログを通知すると、担当者が慣れてしまい、本当に重要なアラートを見逃す「アラート疲れ」が起きます。そこで重大度を3段階に分け、重大度に応じて通知の扱いを使い分ける運用に整理しました。
- 即時通知:サービス停止に直結するレベルの重大度
- 翌営業日にまとめて確認:警告レベルの重大度
ログの自動通知により、一般的な障害対応の目標である「重大障害2時間以内の対応開始」を無理なく達成できた好例だと言えます。
ひとり情シスがログ監視を委託して属人化を解消した事例
ログ監視は24時間365日続く業務で、ひとり情シスや少人数のチームが自前で抱えるには負荷が大きすぎます。担当者が一人で属人的に監視していると、その人が休んだ日や退職したときに、ノウハウごと監視体制が崩れてしまいます。
外部のMSP(マネージドサービスプロバイダ)へ委託して属人化を解消し、本来の企画業務に集中できるようになった事例を見ていきます。
監視オペレーターの内製コストと委託費を比較した事例
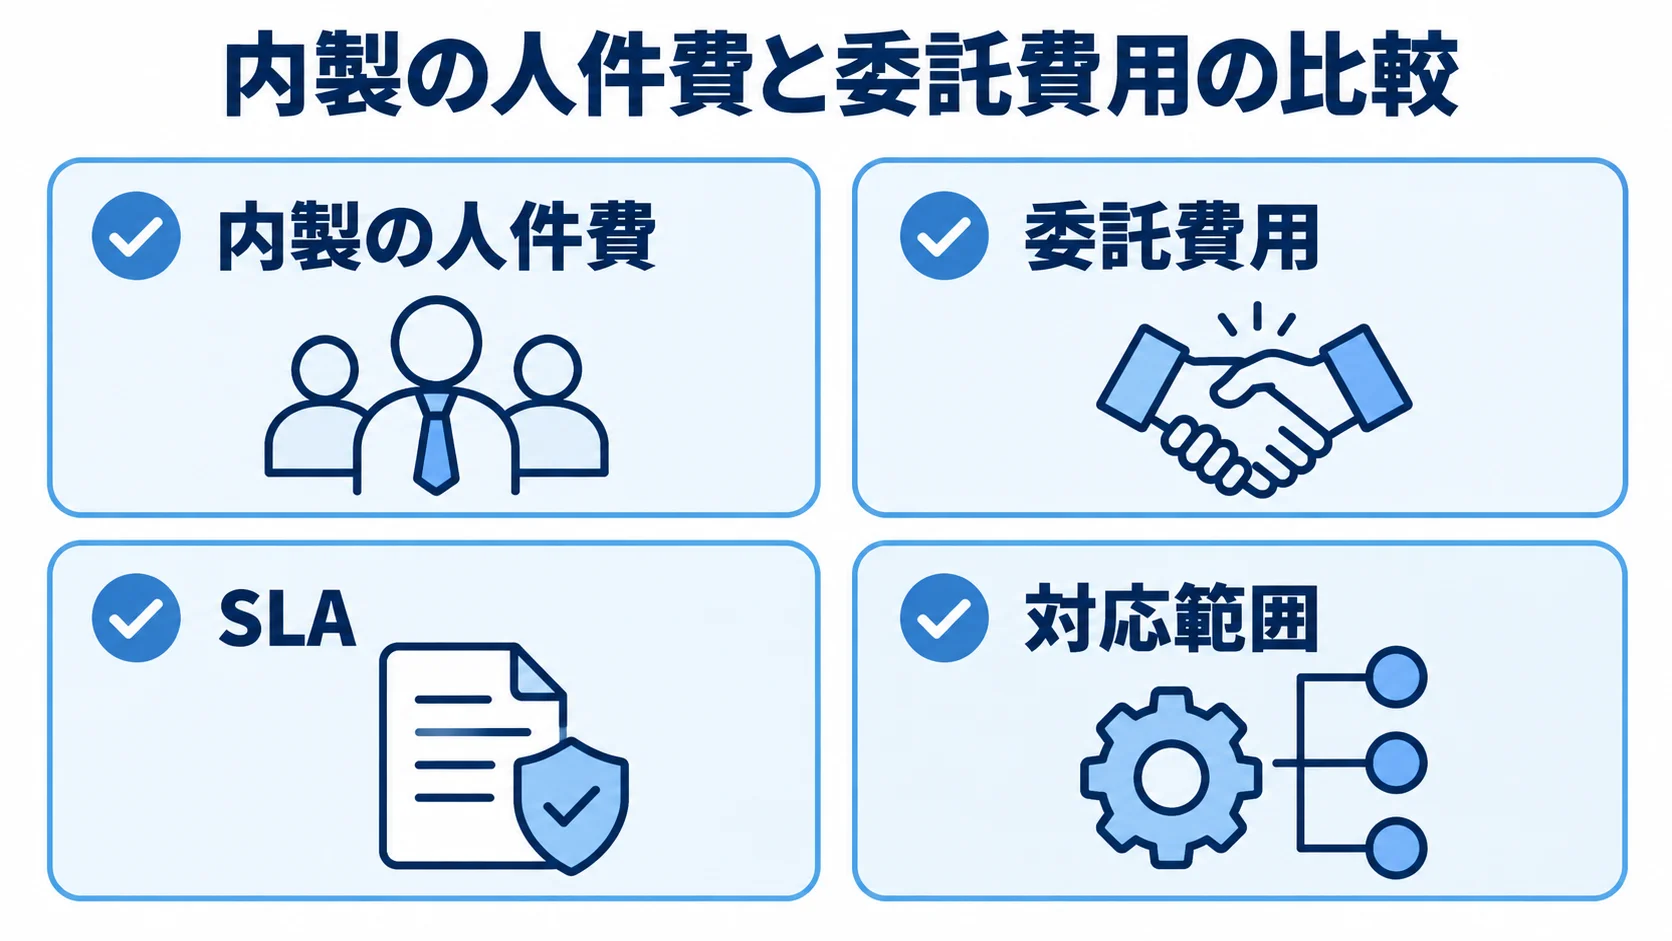
あるサービス業の情シス担当者は、24時間のログ監視を内製で回す場合のコストを試算しました。監視オペレーターの人月単価は業界一般で60万〜80万円とされ、24時間365日のシフトを組むには最低でも4〜5名体制が必要になります。
単純計算では、年間3,000万円を超える人件費がかかります。これに対し、委託の費用相場は、運用・監視(24/365の死活・リソース監視)で月5万〜20万円と桁が違いました。
この企業は、バルクサーバーのような事業者の料金体系も比較しました。監視5,000円/台、障害対応10,000円/台、フルマネージド20,000円/台(いずれも月額)という単価を、自社のサーバー台数に当てはめて見積もりを取りました。
比較の結果、企業は内製の数分の一のコストで24時間体制を確保できると判断しました。
この比較で見落としやすいのは、人件費以外の要素です。次の2つも含めて総コストを評価すると、比較の精度が上がります。
- 採用・教育:監視オペレーターを確保し、育てるための費用
- 退職リスク:担当者が抜けたときに、監視体制が崩れる影響
委託時にSLAと対応範囲を明文化して品質を担保した事例
委託で成功した事例に共通するのは、契約時にSLA(サービス品質保証)と対応範囲を明文化したことです。この企業は、「重大なインシデントは15分以内に一次対応を開始」「検知から60分以内に通知」といった応答時間を契約に盛り込みました。
この設定は、Cloud Naviが重大issueに15分以内の一次対応を保証し、シーズホスティングが検知から60分以内に通知するといった、一次データの水準を参考にしたものです。
委託で起きがちな失敗は、「監視はしているが、何をもって異常とするか」の定義が曖昧なまま、結局アラートが上がらないことです。この事例では、丸投げせずに役割を次のように分けたことが、品質担保につながりました。
- 設計(自社):どのログを、どの閾値で、誰に通知するかの定義
- 運用(委託):監視の実行と、定めた応答時間での一次対応
ログ基盤を集約してMTTRを短縮した事例
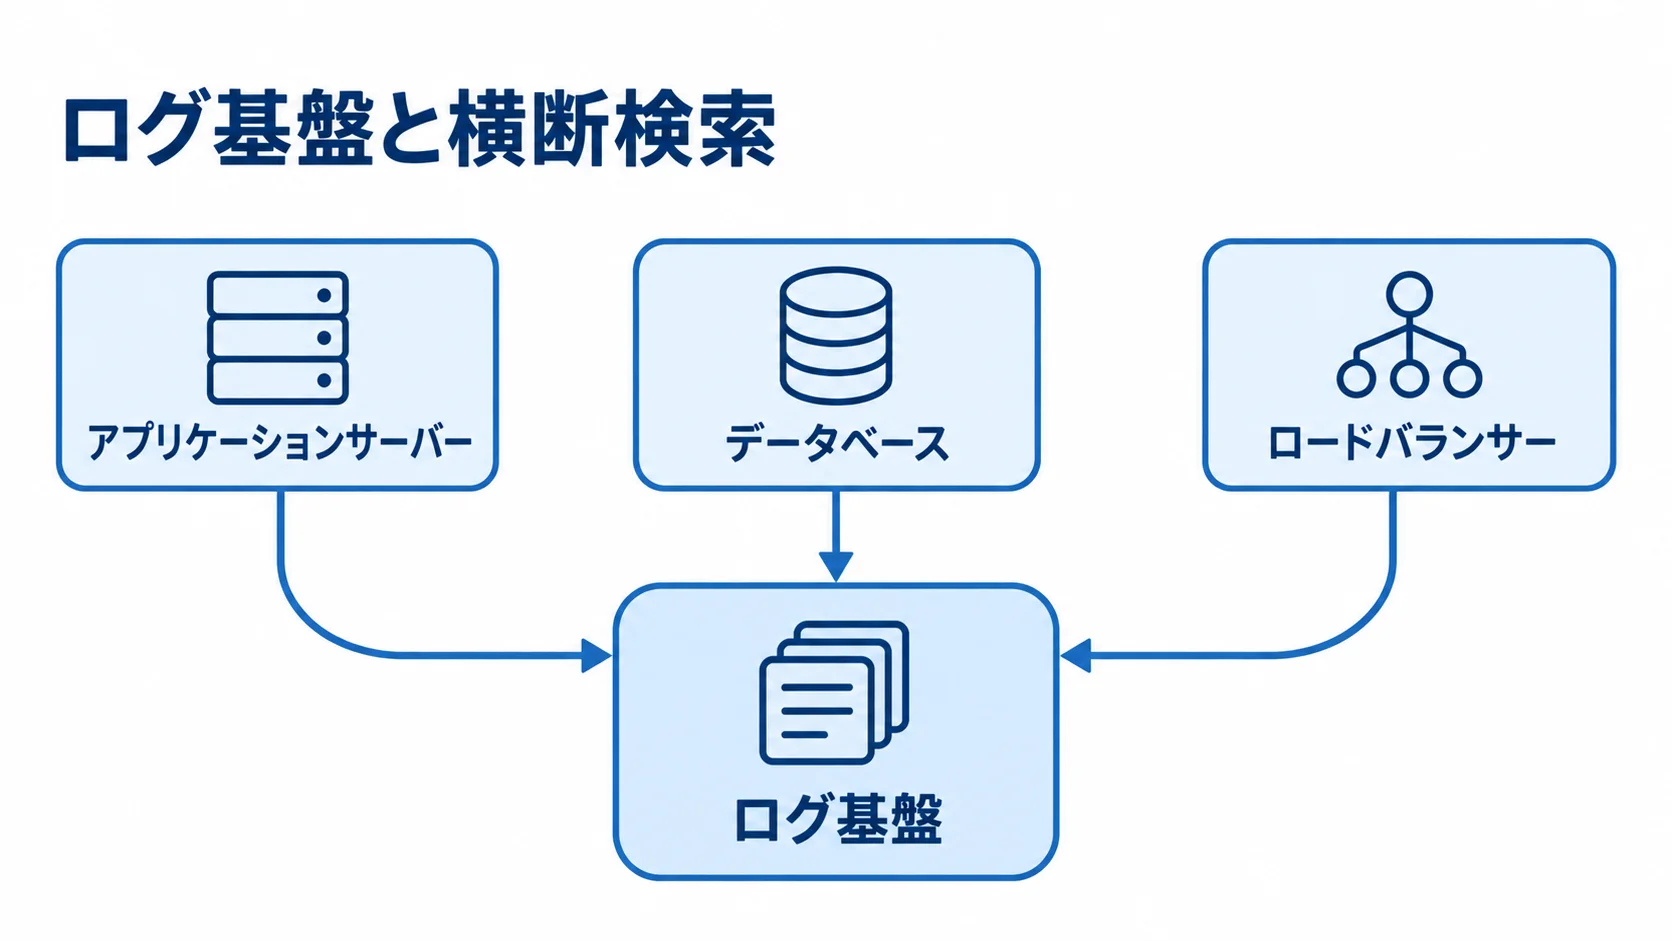
システムが複数のサーバーやマイクロサービスに分散すると、障害の原因を究明するには、複数のログを横断的に追う必要があります。ログがサーバーごとにバラバラに保存されていると、調査のたびにSSHで各サーバーに入り、grepで検索するという非効率な作業が発生します。
ここでは、ログを一箇所に集めて原因究明を速め、MTTR(平均復旧時間)を短縮した事例を見ていきます。
分散ログを集約し横断検索で原因究明を高速化した事例
あるWebサービス事業者は、複数台のアプリケーションサーバーとデータベース、ロードバランサーのログを、一つのログ基盤へ集約しました。集約前は、障害が起きるたびに各サーバーへ個別にログインして調べていたため、原因の特定に数時間かかることも珍しくありませんでした。
集約後は、時刻とリクエストIDをキーに全サーバーのログを横断検索できるようになり、リクエストがどこで詰まったかを数分で追えるようになりました。
この高速化は、ダウンタイム損失の削減に直結しました。Gartnerの2024年の調査では、ダウンタイムは1分あたり5,600米ドルの損失とされています。
MTTRを数時間から数十分へ短縮できれば、1回の障害で数百万円規模の損失を抑えられます。また、ログ集約の投資は、この損失削減で十分に回収できるという計算が、稟議を通すうえで強力な根拠になりました。
横断検索の価値は、次の2つのどちらで語るかで、経営層への伝わり方が変わります。
- 便利さ:調査が速くなったことを示す説明
- 停止時間の短縮による金額:ダウンタイム損失の削減額で示す説明
OSSとSaaSを使い分けてログ基盤を構築した事例
ログ基盤の構築では、ツール選定も成否を分けます。ある企業はコストを抑えるため、OSSのZabbixをログ監視の中核に据えました。
Zabbixはライセンスが無料である一方、構築と維持に自社の工数がかかります。そのため、初期構築は外部に委託し、運用は内製化するハイブリッドな進め方を選びました。
この判断は、OSSは「無料」ではなく「人件費という形でコストが発生する」と理解したうえでのものです。別のスタートアップは、クラウド型のDatadogやNew Relicを採用しました。これらはホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円かかります。その代わり、構築や維持の工数がほぼ不要で、立ち上げが速いのが利点です。
ログ基盤は一度作ると移行に費用がかかるため、ツールは自社の体制と成長フェーズに合わせて慎重に選ぶ必要があります。判断は、次のように分かれます。
- OSSを選ぶ場合:自社にインフラ運用の体力があること
- SaaSを選ぶ場合:スピードと省力化を優先すること
安すぎる監視契約から軌道修正したログ監視事例
失敗の事例からは、成功談とは別の学びが得られます。発注側がもっとも学べるのは、「なぜ失敗したのか」「どう立て直したのか」というリアルな経験です。
ログ監視では、安さだけで契約した結果、いざというときにログが活かされなかった事例があります。こうした失敗の教訓は、これから委託する企業にとって何よりの備えになります。
監視はしていたがログが活かされなかった失敗の教訓
ある企業は、月額数千円の格安監視サービスを契約していました。ところが重大な障害が発生したとき、契約に含まれていたのは死活監視のみで、ログの内容を分析して原因を特定する作業は対象外でした。
ログ自体は蓄積されていたものの、それを読み解いて対応につなげる体制がありませんでした。そのため、自社で深夜にログを掘り起こす羽目になり、復旧が大幅に遅れました。
安すぎる見積もりには、こうした対応範囲の欠落が潜んでおり、その点は失敗やリスクの観点とも深く関わります。この失敗の本質は、金額の安さよりも、「何が含まれ、何が含まれないか」を契約時に確認しなかったことにあります。
事例が教えるのは、「月額の総額」より「障害時に誰がどこまで動いてくれるか」を見るべきだという原則です。契約では、監視の対象がどこまでか、応答時間がどう保証されるかを確かめます。
- 監視の範囲:死活監視だけか、ログ分析や原因調査まで含むか
- SLA:応答時間を保証する形か、努力目標にとどまっていないか
監視設計の見直しと伴走体制で立て直した事例
立て直しに成功した企業は、契約を見直す際に、監視項目と閾値の設計から、アラート時の一次対応、定期的な監視内容の見直しまでを含むサービスへ切り替えました。
月額は上がりましたが、ログを単なる蓄積から対応につながる情報へ変えたことで、障害の早期発見と迅速な復旧が実現しました。さらに、SLAも応答時間を明記した保証型へ引き上げ、いざというときの動きを契約で担保しました。
riplaはフルスクラッチ受託と国内運用保守の立場から、作って終わりではなく、作った後も継続して伴走する進め方を重視しています。ログ監視でも、システムの作り手が監視設計に関与すると、どのログにどんな意味があるかを踏まえた的確な監視が可能になります。
事例は、成果の華やかさより、なぜそのログ監視が機能したのかという視点で読むのが近道です。必要な監視範囲は、次の2つを基に見極めてください。
- 自社の規模:監視の対象と範囲を、どこまで広げるかの目安
- 事業影響度:停止したときに事業へ及ぶ影響の大きさ
まとめ
ITシステムのログ監視の事例を振り返ると、成功も失敗からの回復も、ログを蓄積するだけで終わらせず、予兆検知・自動通知・横断検索を通じて対応につなげた点に集まります。エラーログの増加傾向からディスク枯渇を先回りした事例や、委託で属人化を解消した事例は、ログを「対応につながる一次情報」として扱っています。
ログ基盤の集約でMTTRを短縮し、ダウンタイム損失を抑えた事例も、同じ考え方に立っています。一方で、安すぎる契約でログが活かされなかった失敗からは、金額よりも対応範囲とSLAを見るべきだと学べます。
事例を読むときに大切なのは、「いくら払ったか」ではなく、「いざというときに、ログがどれだけ役立ったか」という視点です。総務省の統計が示す1回1,200万円の機会損失や、Gartnerの1分5,600ドルという数字を自社に当てはめると、ログ監視は単なるコストではなく、事業継続の保険であることが見えてきます。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムの設計思想を踏まえたログ監視の設計と、現場に定着する運用づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。