
ログ監視は、システムが出力するログを収集・集約・解析し、障害の予兆検知や原因究明を支える取り組みです。死活監視や性能監視とは役割を分けます。
導入の流れ、ツールや開発会社の選び方、費用と発注の進め方を、順に取り上げます。失敗を防ぐ運用の要点も添えます。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
ログ監視の導入と発注に関する詳細は、関連記事にまとめています。
- ITシステムログ監視の進め方/やり方/流れや方法/手法/工程/手順
- ITシステムログ監視でおすすめの開発会社/ベンダー6選と選び方
- ITシステムログ監視の見積相場や費用/コスト/値段について
- ITシステムログ監視の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステムログ監視の全体像
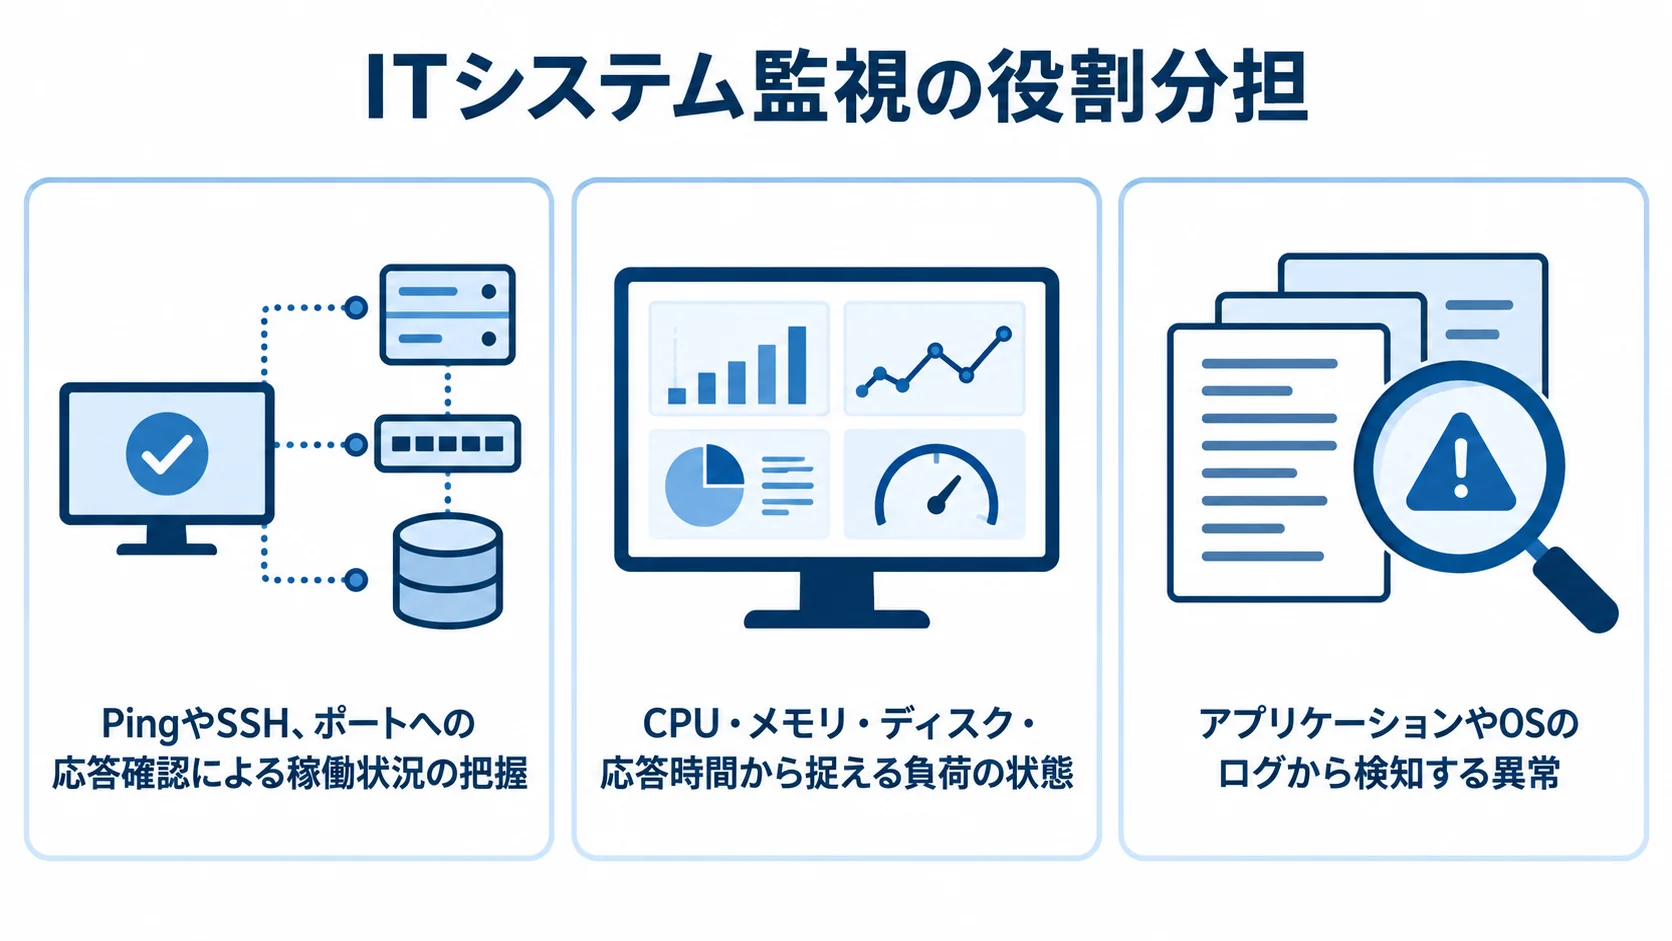
ITシステムの監視は、大きく死活監視・性能監視・ログ監視の3種類に分けられます。ログ監視はその中でも、システムが出力する記録(ログ)からエラーや異常な挙動を読み取る役割を担います。そのため、まずは3種類の関係と、ログ監視ならではの位置づけを押さえておくことが、適切な監視設計の出発点になります。
死活監視・性能監視・ログ監視の違い
3種類は得意な領域が異なるため、それぞれに役割を分けて組み合わせます。
- 死活監視:PingやSSH、ポートへの応答確認による稼働状況の把握
- 性能監視:CPU・メモリ・ディスク・応答時間から捉える負荷の状態
- ログ監視:アプリケーションやOSのログから検知する異常
たとえば応答は返るのに処理が遅い状態では、死活監視だけで異常を捉えられません。3つを組み合わせると、表面的な稼働状況から内部の挙動まで多層的に把握できます。
ログの収集・集約・解析という流れ
ログ監視は、複数のサーバーやアプリケーションに分散して出力されるログを一箇所に集める「集約」から始まります。
大量のログを目で確認していては、異常を見つけにくくなります。そこで、エラーパターンや閾値で自動的に抽出・解析し、必要に応じてアラートを出す仕組みを整えます。
収集から通知までを一連の流れとして設計することが、ログ監視運用の要になります。そのうえで、収集と集約・解析は役割が異なるため、分けて考えます。
- 収集:対象システムからのログ取得
- 集約・解析:一元管理による検索と分析
近年は、ログに加えてメトリクスやトレースを統合する「オブザーバビリティ(可観測性)」が広がっています。複数のデータから「なぜ障害が起きたか」を理解する考え方です。
監視が「どこに異常があるか」を示すのに対し、オブザーバビリティは「なぜそれが問題なのか」を明らかにするアプローチです。ログ監視はその基盤となる重要な要素であり、相関分析へ発展させる前提になります。
ITシステムログ監視の進め方
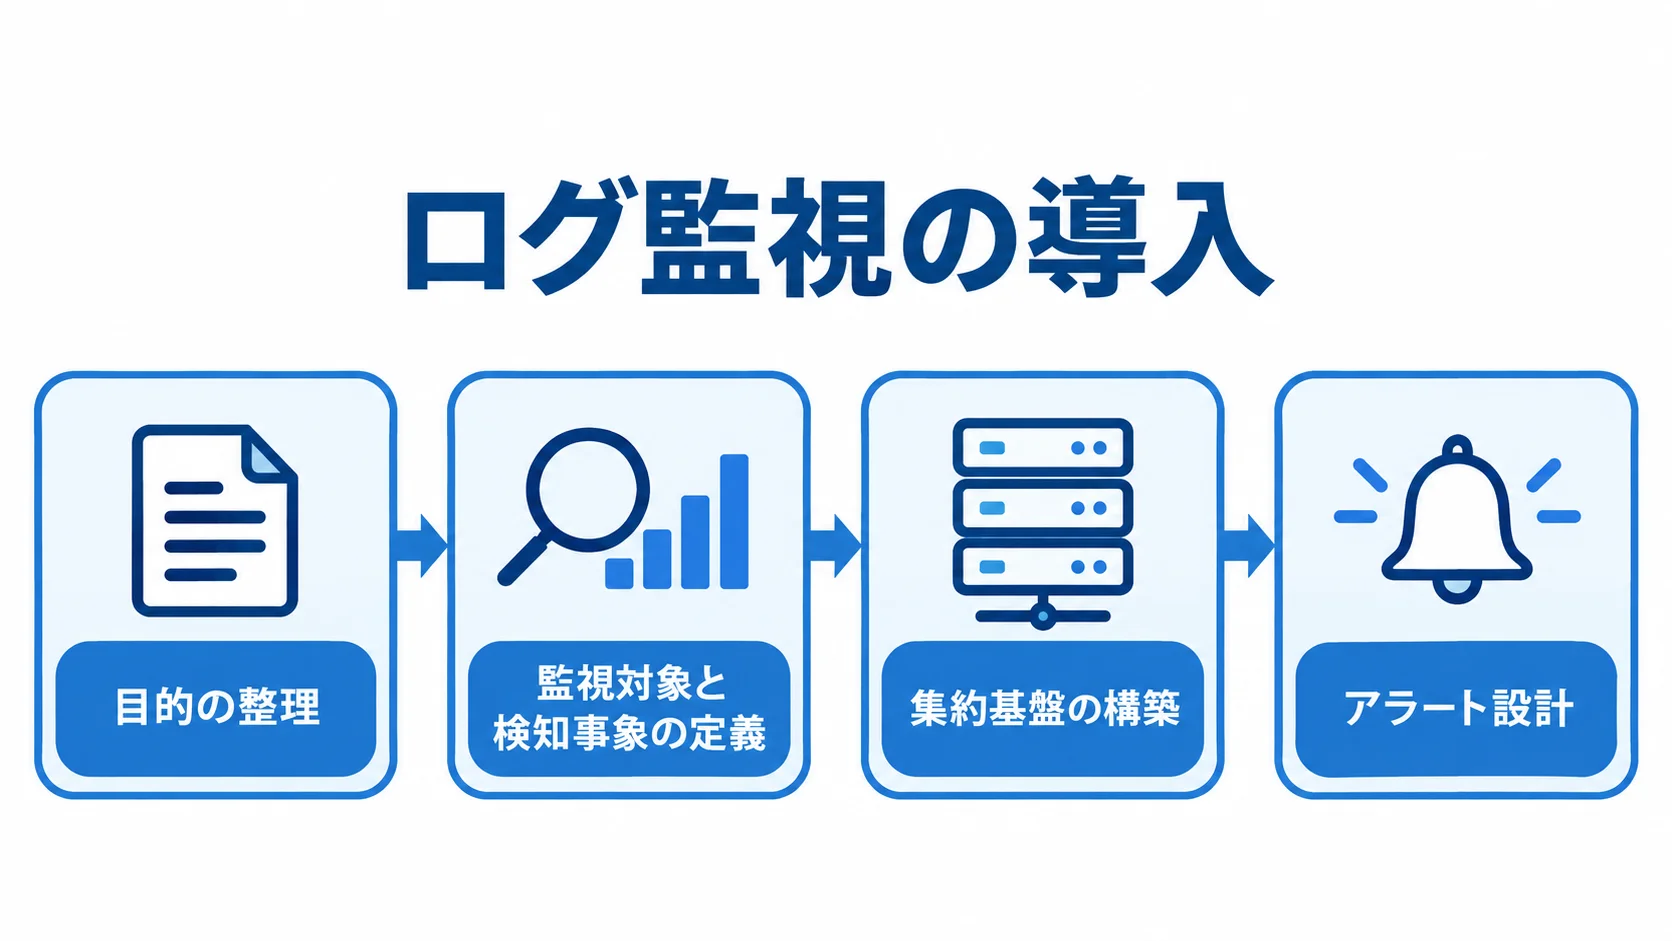
ログ監視を導入するときは、まず何を監視したいのかという目的を整理するところから始めます。そのうえで、監視対象と検知すべき事象を定義し、ログを集約する基盤を構築したあとに、アラートの条件を設計します。この順序で進めると、失敗が少なくなります。
流れは、要件定義のフェーズと、構築・運用のフェーズに分けて見ていきます。
監視対象と検知事象を定義するフェーズ
最初に、どのシステムのどのログを監視し、どんな事象を検知したいのかを明確にします。
監視対象は多岐にわたり、たとえばWebサーバーのアクセスログやアプリケーションのエラーログ、データベースのスロークエリログがあります。そこで、ビジネスへの影響が大きい箇所から優先順位をつけて選ぶことが、運用負荷を抑える鍵になります。
監視するログと検知後の対応は、セットで決めておきます。
- 対象:アクセス・エラー・スロークエリログからの選定
- 対応:深刻度ごとの通知条件と担当者の設定
この段階で、致命的なエラーと軽微な警告を区別しないまま、アラートを鳴らす条件を曖昧にして進めると、後述する過検知や見落としの原因になります。検知の優先度と対応フローをまとめて決めておくことが大切です。
集約基盤の構築とアラート設計のフェーズ
定義が固まったら、ログを一元的に集める集約基盤を構築します。一般的には、各サーバーにエージェントを導入してログを転送し、収集ツールやログ管理サービスに送る構成になります。
この段階では、アラート設計をできる限りシンプルに保つことが求められます。実際の現場では、ツールを選ぶ以上に、アラート設計の良し悪しが運用の成否を左右します。
基盤構築では、転送経路と通知ルールの2点を整えます。
- 集約基盤:エージェントなどによるログの一元収集
- 通知設計:単純な条件から始め、運用後の見直しで調整
ある現場では、「特定キーワードを含むログのみSlackに通知する」条件を設定しました。ところが設定ミスで重要なエラーログが届かず、障害の発見が3時間遅れた事例があります。
凝った条件を作り込むほど設定ミスのリスクも高まります。そのため、まずは確実に通知される単純な条件から始め、運用しながら少しずつ調整していく進め方が安全です。
ログ監視ツール・開発会社の選び方
ログ監視を実現する手段には、自社でツールを導入して運用する方法と、開発会社や監視代行会社に委託する方法があります。いずれの場合も、自社の環境・予算・技術レベルに合った選択をすることが大切です。
個別の会社名は挙げず、ツールやパートナーを選ぶ際に共通して見るべき基準を取り上げます。
環境適合性と技術力の確認ポイント
ツールを選ぶときは、オンプレミスかクラウドか、シングルクラウドかマルチクラウドかといった、自社の監視環境との適合性をまず確かめます。
比較では、OSS(無料)かSaaS(有料)かという予算面と、運用チームの技術レベルを見るとよいでしょう。さらに、監視範囲の広さやアラート通知の柔軟性も比べておきたいところです。
たとえばZabbixはOSSで初期コストを抑えられる一方、運用には一定の技術力が求められます。
候補は、環境への適合性と運用実績の2点で比べます。
- 環境・技術:クラウド、OSS/SaaS、通知の柔軟性の比較
- 運用実績:同規模の実績と、障害時の設計力
開発会社や代行会社に委託する場合は、扱えるツールの幅と障害対応の体制も確かめます。
とくに大量のログから異常を相関的に読み解く設計力は、担当者の経験に大きく左右されます。
提案が自社の課題に合っているか、また、ログ監視を単独で終わらせず性能監視や死活監視と統合した運用まで提案してくれるかを見極めることが重要です。
サポート体制とロックイン回避の評価
導入後に正しく設定・運用できるかは、サポート体制の充実度に大きく依存します。設定の代行、トラブル時の問い合わせ対応、定期的な見直しの提案といった支援が受けられるかを事前に確認しておくと安心です。
無料トライアルやデモ環境が用意されているツールであれば、本格導入の前に自社環境での使い勝手を試せます。
導入後の支援と、将来の移行しやすさを評価します。
- サポート:設定支援、問い合わせ、定期見直しの有無
- ロックイン:標準規格の活用の検討
あわせて見落としやすいのが、ベンダーロックインのリスクです。SaaS型のツールを深く作り込むほど、後から別のツールへ移行する際のスイッチングコストが膨らみます。
将来の乗り換えに備えるなら、OpenTelemetryのように、ログやトレースの収集規格を標準化する仕組みが役立ちます。特定ベンダーに依存しすぎない設計も検討しましょう。
ITシステムログ監視の費用相場
ログ監視の費用は、自社でツールを運用する場合と監視を外部委託する場合、また選ぶツールの課金体系によって大きく変わります。
とくにログ監視はデータの取込量に応じて料金が変動するケースが多く、予算設計の際は取り込むログ量を見積もっておくことが欠かせません。予算規模別の目安と、費用を左右する要因を順に見ていきます。
予算規模別の費用目安
予算帯と課金単位は、セットで比べます。
- 月額5万円未満:ZabbixなどOSSの運用
- 月額5万円から20万円:CloudWatchなど従量課金型
- 月額20万円以上:Datadogなどホスト課金型のSaaS
Zabbixは初期コストがゼロで、CloudWatchはログ取込が1GBあたり約0.76ドル、Datadogは月額15ドル前後からのホスト課金です。
監視そのものを代行会社に委託する場合は、24時間365日の監視と一次対応を含むパッケージで、1台あたり月額10,000円から30,000円程度が相場です。
個別のサービス監視は1サービスあたり月額200円ほど、Apacheなどの自動復旧監視オプションは月額3,000円ほどが目安となります。
自社運用と外注を組み合わせる場合の費用比較の基礎として、押さえておくとよいでしょう。
費用を左右する要因とROIの考え方
ログ監視の費用は、取り込むログの量と保持期間、監視対象のホスト数によって変わります。さらに、24時間体制かどうかでも変動します。
とくにログ取込量は従量課金型のコストに直結するため、不要なログまで集約してしまうと費用が膨らみます。何を残し、何を捨てるかを選ぶことが、費用を抑える出発点になります。
費用とROIは、取込量や体制、障害による損失から考えます。
- 費用要因:ログ量、保持期間、ホスト数などによる変動
- ROI:導入費と、ダウンタイムの機会損失の比較
費用を経営層に説明するときは、投資対効果(ROI)の観点が役立ちます。ログ監視への投資額と、障害で失う売上やブランド毀損の機会損失を並べることで、どれだけの損失を防げるかが見えてきます。
実際に、ログやメトリクスを統合して可視化したことで障害の原因特定時間が3分の1に短縮された事例もあり、復旧の早さは機会損失の抑制に直結します。
障害対応の効果を金額に換算すると、投資判断の納得感が高まります。
ログ監視の発注・外注方法
24時間365日の監視体制を自社のリソースだけで維持するのは、人員の面でも負担が大きい取り組みです。そのため、監視運用を外部のMSP(マネージドサービスプロバイダ)に委託する選択肢が現実的になります。
一方で、丸投げによるブラックボックス化や契約上のリスクには注意が必要です。発注先の種類と、契約形態で気をつけたい点を順に見ていきます。
発注先の種類とハイブリッド運用
全部を外注するか内製するかの二択に限らず、たとえば日中は自社で対応し、夜間や休日のみ外部委託するハイブリッド運用も有効です。一部だけを外注して残りを内製する形は、コストと体制のバランスを取るうえで現実的です。
外注する範囲と、社内に残す役割を決めてから発注します。
- 外注先:開発会社、MSP、時間帯指定型の比較
- 社内役割:SLA定義と、システム全体の理解の維持
外注で注意したいのは、発注側が手放してはいけないスキルです。監視を丸ごと委託すると、自社システムを理解する社員がいなくなり、いざというときに判断できない事態になりかねません。
外注後も社内に保持し続けるべきなのは、SLA(サービス品質保証)を定義する能力と、システム全体のアーキテクチャを把握する力です。将来的に内製化へ移行する選択肢を残すためにも、社内に残す役割との線引きを先に決めておく必要があります。
契約形態と偽装請負を避ける留意点
監視業務を委託する前には、どの契約形態に当たるかを確かめておく必要があります。
業務委託で、発注者が作業者へ直接指揮命令を行うと、偽装請負(労働者派遣法違反)と判断されるおそれがあります。
たとえば、発注者の事業所で請負労働者が1人で作業し、その人が管理責任者も兼ねる場合は注意が必要です。発注者の注文そのものが、直接の指揮命令とみなされかねません。
契約形態と指揮命令の境界を、あらかじめ明確にしておきます。
- 契約形態:請負・準委任・派遣の違い
- 運用連絡:作業者への直接指示を避け、管理責任者を通すこと
近年はSlackなどで常時つながる環境が当たり前になり、指揮命令の境界が曖昧になりがちです。
管理責任者宛のメールに作業担当者をCCで加えること自体は違法ではありません。ただし、実質的な作業手順を指示したり、担当者へ直接返信を求めたりすると、指揮命令とみなされる可能性があります。
発注前に契約形態と運用ルールを決め、適正な委託関係を保つことが、トラブルを避けるうえで欠かせません。
ログ監視で失敗しないためのポイント
ログ監視は、導入したあとも運用しながら改善を重ねていく仕組みです。よくある失敗を知り、SIEMや相関分析、オブザーバビリティといった高度化への道筋を理解しておくことで、形だけの監視に陥らずに済みます。
続いて、構造的な失敗パターンと、改善を回し続けるための考え方を取り上げます。
よくある失敗パターンと対策
最も多い失敗のひとつが「アラート疲れ」です。閾値の設定が緩すぎて過検知が頻発すると、担当者はアラートに慣れてしまい、本当に重要な通知を見落とすようになります。
逆に厳しすぎると重大な障害を取りこぼします。対策としては、警告・軽度障害・重度障害といった段階を設け、深刻度に応じて通知先や対応を変えるノイズチューニングを地道に行うことが効果的です。
設定と運用の責任を決めて、形だけの監視に終わらせないようにします。
- 通知の調整:過検知と見落としの両方の回避
- 担当の明確化:見る人と運用する人の決定
組織レベルの構造的な失敗も見逃せません。たとえば、「高価なSaaSを導入しても誰も見ない」「MSPへ任せきりで、自社システムを理解する社員がゼロになる」といった例があります。
ツールや外注は手段にすぎず、使いこなす体制が伴わなければ、投資は無駄になります。導入と同時に体制を整えておくことが、その対策になります。
相関分析とポストモーテムによる継続改善
ログ監視を一段進める方向としては、複数のログを横断的に突き合わせる相関分析があります。さらに、ログ・メトリクス・トレースを統合するSIEMやオブザーバビリティの導入も挙げられます。
AIでログやメトリクスから異常を予測するAIOpsといった技術も登場しています。ただし、それらは万能ではありません。
十分な量の学習データが必要で、過去に例のないエッジケースには対応しきれないという限界があります。そのうえで、現実的な範囲で取り入れることが大切です。
相関分析と振り返りを、運用の流れに組み込みます。
- 分析の高度化:SIEMやAIOpsを、限界も踏まえて使うこと
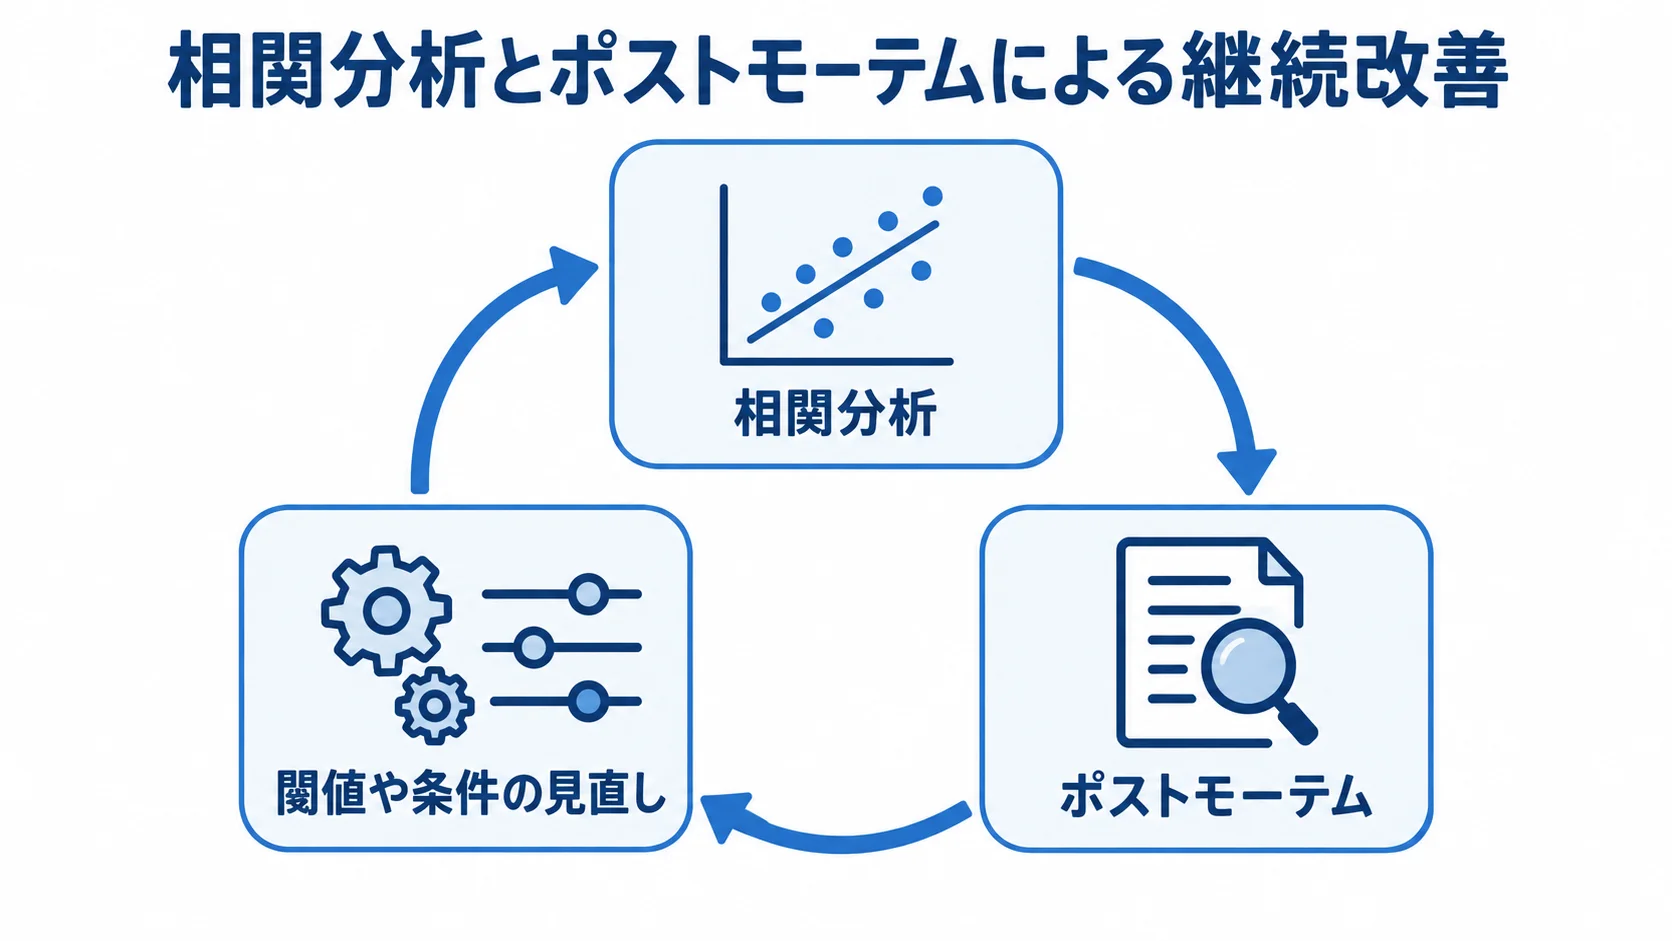
- 振り返り:ポストモーテムに基づく閾値や条件の見直し
そして、見落とされがちなのが障害後の振り返り(ポストモーテム)です。検知や原因特定のあとに、「なぜ起きたか」「アラートは適切だったか」を振り返ります。学びを監視の閾値や条件に反映し、改善を続けます。
この継続的な見直しを重ねると、監視の仕組みそのものが運用とともに精度を高めていきます。ログ監視を生きた仕組みとして育てる姿勢が、長期的な安定稼働につながります。
まとめ
ITシステムログ監視は、死活監視や性能監視と組み合わせることで、システムの内部挙動を詳しく把握できる仕組みです。障害の予兆検知や、迅速な原因究明にも役立ちます。
導入では、監視対象と検知事象の定義から始め、集約基盤を構築して、アラート設計をシンプルに保つことが成功の鍵になります。
ツールや発注先は、自社の環境・予算・技術レベルに合わせて選び、ベンダーロックインや偽装請負といったリスクにも目を配ることが大切です。
費用は取込量や監視体制によって変動するため、ROIの観点で投資判断を行うとよいでしょう。導入後はアラート疲れや形だけの運用を避け、相関分析やポストモーテムで改善を続けます。
ここまでの内容は、監視の役割、費用、継続改善の3点にまとめられます。
- 監視:死活・性能との役割分担による異常の把握
- 費用:取込量と監視体制を踏まえた投資判断
- 改善:通知条件と運用体制の振り返りと更新
個別テーマを深掘りする場合は、関連する手順・費用・委託先の記事を確認してください。
- ITシステムログ監視の進め方/やり方/流れや方法/手法/工程/手順
- ITシステムログ監視でおすすめの開発会社/ベンダー6選と選び方
- ITシステムログ監視の見積相場や費用/コスト/値段について
- ITシステムログ監視の発注/外注/依頼/委託方法について
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。