
ITシステムのログ監視は、ログを集め、異常を知らせ、保管して調べる機能が連携して成り立ちます。
機能に絞り、必要機能と標準機能の役割と限界を、発注企業の視点で一覧的に解説します。主要ツールの得意分野も一次データから紹介します。全体像をまだ把握していない方は、まずITシステムログ監視の完全ガイドから読むことをおすすめします。
- ログ収集・集約:必要なログを集め、扱いやすく整える
- 異常検知・通知:異常を見つけ、担当者へ知らせる
- 保管・検索・可視化:過去のログを調べ、状況を把握する
- 自動相関分析:複数のログを関連づけて、ひとつの事象として捉える
▼全体ガイドの記事
・ITシステムログ監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ログ収集・集約機能
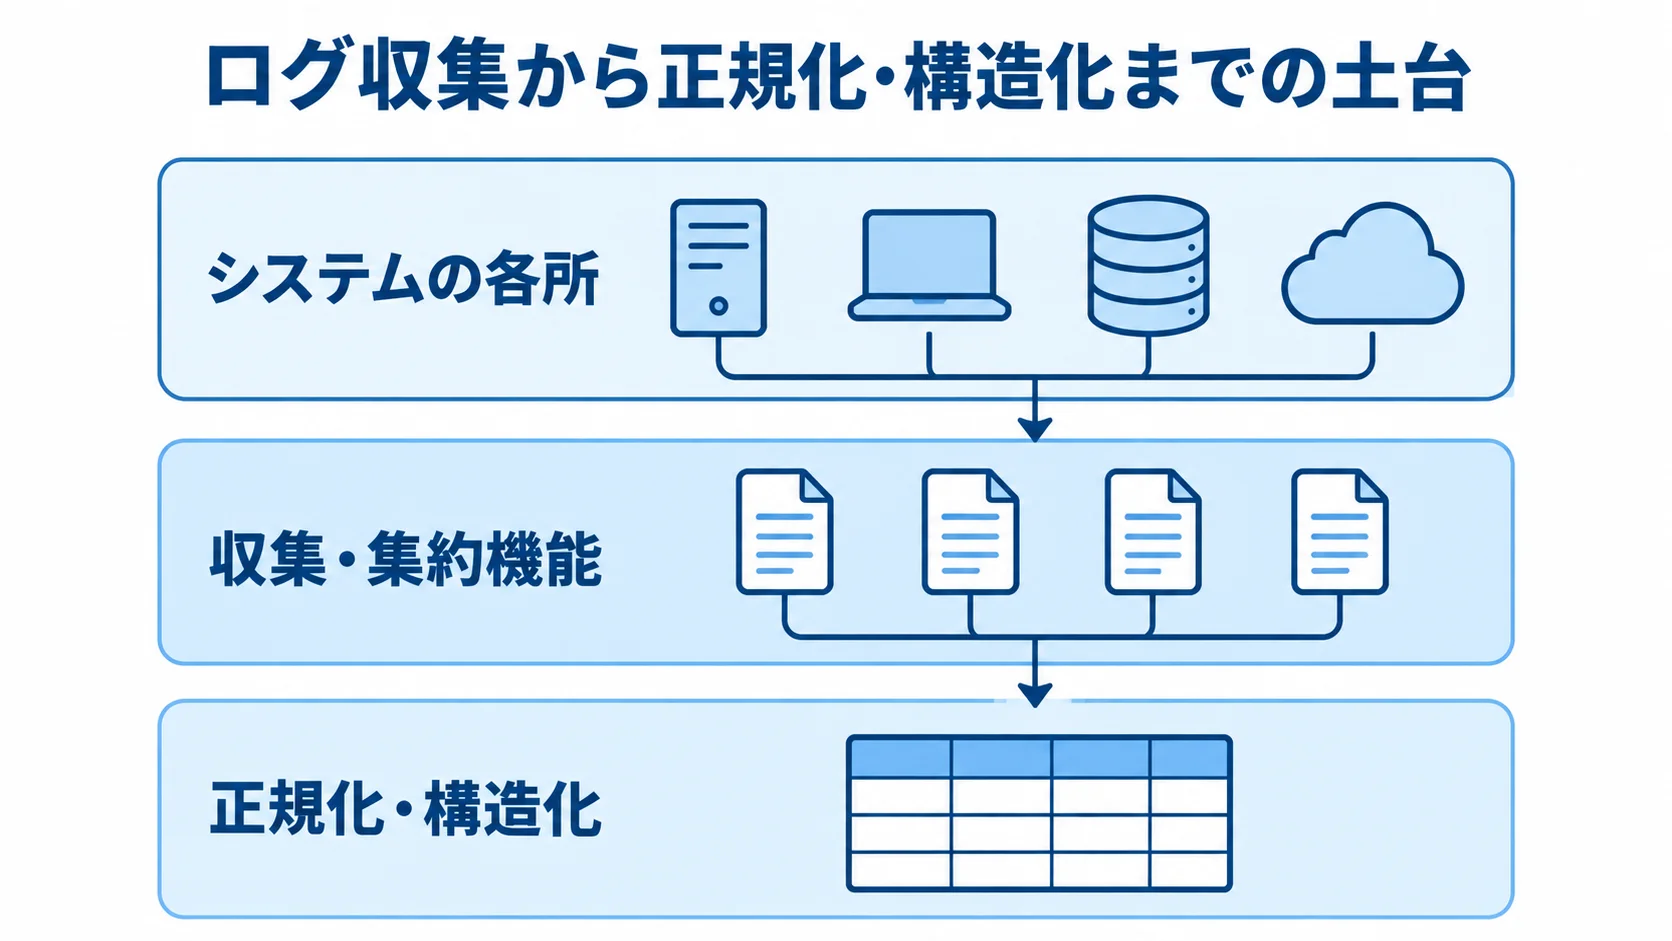
ログ監視のすべての出発点は、ログを集める「収集・集約機能」です。サーバー、アプリケーション、ネットワーク機器、データベースなど、システムの各所が出力するログを一箇所に集めなければ、監視も検索も始まりません。また、この機能の設計が、後段の検知や検索の精度を左右します。
エージェント型・エージェントレス型の収集機能
ログの収集方式は、監視対象にエージェントソフトを入れる方式と、入れずにSyslogやAPI経由で集める方式に分かれます。標準機能としては両方式に対応するツールが多く、「収集できるログの種類」と「導入時の運用負荷」のバランスを見極めることが大切です。
エージェント型は、各サーバーに常駐するプログラムがログをリアルタイムに転送するため、取得できる情報が豊富で精度が高いのが特徴です。Zabbixのエージェントや、Datadog・New Relicのエージェントがこの方式にあたります。一方で、エージェントの導入・更新という運用負荷が発生します。
エージェントレス型は、ネットワーク機器が標準で出力するSyslogや、クラウドサービスが提供するAPIを通じてログを集めます。監視対象に手を加えなくてよいため、エージェントを入れられない機器やマネージドサービスの監視に向いています。どちらの方式を優先するかは、自社の環境がオンプレミス中心かクラウド中心かで決まります。
ログの正規化・構造化機能
収集したログは機器やアプリごとに形式がバラバラです。そのまま蓄積すると検索や集計が困難になるため、共通のフォーマットに整える「正規化・構造化」機能が必要です。
たとえば、タイムスタンプ、ホスト名、重大度、メッセージ本文といった項目を構造化して保存すれば、後から「特定ホストのエラーレベルのログだけ」を絞り込む検索が一瞬で行えます。この機能の有無は、ログ監視の使い勝手を大きく左右します。
標準で構造化に対応していないツールでは、自社でパース(解析)ルールを書く必要があり、運用工数が増えます。一方で、SIEM製品のSplunk Cloudのように、多様なログを取り込んで構造化するのを得意とするツールもあります。選ぶ際は、自社のログ形式に標準対応しているか、カスタムのパースがどこまで柔軟かを確認すると、導入後の手戻りを防げます。
異常検知・アラート通知機能
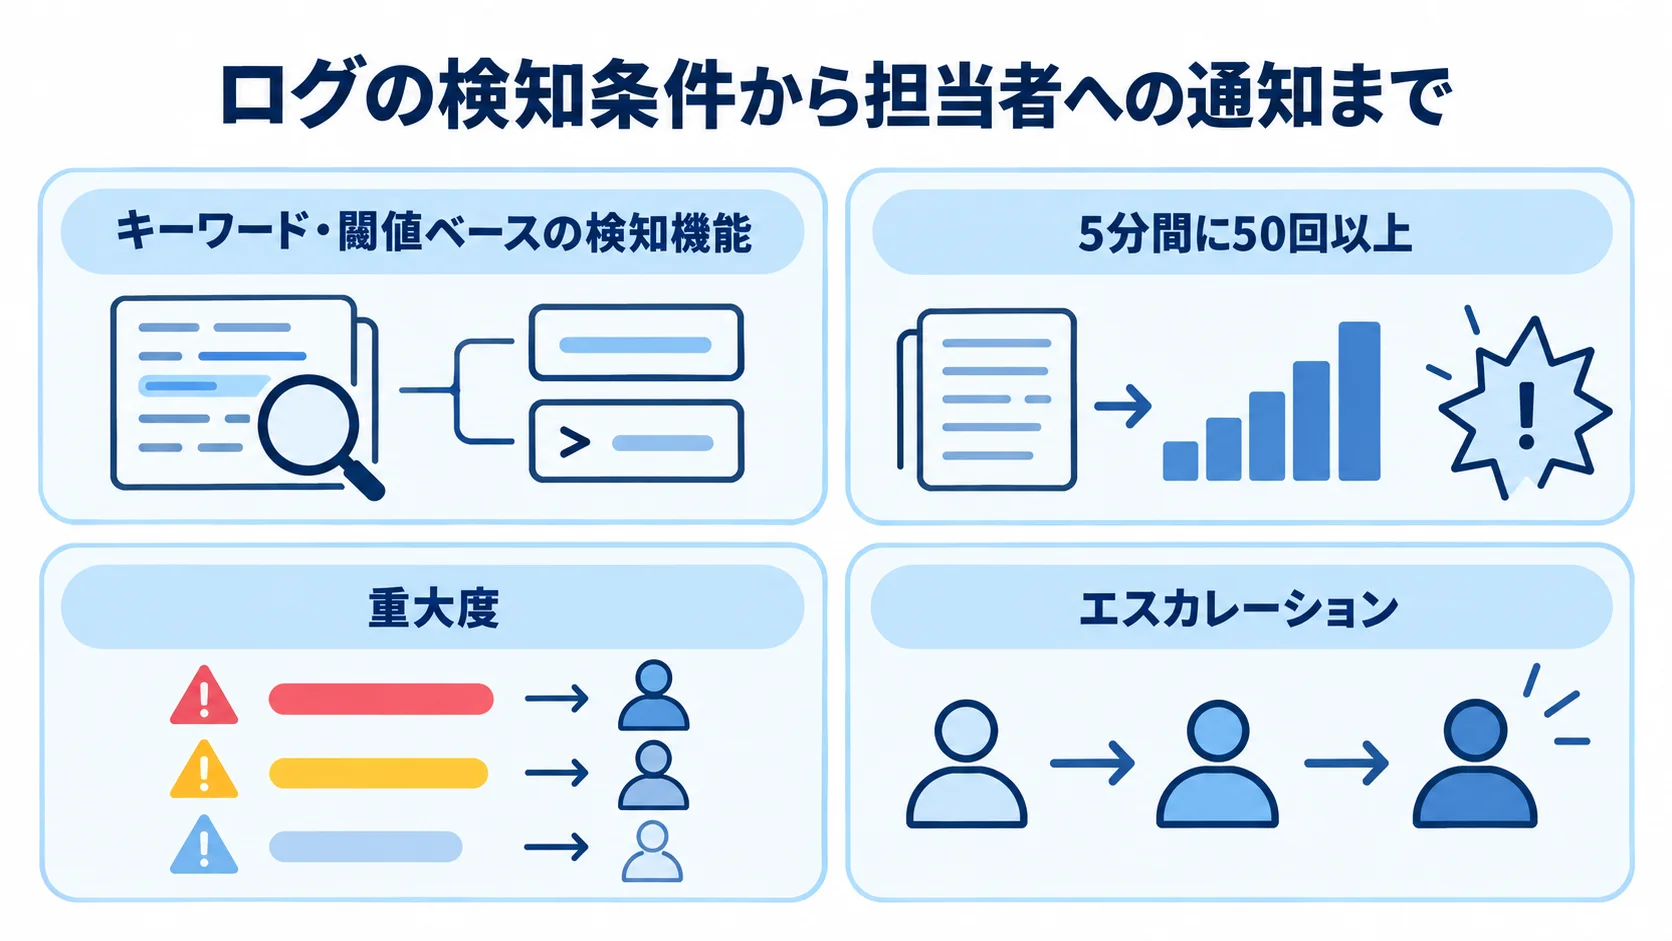
ログ監視の中核を担うのが、集めたログから異常を見つけ出し、担当者に知らせる「異常検知・アラート通知」機能です。蓄積したログは、異常に気づいてこそ役に立ちます。
あらかじめ定めた条件に合うログを自動で拾い、適切な相手へ通知して初めて、ログ監視は対応につながります。他の監視と差別化される点は、この機能にあります。
キーワード・閾値ベースの検知機能
最も基本的な検知機能が、特定のキーワードや閾値に基づくルールベースの検知です。「ERROR」「FATAL」「OutOfMemory」といったキーワードを含むログが出たら通知する、あるいは特定のエラーが一定時間に何回以上出たら通知する、といった条件を設定します。
シンプルですが確実で、ほとんどの障害対応はこの基本機能でカバーできます。標準機能として必ず備わっているべき要素です。検知の精度は、検知エンジンの機能と、それを使いこなす運用設計の両方で決まります。
閾値ベースの検知では、平常時のベースラインを踏まえた設定が欠かせません。たとえば、アクセス過多のエラーは平常時も一定数出ることがあります。これを「1回でも出たら通知」とすると、アラートが鳴り続けて担当者が麻痺してしまいます。そこで「5分間に50回以上」といった集計条件を加え、本当に異常なときだけ通知します。
多段通知・エスカレーション機能
検知した異常を、誰に・どの手段で・どの順番で通知するかを制御するのが、多段通知・エスカレーション機能です。重大度に応じて、警告レベルはチャットへ、重大レベルは電話とSMSへ、といった通知先の振り分けができます。
一定時間内に担当者が応答しなければ次の責任者へ自動でエスカレーションする仕組みは、無人時間帯の監視に欠かせません。この機能が、SLAで定めた応答時間の達成を支えます。通知を自動化すると、属人的な見張りから組織を解放できます。
たとえば、「重大インシデントは15分以内に一次対応を開始」というCloud Naviのような保証水準を実現するには、検知から通知、エスカレーションまでが自動で回る必要があります。一般的な障害対応の目標である「重大障害2時間以内の対応開始・完全解決24時間以内」も、エスカレーション機能があれば取りこぼしなく回せます。
ログ保管・検索・可視化機能
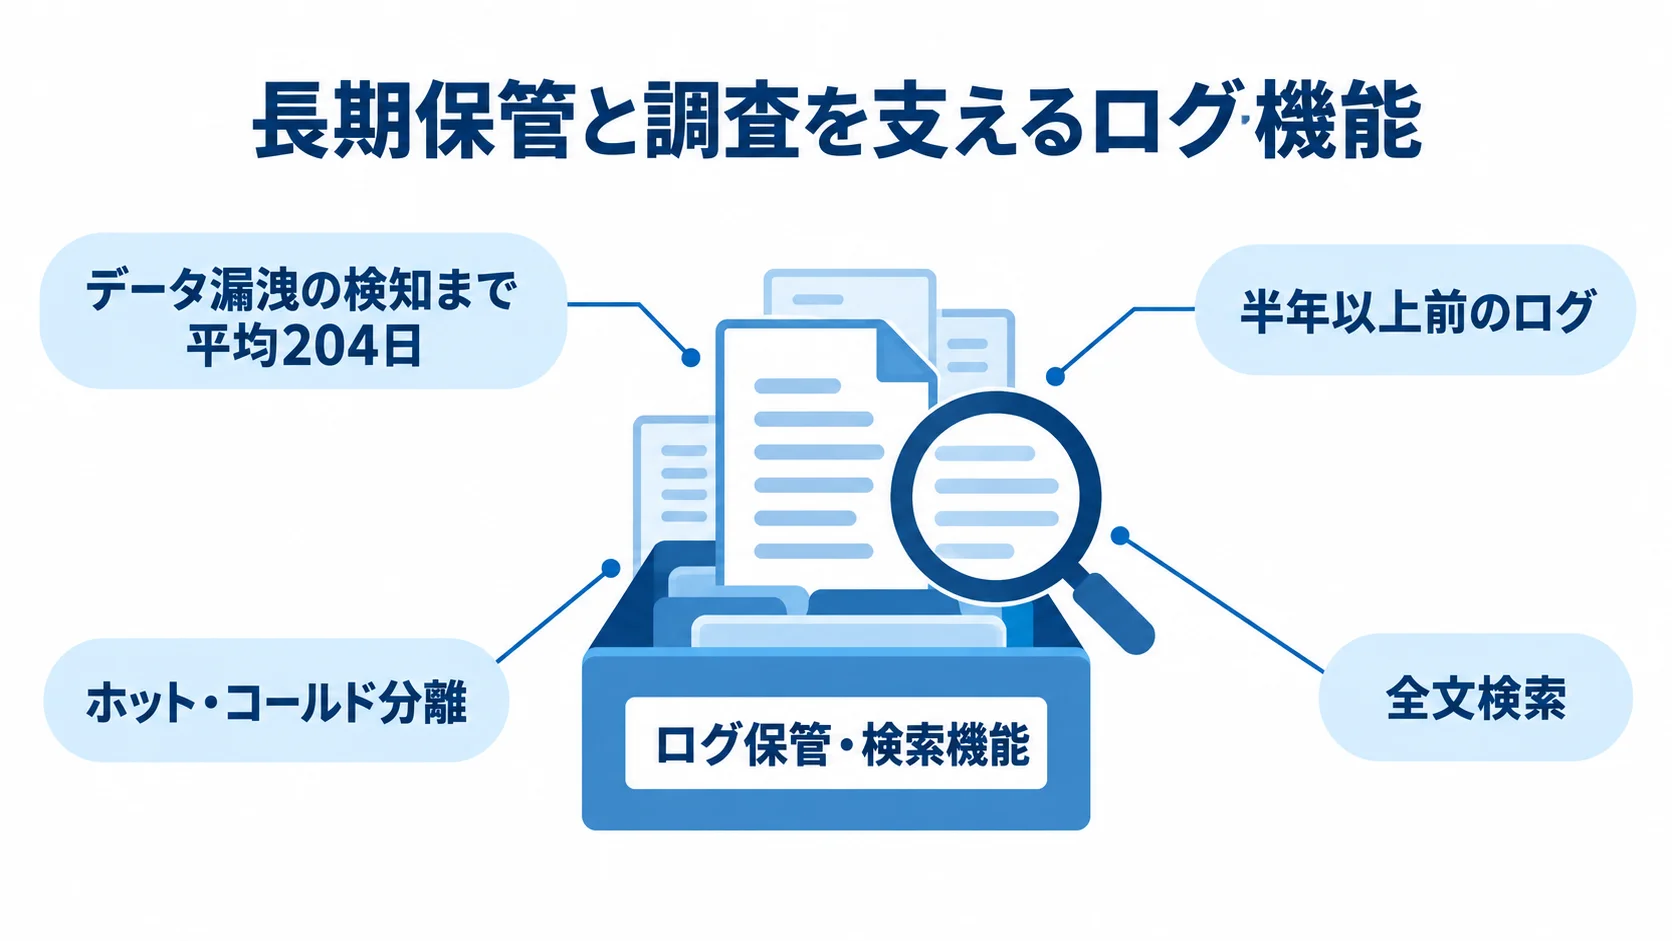
異常を検知して対応した後も、ログ監視の機能は続きます。蓄積したログを長期保管し、必要なときに高速で検索し、傾向をグラフで可視化する機能群が、原因究明と継続的な改善を支えます。
とくに障害発生後の調査や監査・コンプライアンス対応では、過去のログをどれだけ速く正確に引けるかが問われます。
長期保管とアーカイブ・検索機能
ログは、障害調査だけでなく、監査やセキュリティ調査のためにも一定期間の保管が求められます。とくにセキュリティインシデントは発覚までに時間がかかることが知られており、IBMの2024年の調査では、データ漏洩は検知まで平均204日かかるとされています。不正アクセスの痕跡を追うには、半年以上前のログが残っている必要があります。
保管機能では、保存期間をどう設定し、コストとのバランスを取るかが論点になります。大量のログを長期保管するとストレージコストが膨らむため、直近のログは高速検索できる形で保持し、古いログは安価なストレージへアーカイブする「ホット・コールド分離」の機能が役立ちます。
検索機能としては、全文検索や条件絞り込み、時刻範囲指定での絞り込みが標準的に求められます。また、SIEM製品のSplunk Cloudは大量ログの高速検索を得意とし、セキュリティ調査の用途で広く使われています。保管と検索は、いざというときの調査速度を決める土台となる機能です。
ダッシュボード・可視化機能
ログの傾向をひと目で把握するのが、ダッシュボード・可視化機能です。エラー発生数の推移、リクエスト数の変動、レスポンスタイムの分布などをグラフにすると、数字の羅列では見えない異常な変化を直感的に捉えられます。
たとえば、Datadogやニューレリック、Mackerelといったクラウド型ツールは、この可視化のしやすさを強みとしており、設定済みのダッシュボードがすぐ使えます。また、複数のメトリクスを並べて表示すれば、ログ監視・性能監視・死活監視を統合的に見られ、障害の全体像をつかめます。
可視化機能は、技術者だけでなく経営層への報告にも有効です。ログ監視の成果を「障害が減った」と言葉で説明するより、グラフで「エラー発生数が前月比で半減した」と示すほうが説得力があります。可視化は、ログ監視を「専門家だけのもの」から「組織で共有できる情報」へと広げる機能です。
AIOpsによる自動相関分析機能
近年のログ監視で注目を集めているのが、AIを活用した自動相関分析の機能です。膨大なログの中から、人手では気づけないパターンや相関を機械学習で見つけ出し、障害の予兆や根本原因の候補を提示します。
標準機能というより先進的なオプションですが、ログ量が膨大な環境では大きな効果を発揮します。提供される機能には異常検知の自動化やノイズ削減があり、中小企業では部分的な導入が現実的な使い方になります。
異常検知の自動化とノイズ削減機能
AIOpsの代表的な機能が、平常時のパターンを学習して「いつもと違う」状態を自動で検知する異常検知です。閾値を人手で設定しなくても、AIが過去のログから正常な範囲を学び、そこから外れた挙動をアラートします。これにより、設定漏れによる検知ミスを減らせます。
さらに、関連する複数のアラートを一つにまとめ、本質的な問題だけを浮かび上がらせるノイズ削減機能も、アラート疲れの解消に役立ちます。一方で、AIOpsは万能ではありません。学習に十分なログ量と期間が必要で、データが少ない環境では精度が出ません。
また、AIが「異常」と判断した理由が分かりにくいブラックボックス性も課題です。そのため、AIに任せきりにせず、人間が最終判断する前提で使うのが現実的です。基本のルールベース検知を土台にして、AIOpsで補う位置づけにします。
中小企業のスモールスタート向け機能の選び方
AIOpsは大企業向けの紹介が中心ですが、中小企業でも部分的に取り入れることは可能です。JUASの調査では、AI活用は約78%の企業が検討中または未検討の段階にあり、まだ本格普及の手前にあります。
そのため、まずは特定の重要なシステムに絞ってAIOpsの異常検知を試し、効果を検証してから広げるスモールスタートが現実的です。AIOpsという言葉に踊らされず、基本機能で十分か、本当にAIが必要かを冷静に見極めることが欠かせません。さらに、機能の一覧を理解したうえで、自社に必要なものだけを選ぶと、過剰投資を防げます。
機能を選ぶ際は、「自社のログ量でAIが学習できるか」「既存の監視ツールに追加機能として乗せられるか」を確認すると失敗が減ります。クラウド型ツールの多くは、追加の異常検知機能をオプションで提供しており、レガシーな監視を維持しながら部分的に高度化できます。
まとめ
ITシステムのログ監視の機能を一覧で振り返ると、「収集・集約」「異常検知・アラート通知」「保管・検索・可視化」「AIOpsによる相関分析」という機能群の組み合わせで成り立っていることが分かります。収集機能はログを一箇所に集め、検知機能は異常を拾います。
エスカレーション機能はSLAの応答時間を支え、保管・検索機能は監査やセキュリティ調査を可能にします。可視化機能は、組織での情報共有を助けます。AIOpsはこれらを補完する先進機能であり、中小企業はスモールスタートで取り入れるのが現実的です。
機能を選ぶときは、自社の障害対応に本当に必要な機能を見極めることが大切です。基本のルールベース検知と通知があれば、多くの障害はカバーできます。そのうえで、自社のログ量や事業影響度に応じて高度な機能を足していくと、過剰投資を防げます。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムの構造を踏まえたログ監視の機能設計と、現場に定着する運用づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。