
ITシステムのログ監視を外部に委託する、または監視基盤を新たに作るとき、最初の関門はRFP(提案依頼書)と要件定義書の作成です。要件を数値で固めることが、適正な費用と確実な対応を引き出す鍵になります。
決めるべき項目は、監視対象ログと閾値、SLAの水準、監視範囲と対応範囲です。全体像はITシステムログ監視の完全ガイドでご確認ください。
▼全体ガイドの記事
・ITシステムログ監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視対象ログと閾値の数値要件の定義
ログ監視の要件定義で最初に固めるのは、「何を監視するか」です。
対象を曖昧にしたまま発注すると、ベンダーは無難に広く見積もるか、逆に狭く解釈して必要なログが監視されないか、どちらかになります。だからこそ、監視対象のログと異常と判断する閾値を数値で明記し、要件定義書の土台にします。
監視対象ログの一覧と優先度
要件定義書には、監視対象とするログを一覧で列挙します。アプリケーションのエラーログやWebサーバーのアクセスログなど、どのサーバーのどのログを対象にするかまで具体的に書き出します。
発注側がそれぞれのログに事業影響度に基づく優先度を付けると、ベンダーが対応のメリハリを設計しやすくなります。
このとき有効なのが、事業影響度アセスメントの考え方です。すべてのログを同じ重さで24時間監視すると費用がかさむため、影響度で監視レベルを分けると、限られた予算を効果的に配分できます。
要件定義の段階で「どのログが止まると事業にいくらの損失が出るか」を整理しておくと、過剰監視も過少監視も避けられます。
- 最優先で即時通知:売上に直結する基幹システムのエラーログ
- 翌営業日の確認で十分:社内向けツールのログ
閾値と検知条件の数値化
監視対象を決めたら、次は異常と判断する閾値を数値で定義します。条件は曖昧さなく書き切る必要があり、ディスク使用率であれば、90%超で警告、95%超で重大通知といった具合に段階を分けて書けます。
閾値が文章で曖昧に書かれていると、ベンダーごとに解釈が割れ、見積もりの比較もできません。
とはいえ、初期の閾値を発注側が完璧に決め切るのは困難です。そこで要件定義書には、「運用開始後、3カ月間はチューニング期間とし、誤検知や検知漏れを踏まえて閾値を見直す」というプロセスを盛り込んでおくと現実的です。
閾値はベースラインを観測しながら最適化するものだという前提を、発注側とベンダーで共有しておきます。
前提を共有しておけば、アラート疲れと検知漏れの両方を防げます。
要件定義は固定の仕様書ではなく、改善を織り込んだ設計だと捉えるのが成功のコツです。
- 件数で判断する条件:エラーログが5分間に50回以上出たら通知
- 1回でも即時通知:特定の致命的キーワードを含むログ
SLAの数値基準
ログ監視の要件定義で費用を最も左右するのが、SLA(サービス品質保証)の設定です。稼働率、異常検知後の初報応答時間、復旧目標時間といった数値を、どの水準で求めるかが、そのまま監視体制の規模とコストに響きます。
過剰なSLAは無駄なコストを生み、過少なSLAはいざというとき機能しません。そのため、発注側は一次データの実値を参考に、適正な水準を見極めます。
稼働率99.9%と99.99%の差
稼働率の目標は、要件定義で最も慎重に決めるべき数値です。一見わずかな差に見えても、「9」が一つ増えるごとに運用コストは段階的に跳ね上がります。
99.99%を求めるなら、冗長構成や即時対応体制が必要になり、費用が変わります。そのため、自社のシステムが本当に99.99%を必要とするかを、冷静に見極める必要があります。
発注側が、深夜に数分停止しても事業影響が小さいシステムに最高水準のSLAを求めると、過剰投資になります。
情シスがビジネス部門に「99.99%にすると費用が何倍になるか」を示し、許容できるダウンタイムを合意形成することが、現実的なSLA設定につながります。
合意した稼働率の根拠も要件定義書に併記しておくと、後の社内調整がスムーズになります。
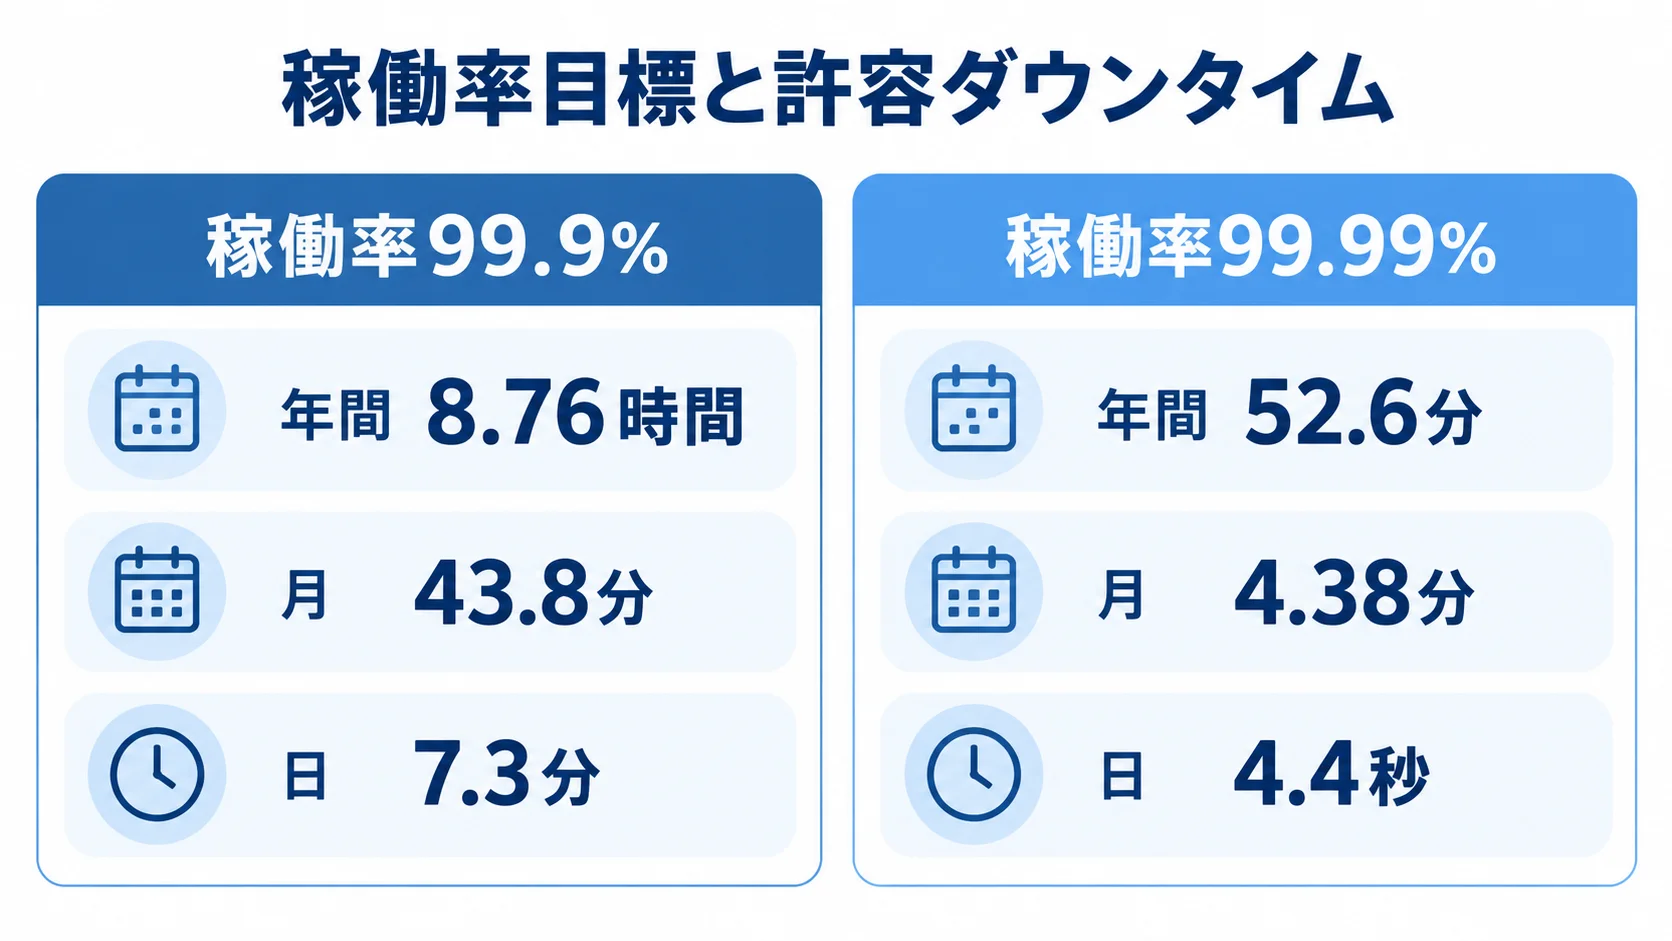
99.9%と99.99%の差は、許容されるダウンタイムの長さにそのまま表れます。
- 99.9%:年間8.76時間、月43.8分、日7.3分
- 99.99%:年間52.6分、月4.38分、日4.4秒
初報応答と復旧目標時間の水準
稼働率と並んで重要なのが、異常検知後の初報応答時間と復旧目標時間です。
一次データの実値を見ると、官公庁仕様では、1時間以内に現地到着・対処開始、1時間以内に内容と予想作業時間を報告、原則4時間以内に完全復旧という水準が定められています。民間では、Cloud Naviが重大issueに15分以内の一次対応を保証し、シーズホスティングが検知から60分以内に通知・12時間で復旧を掲げています。
この時間が「努力目標」か「保証」かの区別も欠かせません。保証型は未達時にサービスクレジット(料金減額)が発生しますが、その分費用は高くなります。
一般的な目標である「重大障害2時間以内対応開始・完全解決24時間以内」を一つの基準に、発注側が自社の事業影響度に見合う水準を設定します。
要件定義書では、これらの実値を参考に、次の2点を明記します。
- 着手の時間:重大障害を検知してから、何分以内に一次対応を始めるか
- 復旧の時間:何時間以内に復旧を目指すか
クラウドの責任共有を前提とした監視範囲
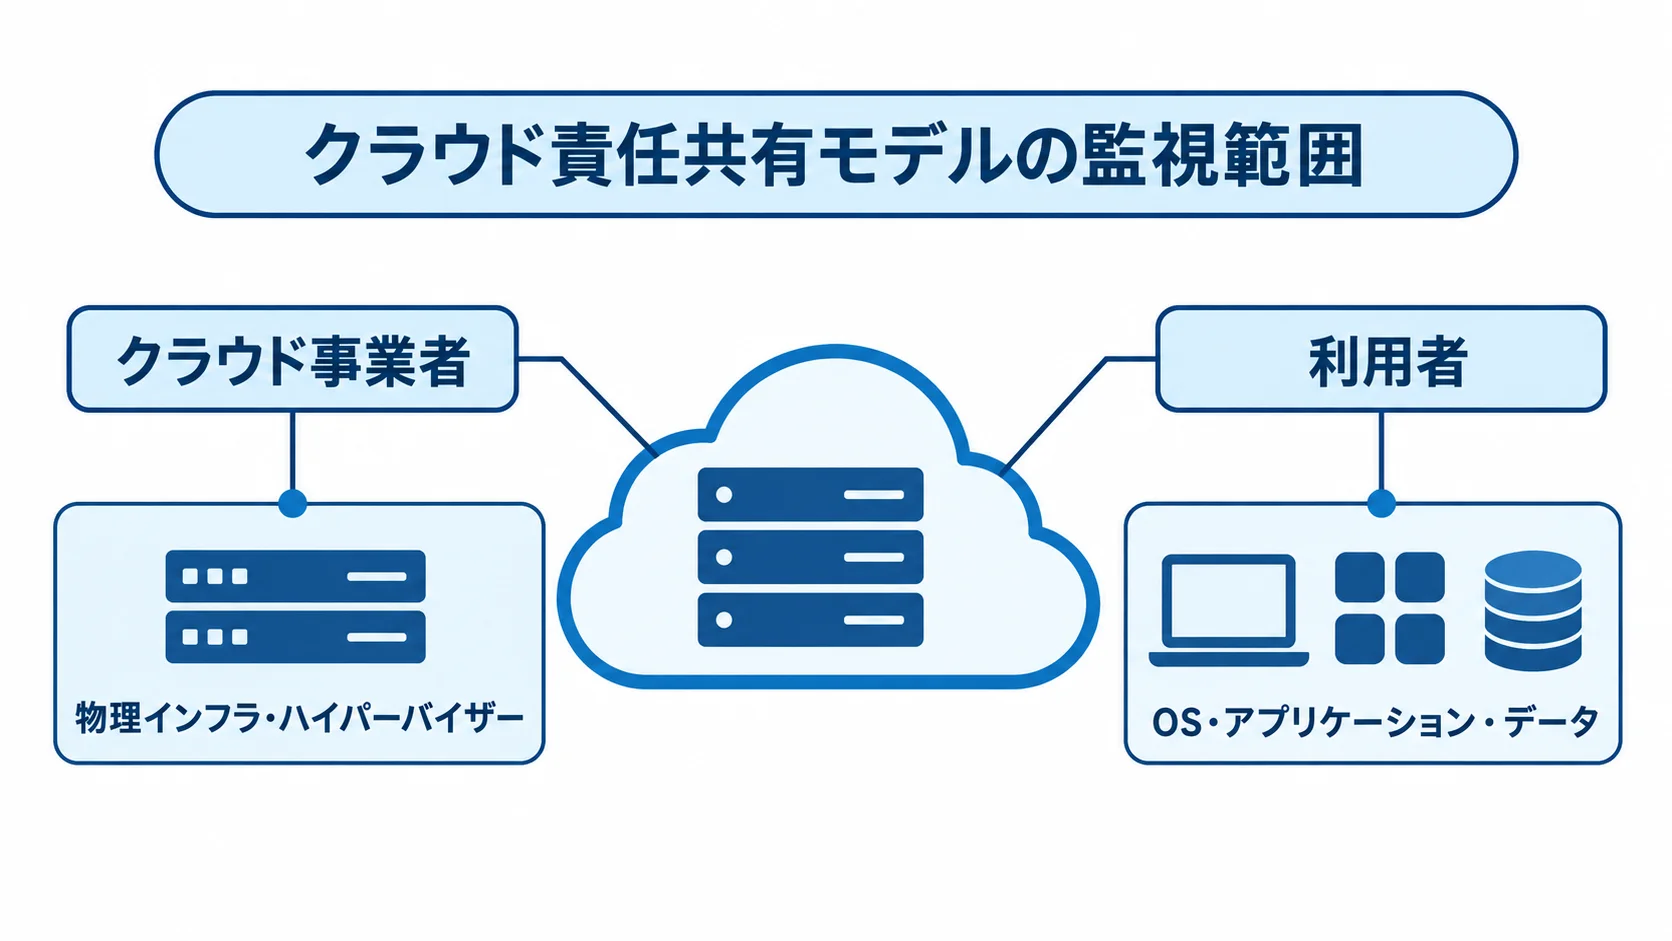
クラウド環境のログ監視では、責任共有モデルを前提に監視範囲を定義する必要があります。
IDC Japanの調査では、国内エンタープライズ・システム市場のクラウド比率は2022年で約5割に達しており、いまや多くのシステムがクラウド上で動いています。
自社の責任とクラウド事業者の領域の境目を踏まえないと、監視の抜け漏れや無意味な要求が生じます。
責任共有モデルでの監視範囲の線引き
クラウドの責任共有モデルでは、物理インフラやハイパーバイザーはクラウド事業者の責任になります。一方で、その上で動くOSやアプリケーション、データは利用者の責任となるのが一般的です。このため、クラウド基盤そのものの障害は利用者側で手出しできず、監視の対象外として扱うのが現実的です。
注意したいのは、クラウド基盤障害で「監視のブラックボックス化」が起きる点です。クラウド事業者側で障害が起きても、利用者はサービスクレジット以上の補償を受けられないことが一般的です。
要件定義では、この前提を踏まえ、クラウドの稼働状況を示すステータスページの監視や、マルチリージョン構成による自衛策を盛り込むかどうかを検討します。
クラウドだからと丸投げせず、利用者側で取れる監視と自衛の範囲を明確にします。そのうえで、自社が監視するレイヤーを次の2つに分けて書き出します。
- 利用者側のログ:アプリケーションとOSのログ
- 事業者側の記録:クラウド事業者が提供する監査ログのうち、対象にする範囲
監視ツール選定の評価基準
RFPには、どの監視ツールを使うかの評価基準も含めると、提案の質が上がります。
OSSのZabbixはライセンス無料ですが、構築と維持に工数がかかります。一方、クラウド型のDatadogやNew Relicは、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円かかります。
サーバー監視にはMackerel、SIEM用途にはSplunk Cloudといった具合に、ツールには得意領域があります。
要件定義書では、ツールを名指しで指定するより、評価基準を示すほうが、ベンダーの提案の幅が広がります。
とくにクラウド型は従量課金のため、ログ量が増えると費用が膨らむ「隠れコスト」に注意が必要です。要件には、想定するログ量と将来の増加を見越した費用シミュレーションの提示を求める一文を入れておくとよいでしょう。
- 環境と連携:自社のクラウド環境への対応、既存システムとの連携
- 料金の見通し:ログ量の増加に応じた料金体系の見通し
対応範囲の明文化と隠れコストの防止
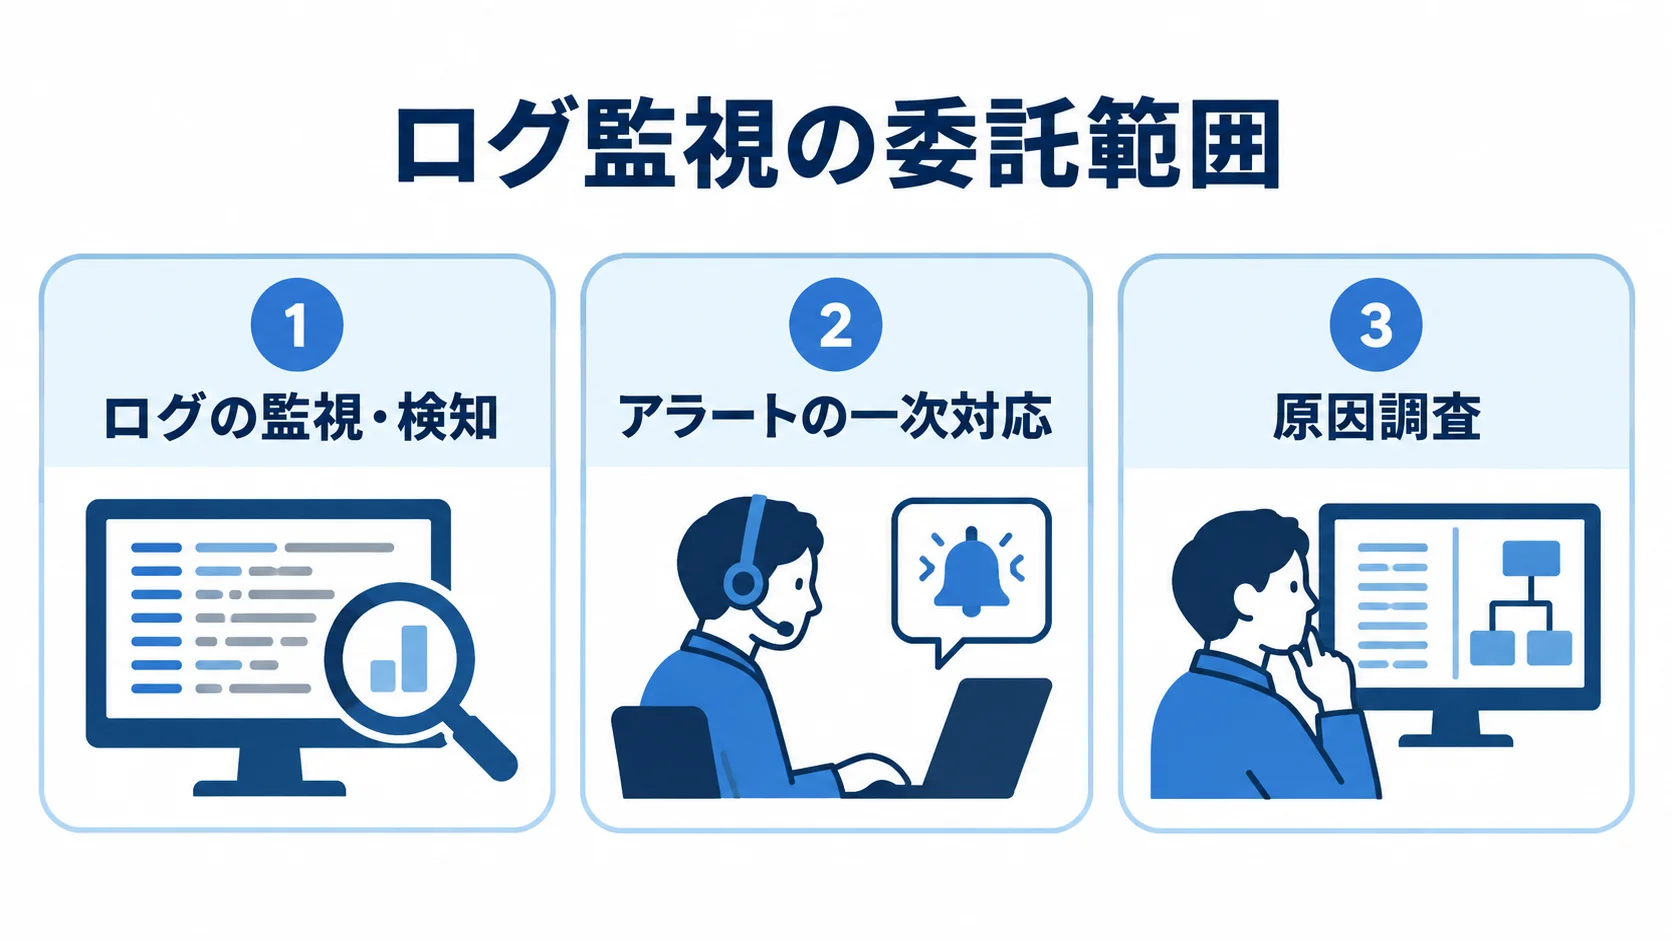
ログ監視の委託で最もトラブルになりやすいのが、対応範囲の認識ズレです。「監視」という言葉には、ログを見るだけなのか、異常時に対応まで行うのか、原因調査まで含むのか、幅があります。
要件定義書で対応範囲を曖昧にしたまま発注すると、いざというときに「それは範囲外」と言われ、追加費用や対応の遅れに苦しむことになります。
監視・一次対応・原因調査の線引き
対応範囲を明文化する際は、業務を段階に分けて、それぞれが基本料金に含まれるか追加費用かを定義します。
具体的には、ログの監視・検知、アラートの一次対応、原因調査という流れに分け、どこまでを委託するかを書き切ります。
一次データでは、運用・監視(24/365の死活・リソース監視)が月5万〜20万円、24時間緊急の障害対応が月10万〜20万円、スポット対応が1件3万〜10万円といった相場感があります。
この線引きを明確にすると、見積もりの妥当性も判断できるようになります。たとえば「監視のみ月3万円」という安い提案は、障害時の対応が含まれていない可能性が高く、いざというとき自社で深夜対応する羽目になります。
要件定義書で「重大障害時は一次対応と原因調査まで含む」と明記しておけば、各社の提案を同じ土俵で比較できます。対応範囲の定義こそが、安すぎる見積もりの罠を避ける最大の防御になります。
- 一次対応:切り分けと暫定処置
- 恒久対応と報告:段階に含めて、委託範囲を定義する
報告体制とベンダー切り替え条項
riplaは、フルスクラッチ受託と国内運用保守の立場から、要件整理から監視設計まで、システムの作り手として一貫して伴走しています。
要件定義書には、定常的な報告体制も明記します。月次でどんなレポートを提出するか、ログの傾向分析や改善提案を含むか、インシデント時の報告フォーマットはどうするかを定めておくと、運用が形骸化しません。
情シスは経営層や業務部門へ状況を報告する立場にあるため、ベンダーからの報告がそのまま社内報告に使える品質であることが望ましいです。
あわせて、将来のベンダー切り替えを見据えた条項も入れておくと安心です。ログ監視は一度委託すると設定がブラックボックス化しやすいため、引き継ぎの取り決めは最初の契約で押さえておきます。
特定ベンダーへのロックインを防ぐには、次の2点を要件に含めます。
- 解約時の予告期間:解約を告げてから終えるまでの期間
- ドキュメントと移管:監視設定や閾値設計のドキュメント引き渡し、監視アカウントの移管手順
まとめ
ITシステムのログ監視のRFP・要件定義書で成功の鍵になるのは、監視対象と閾値、SLA、対応範囲を数値と文章で曖昧さなく定めることです。
監視対象ログは事業影響度で優先度を付け、閾値は数値で書き切ります。SLAは稼働率99.9%と99.99%の差を理解して定め、監視範囲はクラウドの責任共有を前提に線引きします。また、監視・一次対応・原因調査の線引きで隠れコストを防ぎます。この一連の整理が、適正な費用と確実な対応を引き出します。
要件定義では、発注側が監視の設計思想を持つことが欠かせません。その出発点になるのは、ベンダーに任せる前に、発注側が考えをまとめておくことです。
何を、どの閾値で、どこまで監視するか、いざというとき誰がどう動くかを発注側が言語化できてはじめて、安すぎる見積もりの罠を避け、各社を公平に比べられます。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、システムの構造を踏まえた監視要件の整理と、ブレない要件定義書づくりを一貫して支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。