
ログ監視の主な失敗は四つです。アラートの形骸化とSLA・見積もりの過不足、クラウド監視のブラックボックス化、発注者側の初動とBCP不在があります。
導入するだけでは安心できず、設計・運用・契約の各段階に落とし穴があります。全体像はITシステムログ監視の完全ガイドをご覧ください。
▼全体ガイドの記事
・ITシステムログ監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
アラート疲れと監視の形骸化
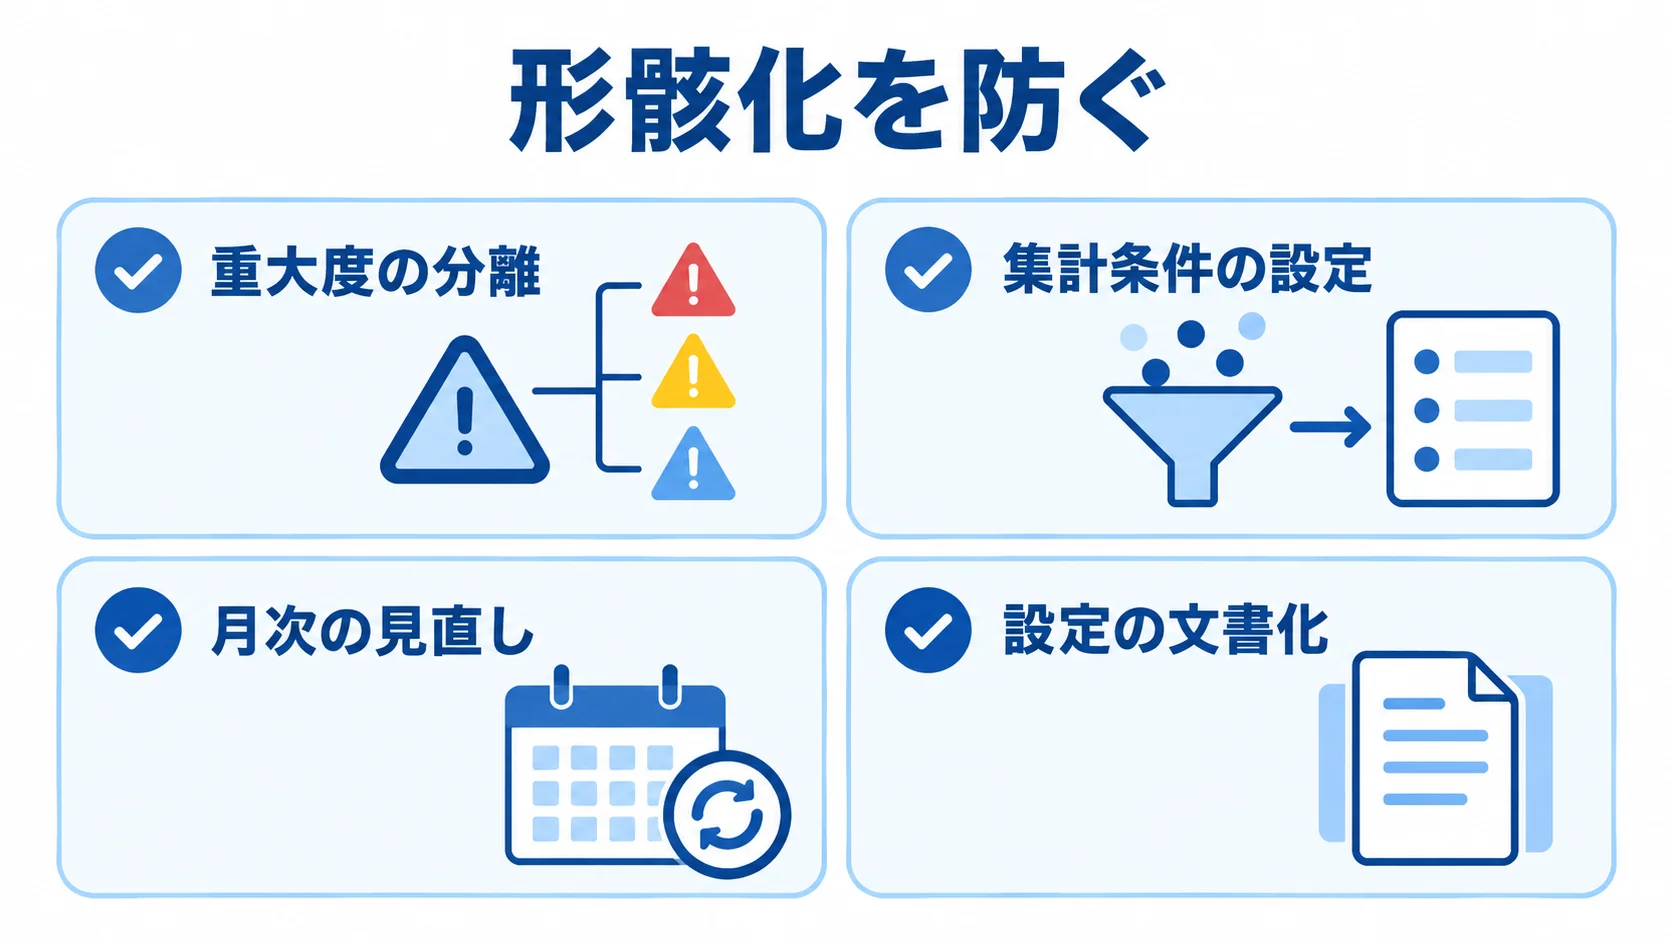
ログ監視で最も多い失敗は、アラートが鳴りすぎて誰も見なくなる「アラート疲れ」による形骸化です。
通知が多すぎて担当者が麻痺すると、重要な異常を見逃してしまいます。これは技術よりも運用設計の問題です。
厄介なのは、形骸化が静かに進み、当事者が気づきにくい点です。アラートを見なくなったことに自覚がないまま日々が過ぎ、重大障害が起きて初めて「監視が役に立っていなかった」と判明します。
監視設定が属人化していると、原因の特定も改善も難しくなります。
過剰なアラートで重要な異常を見逃す失敗
ログ監視を始めたばかりの頃は、心配のあまり多くのキーワードを通知対象にしがちです。
すると、対応の要らない警告まで含めて大量のアラートが鳴り続け、担当者は次第に通知を真剣に見なくなります。そのため、本当に重大な障害のアラートが、その他大勢に埋もれて見逃されます。
これは「狼少年」状態であり、ログ監視が機能不全に陥る典型的な失敗です。監視はしているのに、いざというとき気づけないという最悪の事態を招きます。
この失敗を防ぐには、アラートの重大度を分け、即時対応が必要なものだけを即時通知に絞ることが不可欠です。
アラートは、絞り込むほど効くと捉える発想の転換が、形骸化を防ぐ最大のポイントです。
通知は、重大度の分離と集計条件の設定で絞ります。
- 重大度の分離:翌営業日に確認する警告と、夜間でも鳴らす通知の区別
- 集計条件の設定:「5分間に何回以上」といった条件による平常時ノイズの除外
夜間でも鳴らすのは、サービス停止に直結するものだけです。
閾値チューニングを放置する失敗
もう一つの形骸化の原因が、閾値の放置です。ログ監視は導入後も、システムの変化に合わせて閾値を見直し続ける必要があります。
たとえば、サービスの成長でアクセスが増えれば、平常時のログ量も変わります。
これを放置すると、以前は妥当だった閾値が誤検知だらけになったり、逆に検知漏れを起こしたりします。こうした監視は、徐々に実態と乖離していきます。
この失敗を防ぐには、定期的に監視内容を見直す仕組みを運用に組み込むことが大切です。
委託している場合は、この見直しと改善提案が契約に含まれているかを確認しておくべきです。
ログ監視は手入れを続けてこそ価値を保ちます。作りっぱなしの監視は、いつの間にか役に立たなくなるリスクを抱えています。
月次の見直しでは、アラートの振り返りと見逃しの確認を行います。
- アラートの振り返り:鳴ったアラートのうち、実際に対応が必要だったものの把握
- 見逃しの確認:見逃した障害の有無と、それに基づく閾値の調整
監視設定が属人化して引き継げない失敗
形骸化と並んで根深いのが、監視設定の属人化です。閾値の根拠や除外条件、アラートの分岐ロジックが特定の担当者の頭の中にしかなく、ドキュメント化されていないケースは少なくありません。
その担当者が異動や退職をすると、なぜこの閾値なのか、このアラートは無視してよいのかが誰にもわからなくなります。結果として、怖くて設定に触れず、形骸化した監視をそのまま放置するという二次的な失敗を招きます。
この失敗を防ぐには、監視設計の意図を必ず文書として残すことが欠かせません。そうしておけば、誰が見ても運用を引き継げます。
委託先に運用を任せる場合も、設定内容と変更履歴を発注者側が把握できる形で共有してもらうべきです。特に、少人数の情シスほど属人化は起きやすく、人が一人欠けただけで監視が崩れるリスクを抱えています。そのため、設定の内容を誰でも確かめられる状態にしておくことが、その崩壊を防ぐ最も確実な備えです。
文書化は、社内の設定と委託先からの共有の両面で進めます。
- 設定の文書化:各アラートの目的と閾値の算出根拠、対応手順とエスカレーション先の一覧
- 委託先からの共有:設定内容と変更履歴を、発注者側が把握できる形での受け渡し
過剰・過少SLAと安すぎる見積もりの罠
SLAと見積もりにも、失敗の落とし穴が潜んでいます。SLAは過剰でも過少でも問題を生み、安すぎる見積もりには対応範囲の欠落という罠が隠れています。
費用と品質のバランスを見誤ると、無駄なコストを払うか、いざというとき動いてもらえないかのどちらかに陥ります。
過剰SLAで無駄なコストを払うリスク
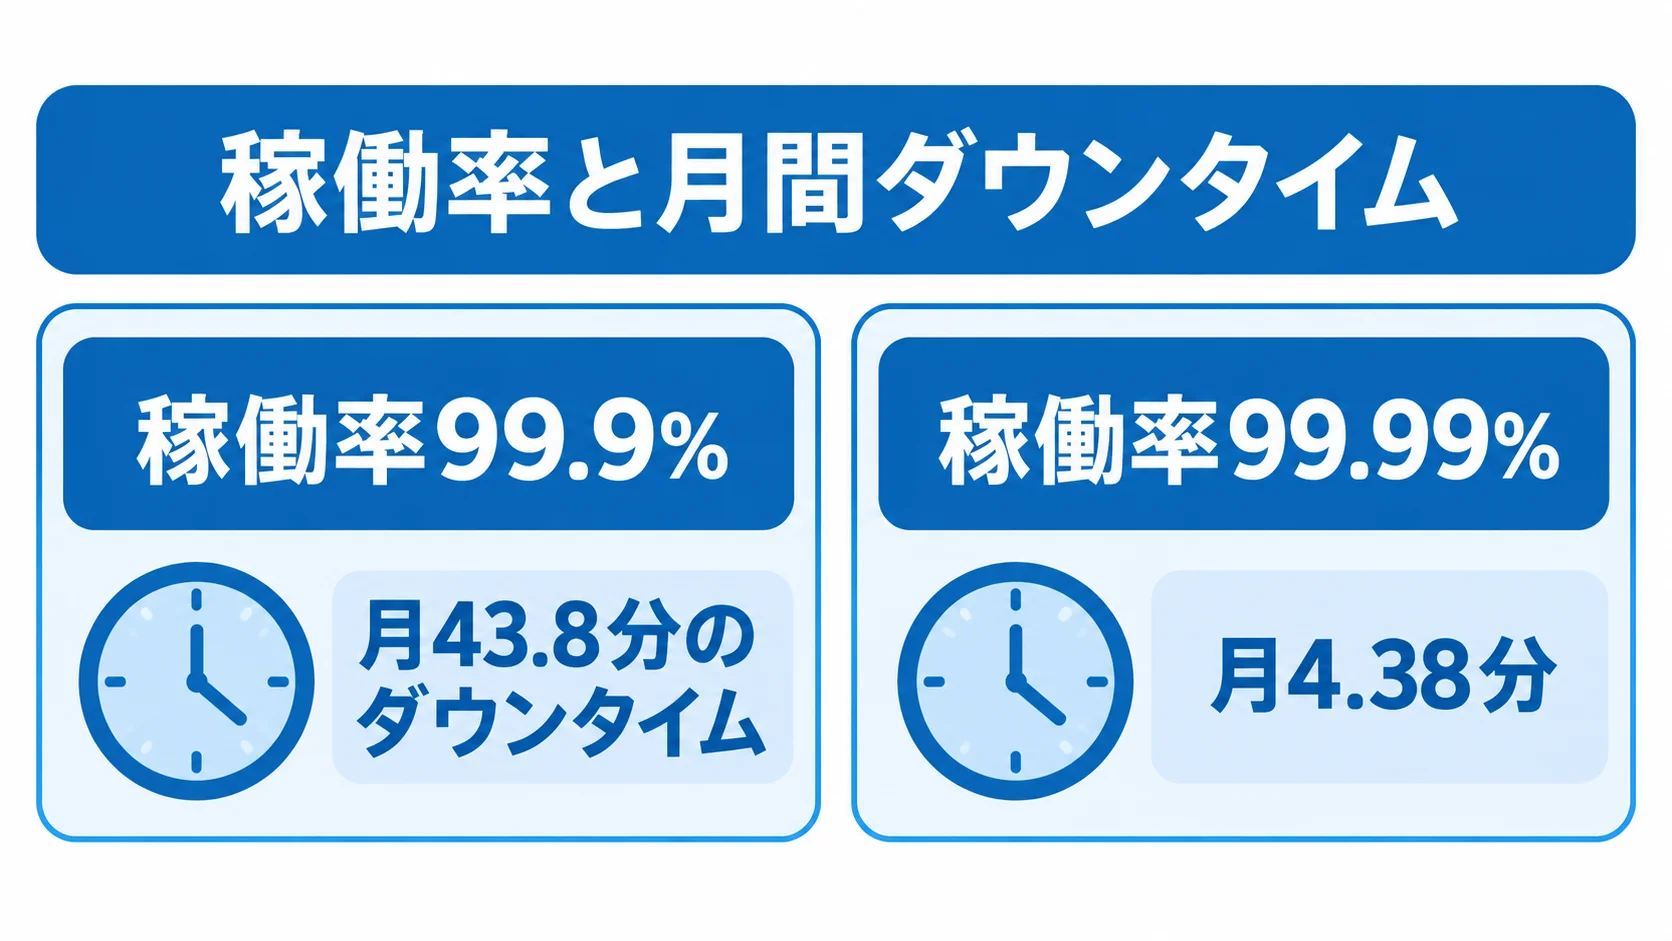
SLAは、システムの重要度に見合った水準で決めることが大切です。たとえば、稼働率99.9%は月43.8分のダウンタイムを許容しますが、99.99%にすると月4.38分まで縮まります。
この差を実現するには冗長構成や即時対応体制が必要で、「9」が一つ増えるごとに運用コストは段階的に跳ね上がります。深夜に数分停止しても事業影響が小さいシステムに最高水準のSLAを求めるのは、明らかな過剰投資です。
この失敗の背景には、情シスがビジネス部門の「止まったら困る」という漠然とした要求をそのまま受け入れてしまう構図があります。
これを避けるには、事業影響度アセスメントで「このシステムが何分止まるといくらの損失か」を数字で示し、ビジネス部門と許容ダウンタイムを合意することが必要です。過剰SLAを緩める作業は、情シスがビジネス部門を説得する社内調整の力も問われる仕事です。SLAを下げる判断が、無駄なコストを削る鍵になります。
SLAの水準は、許容ダウンタイムと冗長化の費用を並べて判断します。
- 許容ダウンタイム:事業影響から見て、何分まで止まってよいかの見極め
- 冗長化の費用:99.9%から99.99%へ上げたときの、冗長構成と即時対応体制のコスト
安すぎる見積もりに潜む対応範囲の欠落
一方で、安さだけで監視契約を選ぶと、過少SLAや対応範囲の欠落という罠にはまります。月額数千円の格安監視サービスは、しばしば死活監視のみで、ログの内容分析や一次対応、原因調査が含まれていません。
重大な障害の際に「それは契約範囲外です」と言われ、結局、自社で深夜にログを掘り起こすことになりかねません。安すぎる見積もりには、必ずと言っていいほど何かが欠けています。
この罠を見抜くには、見積もりの総額よりも、対応範囲とSLAを見ることが重要です。
運用・監視が月5万〜20万円、24時間緊急の障害対応が月10万〜20万円という相場を下回る提案は、必ず対応範囲を疑うべきです。安さの裏にある「含まれないもの」を見極めることが、最大の防御になります。
見積もりは、対応範囲とSLAの性質の両方から確かめます。
- 対応範囲:監視だけか、一次対応と原因調査まで含むか
- SLAの性質:努力目標か保証か、未達時のサービスクレジットの有無
賠償上限と間接損害免責を見落とすリスク
SLAと並んで見落とされがちなのが、契約上の責任範囲です。多くの監視・運用契約には、損害賠償の上限額が「月額料金の◯ヶ月分まで」と定められ、さらに機会損失などの間接損害は免責される条項が入っています。
つまり、監視の不備で重大な障害を見逃され、1,200万円規模の機会損失が出ても、回収できるのは月額料金の数ヶ月分にとどまる、というのが実態です。この差を知らずに契約すると、いざというとき「思っていた補償が受けられない」という失敗に直面します。
監視を委託しても、最終的な事業リスクは発注者に残るという前提を忘れると、契約書の細部に潜む罠を見過ごしてしまいます。安さや手厚さの見かけだけでなく、責任の所在まで確認する姿勢が欠かせません。
契約では、上限と免責、交渉と備えの両面から見ます。
- 上限と免責:賠償上限と間接損害の免責条項を、事業影響度と照らして読むこと
- 交渉と備え:上限額の引き上げや一次対応の保証の交渉、回収できない損失への自社の備え
重要なシステムであれば、上限額の引き上げや一次対応の保証を交渉する余地があります。
クラウド監視のブラックボックス化
クラウドやSaaSへの移行が進むなか、新たに浮上しているのが「監視のブラックボックス化」というリスクです。
IDC Japanの調査では、国内エンタープライズ・システム市場のクラウド比率は2022年で約5割に達しています。しかし、クラウド基盤の内部は利用者から見えません。
また、障害時に手出しできない領域が広がっています。この見えにくさが、新しいタイプの失敗を生んでいます。
クラウド基盤障害に手出しできないリスク
ダウンタイムは1分あたり5,600米ドル、停止1回あたり平均1,200万円という損失統計を踏まえると、クラウド障害のリスクは決して小さくないのです。
この失敗の落とし穴は「クラウドだから安心」という思い込みです。クラウドは可用性が高い一方で、障害がゼロになるとは限りません。
クラウドへの過信は、いざというときに「監視はしていたが何もできなかった」という無力感につながりかねません。
基盤障害では、復旧の主導権と補償の中身を押さえます。
- 復旧の主導権:基盤の復旧はクラウド事業者が担い、自社は手出しできないという前提
- 補償の中身:サービスクレジットは料金の一部返金で、機会損失は埋めないという点
たとえ大きな損害が出ても、補償は契約上のサービスクレジットにとどまるのが一般的です。
自衛のアーキテクチャ設計を怠るリスク
クラウドのブラックボックス化に対する自衛策が、アーキテクチャ設計です。単一リージョンに依存していると、そのリージョンが障害を起こした瞬間にサービスが全停止します。
これを避けるには、マルチリージョン構成で冗長化し、一方が落ちても他方で稼働を続けられる設計が有効です。この自衛策を怠ると、クラウド事業者の障害がそのまま自社サービスの停止に直結してしまいます。
ただし、マルチリージョン化には隠れコストが伴います。インフラ費用が増え、構成が複雑になり、運用負荷も上がります。
すべてのシステムに最高レベルの冗長化を施すのは過剰投資であり、事業影響度に応じてどこまで自衛するかを判断することが現実的です。この見極めを怠ると、可用性とコストのどちらかで失敗します。
ログ監視だけでなく、その先のアーキテクチャ設計まで視野に入れることが、クラウド時代のリスク管理です。
自衛策は、冗長化の範囲と隠れコストを見比べて決めます。
- 冗長化の範囲:止まると致命的なシステムに限ったマルチリージョン構成
- 隠れコスト:インフラ費用の増加、構成の複雑化、運用負荷の上昇
責任共有モデルの誤解で監視が抜け落ちるリスク
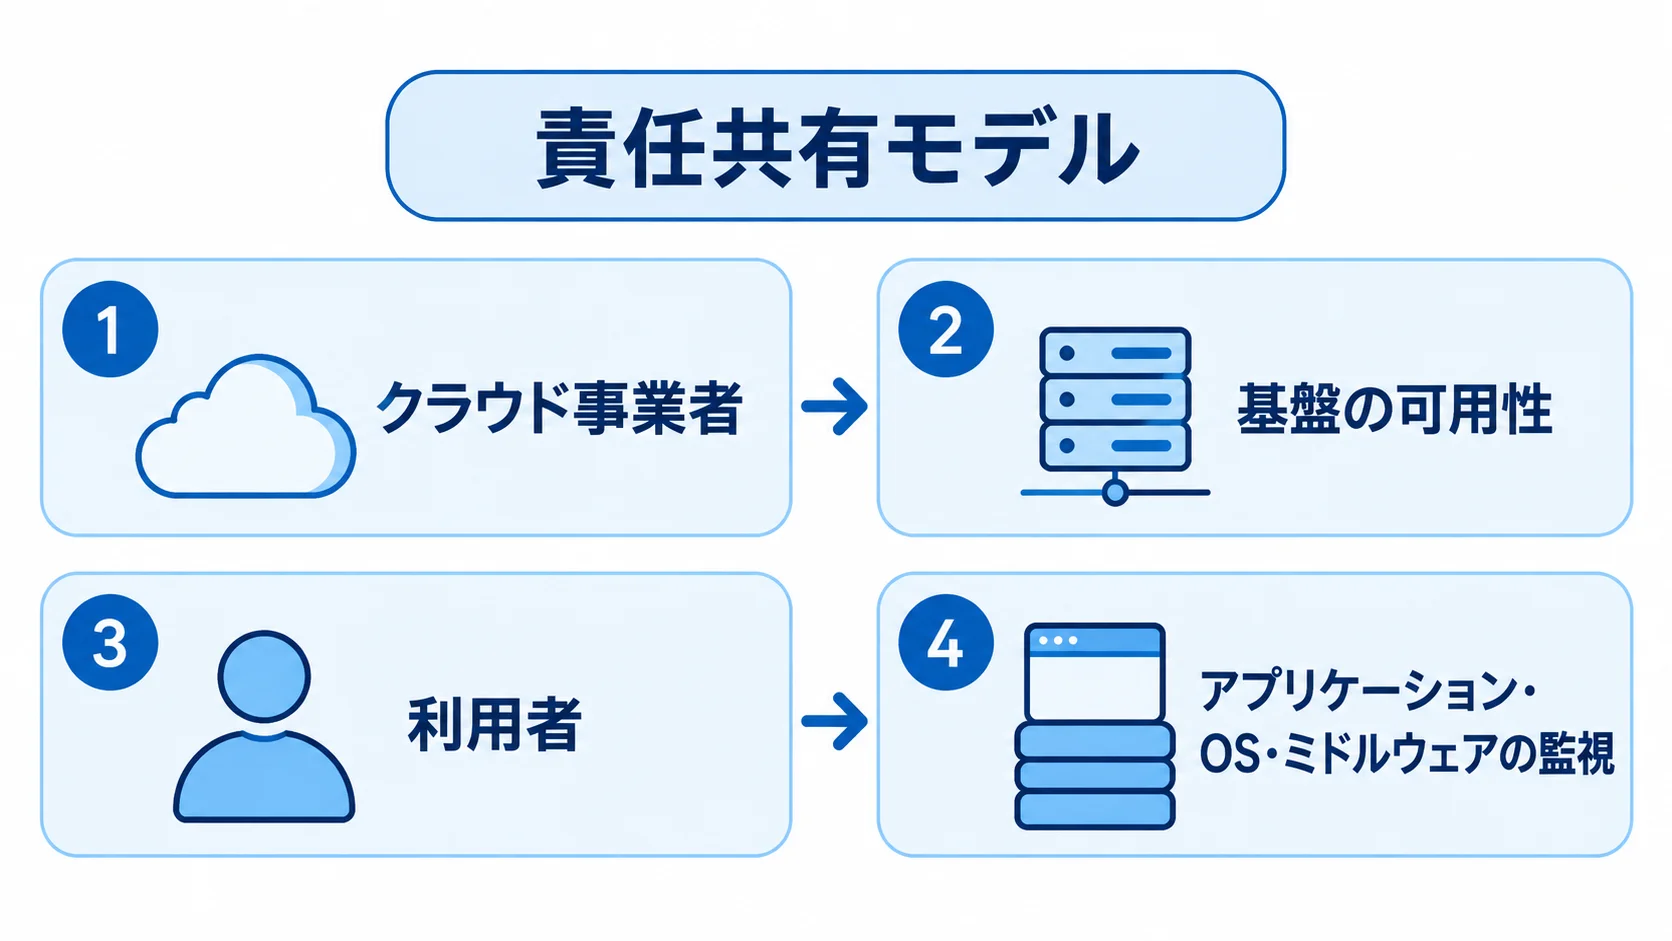
クラウド特有のもう一つの失敗が、責任共有モデルの誤解です。クラウドでは、基盤の可用性はクラウド事業者が担いますが、その上で動くアプリケーションやOS、ミドルウェアの監視は利用者の責任です。
ところが「クラウドだから全部見てくれている」と思い込み、利用者責任の領域に監視を入れ忘れるケースが後を絶ちません。基盤は無事でも、自社アプリのプロセス停止やディスク逼迫を誰も監視しておらず、障害に気づけないという穴が生まれます。
この失敗を防ぐには、契約や利用規約で定められた責任分界点を正確に把握し、利用者側の領域に監視が漏れなく入っているかを点検することが不可欠です。どこまでがクラウド事業者の責任で、どこからが自社の責任かを一覧にし、自社側の監視項目を埋めていきます。
委託している場合も、この分界点の認識をベンダーとすり合わせておかないと、双方が「相手が見ているはず」と思い込む空白地帯が生まれます。特に、責任の境界を曖昧にしたまま運用を始めることは、クラウド時代に最も起きやすい監視の抜け落ちです。
責任の線引きは、責任の境界の把握とベンダーとの認識合わせで進めます。
- 責任の一覧:クラウド事業者と自社の責任の境界を、領域ごとに分けること
- ベンダーとの認識合わせ:委託先と責任分界点の認識を揃え、空白地帯を作らないこと
発注者側の初動失敗とBCP不在
最後に、最も語られにくく、しかし差別化が効く失敗が、発注者である情シス側の立ち回りの問題です。
ログ監視をベンダーに委託しても、障害時に発注者側が何もしなくてよいわけではありません。経営層や業務部門への報告、エスカレーション、BCPと連動した初動は発注者の役割であり、ここでつまずく失敗が後を絶ちません。
経営層への報告遅延とエスカレーション不全
障害が発生したとき、ログ監視のベンダーが技術的な対応を進めても、社内の経営層や業務部門への報告は発注者である情シスの仕事です。
ここで報告が遅れると、経営層が事態を把握できず、対外的な説明や意思決定が後手に回ります。「ベンダーが対応しているから大丈夫」と社内共有を怠った結果、顧客対応や広報が遅れて二次被害を招く、という失敗は少なくありません。
この失敗を防ぐには、障害時の社内エスカレーションの流れをあらかじめ定めておくことが不可欠です。具体的には、誰がどのタイミングで経営層に報告するかを決めておきます。
この役割分担を平時に決めておかないと、いざというとき情シスが技術対応と社内調整の両方を一人で抱え込み、機能停止に陥ります。ログ監視の委託は技術対応を任せられても、社内向けの初動と報告は発注者が担う領域だと、明確に認識しておくべきです。
社内の初動では、報告の担当と顧客告知の判断者を平時から決めておきます。
- 報告の担当:経営層への報告と業務部門への周知を受け持つ担当
- 顧客告知の判断者:顧客への告知を判断する担当
BCP不在で初動が崩れるリスク
もう一つの発注者側の失敗が、BCP(事業継続計画)の不在です。ログ監視で障害を検知できても、それを受けてどう事業を継続するかの計画がなければ、現場は混乱します。
代替手段への切り替え、顧客への一斉連絡、復旧までの暫定運用といった段取りが決まっていないと、検知から対応までの間に貴重な時間を浪費します。監視は「気づく」仕組みであり、その後どう動くかはBCPが担う領域です。
この失敗を避けるには、ログ監視の導入と並行して、検知後の行動計画をBCPに組み込んでおくことが大切です。
障害を検知したら、初動で誰が何をするかを手順にまとめ、定期的に訓練しておけば、いざというときに迷わず動けます。riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作るだけでなく、作った後の障害対応や初動の設計まで継続して伴走しています。
ログ監視を「気づく仕組み」で終わらせず、「気づいた後に動ける体制」までセットで整えることが、失敗を避ける最後の備えになります。
初動体制は、初動の手順と定期的な訓練で整えます。
- 初動の手順:障害の検知後に誰が何をするかをまとめた手順書
- 定期的な訓練:手順を繰り返し確かめ、迷わず動ける状態を保つこと
まとめ
ITシステムのログ監視の失敗・リスクを振り返ると、落とし穴は四つに集約されます。
一つ目はアラートの形骸化、二つ目はSLAと見積もりの過不足、三つ目はクラウド監視のブラックボックス化です。四つ目は、発注者側の報告遅延とBCP不在です。
いずれも技術の問題というより、運用設計・契約・社内体制の問題であり、事前に知っていれば避けられるものばかりです。
失敗を避ける共通の鍵は、ログ監視を導入して終わりにしないことです。アラートを絞り込み、SLAと対応範囲を適正にそろえ、クラウドでは自衛策を講じたうえで、検知後の初動体制まで一貫して整えます。
発注者は、監視設定を属人化させず文書で引き継げる状態にし、契約書の賠償上限や免責、クラウドの責任分界点まで確認しておけば、見落としがちな落とし穴も塞げます。
監視は気づく仕組みにすぎず、気づいた後に誰がどう動くかまで設計して初めて、事業継続の保険として機能します。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムの構造を踏まえた監視設計から、障害時の初動とBCP連動までを一貫して支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。