
ITシステムの不具合対応は、受付から再発防止まで複数の機能が連なって成立します。発注企業が確認したい機能は、4つの機能群に分けて整理できます。
- 受付・トリアージ:不具合を受け付け、緊急度と影響度で優先順位を付ける機能
- 切り分け・暫定対応:発生箇所を特定し、業務を止めないために復旧する機能
- 原因調査・恒久対応:根本原因を調べ、修正とテストまで進める機能
- 報告・再発防止:対応内容を共有し、同じ不具合を減らす機能
委託先の対応範囲は、各機能が見積もりや契約にどこまで含まれるかで読み解けます。全体像を先に確認したい方は、ITシステム不具合対応の完全ガイドも参照してください。
▼全体ガイドの記事
・ITシステム不具合対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
不具合の受付・トリアージ機能
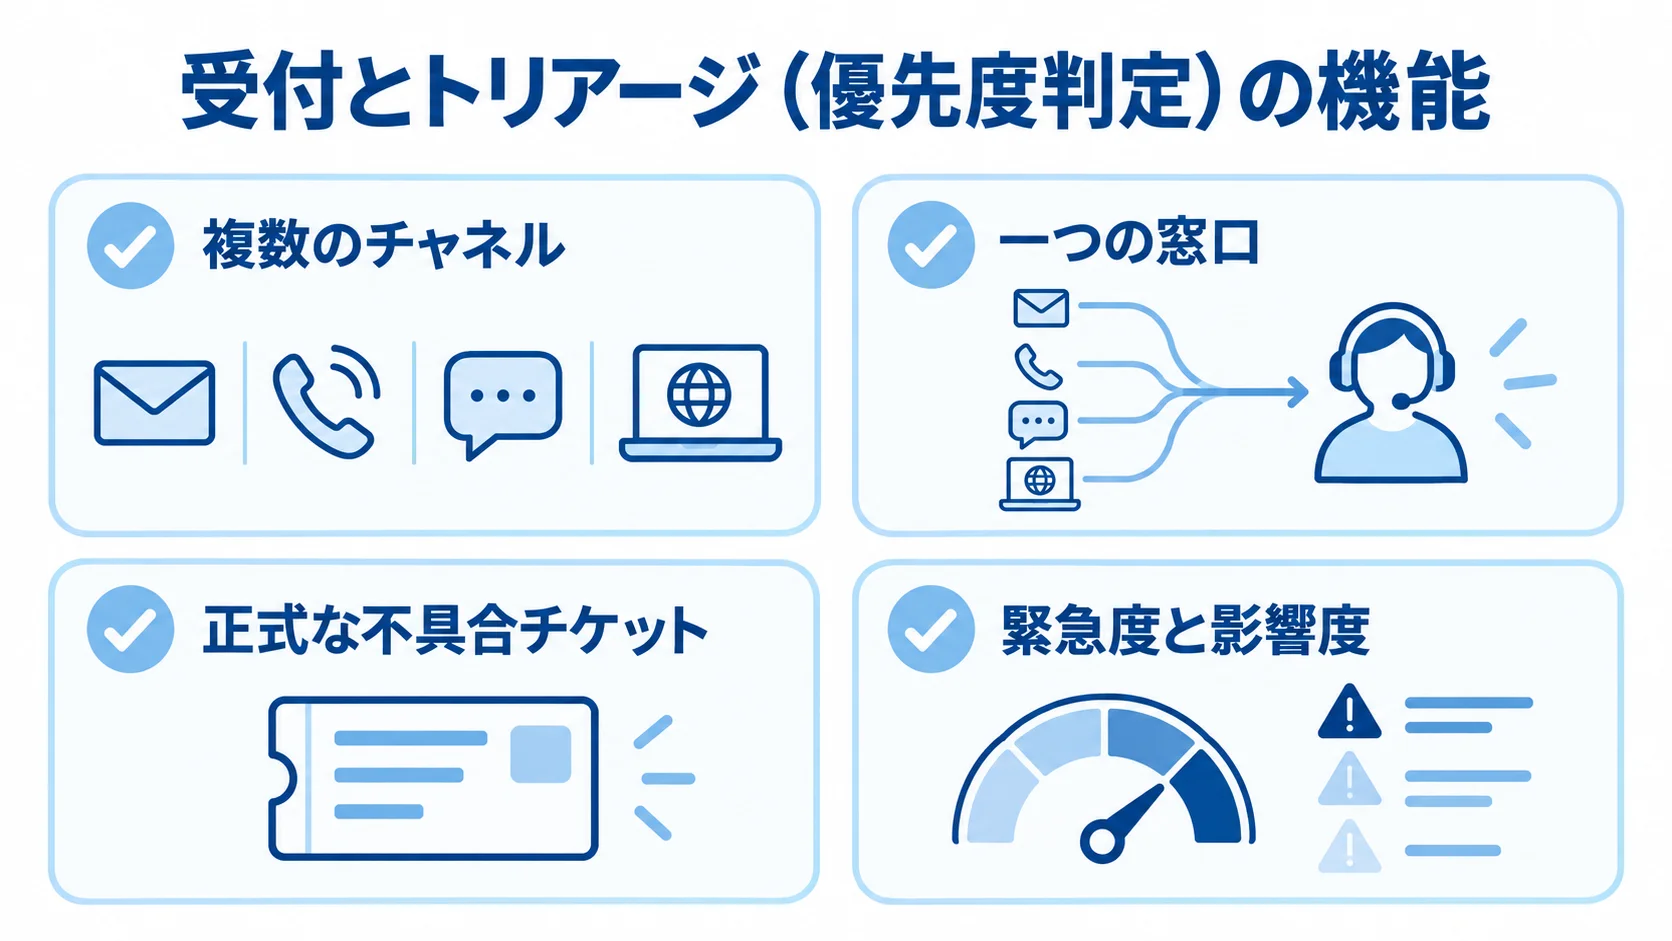
不具合対応の入り口は、受付とトリアージ(優先度判定)の機能です。利用者から「画面が動かない」と連絡が入ったとき、それを正式な不具合チケットとして受け付け、緊急度と影響度から優先順位を付けます。
この最初の交通整理がうまく機能しないと、軽微な不具合に人手を取られ、本当に急ぐべき重大不具合の対応が遅れます。受付・トリアージは地味に見えても、対応全体の質を左右する起点の機能です。
一次対応窓口と受付チャネルの機能
受付機能の中核は、不具合の連絡を確実に受け取る一次対応窓口です。電話やメール、チャット、専用フォームといった複数のチャネルから入る連絡を一つの窓口にまとめ、見落としなくチケット化する仕組みが求められます。さらに、窓口が一つにまとまると、「誰に連絡すればいいか分からない」という現場の混乱もなくなります。
また、委託サービスの多くは、この一次対応窓口を標準機能として提供しています。費用感も一次データで示されており、24時間体制なら月10万〜20万円、営業時間内なら月3万〜8万円とされています。
窓口機能を評価するときは、受付した不具合がどう記録されるかも確認してください。優れたサービスでは、受付時刻や連絡者、症状、影響範囲を定型フォーマットで記録し、原因調査や再発防止に活かせる形で蓄積します。逆に、その場の対応で終わり記録が残らないため同じ不具合が繰り返されても気づけないと、受付と記録の標準化が、その場しのぎを組織的な改善に変える基盤になります。
緊急度・影響度による優先度判定の機能
受け付けた不具合をすべて同じ速度で対応するのは非効率です。そこで必要になるのが、緊急度と影響度の二軸で優先度を判定するトリアージ機能です。トリアージは、単なる仕分けを超えて、事業影響を正しく評価する経営判断の入り口だと捉えるべきです。
たとえば、全社の業務が止まる重大不具合は最優先で即時対応し、一部の利用者の軽微な表示崩れは翌営業日に対応する、といった基準を事前に定めておくと、限られたリソースを正しく配分できます。この基準は、後述するSLA(サービスレベル合意)の対応時間とも連動させるのが一般的です。
とくに、判定基準は発注者と委託先で事前にすり合わせておくことが欠かせません。委託先が「軽微」と判断した不具合が、業務部門にとっては死活問題になる、というズレは珍しくありません。重大・高・中・低のレベルごとに、どんな症状が当たるかを契約段階で具体的に定めておくと、いざというときの認識違いを防げます。
切り分けと暫定対応の機能
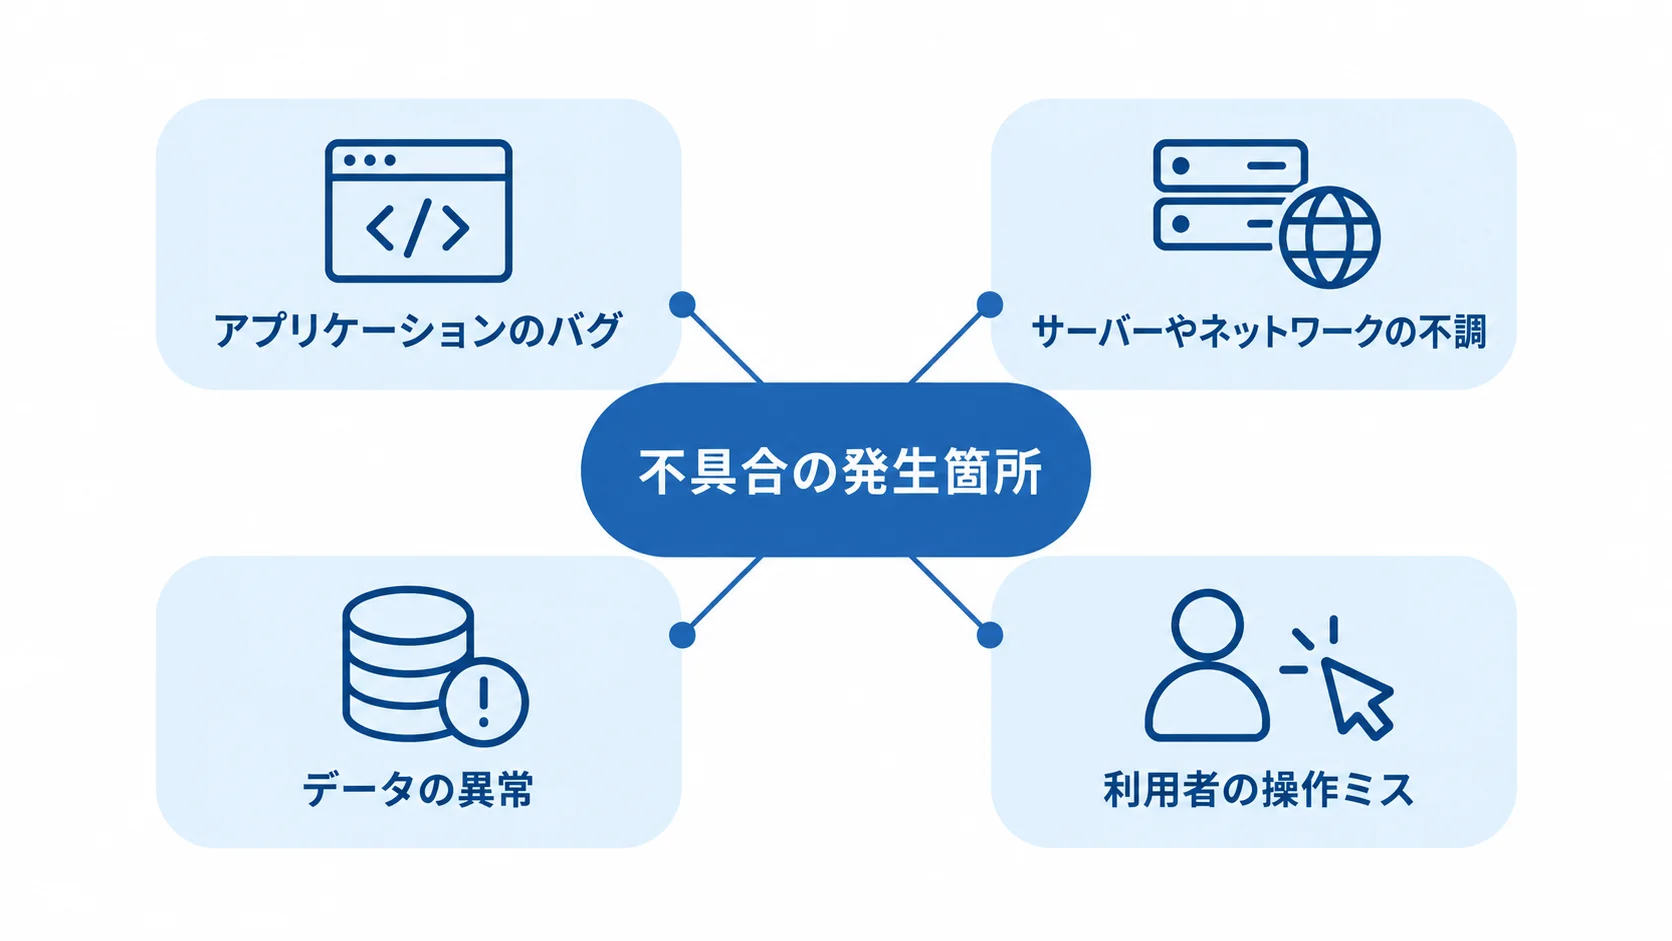
不具合の連絡を受けたら、次に必要になるのは、「何が原因で、どこで起きているのか」を切り分ける機能です。あわせて、業務を止めないための暫定対応の機能も求められます。
不具合の原因は、アプリケーションのバグ、サーバーやネットワークの不調、データの異常、あるいは利用者の操作ミスと多岐にわたります。そのため、この切り分けを素早く行い、まず業務を回復させる暫定対応を打てるかどうかが、復旧時間(MTTR)を大きく左右します。
アプリ・インフラ・データを切り分ける機能
切り分け機能の本質は、不具合の発生箇所をシステムの層ごとに特定することです。たとえば、画面が表示されないという同じ症状でも、原因がアプリケーションのバグなのか、サーバーのリソース不足なのか、ネットワークの断線なのかで、対応はまったく異なります。
優れた不具合対応では、ログ監視や死活監視と連携して、どの層で異常が起きているかをデータに基づいて切り分けます。反対に、監視機能が整っていないと、切り分けに時間がかかり、復旧も遅れます。この切り分けを担うのは、運用設計やインシデント分析のスキルを持つ人材で、委託費の差もそのスキルレベルの差に由来します。
一次データでは、運用設計・インシデント分析の人月単価は80万〜120万円、監視オペレーターは60万〜80万円が目安とされています。一方で、安価なサービスは一次受付しかせず、切り分けを別料金や別ベンダー任せにしている場合もあります。そのため、「切り分けまで含まれるか」は契約前に必ず確認してください。
業務を止めない暫定対応(ワークアラウンド)の機能
原因を完全に特定するには時間がかかることがあります。その間も業務を止めないために必要なのが、暫定対応(ワークアラウンド)の機能です。サーバーの再起動、該当機能の一時停止と代替手順の提示、エラーが出るデータの隔離といった応急処置で、まず業務を回復させます。
恒久的な修正より先に、業務影響を最小化する判断が求められます。この暫定対応の引き出しの多さは、不具合対応の実力を測る一つの指標になります。
ただし、暫定対応はあくまで一時しのぎで、再起動で直ったからと放置すると、同じ不具合が繰り返し発生します。そのうえで、優れた不具合対応では、暫定対応を打った時点で「応急処置であり、恒久対応が別途必要」と記録し、後続の原因調査へつなげます。暫定と恒久の機能を切り分けて管理することが、その場しのぎの悪循環を断ち切る鍵になります。
原因調査と恒久対応の機能
暫定対応で業務を回復させた後に必要になるのは、根本原因を突き止める原因調査の機能と、それを修正する恒久対応の機能です。ここが不具合対応の本丸で、再発防止につながるかどうかの分かれ目になります。表面的な症状だけを潰して終わるか、原因まで根治するかで、その後の不具合の発生頻度は大きく変わります。
ログ解析・再現検証による原因特定の機能
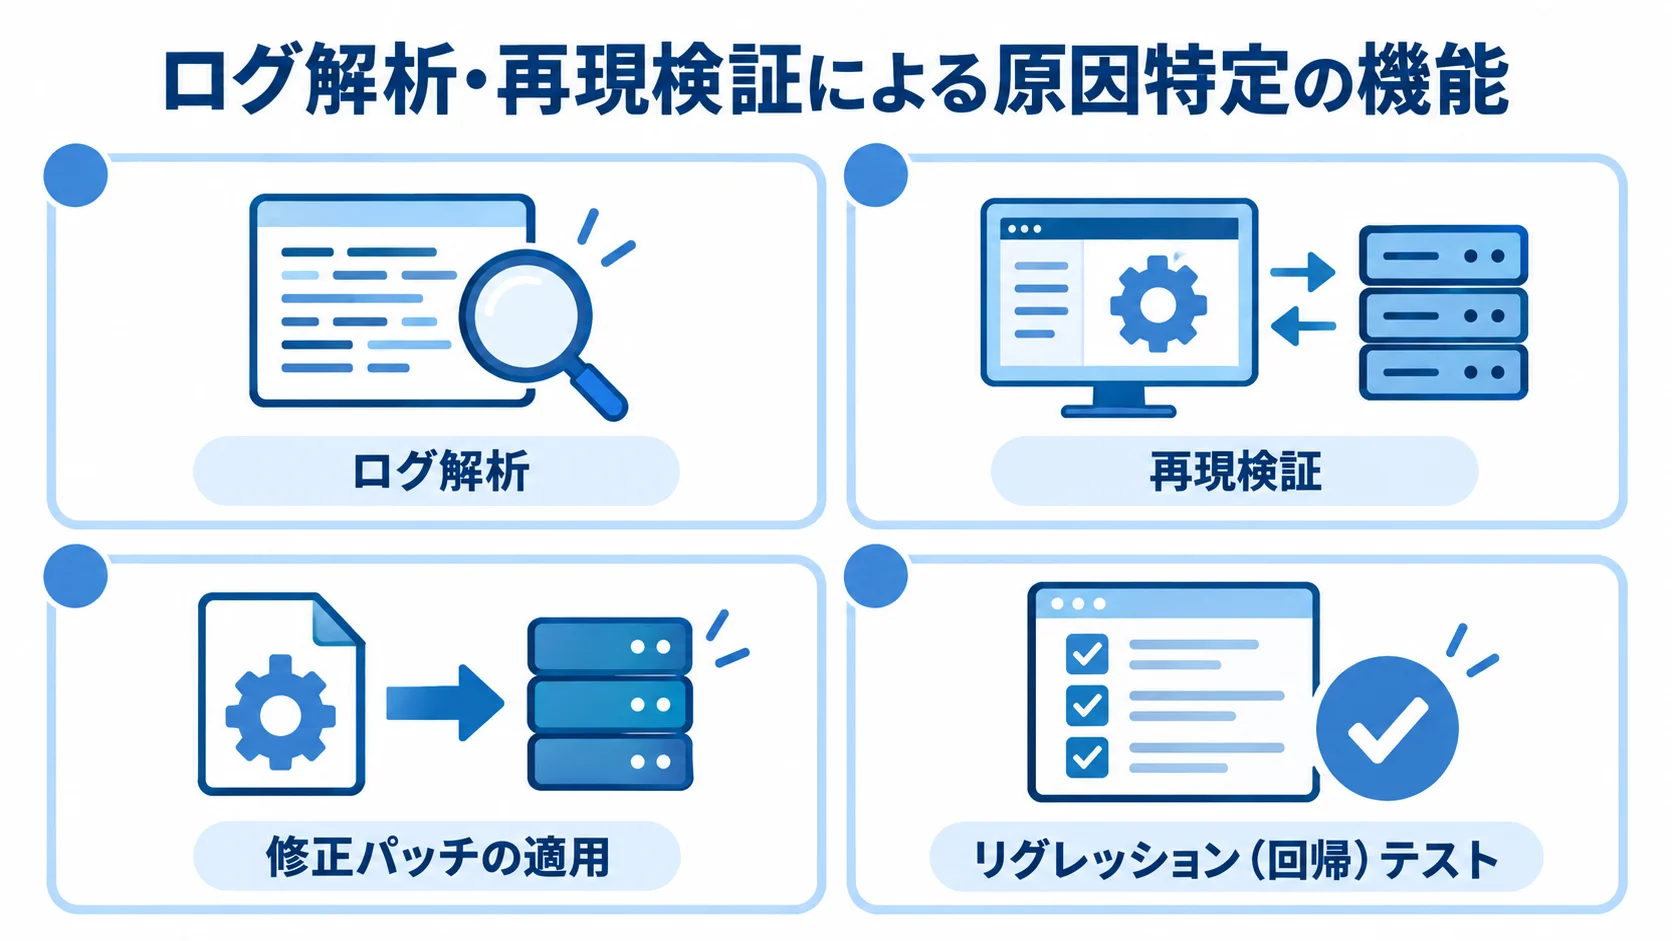
原因調査の中核は、ログ解析と再現検証です。不具合が起きた前後のアプリケーションログ・アクセスログ・エラーログをたどり、どの処理で異常が起きたかを突き止めます。さらに、開発環境で同じ条件を再現して原因を確定させます。
この再現検証ができるかどうかで、推測ではなく事実に基づく修正になるかが決まります。ログが適切に出力・保管されていない環境では原因特定が難航するため、不具合対応の機能は、ログ監視の機能と表裏一体といえます。また、原因調査の機能が弱いと、暫定対応の繰り返しで対応コストが膨らみ続けます。
原因特定を担うのは、システムの構造を理解した技術者です。とくにフルスクラッチで開発したシステムでは、ソースコードを読み解いて原因を追える開発元や、コードを引き継いだ保守ベンダーの関与が不可欠です。そこで、委託先を選ぶ際は、「原因をどこまで掘り下げて調査するか」「ソースコードレベルの調査が可能か」を確認して、根治力を見極めます。
修正パッチの適用とリグレッション確認の機能
原因が特定できたら、恒久対応として修正パッチを作成し、本番環境へ適用します。このとき欠かせないのが、修正によって他の機能が壊れていないかを確認するリグレッション(回帰)テストの機能です。たとえば、一箇所のバグを直したつもりが、別の機能に影響して新たな不具合を生む、といった二次災害は珍しくありません。
そのため、優れた不具合対応では、修正の影響範囲を見極め、テストで確認してから本番に反映します。恒久対応の機能を評価するときは、修正の適用プロセスがどう管理されているかも確認してください。また、誰がいつ何を修正し、どんなテストを経て本番に出したかを記録に残しておかないと、後から「いつの修正で何が変わったか」を追えなくなります。
恒久対応は、「直す機能」だけでなく「安全に直し、記録する機能」までを含めて評価すべきです。その一例として、riplaはフルスクラッチ受託と国内運用保守の立場から、原因調査から修正・テスト・反映までを一貫して担い、変更履歴を残しながら根治する進め方を重視しています。
報告と再発防止の機能
不具合対応は、システムが直ったところで終わりではありません。対応の経緯を関係者へ報告する機能と、同じ不具合を二度と起こさないための再発防止の機能まで含めて、初めて一連の対応が完結します。この最後の二つの機能が、不具合対応をその場しのぎから組織的な品質改善へ引き上げる要になります。
障害報告書とステークホルダー報告の機能
報告機能の中心は、対応完了後にまとめる障害報告書(インシデントレポート)です。障害報告書には、発生日時から再発防止策までの経緯を一枚にまとめ、経営層や業務部門、場合によっては取引先へ説明できる形で残します。とくに重大な不具合では、対応中のリアルタイム報告と、対応後の正式報告の両方が求められます。
たとえば、一次データの官公庁仕様でも、検知から1時間以内に内容と予想作業時間を報告する基準が示されており、報告は対応スピードと並ぶ評価軸です。重大不具合の最中に「今どうなっているのか」が分からないと、業務部門の不安が増幅し、現場への問い合わせが殺到して復旧作業の妨げになります。
報告機能を評価するときは、報告の頻度とフォーマットが定型化されているかを確認してください。また、初報・中間報告・最終報告のタイミングと様式が決まっているサービスは、不具合発生時の社内の混乱を構造的に抑えます。報告は技術機能とは言えないものの、不具合対応の信頼性を支える不可欠な機能です。
ナレッジ蓄積と再発防止策の機能
再発防止機能の核は、過去の不具合と対応のナレッジ化です。たとえば、発生した不具合とその原因・対応をデータベース化しておくと、同種の不具合が再び起きたときに、調査時間を大幅に短縮できます。ナレッジの蓄積は、対応のたびに組織が賢くなる仕組みです。
加えて、頻発する不具合のパターンが見えてくれば、根本原因となる設計やデータの問題に手を入れ、不具合の発生件数そのものを減らせます。再発防止の機能を高度化するのが、AIOpsのような自動検知・予兆検知の活用です。
一方で、一次データでは、JUASの調査としてAI活用は約78%が検討中・未検討で、多くはまだこれからの段階です。だからこそ、まずは人手によるナレッジ蓄積と再発防止策から始め、効果を見ながら自動化を段階的に取り入れるのが現実的です。不具合対応の機能は、受付から再発防止まで一連の流れとして設計されて初めて、対応コストの逓減という成果につながります。
まとめ
ITシステムの不具合対応が提供する機能は、受付・トリアージ、切り分けと暫定対応、原因調査と恒久対応、報告と再発防止という四つの機能群が連なって成立しています。受付では一次対応窓口と優先度判定が起点となり、切り分けではアプリ・インフラ・データの層を見極めて、業務を止めない暫定対応を打ちます。
原因調査ではログ解析と再現検証で根本原因を特定し、リグレッション確認を伴う恒久対応で根治します。そのうえで、障害報告書とナレッジ蓄積が、再発防止と対応コストの逓減を支えます。
「監視は別」「原因調査は別ベンダー」といった抜けがあると、いざというときに対応が分断されます。そのため、委託先の見積もりや契約書を読むときは、これらの機能のどこまでが標準で含まれ、どこから追加費用になるかを必ず確認してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、受付から原因調査・恒久対応・再発防止までを一貫した機能として提供し、分断のない不具合対応を支援します。また、全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。