
ITシステム不具合対応は、事象を切り分けて重要度と緊急度から優先順位を決め、復旧と再発防止までを続けていく取り組みです。限られた人員を適切に配分し、この取り組みを回し続けられる体制を整えることが、安定運用につながります。
全体は、切り分け、優先順位の判断、再発防止の三つで成り立っています。
- 切り分け:発生箇所と影響範囲を確認し、対応の前提をそろえる
- 優先順位:重要度と緊急度を基準に、限られた対応リソースを配分する
- 再発防止:復旧後に原因と経緯を記録し、手順や体制の見直しへつなげる
この順に考えると、目の前の復旧と長期的な運用改善を両立しやすくなります。
この記事は、運用担当者や情報システム部門、開発リーダーの方に向けた完全ガイドです。インシデントと障害の違いといった基礎から、トリアージ、検出者バイアスを排除した優先度決定、あえて対応しないバグを決めるビジネス視点までが対象です。各テーマの詳細は専用の記事にリンクしているので、必要な箇所を深掘りしながら読み進めてください。
業務システム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム不具合対応の全体像
ITシステム不具合対応とは、システムが本来期待された動作をしない状態を検知し、影響を最小化しながら正常な状態へ戻し、再発を防ぐ一連の活動を指します。
まず押さえておきたいのが、似た言葉の使い分けです。使い分けが曖昧なままだと、対応の優先順位や体制設計にぶれが生じます。
インシデント・障害・不具合の違い
「インシデント」はサービスが正常に稼働していない状態そのものを指し、「障害」はそのインシデントを引き起こしている原因となる事象を指します。たとえば「画面が表示されない」がインシデントで、「データベースの接続枠が枯渇していた」が障害です。また「不具合」は、仕様どおりに動かないシステム上の欠陥全般を指し、サービス停止を伴わない軽微なものも含みます。
この区別が重要なのは、対応の目的が異なるからです。インシデント管理は、いかに早くサービスを復旧させるかを最優先にします。一方で、問題管理(障害管理)は、なぜ起きたのかを突き止め、二度と起こさないようにすることを目的とします。
不具合対応の現場では、この二つを意識的に切り替えながら進めることが求められます。
切り分けとトリアージが対応の起点になる理由
不具合は次々と発生しますが、対応できる人員と時間は有限です。そこで欠かせないのが、事象を「どこで何が起きているか」に分解する切り分けと、「どれから手をつけるか」を決めるトリアージです。医療の現場で患者の重症度に応じて治療順を決めるのと同じように、不具合も影響度に応じて順序づけしなければ、軽微なものに時間を取られて致命的なものを見逃すリスクが高まります。
切り分けでは、ネットワーク・アプリケーション・データベース・外部連携サービスのどの層に問題があるのかを段階的に絞り込みます。再現性の有無、影響を受けるユーザーの範囲、特定の操作や時間帯との相関を確認すると、原因の見当をつけつつ影響範囲も把握できます。この初動の精度が、その後の対応スピードと品質を大きく左右します。
▶ 詳細はこちら:ITシステム不具合対応の進め方/やり方/流れや方法/手法/工程/手順対応の流れを確認できます。
ITシステム不具合対応の進め方
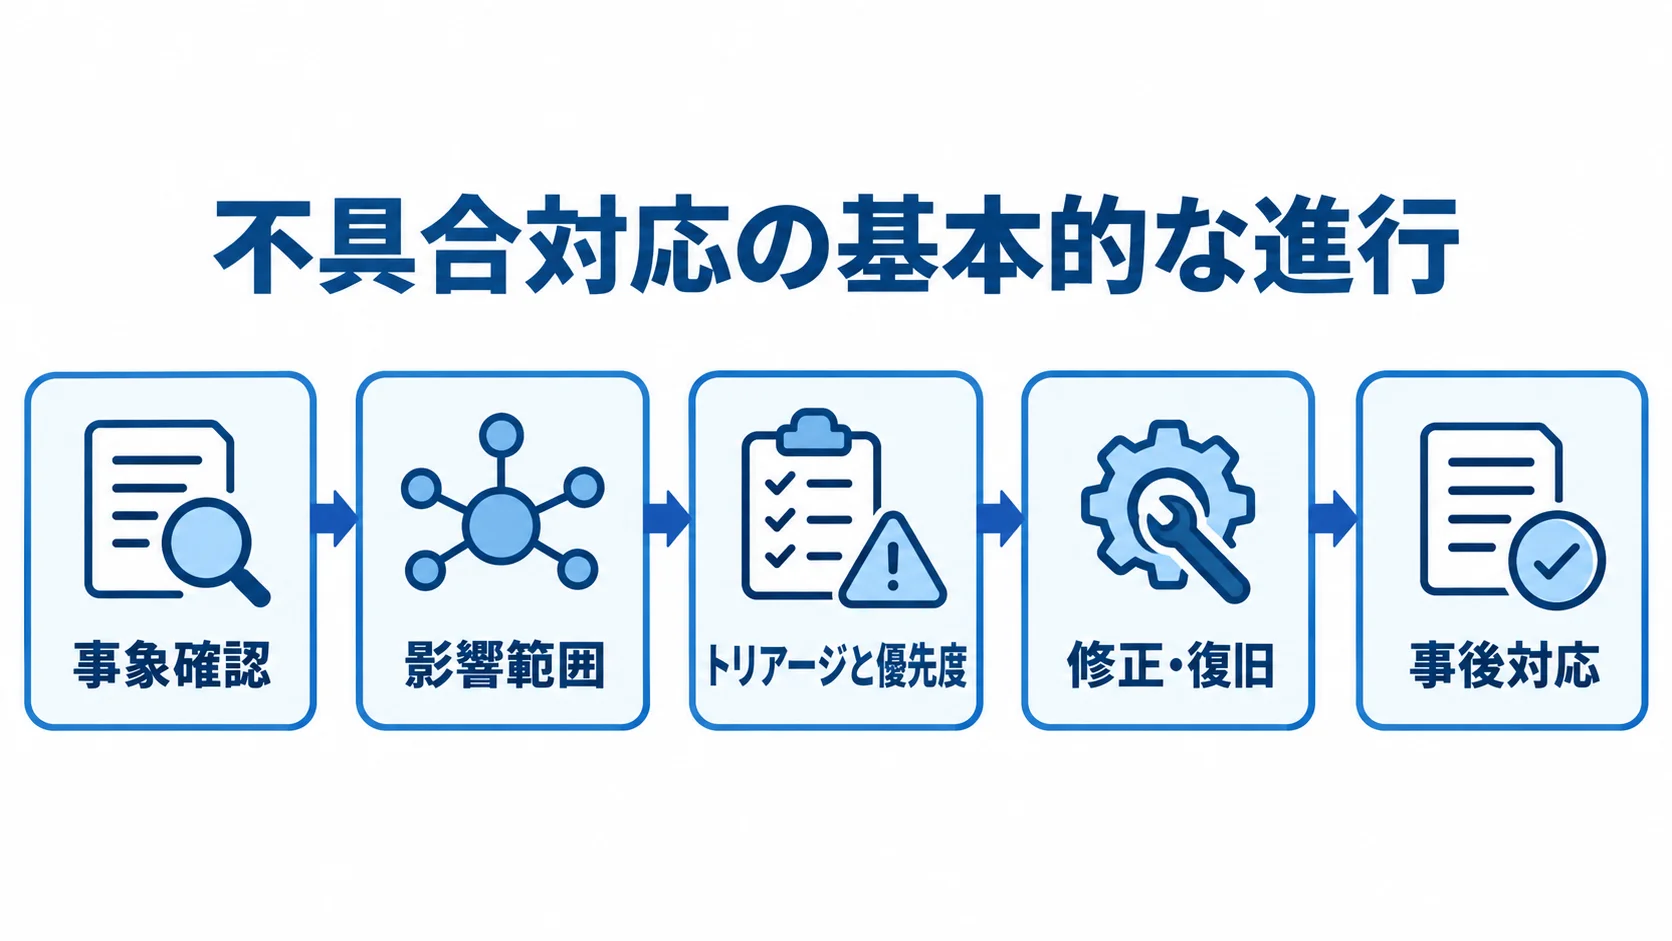
不具合対応は思いつきで動くのではなく、決まった流れに沿って進めることで、属人化を防ぎ再現性を高められます。
基本となるのは、事象を確認し、影響範囲を切り分け、トリアージと優先度を決め、修正・復旧へ進み、最後に事後対応を行う流れです。
事象確認から切り分けまでの初動
最初に行うのは、報告された事象が本当に起きているのかを確かめる事実確認です。ユーザーの操作環境特有の問題なのか、システム全体の不具合なのかを切り分けるため、再現手順・発生時刻・対象ユーザー・エラーメッセージといった情報を集めます。
この段階で曖昧な情報のまま対応を始めると、見当違いの調査に時間を浪費しがちです。続いて、ログやモニタリングダッシュボードを参照しながら、問題がどの層で発生しているかを絞り込みます。さらに、直近のリリースや設定変更との時間的な相関を確認すると、変更直後に起きた不具合は、その変更が原因である可能性が高いと判断できます。
修正・復旧と事後対応
原因の見当がついたら、まずはサービスを正常な状態に戻す暫定対応を優先します。緊急時に最初から根本対応にこだわると、復旧が遅れてユーザー影響が拡大してしまいます。そのため、設定の切り戻しや機能の一時停止などで影響を止め、その後に恒久的な修正へ進むのが基本です。
対応が一段落したら、必ず事後対応として記録を残します。発生から復旧までのタイムライン、原因、暫定対応と恒久対応の内容を不具合管理票にまとめ、再発防止につなげます。また、Critical級の事象では検知から15分以内の一次連絡と1時間以内の目標復旧、High級では30分以内のエスカレーションといったSLAの目安を設けておくと、初動の判断がぶれません。
▶ 詳細はこちら:ITシステム不具合対応の進め方/やり方/流れや方法/手法/工程/手順初動から復旧までの手順を整理するときに役立ちます。
不具合の優先順位付けと体制づくり
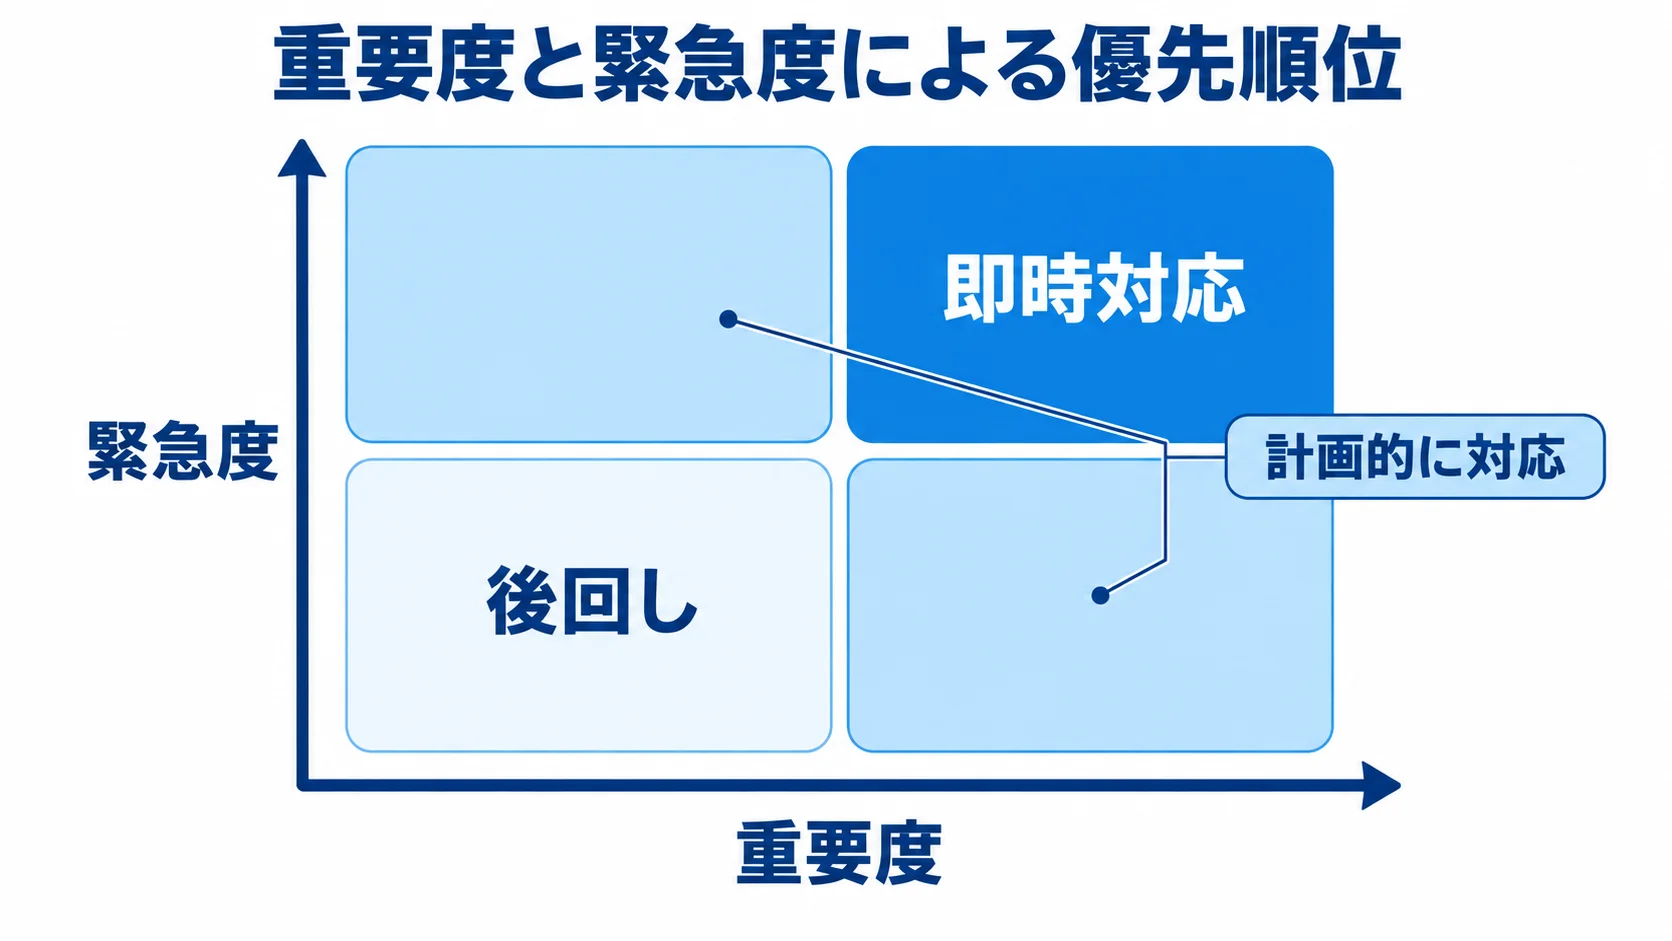
不具合対応の成否は、個々の技術力以上に「どの不具合から手をつけるか」をどう決めるかにかかっています。
優先順位を場当たり的に決めると、声の大きい人の依頼が先に通り、本当に重大なものが後回しになりかねません。
重要度×緊急度マトリクスと検出者バイアスの排除
優先度は、ビジネスやシステムへの影響度を示す「重要度」と、対応までに許される時間の余裕を示す「緊急度」の2つの観点で判断します。両方が高ければ即時対応、片方だけ高ければ計画的に対応、両方とも低ければ後回しと、マトリクス上で整理すると判断が明確になります。
この枠組みを共有しておけば、メンバー間で優先度の認識がそろいます。ただし、注意したいのが「検出者バイアス」です。不具合を見つけたテスト担当者やユーザーは、自分が報告したものを重大だと感じやすく、本人が単独で決めると判断が偏ります。
よくあるのが「とりあえず見てもらうため」に優先度を高く設定してしまう悪習です。優先度は、残課題やスケジュール全体を俯瞰できるPMやPOが、客観的な基準に基づいて決めるべきものです。
判定会議と縮退運転の体制設計
優先度の合意形成には、週1回程度の不具合判定会議が有効です。一方で、朝のスタンドアップでその場の解析不足のまま優先度を決めると、時間ロスや判断ミスにつながりがちです。判定会議でバグの発生件数の推移やゾーン分析を共有し、スケジュールと照らし合わせて合意することで、納得感のある優先順位づけができます。
緊急対応では、指揮官(インシデントコマンダー)と実務担当を分けるほか、連絡調整役と書記も置くのが理想です。ただし、中小企業やスタートアップでは人員が揃わないことも多く、その場合は縮退運転として役割を兼務します。たとえば2名なら、指揮と実務を担う「対応ライン」と、連絡と記録を担う「コミュニケーションライン」に完全分割し、作業者が外部連絡にリソースを奪われないようにします。
▶ 詳細はこちら:ITシステム不具合対応の進め方/やり方/流れや方法/手法/工程/手順優先順位づけと体制づくりの詳細を確認できます。
不具合対応を依頼する会社の選び方
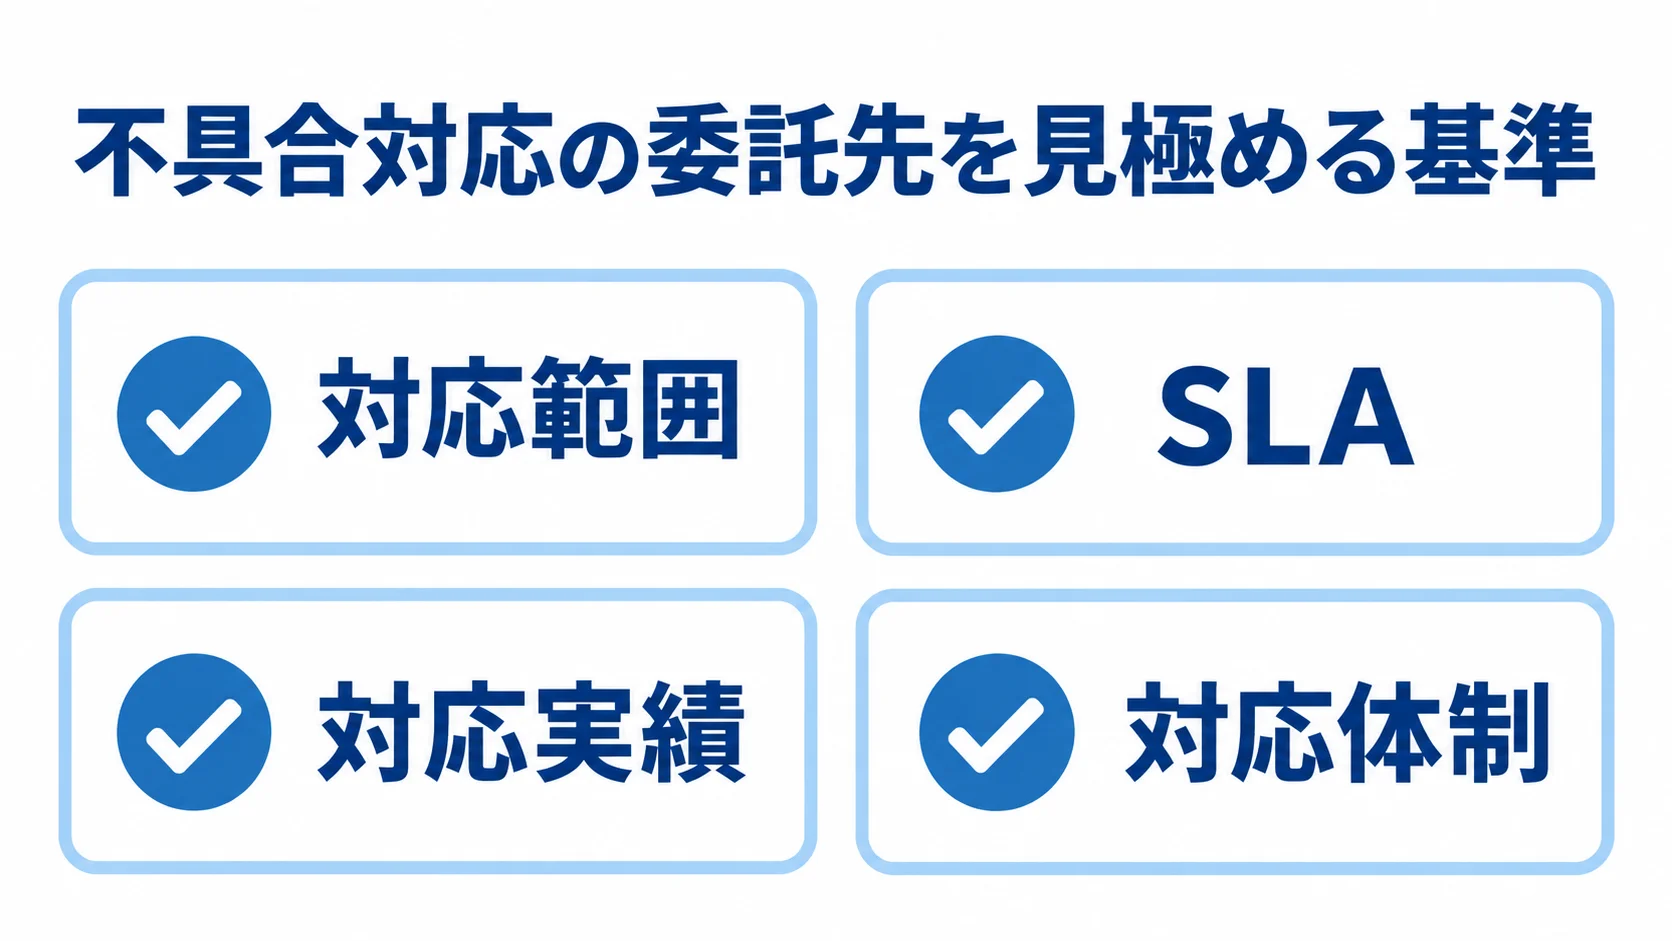
自社のリソースだけで24時間365日の監視や不具合対応をまかなうのは、多くの企業にとって現実的ではありません。
そこで運用代行やソフトウェアテストの外部委託を検討することになります。ただ、依頼先の選定を誤ると、かえって対応が滞ったり費用がかさんだりします。
依頼先を選ぶ際は、会社名ではなく、見極めるべき基準を押さえておくことが大切です。
対応範囲とSLAの確認ポイント
まず確認すべきは、依頼先がどこまでの範囲を担うのかという点です。監視やアラート検知だけなのか、一次対応や復旧作業まで含むのか、さらに根本原因の調査や恒久対策の提案まで踏み込むのかで、サービスの性質は大きく変わります。
自社で対応できる部分とできない部分を明確にし、その不足分を補ってくれる相手を選ぶことが重要です。次に、SLA(サービス品質保証)の内容を精査します。
検知から連絡までの時間、目標復旧時間、対応可能な時間帯がどう定義されているか、達成できなかった場合のペナルティや報告義務がどうなっているかを確認します。曖昧なSLAは、いざというときに「対応の遅れ」をめぐって揉める原因になります。
実績と対応体制の評価
同種のシステムや業界での対応実績があるかどうかは、信頼性を測る大きな手がかりです。自社が使っている技術スタックやクラウド環境に精通しているか、過去にどのような不具合をどう解決したのかといった具体的な事例を確認しましょう。
実績の裏付けがある相手は、初動の精度や原因特定のスピードに差が出ます。また、対応体制とコミュニケーションの質も、窓口がひとつに決まっているか、緊急時のエスカレーション経路が明確か、報告書の品質が高いかで見極めます。特に外部委託では、提出される障害報告書(RCA)の内容を自社で評価し、不十分なら差し戻せる関係性を築けるかどうかが、長期的なベンダーコントロールを左右します。
▶ 詳細はこちら:ITシステム不具合対応でおすすめの開発会社/ベンダー6選と選び方委託先選びの基準を確認できます。
ITシステム不具合対応の費用相場
不具合対応を外部に委託する際の費用は、対応範囲・監視時間帯・システムの規模によって大きく変動します。
一律の相場を示すのは難しいものの、費用がどの要素で決まるかを理解しておくと、見積もりの妥当性を判断しやすくなります。
規模別の費用目安
小規模なシステムで、平日日中のみの監視と軽微な不具合対応であれば、月額数万円から十数万円程度に収まることが一般的です。一方で、24時間365日の有人監視や、複数システムの横断的な対応、緊急時の即時駆けつけまで含めると、月額数十万円以上になることも珍しくありません。対応の手厚さと費用は比例するため、自社に必要な水準を見極めることが重要です。
スポットでの不具合修正やバグ調査を都度依頼する場合は、エンジニアの稼働時間に応じた人月・人日単価で算出されることが多いです。原因調査が難航するほど工数がかさむため、事前に調査範囲や上限工数を取り決めておくと、想定外の費用増を防げます。
費用を左右する主な要因
費用を大きく左右するのは、監視時間帯とSLAの厳しさです。夜間・休日を含む24時間対応や、短い目標復旧時間を求めるほど、待機要員の確保が必要になり費用は上がります。そのため、求める復旧スピードと予算のバランスを取ることが、費用を適切な水準に抑えるための出発点です。
このほか、対象システムの数や複雑さ、ドキュメントの整備状況も費用に影響します。構成図やマニュアルが整っていれば、委託先の立ち上がりが早く工数を抑えられますが、情報が不足していると調査に余計な時間がかかります。事前に資料を整えておくことが、結果的にコスト削減につながります。
▶ 詳細はこちら:ITシステム不具合対応の見積相場や費用/コスト/値段について費用の見積もり方を確認できます。
不具合対応の発注・外注方法
不具合対応を外注する際は、業務を丸投げせず、自社が主導権を握りながら委託先を活用する姿勢が欠かせません。発注前の準備と委託形態の選択が、その後の対応品質を大きく左右します。
委託形態の種類と特徴
外注の形態には、月額固定で一定範囲の対応を任せる運用保守契約、稼働時間に応じて費用を支払う準委任契約、成果物を定義して発注する請負契約などがあります。
継続的な監視や不確実性の高い不具合対応では準委任が向き、明確に切り出せるバグ修正では請負が適するなど、業務の性質に応じて使い分けます。
契約形態によって、指揮命令の可否や成果物の責任範囲が変わります。そのため、自社が求める関わり方と合っているかを確かめる必要があります。曖昧なまま契約すると、対応漏れや責任の押し付け合いが起きかねません。
発注前に準備すべきドキュメント
委託をスムーズに進めるには、システム構成図や資産一覧、既知の不具合リストを前もって整えておく必要があります。過去の障害報告書もそろっていれば、委託先は短期間でシステムを把握でき、初動の精度が高まります。
また、どのレベルの事象を、どの連絡先へ、どのタイミングで報告するかというエスカレーションルールも事前に取り決めておきます。委託後の運用がうまくいくかどうかは、こうした準備の徹底度に大きく依存します。準備を怠ると、せっかく外注しても自社側の負担がかえって増えてしまいます。
▶ 詳細はこちら:ITシステム不具合対応の発注/外注/依頼/委託方法について発注前の準備と契約の考え方を確認できます。
不具合対応で失敗しないためのポイント
不具合対応の仕組みを整えても、運用の中でつまずくポイントは少なくありません。よくある失敗を事前に知っておくことで、同じ過ちを避けられます。
特に陥りやすいのは、すべてを直そうとする姿勢と、特定の人に頼る体制です。
「対応しないバグ」を決めるビジネス視点
すべての不具合を直そうとすると、リソースが分散し、本当に重要なものへの対応が薄くなります。そこで、「あえて対応しないバグ」を決めることも、戦略的な判断のひとつになります。
たとえば、発生頻度が極めて低く影響も軽微なバグや、修正コストがリスクを上回るケースでは、対応を見送る方が合理的な場合があります。また、ソーシャルゲームなどでは、ユーザーが得をする方向の不具合をあえて修正せず、運用とユーザー双方の利益になるよう判断する例もあります。
これはシステム運用の枠を超えたビジネス判断であり、技術者だけでなく事業責任者を交えて決めるべき領域です。「直すこと」自体が目的化していないかを、常に問い直す姿勢が求められます。
属人化と非難なき文化への対処
不具合対応が特定の人に依存すると、その人が不在のときに対応が止まり、本人にも過度な負担が偏ります。対応の流れの一覧化、マニュアル整備、複数メンバーでの役割共有を進めて、属人化を解消していくことが大切です。オンコール負担を定量化し、交代枠やインセンティブを見直す組織設計も有効です。
再発防止の場面では、個人のミスを責めるのではなく、ミスを誘発した仕組みの欠陥に焦点を当てる「非難なき文化」が欠かせません。「なぜミスをしたのか」と問い詰めず、「どのようにしてその状況が生まれたのか」と問いを変えると、犯人探しを避けながら本質的な改善点を引き出せます。心理的安全性が確保された環境でこそ、再発防止策は実効性を持ちます。
▶ 詳細はこちら:ITシステム不具合対応でおすすめの開発会社/ベンダー6選と選び方失敗を防ぐための選び方を確認できます。
まとめ
ITシステム不具合対応の要は、発生した事象を正しく切り分け、重要度と緊急度のマトリクスでトリアージし、限られたリソースを最も効果の高いところに振り向けることにあります。
検出者バイアスを排除し、PMやPOが客観的な基準で優先度を決め、週1回程度の判定会議で合意形成する仕組みを整えることで、属人化を防ぎながら対応品質を高められます。
自社だけで抱え込まず、運用代行やテスト委託を適切に活用し、SLAと対応範囲を明確にしてベンダーをコントロールすることも重要です。
また、「すべてを直す」発想から離れ、ビジネス視点で「対応しないバグ」を見極める判断を持つことが大切です。非難なき文化による再発防止の仕組みづくりまで踏み込むことで、不具合対応は場当たりの対応から、事業を支える継続的な仕組みへと進化します。
各テーマの詳細は、進め方・会社選び・費用・発注方法の各記事で深掘りしていますので、あわせてご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。