
ITシステムの不具合対応で起きがちな失敗は、対応範囲の確認不足、丸投げによる発注側の初動の崩壊、SLAの過剰・過少、クラウド化による監視のブラックボックス化の四つです。
他社のつまずきを知っておくことは、同じ失敗を避ける備えになります。全体像をまだ把握していない方は、まずITシステム不具合対応の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム不具合対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
安すぎる見積もりに潜む対応範囲の罠
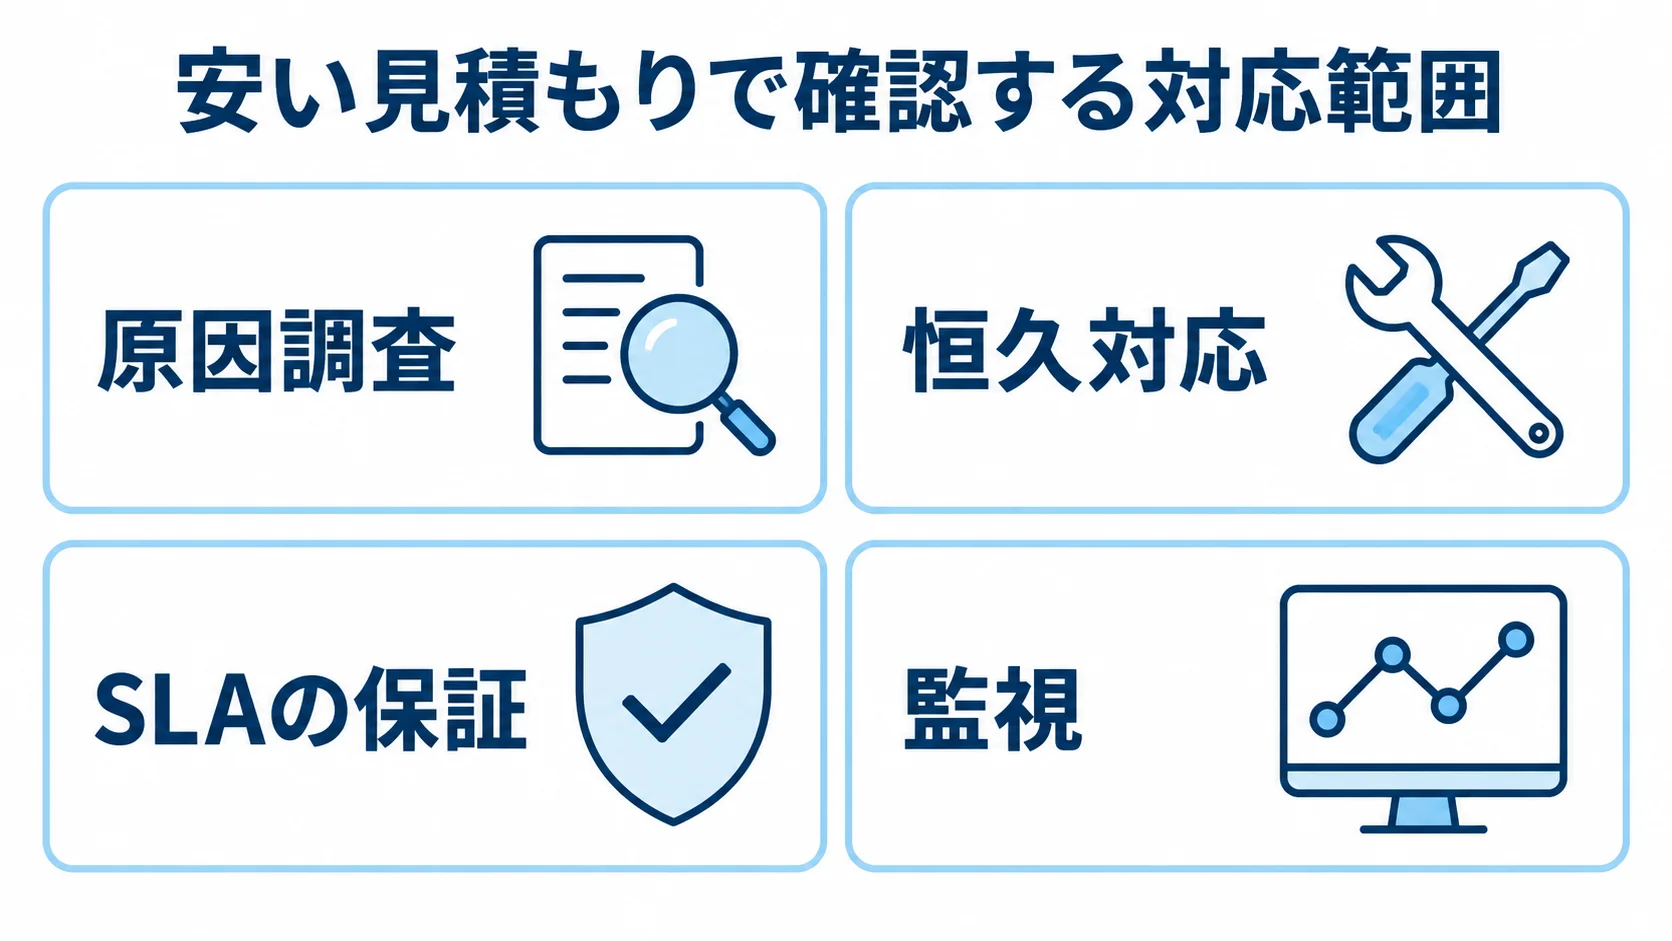
不具合対応の委託で最も多い失敗は、月額の安さだけで委託先を選んでしまうことです。安い見積もりには、たいてい理由があります。
その理由は、対応範囲が極端に狭い、SLAの保証がないといった引き算に表れることがあります。原因調査が含まれない、工数の上限が低いといった点も、金額だけでは気づきにくいものです。こうした「見えない引き算」を見抜けないまま契約すると、いざというときに対応してもらえず、結局は別の費用が積み上がります。
一次受付だけで原因調査が範囲外だった失敗
典型的な失敗は、契約した不具合対応が「一次受付と再起動でしのぐ暫定対応」までで、根本原因の調査と恒久対応は範囲外だったというケースです。
同じ不具合が再発しても暫定対応を繰り返すだけで、原因には手が入りません。その結果、毎月のように同じトラブルに悩まされ、暫定対応のたびにスポット費用がかさみます。
一次データでも、原因調査やバグ修正はスポット1件3万〜10万円といった水準で別精算になることが多く、安い月額の裏で追加費用が積み上がります。
この失敗を避けるには、見積もりを取る段階で、原因調査と恒久対応まで含むかを明確に確認しておく必要があります。
特に、自社開発したシステムでは、ソースコードを読み解いて原因を追える体制があるかが決め手になります。一次受付しかしない委託先と、原因調査ができる開発元が分かれていると、不具合が宙に浮きます。
安さに飛びつく前に、「この月額で、再発を止めるところまでやってくれるのか」を必ず問い直してください。総額と根治力で比べる習慣があれば、この罠を避けられます。
見積もりを比べるときは、原因調査の扱いを中心に見ると、対応範囲の違いが見えやすくなります。
- 原因調査と恒久対応:月額に含まれるか、スポット精算になるか
- 開発元との連携:一次受付の窓口と、原因調査を担う開発元が同じ体制か
SLAも監視もない見積もりの危うさ
安すぎる見積もりのもう一つの落とし穴は、SLA(対応時間の保証)も監視も付いていないことです。SLAがなければ、不具合を連絡しても「いつ対応するか分からない」状態に置かれます。
監視がなければ、不具合に気づくのは利用者からのクレームになり、対応が後手に回ります。安い委託先は、即応性を支える仕組みを省くことで価格を下げているケースが少なくありません。
SLAと監視がないことのリスクは、ダウンタイムの損失で考えると深刻です。一次データでは、総務省の2025年版資料として、金融・医療・EC系で5分以上停止1回あたり平均1,200万円の機会損失が示されています。
月数万円を惜しんで監視もSLAもない契約を選び、たった1回の重大停止で1,200万円を失えば、安さは何の意味も持ちません。
見積もりを比べるときは、価格の裏にSLAと監視という安全装置が備わっているかを確認してください。安さの正体は、たいてい安全装置の欠如です。
SLAと監視は、見積もりの中身を見るときに欠かせない項目です。
- SLA:不具合への対応時間が、契約の中で決められているか
- 監視:不具合の発生を、自社側で早く検知できる仕組みがあるか
ベンダー丸投げで発注側の初動が崩壊するリスク
見落とされがちな失敗は、「委託したのだから対応はベンダー任せでよい」という丸投げの姿勢です。
不具合対応の技術的な復旧は委託先が担えても、業務影響の判断や経営層への報告、業務部門との調整は発注者にしかできません。この発注側の初動が崩れると、システムが直っても社内は大混乱に陥ります。
委託は責任の移転ではなく役割の分担であり、発注側に残る役割があることを、最初に認識しておく必要があります。
経営層への報告遅延で信頼を失う失敗
丸投げが招く深刻な失敗は、経営層や業務部門への報告が遅れることです。不具合が起きたとき、経営層が知りたいのは「事業への影響はどの程度か」「いつ復旧するのか」です。
発注者がこの状況把握と報告を怠ると、経営層は事態を把握できず、対外的な説明も後手に回ります。さらに、委託先が技術的な復旧を進めていても、社内に情報が伝わらなければ、組織としては「何も対応していない」ように見えてしまいます。
この失敗を避けるには、発注者側が報告の流れを事前に決めておくことが欠かせません。一次データの官公庁仕様でも、検知から1時間以内に内容と予想作業時間を報告する基準が示されています。
これを参考に、自社でも「重大不具合が起きたら、初報を何分以内に経営層へ」「中間報告は何時間ごとに」と決めておきます。
委託先からの技術報告を、発注者が経営層向けに言い換えて伝える役割を担うことで、報告の遅れによる信頼の失墜を防げます。報告は委託できない、発注者の責務です。
報告の遅れを防ぐには、発注側が担う報告の中身を分けて考えるとよいでしょう。
- 経営層への報告:事業への影響と復旧の見通しを、技術的な言葉を使わずに伝える
- 業務部門との連絡:止まった業務の代替手段や現場への周知を、誰が担うか
BCP不在で重大障害時に組織が動けない失敗
丸投げのもう一つのリスクは、事業継続計画(BCP)と連動した初動が用意されていないことです。システムが長時間止まったときは、業務をどう代替で回すか、顧客にどう告知するか、いつ事業を止める判断をするかを決めておく必要があります。
これらは経営判断であり、発注者が事前に決めておくべきものです。BCPが不在のまま重大障害に直面すると、復旧を待つ間に組織が何も動けず、損失が拡大します。
BCPと連動した初動を整えるには、不具合対応を技術の話だけでなく事業継続の話として捉える視点が必要です。重大障害の想定シナリオを作り、各部門の役割と代替手段、エスカレーションの判断基準を決めておきます。
委託先の復旧作業と、発注者側のBCP発動を並行して進められる体制があれば、停止時間中の損失を最小化できます。
riplaは、フルスクラッチ受託と国内運用保守の立場から、技術的な復旧支援だけでなく、発注者側の初動設計やBCP連動の整理にも踏み込むことを重視しています。
丸投げを脱し、発注者と委託先が役割を分担して初めて、不具合対応は機能します。
BCPとの連動を確かめるときは、委託先と社内のそれぞれが何を受け持つかを見ておくとよいでしょう。
- 委託先の復旧作業:どの範囲までを委託先が受け持つか
- 発注側のBCP発動:代替業務や告知、事業停止の判断を、いつ誰が行うか
過剰・過少なSLAの落とし穴
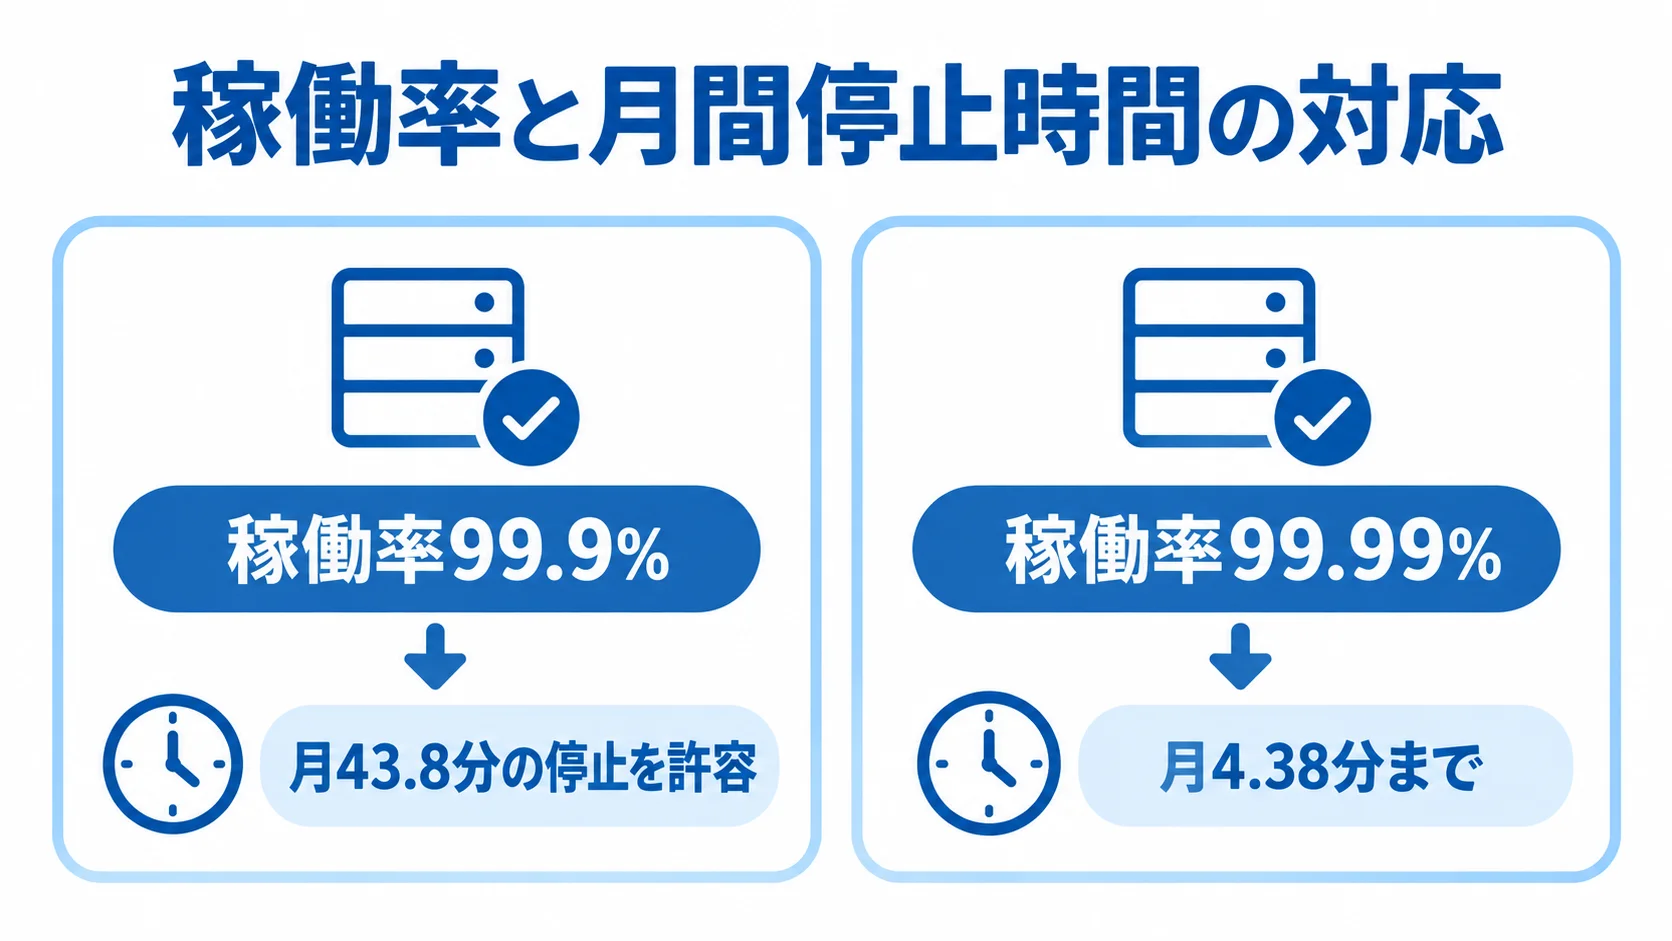
SLA(サービスレベル合意)の設定ミスも、よくある失敗です。過剰なSLAは無駄な費用を生み、過少なSLAは肝心なときに業務を止めてしまいます。
さらに、SLAの中身を理解せずに契約すると、未達でも補償されないことや、損失が補填されないことに、いざというとき直面します。SLAは数字だけ決めても安心とは言えず、中身まで吟味すべき領域です。
過剰SLAで費用が膨らむ失敗とその適正化
過剰SLAの典型は、業務時間外に止まっても影響がないシステムに、稼働率99.99%や24時間即応を求めてしまうケースです。
一次データでは、稼働率99.9%は月43.8分の停止を許容し、99.99%は月4.38分まで絞ります。この差を実現するには冗長構成や即応体制が必要で、費用は段階的に跳ね上がります。
本当は99.9%で十分なシステムに99.99%を求めれば、その分の費用は丸ごと無駄になります。
過剰SLAの適正化が難しいのは、技術の問題より社内調整の問題だからです。ビジネス部門は「絶対に止めるな」と要求しがちで、情報システム部門がSLAを下げる提案をしても通りにくいことが多いのです。
ここで役立つのは、事業への影響の大きさを測ることです。「このシステムが○分止まると、いくらの損失が出るか」を部門ごとに示し、過剰なSLAにかかる追加費用と比べます。
この数字を根拠にビジネス部門を説得すれば、過剰SLAを適正水準へ緩和できます。SLAの適正化は、コスト削減の大きな打ち手です。
見直しでは、業務の側から必要な条件を整理すると進めやすくなります。
- 停止の許容時間:月に何分までの停止を、業務が許せるか
- 即応体制の要否:24時間の対応が、業務に本当に必要か
SLA未達でも損失が補填されない現実
SLAをめぐる誤解の一つが、「SLAを結べば、未達のときに損失を補填してもらえる」という期待です。ところが、多くのSLAは努力目標型で、未達でもペナルティはありません。
保証型であっても、補償はサービスクレジット(当月料金の一部減額)にとどまるのが一般的です。一次データでも、損害賠償には上限が設けられ、間接損害は免責とされます。そのため、SLA未達による事業損失そのものが補填されることは、ほぼありません。
この現実を踏まえると、SLAは「損失補填の保険」ではなく「対応水準の約束」として捉えるべきです。
リスクヘッジの基本は、SLAだけに頼らず、バックアップやBCPといった備えを自社側でも用意しておくことです。
SLAの中身を理解せず過度に期待することが、いざというときの失望につながる失敗です。
契約時に見ておきたいのは、SLAの種類と補償の中身です。
- SLAの型:保証型か努力目標型か
- 未達時の扱い:補償の形、損害賠償の上限、免責の範囲
クラウド・SaaS化による監視のブラックボックス化リスク
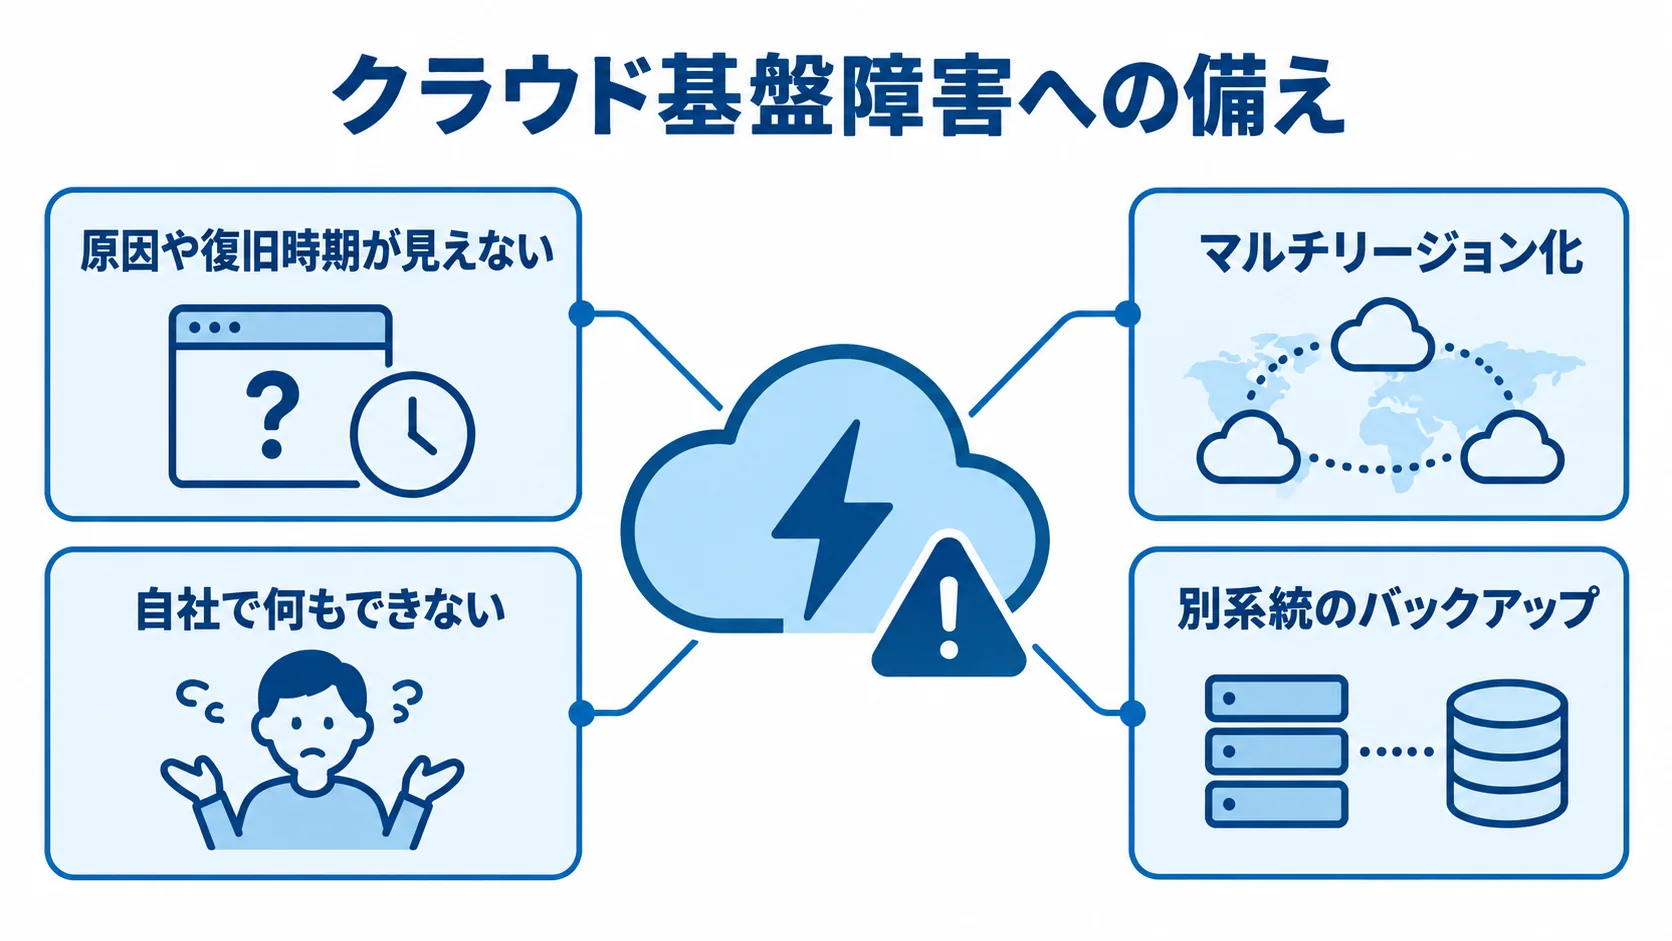
近年特有のリスクが、クラウドやSaaSへの移行に伴う「監視のブラックボックス化」です。一次データでは、国内エンタープライズ・システム市場のクラウド比率は2022年で約5割に達しています。
クラウド基盤の障害は利用者側では手出しができず、原因も復旧時期も見えません。自社のシステムなら直せた不具合が、クラウドでは「ベンダーの復旧を待つしかない」状態になります。
クラウド基盤障害は手出しできず補償も限定的
クラウド基盤障害の最大のリスクは、自社で何もできないことです。基盤側で大規模障害が起きると、自社の不具合対応がどれだけ優れていても、復旧はクラウド事業者次第になります。
しかも、補償はサービスクレジットにとどまり、停止による事業損失は補填されません。
海外調査ではダウンタイム1分あたり約5,600米ドルという試算もあり、長時間の基盤障害は莫大な損失につながります。その大半は自社が被ることになります。
この無力さを放置するのが、クラウド移行で陥りがちな失敗です。「クラウドにすれば運用が楽になる」と考えて基盤障害への備えを怠ると、大規模障害が起きたとき打つ手がありません。
クラウド化は、運用の一部をベンダーに委ねる代わりに、自社で制御できない領域が増えるトレードオフだと理解する必要があります。
クラウドの利便性の裏には、監視と制御のブラックボックス化という構造的なリスクが潜んでいます。
基盤障害への備えを確かめるには、情報と対策の両面を見ておくことが欠かせません。
- 障害時の情報:原因や復旧時期を、ベンダーからどの程度受け取れるか
- 自社で打てる手:基盤側の障害に対して、自社側で取れる対策の範囲
マルチリージョン化など自衛アーキによる備え
ブラックボックス化のリスクに対する自衛策は、アーキテクチャ設計で備えることです。
複数のリージョンやアベイラビリティゾーンにシステムを分散させるマルチリージョン化や、重要なデータの別系統でのバックアップを設計に組み込んでおくと、一つの基盤障害で全停止する事態を避けられます。
クラウドの障害は防げなくても、その影響は自社の設計で緩和できます。
ただし、こうした備えには相応の費用と手間がかかります。すべてのシステムに冗長構成を組むのは過剰で、事業を止められない重要システムに絞って投資するのが現実的です。
判断の基準は、ここでも事業影響度です。停止が許されないシステムだけを自衛アーキで守り、止まっても困らないものは割り切ります。
riplaは、フルスクラッチ受託と国内運用保守の立場から、クラウドの責任共有モデルを前提に、どこまで自衛し、どこを割り切るかの設計判断を一緒に整理することを重視しています。
クラウド時代の不具合対応は、防げない障害を前提に、自社の設計で備える発想が欠かせません。
自衛アーキを検討するときは、各システムが止まったときの影響を比べておくと判断しやすくなります。
- 設計・構築コスト:冗長構成や別系統のバックアップに必要な費用と手間
- 停止の影響:止まったとき、事業にどの程度の打撃が及ぶか
まとめ
ITシステム不具合対応の失敗は、安すぎる見積もりの罠、ベンダー丸投げによる初動の崩壊、過剰・過少なSLA、クラウド化による監視のブラックボックス化という四つのパターンに集約されます。
安い見積もりには原因調査やSLA・監視の欠如が潜み、たった1回の重大停止で1,200万円を失えば、安さはすぐ帳消しになります。丸投げは経営層への報告遅延とBCP不在を招き、技術的に直っても組織が崩れてしまいます。
SLAは過剰なら無駄、過少なら危険で、未達でも損失は補填されません。クラウド基盤障害は手出しできず、自衛アーキで影響を緩和するしかありません。
失敗に共通する教訓は、「不具合対応は委託先に丸投げできず、対応範囲・SLA・報告・事業継続まで発注者が主体的に設計すべき」という原則です。
安さや安心という言葉に流されず、総額と根治力、報告フロー、事業影響度から逆算して備えることで、致命的な失敗を避けられます。riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、開発と運用を分断せず一体で支えることを重視しています。
また、原因調査から報告設計・自衛アーキまで一貫して伴走することで、これらのリスクを構造的に回避する支援を行っています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。