
ITシステムの障害で担当者をもっとも悩ませるのは、何が原因かを突き止める原因調査です。サービスが止まっている最中に、ログをたどり、再現条件を探る作業が重なるからです。調査の巧拙が復旧時間を左右するため、同じ障害を乗り越えた企業の事例は運用改善のヒントになります。
この記事は、ITシステムの原因調査に関する導入事例・開発事例・活用事例・成功事例を、発注企業(情報システム部門)の視点から掘り下げる「事例特化」の解説です。その際、費用相場・SLA実値・損失統計もあわせて見ていきます。全体像はITシステム原因調査の完全ガイドで確認できます。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
夜間障害の原因調査を立て直した事例
原因調査の事例で、もっとも切実なのが夜間障害です。深夜や早朝にシステムが止まり、限られた人手で原因を突き止めなければなりません。
担当者が一人で対応する場合、ログを追う作業、経営層への報告、復旧の試みが同時に押し寄せ、冷静な切り分けが難しくなります。そのため、この火消しの進め方をどう立て直すかで、原因調査の成否が分かれます。
復旧目標を決めずに調査が長時間化していたBefore
立て直し前の典型的な状態は、復旧目標時間を決めないまま、根本原因だけを探し続けてしまう調査です。原因が分からないまま時間が過ぎ、停止が長引きます。
総務省の2025年版資料では、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失が生じるとされています。また、Gartnerの2024年調査でも、ダウンタイムは1分あたり5,600米ドルの損失と試算されています。原因究明を優先するあまり復旧が後回しになると、この損失は膨らみ続けてしまいます。
この企業では、夜間のデータベース応答遅延に対し、根本原因の特定にこだわるあまり、縮退運転で先に止血する判断が遅れていました。結果として、数十分で暫定復旧できたはずの障害が、数時間にわたってサービス全体を巻き込みました。原因調査と復旧は別の作業ですが、止血してから原因を追う順序は確立されていませんでした。
立て直し前の課題は、次の2点です。
- 復旧目標の不在:目標時間がないため、原因が分かるまで復旧の区切りが決まりませんでした。
- 止血の後回し:縮退運転で先に止める判断が、原因の特定に押されて遅れた点です。
初動の役割分担と暫定復旧でMTTRを短縮したAfter
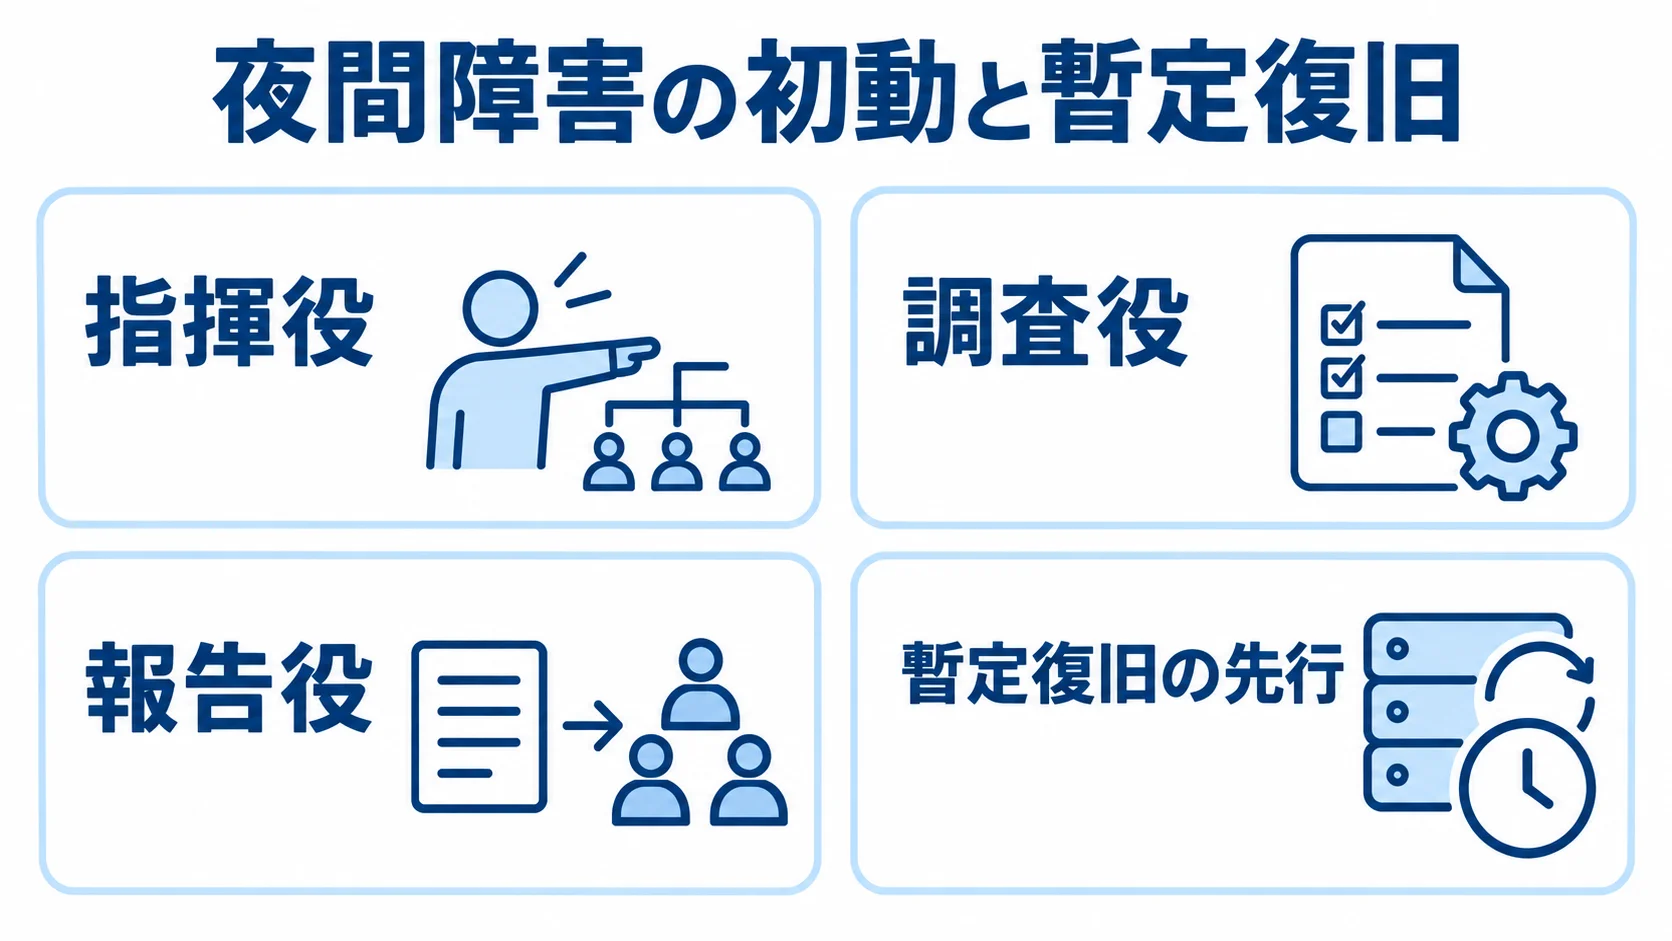
立て直しでは、まず初動の役割を「指揮役」「調査役」「報告役」に分け、一人がすべてを抱えない体制を整えました。指揮役が復旧目標時間を宣言し、調査役がログから原因の当たりをつけ、報告役が経営層と業務部門への状況連絡を担います。
この役割分担によって、調査に没頭しながら報告に追われるという負荷が分散されました。官公庁の仕様例にも「1時間以内に内容と予想作業時間を報告」「原則4時間以内に完全復旧」といった時間軸が定められています。また、初報と復旧目標を分けて管理する考え方は、実務でも一般的です。
さらに、原因が完全に判明する前でも、サーバーの再起動や縮退運転といった暫定復旧を先行させるルールを定めました。根本原因の特定は復旧後に落ち着いて行い、その間もサービスは動かし続けるという発想です。
この立て直しによって、平均復旧時間(MTTR)が大幅に短縮され、夜間障害でも一定時間内に止血できる体制が定着しました。原因調査を「止めずに行う」設計が、損失を最小化する鍵になったのです。
立て直しで取り入れた点は、次の2点です。
- 役割の分離:指揮、調査、報告を別の役割にして、一人に負荷が集まらない体制にしました。
- 暫定復旧の先行:再起動や縮退運転で先に止め、根本原因は復旧後に落ち着いて追う順序にしました。
ひとり情シスが原因調査を委託した事例
中小企業に多いのが、情報システム担当が一人しかいない「ひとり情シス」体制です。この体制では、原因調査のノウハウがその一人に集中します。
そのため、担当者が不在のときに障害が起きると、誰も原因を追えないという属人化リスクが常に付きまといます。この事例の主題は、その属人化を外部委託によってどう解消したかです。
監視と原因調査を月額で外部に委ねたコスト設計
この企業では、24時間365日の死活監視と一次的な原因調査を外部に委ねることで、担当者一人の負担を軽減しました。
費用の目安は、運用・監視(死活・リソース監視)が月5万〜20万円、障害対応は営業時間内なら月3万〜8万円です。24時間の緊急対応を含めると、月10万〜20万円が相場になります。スポットでの障害対応なら1件3万〜10万円という料金体系もあり、自社の障害頻度に応じて固定費と変動費を組み合わせられます。
具体的なサービス例では、監視のみが1台あたり月5,000円、障害対応込みが1台あたり月10,000円です。フルマネージドは1台あたり月20,000円と、段階的に料金が設定されています。
ひとり情シスにとって大切なのは、自社の規模に合わせて、どこまでを外部に任せ、どこから自社で見るかを切り分けることです。原因調査という難度の高い作業を月額の範囲に組み込めれば、担当者が休んでいる間も調査が止まらず、安心感が得られます。
この企業が外部に委ねた範囲は、次の2つです。
- 24時間365日の死活監視:システムの稼働状態を、夜間や休日も含めて外部が見守る形です。
- 一次的な原因調査:担当者が休んでいる間も、調査の一次対応が止まらない形にしました。
調査手順の文書化で属人化を解消した効果
外部委託の副次的な効果として大きかったのが、原因調査の手順が文書化されたことです。委託先と作業範囲を取り決める過程で、調査フローそのものが言語化されました。
これまで担当者の頭の中だけにあった暗黙知が、誰でも追える手順書として残りました。その結果、担当者が異動・退職しても原因調査が回り続ける体制になりました。
属人化の解消は、人手を増やすことではなく、調査の型を組織の資産として残すことだと、この事例は示しています。riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った後も継続して伴走し、こうした調査手順の標準化と文書化を一緒に進めることを重視しています。
ひとり情シスの不安は、人を増やすより仕組みを残すことで構造的に解消できるのです。
手順の文書化で残ったものは、次の2つです。
- 確認の順序:どのログを、どの順に確認するかが、誰でも追える手順として残りました。
- エスカレーションの基準:どの閾値を超えたら上げるかが、言葉にして決められました。
機会損失の定量化で投資を正当化した事例
原因調査の体制強化に予算を取るには、経営層を説得できる数字が必要です。障害が減るのは当たり前と思われやすく、運用投資は効果が見えにくいため、稟議が通りにくいものです。
この壁を、ダウンタイムの機会損失を定量化することで突破した事例を見ていきます。
停止回数とMTTRから損失額を試算した稟議
この企業は、過去1年間の障害を対象に、Gartnerの試算であるダウンタイム1分あたり5,600米ドルを参考にしながら、自社の売上規模に合わせて損失を見積もりました。ここで使うMTTRは、1回あたりの平均復旧時間です。
「障害が多い」と漠然と訴えるよりも、年間でいくら失っているかを数字で示したことが、経営層の判断を動かしました。
試算では、原因調査の体制を強化してMTTRを短縮すれば、同じ停止回数でも損失が比例して減ることを示しました。たとえば平均復旧時間を半減できれば、年間損失も理論上は半分になります。
この「調査の速さが損失額に直結する」というロジックが、監視ツールの導入や外部委託費という投資を正当化する根拠になりました。原因調査への投資を、損失を防ぐ保険として位置づけ直したのです。
稟議で示した材料は、次の2つです。
- 年間の機会損失:停止回数、MTTR、1分あたりの損失額から、年間で被っている損失を金額にしました。
- MTTR短縮の効果:同じ停止回数でも、平均復旧時間を縮めれば損失が比例して減る、という試算です。
運用コストの業界指標と照らして妥当性を示した事例
投資額の妥当性を補強するため、この企業は業界の運用コスト指標も参照しました。JUASの「IT運用コストメトリックス調査2020」では、運用役務コストの中央値が従業員1人あたり年9万円、サーバー1台あたり年140万円とされています。自社の運用投資がこの相場の範囲に収まっていることを示し、過大でも過少でもない適正な投資だと、経営層に納得してもらえました。
機会損失という「失っている金額」と、業界相場という「適正な水準」の両方を示すことで、原因調査への投資を感覚ではなく数字で語れるようになります。この事例が教えるのは、運用投資を通すには定量化が欠かせず、損失統計と業界指標という二つの一次データを組み合わせることで説得力が生まれる、ということです。
数字で語れる情シスは、原因調査の予算を毎年安定して確保できるようになります。
投資額の妥当性を示すために使った材料は、次の2つです。
- 失っている金額:機会損失を金額で示し、障害によって失っている額を経営層に伝えました。
- 業界の適正水準:運用役務コストとサーバー1台あたりの相場に照らして、自社の投資を確認しました。
再発防止の仕組みづくりで定着した事例
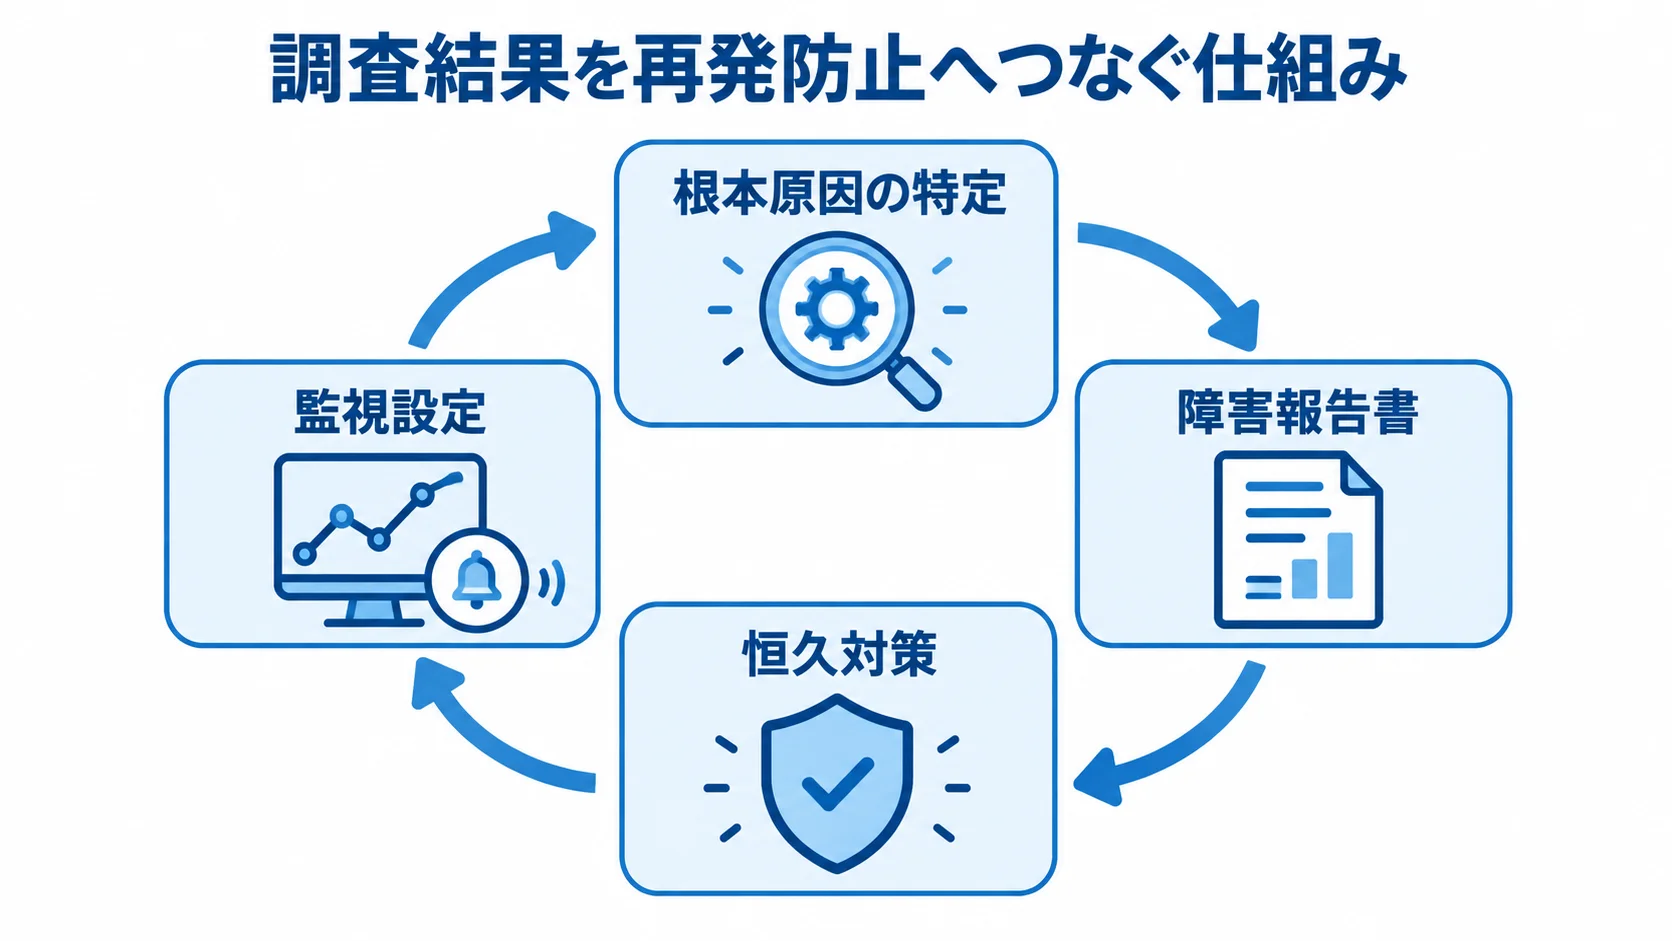
原因調査の真価は、目の前の障害を収束させるだけでなく、同じ障害を二度と起こさない再発防止にあります。原因を特定しても記録に残らず、対策に結びつかなければ、同じトラブルが繰り返されます。調査結果を仕組みとして定着させた事例から、再発防止の型を学びます。
障害報告書とポストモーテムを習慣化した事例
この企業では、一定規模以上の障害について、障害報告書を必ず作成するルールを定めました。さらに、関係者が集まって「なぜ防げなかったか」を個人の責任追及ではなく仕組みの問題として振り返るポストモーテム(事後検証)を習慣化しました。
原因調査の結論を改善の材料として扱う文化が、再発防止の土台になります。
障害報告書には、暫定対策と恒久対策を分けて記載しました。これにより、調査で判明した根本原因が「分かったまま放置される」事態を防げます。報告書が蓄積されると、過去の類似障害を検索して調査の初動を早める知識ベースにもなり、調査そのものが年々速くなっていきました。
この企業の再発防止の取り組みは、次の2つにまとめられます。
- 障害報告書:原因、経緯、影響、恒久対策をまとめ、恒久対策には期限と担当を付けます。
- ポストモーテム:関係者が「なぜ防げなかったか」を、仕組みの問題として振り返る場です。
調査結果を監視設定に反映して検知を早めた事例
もう一つの工夫が、原因調査で判明した予兆を監視に組み込むことです。ある障害の原因がメモリ枯渇だと分かったことが、監視を見直す出発点になりました。
OSSのZabbix、クラウド型のDatadog、Mackerelといった監視ツールに、調査で得た知見をフィードバックすることで、監視が事後対応から予兆検知へと進化していきました。
この「調査結果を監視に還元する」ループが回り始めると、障害の総数そのものが減っていきます。この事例は、原因調査が監視・報告・対策をつなぐ継続的な改善サイクルの中核にあると示しています。
調査して終わりにせず、次の検知に活かす仕組みを持つ企業こそが、障害に強いシステム運用を実現しているのです。
予兆検知への移行で押さえた点は、次の2つです。
- 閾値アラート:メモリ枯渇の手前にあたる使用率に閾値を設定し、障害の前に気づけるようにしました。
- 知見の還流:調査で得た知見を監視ツールへ戻す流れを、継続して回す仕組みです。
中小企業がAIOpsで調査を省力化した事例
大企業向けと思われがちなAIOps(AIによるIT運用)を、中小企業が身の丈に合った形で取り入れ、原因調査を省力化した事例もあります。
限られた人手で増え続けるアラートをさばききれなくなった企業が、調査の入口を自動化して、担当者を本来の判断業務に集中させた取り組みです。スモールスタートの設計が、無理のない導入の鍵になりました。
アラートのノイズ削減から始めた部分導入
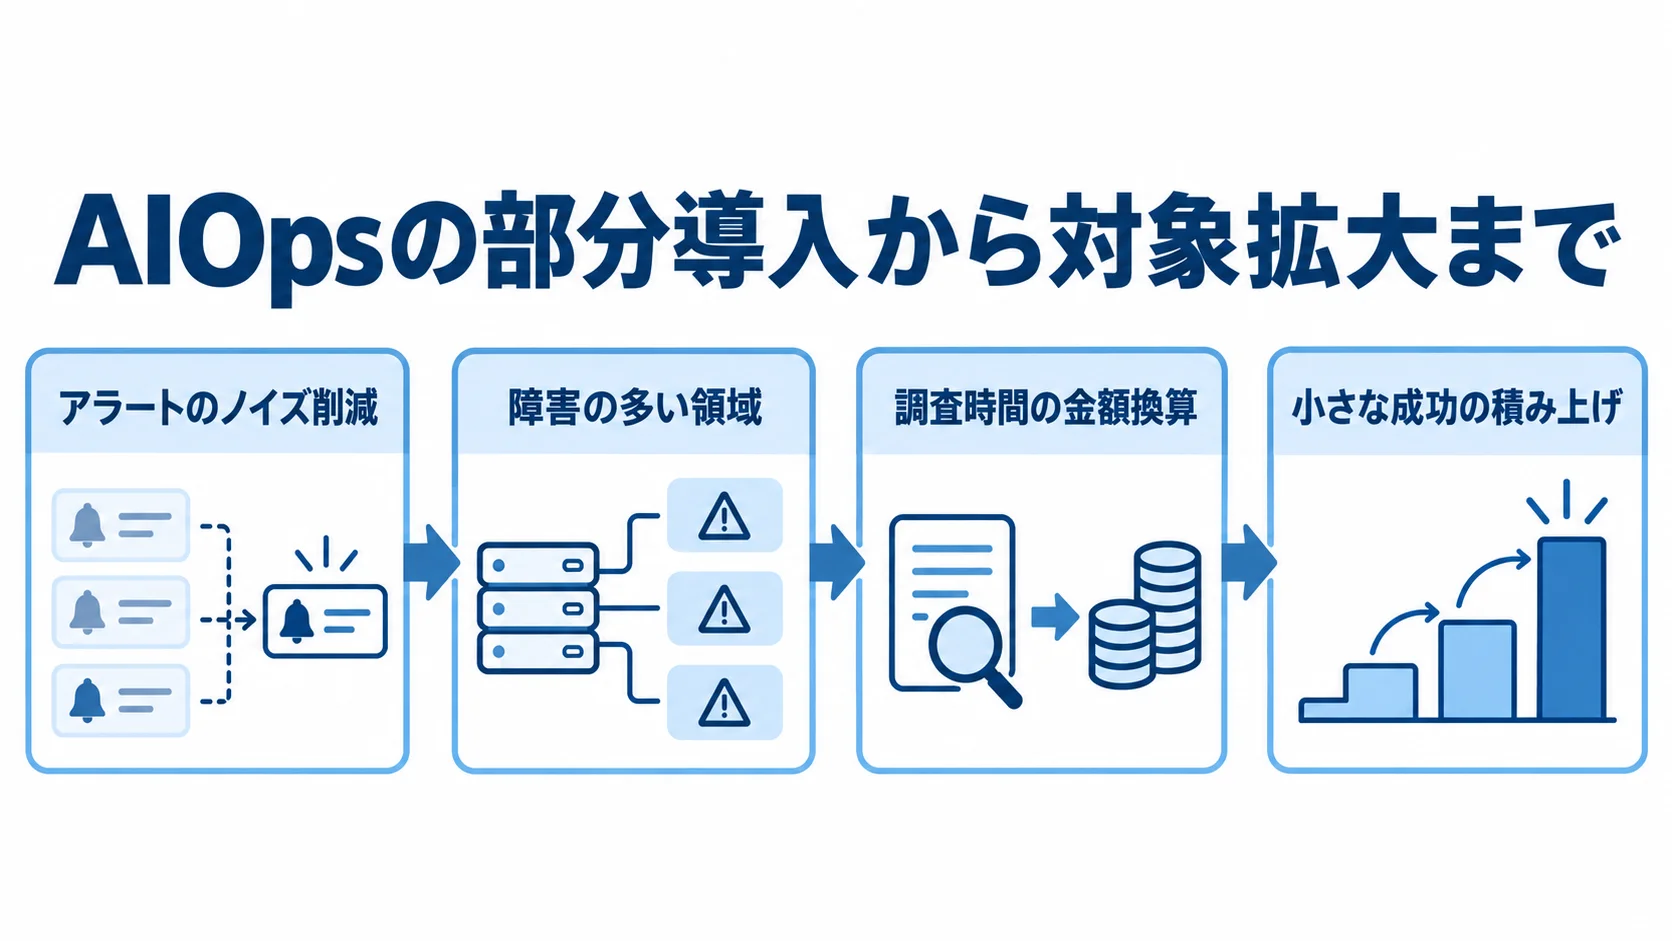
この企業がまず手を付けたのは、大量に上がるアラートのノイズ削減でした。重要度の低い通知に埋もれて危険な兆候を見逃す状態を、AIを使って改善しました。
全システムを一気に対象とせず、最も障害の多い領域から部分的に導入したことで、投資を抑えつつ効果を確かめられました。JUASの調査でもAI活用は約78パーセントが検討中・未検討とされており、この段階的な始め方は多くの中小企業の現実に即しています。
ノイズが減ったことで、担当者は「どのアラートを調べるべきか」の判断に費やしていた時間を削減できました。調査の入口でふるい分けが自動化されると、人は本当に難しい原因の特定に集中できます。また、レガシーな監視をいきなり捨てるのではなく、既存の仕組みに自動化を一枚重ねる発想が、無理のない省力化を実現しました。
部分導入で押さえた点は、次の2つです。
- ノイズの削減:似たアラートを相関分析で束ね、優先すべき通知だけを浮かび上がらせました。
- 障害の多い領域から:全システムではなく、最も障害の多い領域から導入して効果を確かめました。
ROIを示しながら適用範囲を広げた進め方
この事例で示唆に富むのは、部分導入で得た効果を数字で示し、次の適用範囲拡大の予算を獲得していった進め方です。その数字をもとに、段階的に対象システムを広げる合意を取り付けました。
最初から全社導入を狙わず、小さな成功でROIを証明してから広げる堅実さが、AIOps導入の失敗を避ける要点です。中小企業にとって、AIOpsは「大企業の高価な仕組み」ではなく、最も困っている調査の一部を肩代わりさせる現実的な道具です。
riplaは、フルスクラッチ受託と国内運用保守の立場から、レガシーを維持しつつ効果の大きい領域に自動化を部分導入する進め方を支えています。身の丈に合ったロードマップづくりも支援しています。
原因調査の省力化は、小さく始めて効果を数字で示すことから始まる、というのが事例の教えです。
予算を獲得するうえで押さえた点は、次の2つです。
- 調査時間の金額換算:ノイズ削減で削れた調査時間を人件費に換算し、投資対効果として経営層に示しました。
- 小さな成功の積み上げ:最初から全社導入を狙わず、小さな成功でROIを証明してから対象を広げました。
まとめ
ITシステムの原因調査事例を振り返ると、成功の鍵は、復旧と調査を分けて考えることにあります。具体的には、初動の役割分担で止血を優先すること、手順の文書化で属人化を解消すること、機会損失を定量化して投資を正当化すること、調査結果を監視と対策に還元することの四点に集約されます。
夜間障害ではMTTRを縮めて損失を抑え、ひとり情シスでは外部委託と手順書化で安心を得られます。損失額の定量化が予算を動かし、障害報告書とポストモーテムが再発を防ぎます。
ダウンタイム1分あたり5,600米ドル、5分以上の停止で1回あたり平均1,200万円という統計が、調査の速さがそのまま損失額を左右することを物語っています。
事例を読むときに大切なのは、「どんなツールを入れたか」より「どう調査の型を組織に残したか」という視点です。
自社の障害履歴を一覧にして、まずは復旧目標時間を宣言することと、障害報告書を習慣にすることから、明日にでも始めてください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムを作った後も継続して伴走し、原因調査の標準化と再発防止の仕組みづくりを一貫して支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。