
ITシステムの原因調査は、事実から根本原因(Root Cause)を特定し、恒久対策の実行まで進めて問題管理につなげる活動です。
全体像と進め方に加えて、なぜなぜ分析などの手法、委託先の選び方、費用の目安、発注の準備までを一通り押さえます。詳しい内容は、下の関連記事で確認できます。
- ITシステム原因調査の進め方/やり方/流れや方法/手法/工程/手順
- ITシステム原因調査でおすすめの開発会社/ベンダー6選と選び方
- ITシステム原因調査の見積相場や費用/コスト/値段について
- ITシステム原因調査の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム原因調査の全体像
原因調査は、障害や不具合の引き金となった事象を特定し、同じトラブルを二度と起こさないための分析活動です。
まず押さえたいのは、「インシデント」と「障害」の違い、そして「インシデント管理」と「問題管理」の違いです。これらを混同したまま運用すると、復旧はできても再発防止が進まないという落とし穴に陥りがちです。
インシデントと障害、原因調査の位置づけ
「インシデント」は、サービスが正常に稼働していない状態を指します。一方、「障害」は、その状態を引き起こしている原因となる事象を指します。
- インシデント管理:サービスの迅速な復旧と、目の前の影響への対処
- 問題管理:障害の根本原因の特定と、再発防止の恒久対策
たとえば、「画面が表示されない」のがインシデントで、「データベースの接続枯渇」が障害にあたります。原因調査は、このインシデントを起点に、どの障害が、なぜ発生したのかを掘り下げる工程です。
重要なのは、迅速な復旧を目指す「インシデント管理」と、根本原因の特定・再発防止を目指す「問題管理(障害管理)」を分けて考えることです。原因調査は、このうち後者の中核を担います。
復旧を急ぐあまり暫定対応で蓋をしてしまうと、根本原因が残ったまま、同じトラブルが繰り返されます。そのため、暫定対応(復旧)と恒久対策(再発防止)を意識して切り分けることが、原因調査の出発点になります。
原因調査がビジネスにもたらす価値
原因調査を仕組み化すると、技術的な作業にとどまらない効果が生まれます。再発が減ればエンジニアのオンコール負担が軽くなり、バーンアウトの予防にもつながります。
- 事業影響と説明責任:原因と影響を明らかにし、顧客や経営層へ説明する根拠を整えます。
- 組織の学習資産:調査で得た知見の蓄積と、システム全体のレジリエンス(回復力)の向上
原因調査は、障害が事業に与える損害を最小化する役割も担います。
警察庁が2023年に公表した資料では、ランサムウェア被害企業140社のうち約95%が業務に影響したと回答しています。原因の特定と再発防止は、事業継続に直結します。
場当たり的な対応から脱却し、再現性のある調査プロセスを持つことが、安定したサービス運営の土台になります。
ITシステム原因調査の進め方
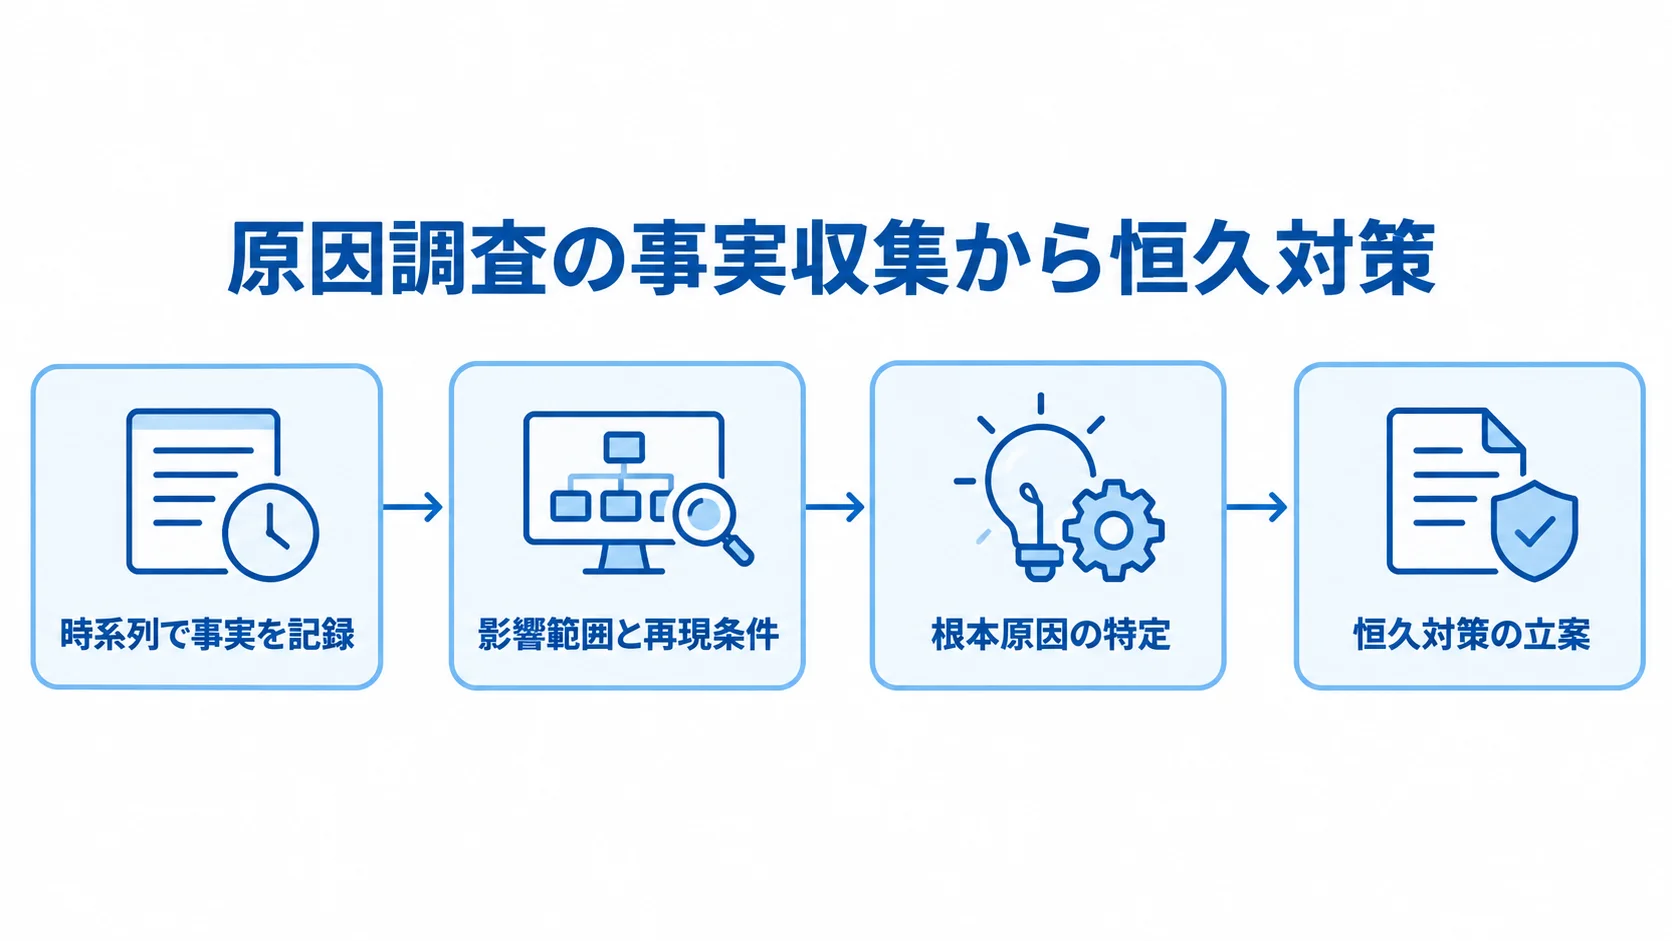
原因調査は、ログ解析で事実を集め、なぜなぜ分析で因果を掘り下げ、根本原因を特定したうえで、恒久対策を立てる流れで進みます。
感覚や思い込みで原因を決めつけず、客観的な事実を積み上げてから因果関係を組み立てることが、調査の精度を高める鍵です。そこで、流れは大きく2つのフェーズに分けて捉えます。
事実収集とログ解析フェーズ
最初のフェーズでは、いつ・どこで・何が起きたのかを時系列で正確に把握します。
- 時系列で事実を記録:アプリケーションログ、サーバーのリソース、監視アラートを照合する
- 影響範囲と再現条件:影響する機能やユーザーの確認と、事象の再現条件の特定
デプロイ履歴や設定変更も含め、発生時刻の前後で何が変わったかを洗い出すと、原因の候補が絞られていきます。ここで集めた事実は後の分析の土台になるため、推測を交えず客観的な記録に徹することが大切です。
あわせて、影響範囲を明らかにすると、調査の優先度や恒久対策の重み付けが決まります。再現条件まで押さえられると、原因の絞り込みが一気に進みます。
根本原因の特定と恒久対策の立案フェーズ
集めた事実をもとに、なぜその事象が起きたのかを繰り返し問い、表面的な現象の奥にある本質的な原因にたどり着きます。たとえば「サーバーが落ちた」場合は、直接の原因と、リソース枯渇が起きた理由を順に調べます。さらに、事前に検知できなかった理由まで掘り下げると、根本課題が見えてきます。
根本原因が特定できたら、仕組みで解決する恒久対策を立てます。「気をつける」「チェックを増やす」といった属人的な対策だけでは、再発を防ぎにくくなります。
対策は、完全予防・リスク緩和・迅速検知・影響範囲の最小化の4つの観点で検討すると、抜け漏れの少ない再発防止策を組み立てられます。
調査結果は、実行できる形の再発防止策に落とし込みます。そのうえで、担当者と期限まで明確にしておくことが大切です。
- 再発を防ぐ:原因を取り除く恒久対策を決めます。
- 影響を抑える:暫定策と復旧手順を整え、同じ障害が起きた際の影響を抑えます。
原因調査の代表的な手法と分析技法
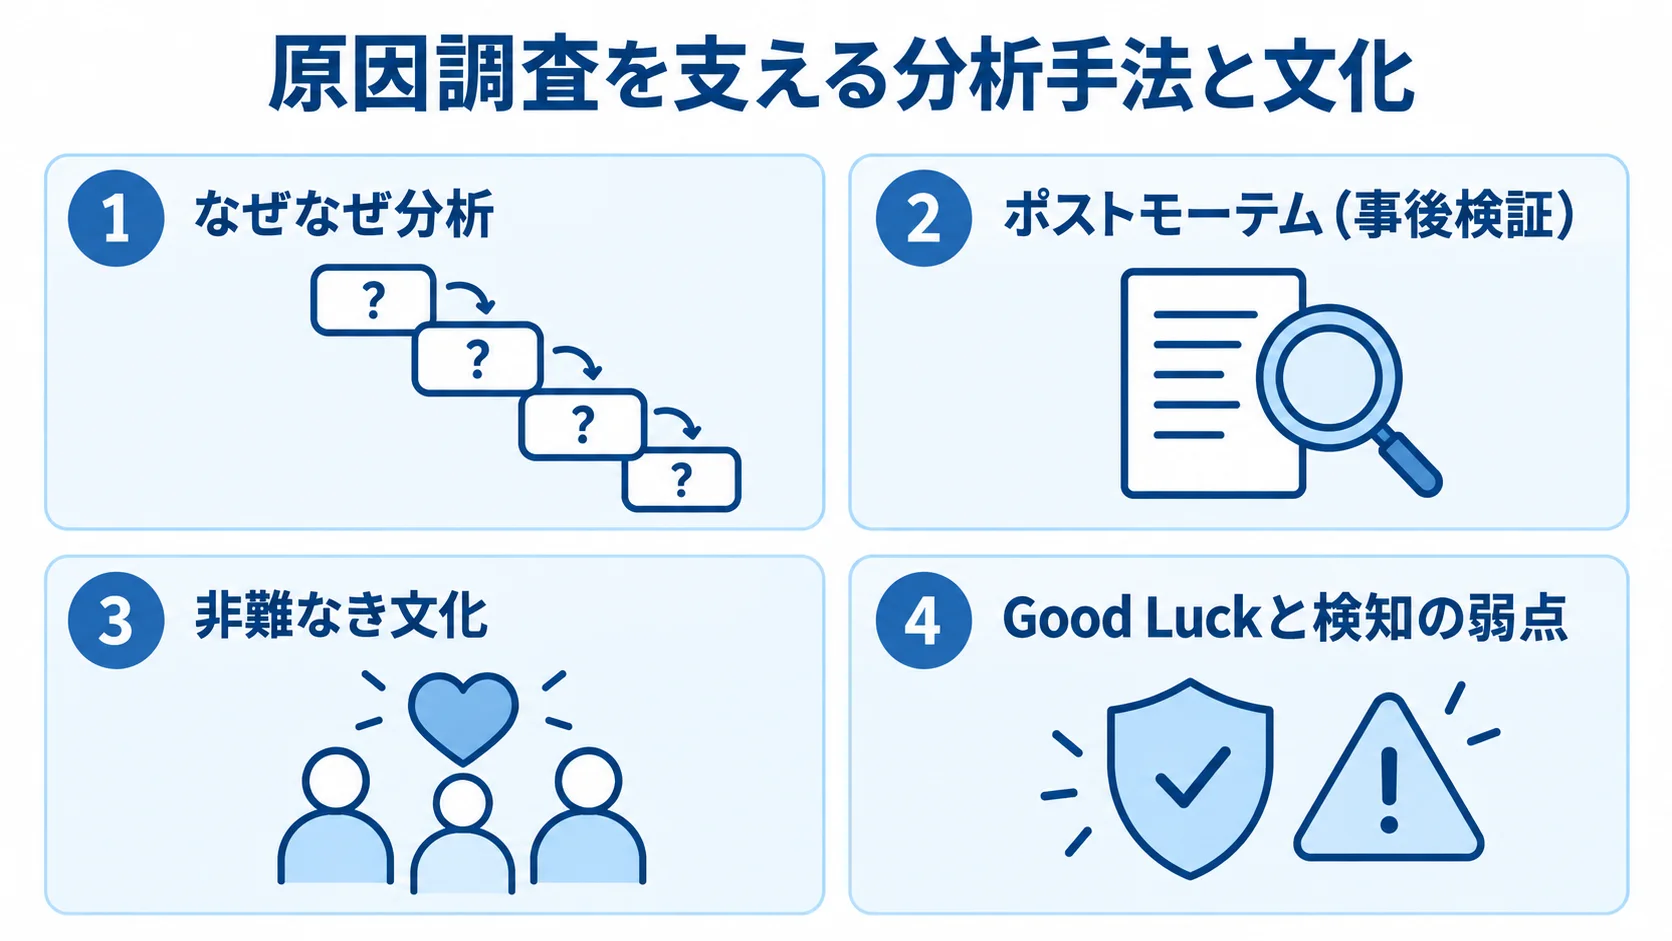
原因調査を支える代表的な手法は、「なぜなぜ分析」と「ポストモーテム(事後検証)」です。どちらも作業手順にとどまらず、組織の文化と密接に結びついています。
とりわけ、個人を責めない「非難なき文化(Blameless Culture)」を土台に据えられるかどうかで、得られる学びの質が大きく変わります。
なぜなぜ分析と個人攻撃を防ぐ技法
なぜなぜ分析は「なぜ」を繰り返すことで、表面事象の奥にある本質課題を浮き彫りにする手法です。ただし、進め方を誤ると「なぜあなたはミスをしたのか」という個人攻撃に転じてしまう危険があります。
- 問いを仕組みに向ける:「なぜ」だけでなく「どのようにして」と問い、プロセスの欠陥を見つけます。
- 環境要因を確かめる:個人の注意力に頼らず、作業環境や仕組みに原因を求めます。
個人攻撃を避けるには、問いの形を変えるのが有効です。たとえば、「なぜ誤った設定をしたのか」と問う代わりに、「どのようにして誤った設定が通ってしまったのか」と問います。そうすると、責任追及ではなく仕組みの欠陥に視点が向かいます。
この考え方は「花瓶の例え」で説明されます。花瓶を割った失敗も、本人の不注意だけで片づけず、「水場までの移動経路」や「割れやすい材質」にまで目を向けます。
個人の注意力に頼る対策では、再発を防げません。仕組みに目を向ける視点があってこそ、なぜなぜ分析は機能します。
ポストモーテムと非難なき文化
ポストモーテムとは、障害が収まった後に、概要やタイムライン、根本原因、再発防止策を文書化し、組織の学習資産として残す事後検証です。個人を責める「反省会」とは根本的に異なります。
- 非難なき文化:責任追及ではなく、ミスを誘発した仕組みの欠陥に焦点を当てます。
- Good Luckと検知の弱点:偶然うまくいった点や検知の遅れを、振り返りの対象にします。
記憶が新しいうちに行うのが望ましく、解決後72時間以内(おおむね2〜3営業日以内)に行うのが理想とされています。
質の高いポストモーテムでは、運が良かった点(Good Luck)もあえて洗い出します。「たまたま早期に発見できた」という偶然を見える形にすると、潜在リスクが浮かび上がるからです。
「なぜ監視アラートより先に、ユーザーやカスタマーサポートが気づいたのか」と厳しく問うことで、検知体制の弱点を補強できます。こうした分析手法の使い分けは、原因調査の質を左右します。
原因調査を委託する会社の選び方
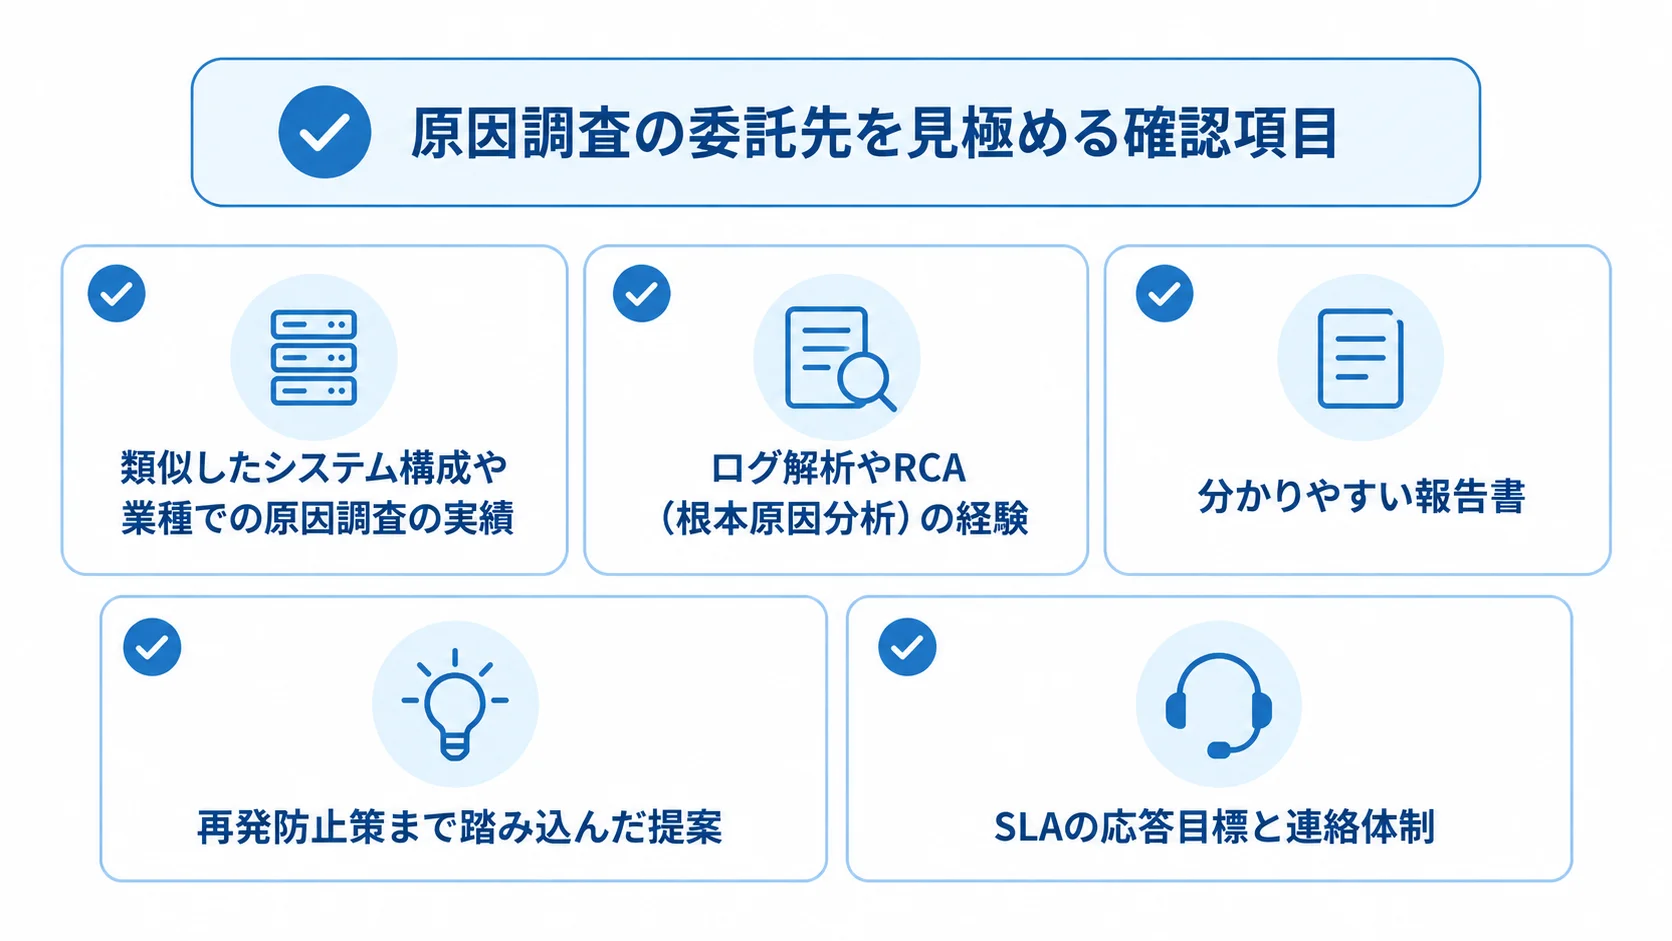
24時間365日の監視や高度な原因調査を自社だけで担うのは、簡単ではありません。そこで、運用代行や監視サービス、インシデント管理の専門ベンダーへ委託する選択肢が現実的になります。
個別の会社名よりも、委託先を選ぶ際に共通して確認したい基準を挙げます。具体的な比較は、関連記事をご覧ください。
実績と調査力の確認ポイント
委託先を選ぶ際は、自社と類似したシステム構成や業種での原因調査の実績があるかを確かめます。ログ解析やRCA(根本原因分析)の経験が豊富なベンダーほど、調査のスピードと精度が高い傾向があります。
委託先の見極めでは、調査結果を分かりやすい報告書にまとめられるか、再発防止策まで踏み込んだ提案ができるかも判断材料になります。
委託の長期的な価値を左右するのは、再発を防ぐ仕組みづくりまで伴走できるかどうかです。
SLAと対応体制・ベンダー統制の評価
委託先のSLA(サービス品質保証)に、検知から連絡やエスカレーションまでの時間目標が明示されているかを確認します。
- SLAの応答目標と連絡体制:検知後の連絡・復旧目標と、深夜・休日を含む対応体制
- ベンダー報告の評価:RCAの妥当性、契約上の情報開示、SLA違反時の取り決め
たとえば、重大度の高い障害でも検知から15分以内の連絡、1時間以内の目標復旧といった水準が示されていれば、安心材料になります。あわせて、連絡フローも事前に把握しておきましょう。
外部ベンダーやSaaSが関わる障害では、報告書(RCA)の内容が不十分なら差し戻す「ベンダーコントロール」が欠かせません。
ペナルティや詳細情報の開示要求まで、契約段階で決めておけば、いざというときに「待つだけ」にならずに済みます。
原因調査にかかる費用相場
原因調査の費用は、調査対象の規模や緊急度、求める調査の深さによって大きく変動します。単発のスポット調査か、月額の監視・運用代行に含めるかによっても、費用の構造は異なります。
費用の目安と、コストを左右する主な要因を見ていきます。金額の詳しい内容は、関連記事で解説しています。
調査形態別の費用目安
原因調査の費用は、エンジニアの人月単価と調査に要する工数で決まるのが基本です。緊急性の高い障害対応を伴うスポット調査では、対応の即時性やオンコール体制が加味され、単価が上がる傾向があります。
月額の運用代行や監視サービスに原因調査を含めれば、固定費のなかで対応されるため、発注する会社は突発的な高額出費を平準化できます。
自社の障害発生の頻度やシステムの重要度を見て、どちらの形態が合うかを検討するとよいでしょう。
費用を左右する主な要因
費用は、対象システムの状態と、監視・調査の体制によって変わります。
- システムと資料の状態:構成の複雑さや、ログ・ドキュメントの整備状況が調査工数を左右します。
- 監視・調査の体制:24時間365日の監視やインシデント管理基盤の有無も費用に影響します。
構成図やログが整理されていれば、調査工数は減り、コストも抑えられます。逆に、資料が乏しく属人化が進んでいるシステムでは、現状把握だけで多くの工数を要します。
日頃からシステム構成を図にまとめ、ログを残しておくことが、結果的に調査コストの削減につながります。
検知の自動化に投資しておくと、初動が早まり、調査全体の工数を圧縮できます。このため、トータルコストでは有利になるケースも少なくありません。
原因調査の発注・外注方法
原因調査を外部に発注するなら、依頼内容を明確にし、調査に必要な情報を整理しておくことが、スムーズな委託の前提になります。また、発注先の種類によって対応範囲や得意分野が異なるため、自社の課題に合った委託先を選ぶことが大切です。
発注先の種類と特徴
発注先には、システムを開発した元のベンダー、インフラ運用代行・監視を専門とする会社、セキュリティ調査を得意とする事業者など、さまざまなタイプがあります。
開発元は仕様に精通しているという強みがあります。一方で、客観的な視点からの調査は、外部の専門会社のほうが優れる場合もあります。原因が不明確な段階では、ログ解析やフォレンジックに強い会社を選ぶと、原因の絞り込みが早まります。
自社の障害がアプリ起因か、インフラ起因か、あるいはセキュリティ起因かによって、適した発注先は変わってきます。
発注前に準備すべきドキュメント
発注をスムーズに進めるには、事前に資料を揃えておくことが有効です。
- 調査に必要な資料:構成図やネットワーク図、事象のタイムライン、ログ、過去の報告書
- 依頼範囲と報告内容:調査範囲と報告書に含める項目を、委託先へ明示します。
これらが揃っていると、委託先は短時間で状況を把握でき、調査の立ち上がりが早まります。一方、情報が不足していると、現状把握だけで余計な工数と費用がかかってしまいます。
期待値をすり合わせておくと、納品物のミスマッチを防ぎ、再発防止につながる実用的な調査結果を受け取りやすくなります。
原因調査で失敗しないためのポイント
原因調査は、調査そのものよりも、「立てた恒久対策が実行され、文化として定着するか」でつまずくことが多いものです。せっかく根本原因を突き止めても、対策が日々の開発タスクに埋もれてしまえば、再発は防げません。
調査を成果につなげるには、恒久対策を守ることと、非難なき文化を定着させることが欠かせません。
恒久対策を守る交渉とリソース確保
ポストモーテムで立てた恒久対策は、新機能開発の優先圧力に押し出されて後回しにされがちです。
- 対策の担当と期限:再発防止策をタスクとして登録し、担当者と期限を決めます。
- 投資の根拠と検証:予防投資の根拠を数値で示し、検証の手段も確保します。
後回しにさせないためには、対策を開発の計画の中に位置づけておくことが欠かせません。さらに、経営層やビジネス側には、技術的負債の解消が事業リスクの低減につながると伝え、リソースを確保する交渉も必要になります。
カオスエンジニアリングのような能動的な検証も有効です。ある事例では、擬似障害実験47件から致命的な故障モード12件を特定しました。MTTR(平均復旧時間)は65%減り、レジリエンススコアは2.3から4.1へ向上したと報告されています。
定量的な効果は、予防投資の必要性を説得する強力な材料になります。
非難なき文化の定着とメンタルケア
原因調査を機能させるには、「障害ゼロ」を求める前時代的な発想から脱却し、障害は起こり得る前提で備える文化への転換が必要です。
- 事実を共有できる文化:犯人探しを避け、現場が事実を共有して原因調査できる環境を整えます。
- オンコール負担の把握:深夜・休日の負担を数値で捉え、交代枠やインセンティブを見直します。
失敗を許容せず犯人探しに走る組織では、現場が事実を隠すようになり、正確な原因調査は成り立ちません。そのため、経営層にも、非難なき文化が結果的に再発防止と事業継続に資することを丁寧に伝える必要があります。
あわせて、障害対応を担うエンジニアのメンタルヘルスにも目を向けるべきです。負担を軽くする手立てが、バーンアウトの予防につながります。
属人化を解消し、特定の人に負担が偏らない体制をつくることが、持続可能な原因調査の前提となります。
まとめ
ITシステムの原因調査は、目の前の障害を復旧させる「インシデント管理」と、再発を断ち切る「問題管理」を切り分けることから始まります。そのうえで、ログ解析で事実を集め、なぜなぜ分析で本質課題へ掘り下げ、仕組みで解決する恒久対策を立案するという流れを押さえれば、場当たり的な対応から脱却できます。
なぜなぜ分析を個人攻撃に転じさせない問いの立て方や、非難なき文化を土台としたポストモーテムが、調査の質を大きく左右します。また、外部委託を検討する際は、実績や調査力、SLA、ベンダー統制の観点で委託先を見極め、費用の構造や発注前の準備物を理解しておくことが成功の鍵です。
そして何より、立てた恒久対策を新機能開発の圧力から守り、文化として定着させることが再発防止を実現します。各テーマの詳細は、下の関連記事で具体的に解説していますので、ぜひあわせてご活用ください。
本文のテーマを深く知りたい方向けに、関連記事を内容別にまとめました。
- ITシステム原因調査の進め方/やり方/流れや方法/手法/工程/手順
- ITシステム原因調査でおすすめの開発会社/ベンダー6選と選び方
- ITシステム原因調査の見積相場や費用/コスト/値段について
- ITシステム原因調査の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。