
ITシステム原因調査に必要な機能は、異常の検知から恒久対策まで一続きの流れになっており、前の段階の結果を次の段階が受け継いで働きます。
委託する範囲と自社で持つ機能を分けるときは、次の4層に沿って整理すると判断の材料が見えやすくなります。
- 検知・切り分け:異常の発見と、調査の優先順位づけ
- ログ・相関分析:分散したログの収集と、発生時刻や原因候補の追跡
- 再現・影響範囲:不具合の再現条件の確認と、業務やデータへの波及範囲の把握
- 恒久対策・自動化:再発の防止と、調査の負荷軽減
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
検知から切り分けまでの調査基盤機能
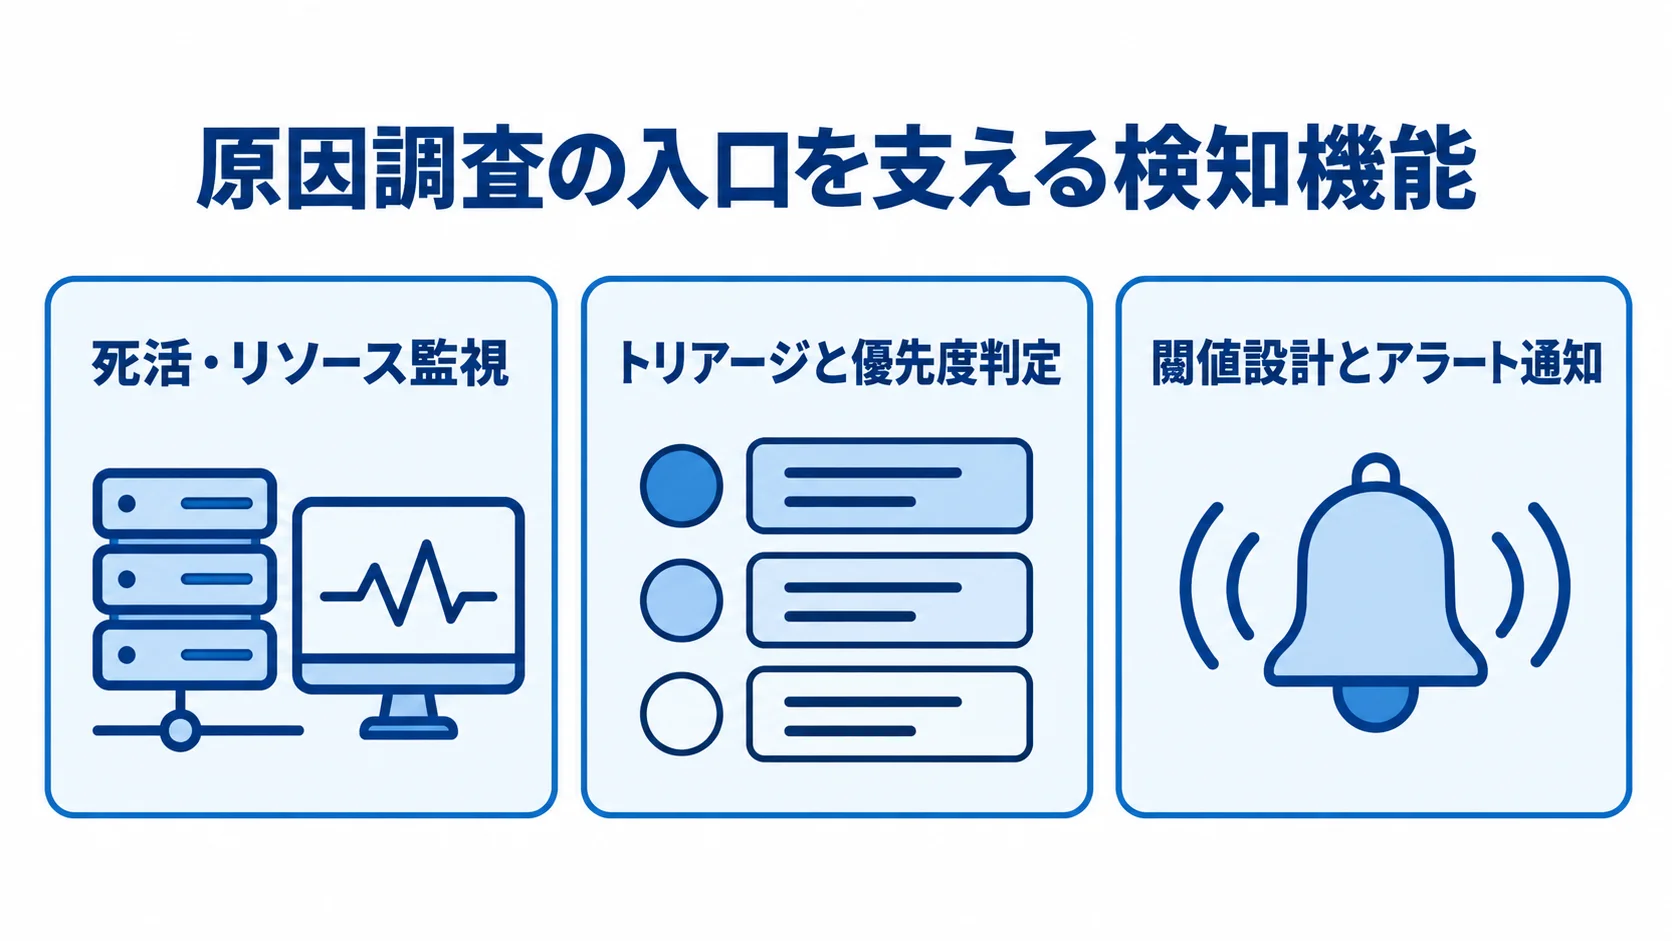
原因調査の起点になるのが、異常を素早く検知し、調査すべき対象を切り分ける基盤機能です。障害が起きてから調査を始めると遅れるため、平常時から状態を観測して異常の兆しをつかむ仕組みが調査の前提になります。
ここでは、死活・リソース監視による異常検知、トリアージと優先度判定、閾値設計とアラート通知を取り上げます。
死活・リソース監視による異常検知機能
調査の入口は、サーバーやサービスが生きているかを確かめる死活監視と、CPU・メモリ・ディスクなどの使用率を見るリソース監視です。これらが異常を検知してアラートを上げることで、調査が始まります。検知できないものは調査もできないため、どの対象を監視下に置くかという設計が、調査できる範囲を決めます。
監視ツールにはそれぞれ特性があります。OSSのZabbixはライセンス無料で柔軟ですが、構築と維持に工数がかかります。一方で、クラウド型のDatadogやNew Relicは、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です。
運用・監視サービスの相場は月5万〜20万円が目安で、例としてサーバー監視3万円に月次メンテナンス4時間2万円を組み合わせる料金体系もあります。サーバー監視に特化したMackerelもあり、調査対象の規模と運用体制に合わせて選びます。検知機能の精度が、その後の調査の出発点を決めます。
トリアージと優先度判定の機能
異常を検知したら、次にどこから手を付けるかを判断するトリアージ機能が働きます。調査本体に入る前に、何を・どの順で調べるかを整える役割を担います。すべての異常を同じ重さで扱うと調査が回らなくなるため、サービスへの影響の大きさで優先度を付け、重大なものから調べます。
トリアージでは、影響を受けているユーザー数、停止している業務の重要度、復旧目標時間などを総合して優先度を決めます。この判定が適切であれば、限られた人手を最も損失の大きい障害に集中できます。
たとえばCloud Naviでは、重大インシデントに15分以内の一次対応を保証しています。こうした優先度に応じた応答時間の設計が、トリアージの基準になります。
閾値設計とアラート通知の機能
検知の精度を決めるのが、どの指標を、どの値を超えたら、誰に通知するかという閾値設計です。閾値が緩すぎると異常を見逃し、厳しすぎるとアラートが鳴りやまず、重要なものがノイズに埋もれます。
CPU使用率やエラー率、レスポンス遅延といった指標ごとに、平常時のベースラインを把握したうえで閾値を引くことが、調査の起点を正しく作る前提になります。ここが甘いと、後続のログ分析や再現の工程が後手に回るため、閾値とアラートの設計は調査基盤の土台です。
アラートの宛先と通知経路を優先度別に分ける設計も、この機能の一部です。重大なものはエスカレーション経路に乗せて確実に担当者へ届け、軽微なものは記録だけにとどめるといった出し分けが、調査の初動を左右します。シーズホスティングの例では、検知から60分以内の通知が水準として示されており、通知の速さと正確さが、調査の入口の質を決めます。
ログ収集と相関分析の機能
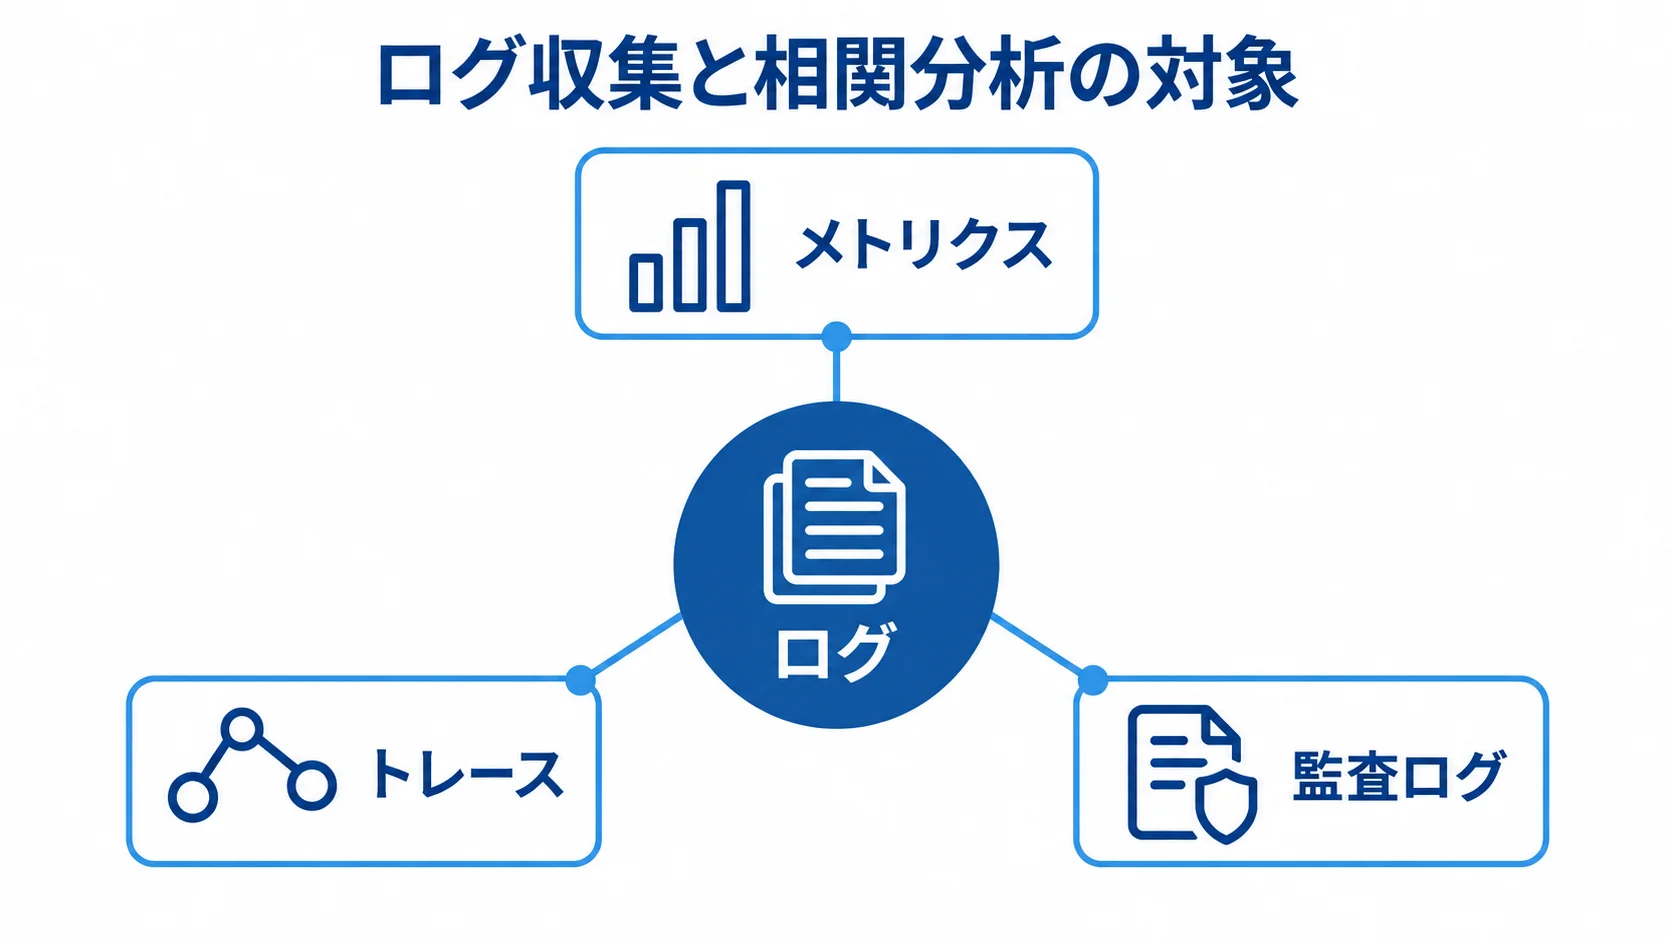
原因調査の中核になるのが、ログを集めて分析する機能です。何が起きたかの証拠はログに残っており、複数のログを突き合わせて時系列で因果を追うことが、原因特定の基本になります。
ここでは、分散したログの一元収集と検索、メトリクスとログの相関分析、ログ保全とトレーサビリティを順に取り上げます。
分散したログの一元収集と検索機能
現代のシステムは、Webサーバー、アプリケーション、データベース、ネットワーク機器など複数の層にまたがり、ログもそれぞれの場所に分散しています。そのため原因調査では、これらを一元的に集約し、時刻で串刺し検索できる機能が欠かせません。
SIEMと呼ばれるSplunk Cloudのような基盤は、各所のログを集めて横断的に検索・相関できるようにし、調査の効率を大きく高めます。ログが一元的に集まっていないと、調査担当者は各サーバーに個別にログインしてログを追うことになり、障害の最中に貴重な時間を浪費します。
一方で、一元収集と全文検索が整っていれば、エラーが最初に出た瞬間を特定し、そこから因果をさかのぼれます。IBMの2024年調査では、データ漏洩の検知までに平均204日を要し、被害額は平均445万米ドルとされています。ログから異常を早期に見つける体制の価値は計り知れません。
メトリクスとログを突き合わせる相関分析機能
ログ単体だけでなく、CPU使用率やレスポンスタイムといったメトリクスと突き合わせる相関分析が、原因の絞り込みを加速します。たとえば、応答遅延が始まった時刻と、特定のバッチ処理のログ出力時刻、メモリ使用率の急上昇が一致すれば、そのバッチが原因の有力候補になります。
DatadogやNew Relicは、メトリクスとログ、トレースを統合的に可視化する機能を持ち、相関を直感的に把握できます。相関分析の機能が充実していると、調査担当者は「いつ・何が・どう連鎖したか」を一画面で追えます。
これにより、経験の浅い担当者でも一定の調査ができるようになり、原因調査の属人化を和らげられます。ログ収集と相関分析は、証拠を集めて筋道を立てるという原因調査の本質的な機能で、ここへの投資が調査スピードに最も直接的に効きます。
ログ保全とトレーサビリティの機能
見落とされがちなのが、相関分析の土台となるログ保全で、どれだけの期間・どの粒度で残すかが問われます。原因調査では、障害が起きた瞬間だけでなく、数日前からの予兆をさかのぼって確認したいことが多くあります。ログの保存期間が短すぎると、調査に必要な過去のデータがすでに消えており、原因の特定に行き詰まります。
データ漏洩のような事案は、IBM 2024年の調査で検知まで平均204日とされ、長期間にわたります。そのため、十分な保全期間の設計が調査の成否を分けます。さらに、保全されたログがそろってこそ、相関分析の結果を信頼して使えます。
あわせて、誰が・いつ・どの操作をしたかを追えるトレーサビリティ(追跡可能性)も欠かせません。アクセスログや操作ログが残っていれば、不正アクセスや設定ミスといった人為的な要因を切り分けられます。SIEMのSplunk Cloudのような基盤は、監査ログを長期保全し、いつでも横断的に辿れる状態にします。
再現と影響範囲を特定する機能
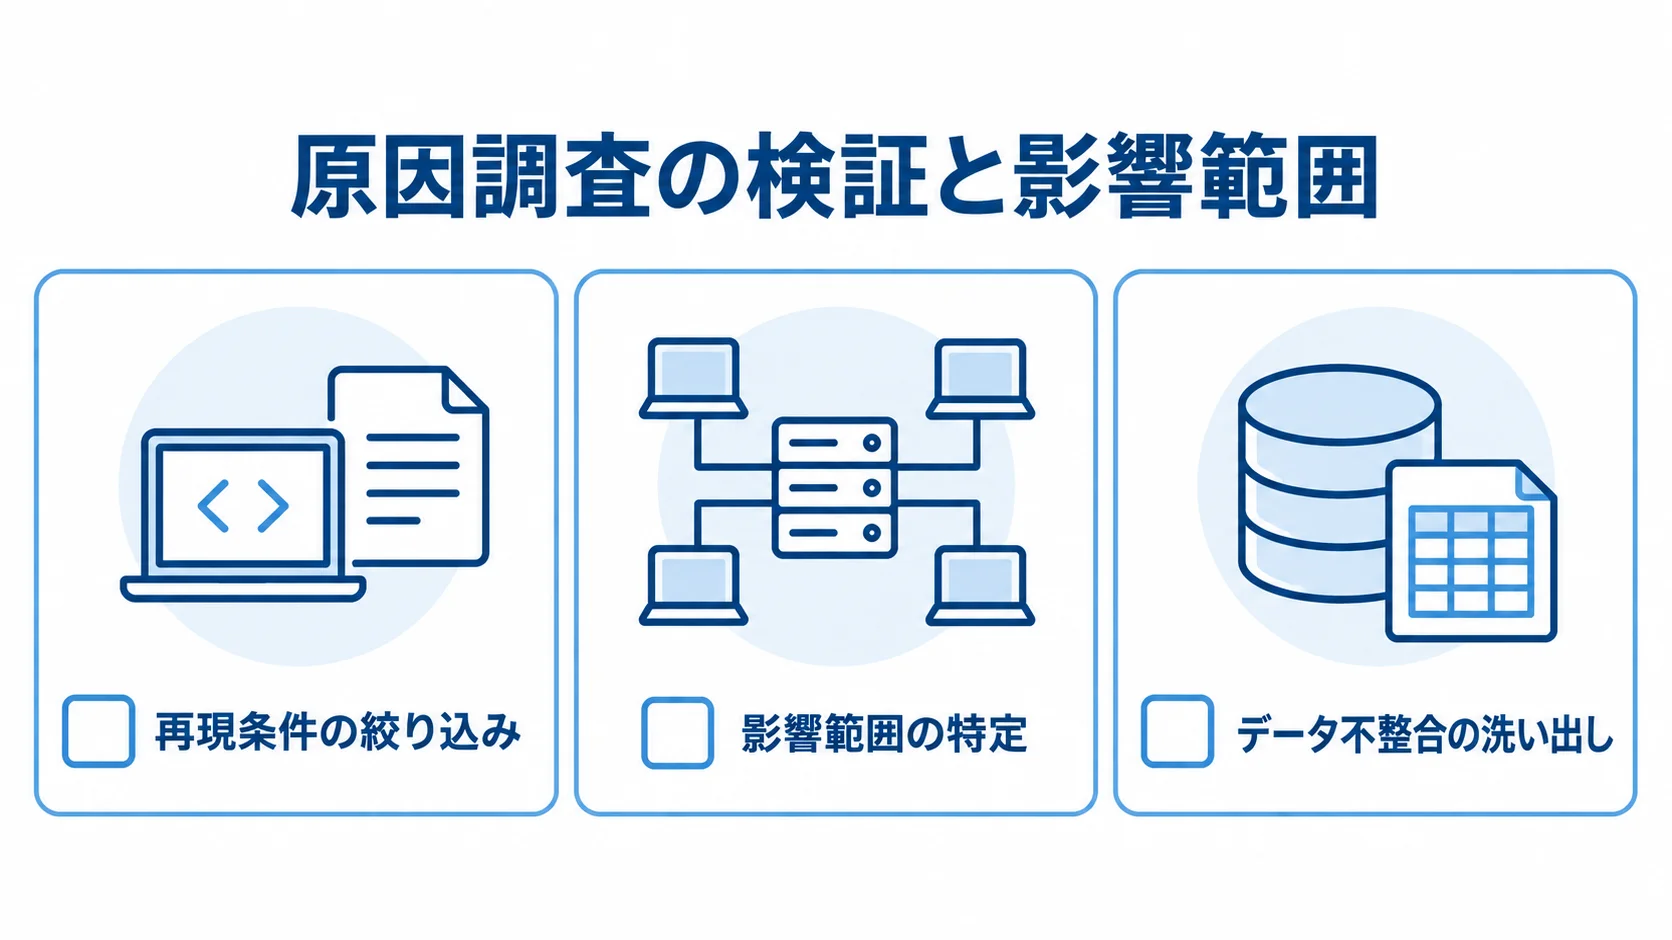
原因の候補が見えてきたら、それが本当に原因かを確かめる再現機能と、障害がどこまで波及しているかを見極める影響範囲特定機能が必要になります。
再現できない不具合は対策の効果も確かめられず、影響範囲を誤れば報告も復旧の判断も狂ってしまいます。再現条件の絞り込み、影響範囲の特定、データ不整合の洗い出しに分けて、順に取り上げます。
再現条件の絞り込みと検証環境の機能
原因調査では、どんな条件で問題が起きるかを絞り込む再現の機能が要になります。特定の入力データや時間帯、負荷状況でのみ起きる不具合は、その条件を再現できて初めて原因が確定します。
本番と同等の検証環境を平常時から用意しておくことが、再現のスピードを左右します。ログから推定した条件をその環境で再現すれば、対策後に同じ条件で効果を確かめられます。ただし、本番とデータ量や構成が違う環境では、本番でのみ起きる負荷起因の不具合を再現できないことがあるため、本番に近い環境を保つことが前提です。
再現が難しいケースでは、本番のログやメトリクスから状況証拠を積み上げ、最も確からしい原因を推定します。100パーセントの再現にこだわって復旧を遅らせるより、確度の高い暫定対策を打ちながら調査を続けるバランス感覚も、この機能の一部です。
影響範囲の特定と報告連携の機能
原因と並行して調べるべきは、障害がどの業務・どの利用者にまで及んでいるかという影響範囲です。影響範囲が分からなければ、誰に何を報告すべきか、どこまで復旧すれば業務が回るかを判断できません。
関連するシステム間の依存関係を辿り、波及先を特定する作業も、この機能に含まれます。こうした波及先の特定は、BCP(事業継続計画)と連動した初動判断にも直結します。影響範囲の特定は、経営層や業務部門への報告とも連動します。
官公庁の仕様例では「1時間以内に内容と予想作業時間を報告」と定められています。影響範囲を素早くつかんで正確に報告することが、原因調査に求められる役割です。riplaはフルスクラッチ受託の立場からシステムの内部構造を把握しているため、波及先の特定を、作った当事者として精度高く支援できます。
データ不整合の波及範囲を洗い出す機能
影響範囲の特定で特に難しいのが、データの不整合がどこまで広がったかを洗い出す機能です。バグによって誤ったデータが書き込まれると、そのデータを参照した後続の処理にも影響が連鎖し、被害が見えないところで拡大します。
原因調査では、いつからいつまでの間に、どのレコードが影響を受けたのかを特定し、修復が必要な範囲を確定させる作業が欠かせません。範囲を誤ると、表面上は復旧したように見えても、汚れたデータが残り続けて後日トラブルが再燃します。
この機能では、データベースの変更履歴やトランザクションログを辿り、影響を受けたデータを抽出して正しい状態へ戻す手順を設計します。誤データの規模が大きければ、一括補正のバッチを組むこともあります。波及範囲を正確に押さえられるかは、システムの内部構造とデータの流れをどれだけ理解しているかにかかっています。
恒久対策とAIOpsによる自動化機能
原因を特定したら、二度と同じ障害を起こさない恒久対策を設計・実装する機能が必要です。さらに近年は、AIが調査の一部を肩代わりするAIOpsという機能が登場しています。
ここでは、恒久対策の設計、AIOpsによる予兆検知と原因推定、振り返りとナレッジ蓄積を取り上げます。
恒久対策の設計とパッチ適用の機能
恒久対策には、ソースコードの修正や設定変更が含まれます。リソース増強や監視閾値の見直しも、原因に応じた打ち手になります。判明した根本原因に対して再発を防ぐ修正を設計し、テストを経て本番に適用するまでが、この機能の一連の作業です。
障害対応サービスの料金は、24時間の緊急対応を含めると月10万〜20万円、スポット対応では1件3万〜10万円が目安です。恒久対策の実装は、この範囲か、規模が大きければ追加の開発として扱われます。
暫定対策は止血にすぎず、根本原因を断つ恒久対策を別に計画して実施しなければ、同じ障害が再発します。さらに、実装後は再現環境で同じ条件を再現し、不具合が解消したことを検証する工程まで含めると、対策の確実性を担保できます。原因を見つけるだけでなく、対策の実装まで続けて、調査は初めて完結します。
AIOpsによる予兆検知と原因推定の機能
AIOps(AIによるIT運用)は、大量のログとメトリクスを機械学習で分析し、人が気づきにくい予兆を検知したり、過去のパターンから原因を推定したりする機能です。アラートが大量に出る中から重要なものを選び出すノイズ削減や、相関の自動抽出によって、調査の初動を早められます。
JUASの調査では、AI活用について約78パーセントの企業が検討中または未検討とされています。まだ普及の途上にありますが、調査負荷を下げる手段として注目されています。
中小企業が導入する際は、全面導入を狙うより、まず最も障害の多い領域に部分導入してROIを確かめるスモールスタートが現実的です。また、レガシーな監視を維持しつつ、効果の大きい部分から自動化を重ねるのが、無理のないロードマップになります。
振り返りとナレッジ蓄積の機能
恒久対策と並ぶ調査の出口機能が、振り返り(ポストモーテム)とナレッジ蓄積です。一つの障害を収束させたら、なぜ起きたか、なぜ検知が遅れたか、どうすれば防げたかを関係者で振り返り、得られた知見を記録に残します。
この記録が障害管理台帳やナレッジベースとして蓄積されると、調査の成果が組織の資産になります。次に似た症状が出たとき、過去の調査結果を参照すれば、原因にたどり着く時間を大幅に短縮できます。ナレッジが増えるほど、属人化から脱して、誰が担当しても一定の質を保てます。
過去の事象・原因・対策を検索できる仕組みは、経験の浅い担当者にとっての教科書にもなり、調査力の底上げにつながります。riplaはフルスクラッチ受託と国内運用保守の立場から、調査して終わりにせず、振り返りとナレッジ化までを運用に組み込む進め方を重視しています。
まとめ
ITシステム原因調査が提供する機能は、四つの層で構成されています。検知から切り分けまでの基盤機能と、ログ収集・相関分析の機能が調査の入口を作ります。さらに、再現・影響範囲特定の機能と、恒久対策・AIOpsによる自動化機能が、その後の対応を支えます。
具体的には、死活・リソース監視が入口を作り、ZabbixやDatadog、SIEMのSplunk Cloudがログと相関の分析を支えます。検証環境が再現を可能にし、AIOpsが予兆検知で調査負荷を下げます。
費用は、監視で月5万〜20万円、24時間障害対応で月10万〜20万円が目安です。機能の範囲が、そのまま料金に直結します。
機能を見るときに大切なのは、「検知・分析・再現・対策」が切れ目なくつながっているかという視点です。どれか一つが欠けると調査は途中で止まり、損失が膨らみます。自社で持つべき機能と外部に委ねる機能は、この流れに照らして切り分けてください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムの内部を知る当事者として、検知から恒久対策までの調査機能を一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。