
ITシステムの原因調査を外部に委託するときは、RFP(提案依頼書)や要件定義書に、調査範囲と応答・復旧時間を数値で書き込みます。ログ・監視項目も、同じように数値で定めます。契約と体制の条件も、あわせて書き込みます。
数値がないと、見積もりを比べられません。隠れコストを潰す契約・体制要件は、リサーチで得たSLA実値や費用相場とあわせて掘り下げます。全体像をまだ把握していない方は、まずITシステム原因調査の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
調査範囲と責任分界点を定義する要件
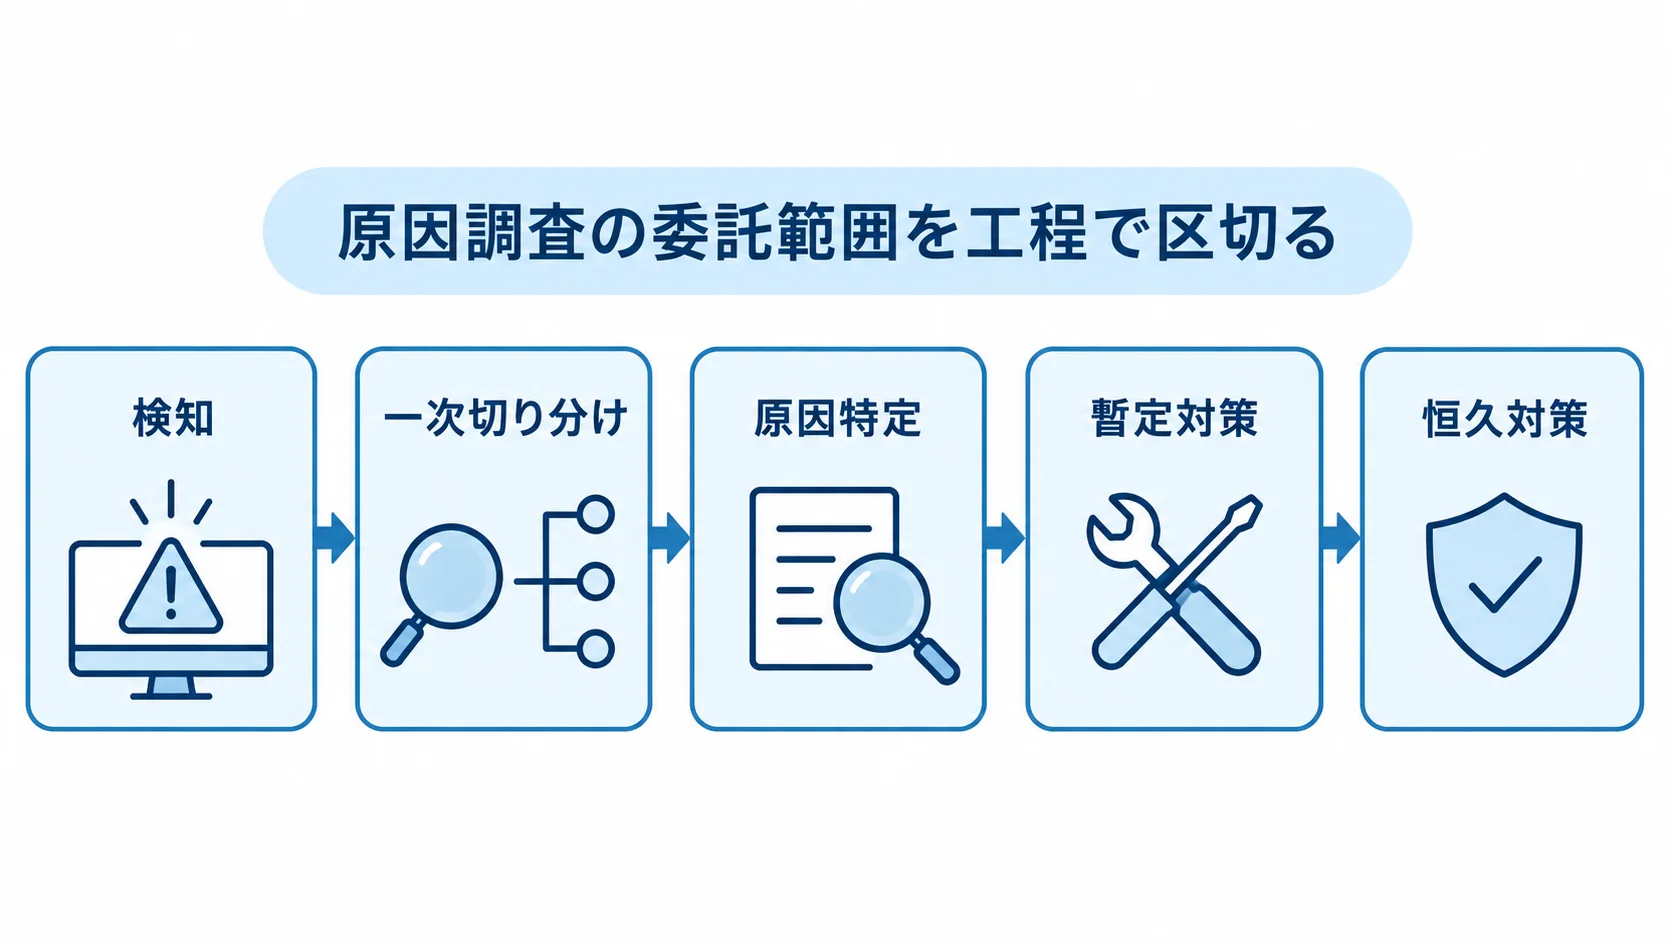
RFPでまず明確にすべきは、原因調査をどこからどこまで委託するかという範囲と、発注側とベンダーのどちらが何の責任を負うかという責任分界点です。ここが曖昧だと、障害の発生時に「それは契約範囲外です」という食い違いが起き、肝心なときに調査が止まってしまいます。そのため、範囲と分界点を工程と層の両面から定義しておく必要があります。
一次切り分けから恒久対策までの範囲定義
原因調査の範囲は、検知、一次切り分け、原因特定、暫定対策を確認したうえで、恒久対策までの工程ごとにどこまでを委託するかを明記します。たとえば「一次切り分けと原因特定まではベンダー、恒久対策の実装は別途見積もり」のように、工程の境界を数値や具体例で示します。
範囲を曖昧にすると、ベンダーは安全側に狭く見積もり、いざ恒久対策が必要になったときに高額な追加費用を請求される、という事態を招きます。
また、費用の目安として、障害対応は営業時間内なら月3万〜8万円、24時間緊急対応なら月10万〜20万円、スポット1件なら3万〜10万円です。範囲が明記されていれば、この相場のどこに位置する見積もりかを判断できます。
そのうえで、月額の固定費にどの工程まで含むのかを、RFPの段階で工程表として示させることが、後の認識のずれを防ぐ最良の方法です。工程ごとに納めるもの(調査報告書、恒久対策の設計書など)を明記しておくと、各工程が完了したかを客観的に判定できます。さらに、対価の妥当性も評価しやすくなります。
工程の境界は、委託の終わり目と完了の判定の二つで押さえます。
- 委託の終わり目:恒久対策を委託に含めるか、別途見積もりとするか
- 完了の判定:各工程の区切りをどこに置き、どの書面で確かめるか
クラウド責任共有モデルを前提にした分界点
クラウド基盤を使っている場合は、責任分界点の定義がいっそう欠かせません。クラウドの責任共有モデルでは、基盤そのものの障害はクラウド事業者が責任を負い、利用者側は手を出せません。
RFPでは、「クラウド基盤に起因する障害はどう扱うか」「事業者からの情報をどう収集し、どう報告するか」を明記して、調査範囲の境界を引く必要があります。
国内エンタープライズ市場では、2022年時点でクラウドの比率が約5割(IDC Japan)に達しています。特に、この前提整理は多くの企業にとって欠かせません。
責任分界点を引くときは、アプリケーション層から基盤層まで、ベンダーがどこまで調査するかを層ごとに整理します。どこからがクラウド事業者の領域かも、同じ整理のなかで示しておきます。
この切り分けがないと、基盤側の障害なのに自社のベンダーが原因を追い続け、時間を浪費するといった非効率が起きます。
範囲と分界点の定義は、原因調査RFPの土台です。ここを曖昧にしたまま発注すると、後で後悔することになります。
クラウド基盤については、基盤障害の扱いと事業者との連絡を、RFPで先に定めておきます。
- 基盤障害の扱い:クラウド基盤の障害を、調査範囲のどちら側に置くか
- 事業者との連絡:クラウド事業者から得る情報の入手方法と、報告の流れ
複数ベンダーが絡む場合の調整役の要件
実際の現場では、複数のベンダーが一つのシステムに関わることが珍しくありません。開発元やインフラ事業者のほか、ネットワーク事業者やパッケージ提供元が加わる場合もあります。
障害が起きたとき、各社が「うちの領域ではない」と主張し合うと、原因調査が宙に浮き、復旧も大幅に遅れます。そのため、RFPでは「誰が全体の調整役を担い、各社の調査を取りまとめるか」を要件として定義しておく必要があります。調整役が不在のまま発注すると、障害時に発注側が各社の板挟みになります。
この調整役には、システム全体の構成を把握し、各層の切り分けを主導できる立場のベンダーが適しています。
RFPに「他ベンダーとの情報連携の手順」「障害時の合同対応の進め方」を書き込んでおけば、各社が責任を押し付け合う事態を防げます。
riplaはフルスクラッチ受託の立場からシステム全体の構造を把握しているため、複数ベンダーが絡む障害でも、作った当事者として調査の取りまとめ役を担えます。調整役の要件は、マルチベンダー環境で原因調査が空転しないようにするための、見落とせない契約項目です。
調整役は、任命と合同対応の手順の二点をRFPに書き込みます。
- 調整役の任命:全体の取りまとめを担う会社を、RFPの段階で決めておく
- 合同対応の手順:障害時に各社が同じ場で動くための段取り
応答・復旧時間とSLAの数値要件
原因調査RFPの核となるのは、応答時間・復旧時間・稼働率といったSLA(サービス品質保証)の数値要件です。これらを具体的な数字で定義すると、提案の質を客観的に比べられます。応答・復旧の時間要件と稼働率の要件は、それぞれ数値で定めます。
初報応答と復旧目標時間の具体的な数値
重要なシステムほど短い応答を求めたくなりますが、短くするほど費用は上がります。
原因調査の場合は、原因特定までの目標と、対策完了までの目標を切り分けて要件化します。そうすると、調査の遅延と復旧の遅延を別々に評価できます。数値があってこそ、SLA未達時のペナルティも設計できます。
初報と復旧は、それぞれ別の目標時間を立ててRFPに書き込みます。
- 初報の時間:障害検知から一次対応開始、初報の報告までの目標時間
- 復旧の目標:暫定復旧と完全復旧を分けた、それぞれの目標時間
実例として、官公庁の仕様では「1時間以内に現地到着・対処開始」「1時間以内に内容と予想作業時間を報告」とされています。また、Cloud Naviは重大インシデントに15分以内の一次対応を保証しています。自社の業務影響に照らして、この水準のどこを求めるかを決めます。
一般的な目標としては「重大障害は2時間以内に対応開始、完全解決は24時間以内」とされ、シーズホスティングの例では、検知から60分以内に通知し、12時間で復旧するという水準もあります。
SLA未達時のペナルティと測定基準の要件
応答・復旧の数値目標を定めたら、それを達成できなかったときの取り扱いを要件として明記します。多くの契約では、SLA未達時にサービスクレジット(保守費の一部減額)が適用されますが、その算定方法や上限が曖昧だと、いざというとき機能しません。
ベンダーには、どの目標を、どの程度下回ったら、いくら減額するかを提示させます。保証型の水準を求めるのか、努力目標型で足りるのかは、事業影響度に照らして線引きします。ペナルティまで設計して、初めて数値要件は実効性を持ちます。
あわせて、応答時間や復旧時間をどの時点から計測するかという測定基準も要件化します。同じ目標値でも、起点によって実質的な厳しさが変わるためです。
月次でSLAの達成状況を報告させる運用を要件に含めておけば、契約後も品質を客観的に監視できます。
原因調査は工数が読みにくいだけに、測定基準とペナルティを曖昧にすると、未達かどうかの判定で揉めて形骸化しがちです。だからこそ、ここを数値と起点で明確に固めることが、SLAを形だけのものにしないための要点になります。
測定基準は計測の起点を、未達時の扱いは減額の算定方法と上限を、RFPで固めておきます。
- 計測の起点:障害の検知時刻と、利用者からの報告受付時刻のどちらを使うか
- 未達時の扱い:下回った幅に応じた減額の算定方法と上限
稼働率の要件と過剰SLAの回避
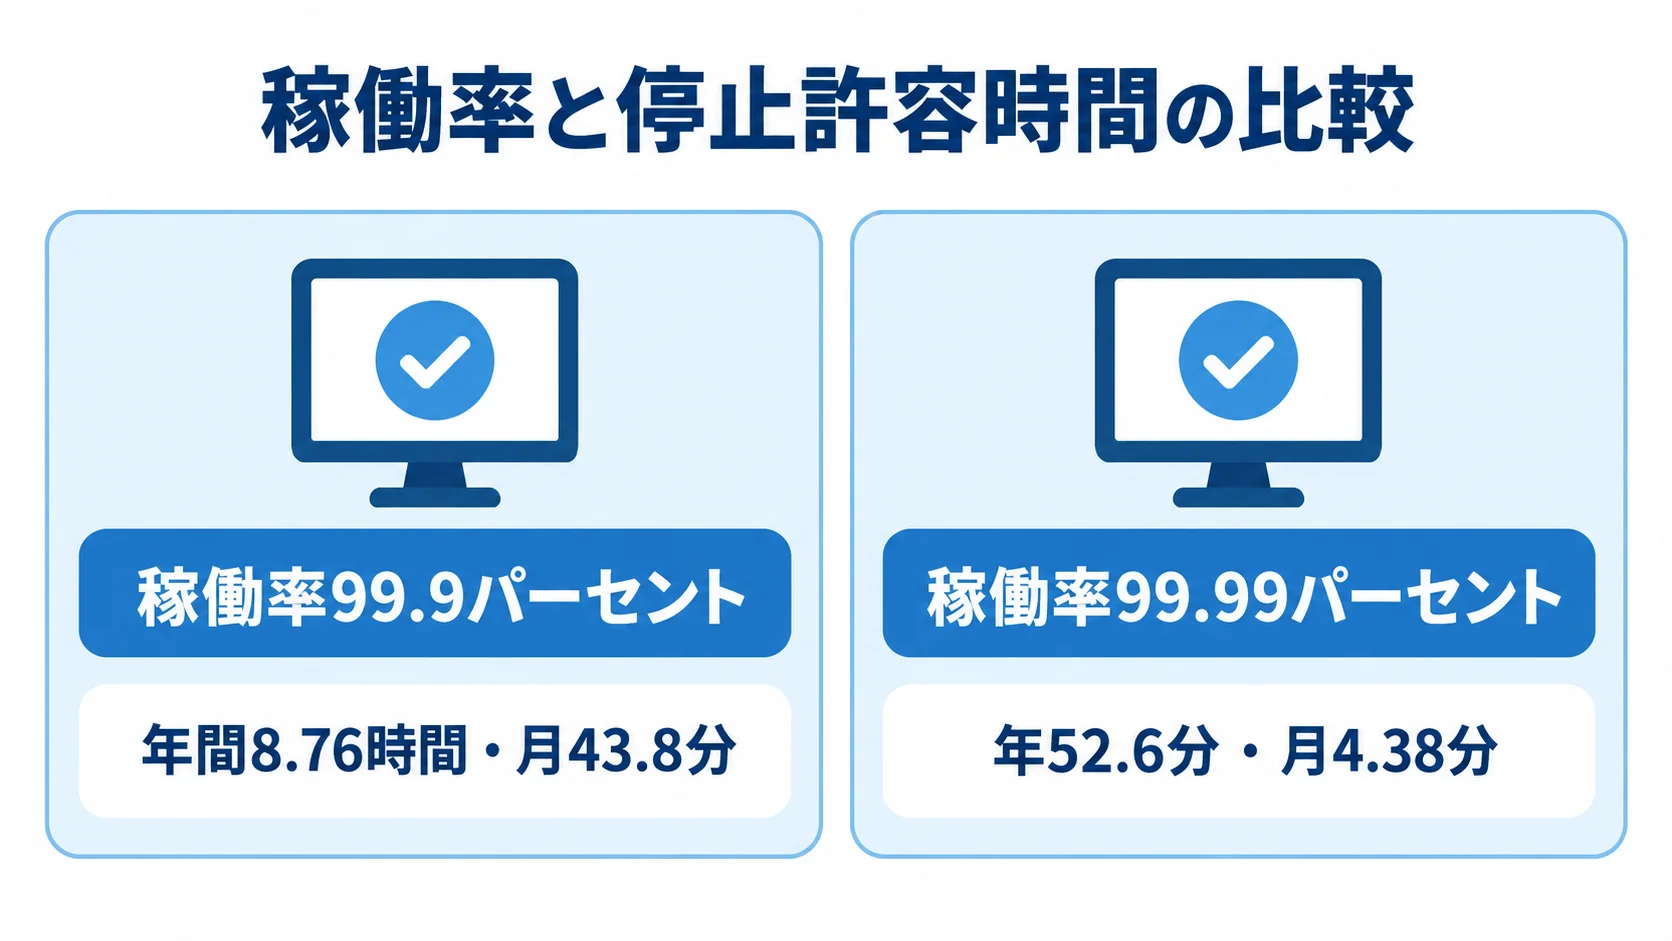
稼働率の要件は、求める「9」の数で費用が段階的に跳ね上がる点に注意が必要です。稼働率99.9パーセントは年間8.76時間・月43.8分の停止を許容するのに対し、99.99パーセントは年52.6分・月4.38分まで厳しくなります。
「9」が一つ増えるごとに運用コストは上がります。そのため、自社の業務に本当に必要な水準を見極めることが、要件定義の腕の見せどころです。
過剰なSLAは無駄な費用を生みます。そこで、事業影響度を評価し、「このシステムは月数十分の停止なら許容できる」と判断できれば、99.9パーセントで足りるケースが多くあります。
RFPでは、稼働率の要件と、その根拠となる事業影響度の評価を併記すると、ベンダーも適正な提案をしやすくなります。riplaはフルスクラッチ受託の立場から、システムの重要度に応じた適正なSLA設計を一緒に検討し、過剰でも過少でもない要件づくりを支援します。SLAは、事業に見合う水準であることが肝心です。
稼働率は、目標の水準と、その根拠となる事業影響度の評価をセットで書き込みます。
- 目標の水準:求める稼働率の桁と、それに応じた運用費の変化
- 根拠の併記:事業影響度の評価を、稼働率の要件と並べて示す
ログ・監視項目と調査基盤の要件
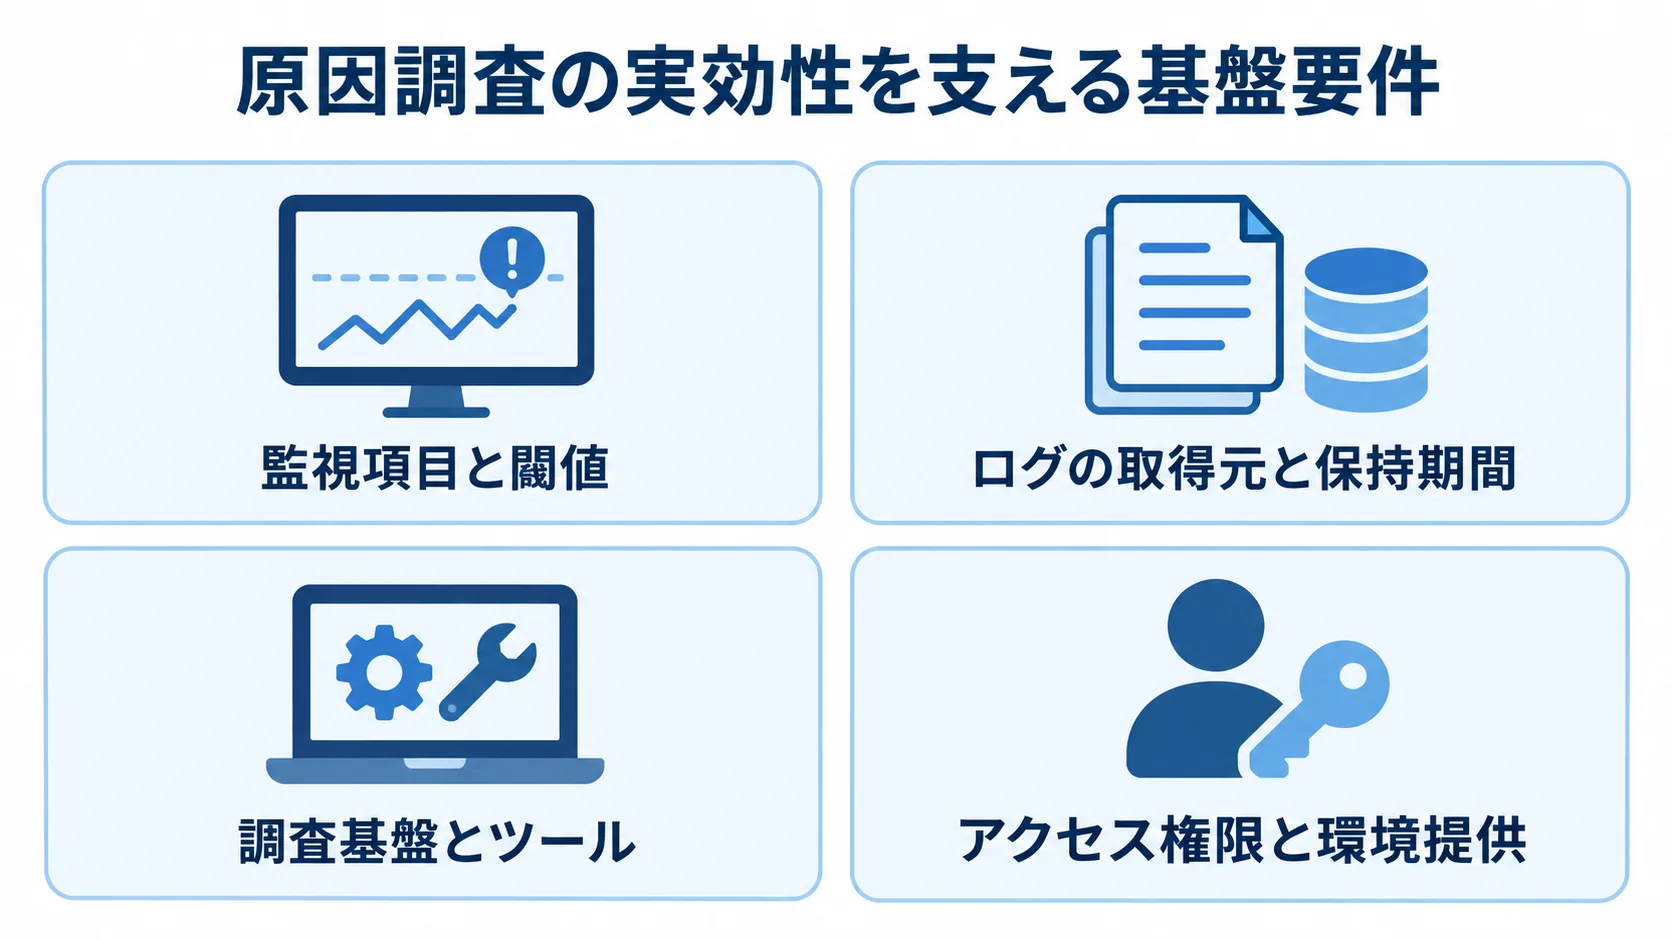
原因調査の精度は、どのログをどう取得し、何を監視するかという基盤の要件で決まります。調査に必要なデータが残っていなければ、どんな優秀な担当者でも原因にたどり着けません。
監視項目と閾値、調査基盤とツールの要件を定めるとともに、調査に必要なアクセス権限も決めます。
監視項目・閾値・ログ保持期間の要件
RFPには、監視する項目と異常と判断する閾値を具体的に書き込みます。調査の手がかりになる指標は、CPU使用率やメモリ使用率のほか、ディスク残量、レスポンスタイム、エラー率などを網羅します。
また、それぞれ何パーセントや何秒を超えたらアラートを上げるかを数値で定めます。あわせて、ログをどこから集め、どのくらいの期間保持するかも要件化します。ログの保持期間が短いと、後から原因を追えなくなるためです。
IBMの2024年調査では、データ漏洩の検知まで平均204日かかるとされています。このため、長期のログ保持は、原因調査と侵害検知の両面で役立ちます。
監視項目と閾値、保持期間を要件として固めておけば、調査に必要なデータが確実に残り、いざというときに過去にさかのぼった分析ができます。「何を見て、何を残すか」を定めることが、調査の可否を左右する根幹の要件です。
逆に、必要な監視項目やログが取得されていない状態で発注すると、いざ障害が起きても手がかりが残っておらず、調査自体が成立しないという事態を招きます。
監視では、指標ごとの閾値と、ログの取得元・保持期間を要件として固めます。
- 閾値とアラート:指標ごとの警告の基準値
- ログの取得元と保持期間:取得元と保持期間を、数値とともに決めておく
監視ツール選定基準と調査基盤の要件
調査基盤として、どの監視ツールを使うかの選定基準もRFPに含めます。選定では、既存資産との親和性も判断材料にして、ツールの要件を整理します。OSSのZabbixはライセンス費がかからず柔軟ですが、構築と維持に工数がかかります。
クラウド型のDatadogやNew Relicは、ホスト数やメトリクス量に応じた従量課金です。
ベンダーが特定ツールに縛られず提案できるよう、満たすべき機能要件を中立的に書くのがコツです。セキュリティ起因の障害も視野に入れるなら、SIEMのSplunk CloudやEDRのCrowdStrike、Microsoft Defender for Endpointといった製品への対応可否も、選定基準に加えます。
SOC運用を併せて委託する場合は、対象台数あたりの料金感を把握しておくと役立ちます。例として、CEC SOCは月30万円〜/1,000台、SHIFTのSOC運用支援はシルバーで月9万円〜という水準があります。
こうした料金感を知っておくと、見積もりの妥当性を判断できます。調査基盤の要件は、原因調査の実効性を担保する重要な項目です。
監視ツールは、形態とセキュリティ製品への対応可否の二点から選定基準を立てます。
- ツールの形態:OSSかクラウド型か、自社の規模と運用体制に合うもの
- セキュリティ製品:SIEMやEDRへの対応可否
調査に必要なアクセス権限と環境提供の要件
見落とされがちなのが、ベンダーが原因調査を行うために、発注側が何を提供するかという要件です。ログへのアクセス権限、監視ダッシュボードの閲覧権、検証環境、本番への接続経路などが該当します。
また、調査に必要な環境を誰がどう用意するかを定義しないと、いざ調査というときに「権限がなくてログを見られない」という空白が生じます。とくにクラウド環境では、監視情報やアクセスログにベンダーが到達できるかが、切り分けの速さを左右します。提供物の要件を明記することは、調査の実効性の前提です。
一方で、権限の付与はセキュリティと切り離せません。本番環境への広範なアクセスを安易に渡すと、それ自体が情報漏洩や誤操作のリスクになります。
そこでRFPでは、調査に必要な最小限の権限を、必要な期間だけ付与する運用や、操作ログを残す前提を要件として盛り込みます。アクセス権限と環境提供の要件は、調査の速さとセキュリティのバランスを取る設計であり、発注側の責任範囲として事前に詰めておくべき項目です。ここを曖昧にすると、緊急時に権限調整で時間を浪費し、せっかくのSLAも活かせません。
アクセス権限と環境は、誰が環境を用意するかと、調査の操作をどう残すかを定めます。
- 提供の責任:誰が、どの環境を用意するか
- 操作の記録:調査で行った操作を、後から追える形で残す
隠れコストを潰す契約・体制要件
RFPの最後に詰めるべきなのは、見積もりに表れにくい隠れコストを防ぐ契約と体制の要件です。基本料金は安く見えても、対応範囲外の作業や工数上限の超過で追加費用がかさむと、結局は割高になります。そのため、追加費用の線引きと、体制や引き継ぎの要件を定めておく必要があります。
工数上限と追加費用の線引きを明記する要件
月額固定の契約では、基本料金に含まれる工数上限と、それを超えた場合の単価を明記させます。
原因調査は障害の難度によって工数が読みにくいため、「月◯時間まで含む、超過分は人月単価◯◯万円」という形で線引きを要件化します。
「安すぎる見積もり」には、対応範囲が狭い、SLAがない、工数上限が極端に低いといった落とし穴が潜みます。
RFPで範囲、SLA、工数上限を数値で定義していれば、安さの裏にあるリスクも見抜けます。隠れコストは、要件の曖昧さから生まれます。
曖昧さを潰すことが、最良のコスト管理です。とくに原因調査は工数が事前に読みづらい領域だけに、線引きの一文があるかないかで、年間の総支払額が変わってきます。
追加費用の線引きでは、超過単価の上限と、各社の前提がそろっているかを確かめます。
- 超過単価:人月単価の上限を、職種ごとの相場と照らして確かめる
- 前提の揃い方:範囲、SLA、工数上限が、各社の見積もりにそろっているか
人月単価の相場は業界一般で60万〜150万円、監視オペレーターで60万〜80万円、運用設計・インシデント分析で80万〜120万円が目安です。
体制・エスカレーションと引き継ぎの要件
原因調査は時間との勝負であり、夜間や休日に連絡がつかなければ意味がありません。そのため、24時間365日の対応体制を求めるか、営業時間内に限るかを明記し、その違いに応じた費用を見積もらせます。
報告の形式や頻度も要件に含めておくと、障害時の情報共有が円滑になります。そのうえで、社内の経営層や業務部門への二次連絡もスムーズに進みます。
将来ベンダーを切り替える場合に備えて、調査手順書や監視設定、アカウント情報、ソースコードの引き渡し方法を契約に盛り込みます。解約予告期間も定めておくと、特定ベンダーへの過度な依存を避けられます。
riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った当事者として、透明性の高い体制と引き継ぎ可能なドキュメントを重視しています。また、隠れコストの少ない原因調査の要件づくりを支援します。要件定義の丁寧さが、長期の運用コストを左右します。
体制では連絡の体制を、引き継ぎでは依存の回避を、契約の段階で定めておきます。
- 連絡の体制:一次対応の担当、エスカレーションの基準、対応する時間帯
- 依存の回避:将来ベンダーを切り替えられる状態を、契約の段階で確保する
まとめ
ITシステム原因調査のRFPや要件定義書では、工程ごとの範囲とクラウド責任共有の分界点を先に引きます。そのうえで、初報は15分から1時間、復旧は2時間から24時間といった数値でSLAを定めます。要件は四つの柱で構成されます。範囲と分界点、SLAが中心になります。残りの柱は、ログ・監視項目と調査基盤、隠れコストを潰す契約・体制要件です。
隠れコストを防ぐ契約・体制の条件も、あわせて定めます。また、監視項目・閾値・ログ保持期間とツール選定基準を固め、工数上限と引き継ぎを契約に盛り込みます。これらを数値で定義すると、見積もりの比較と妥当性の判断がしやすくなります。
要件定義で大切なのは、「曖昧さこそが隠れコストとトラブルの源」という認識です。そのため、範囲・時間・項目・契約をすべて数値と具体例で書き切れば、ベンダーは同じ前提で提案でき、発注側は安さの裏のリスクを見抜けます。
まずは自社の重要システムについて、許容できる停止時間とログ保持期間を決めることから始めてください。riplaはフルスクラッチ受託と国内運用保守を組み合わせ、システムを知る当事者として適正なSLA設計と要件づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。