
原因調査は、進め方を誤ると障害が長引き、信頼を損ない、再発を繰り返すことになります。典型的な失敗は、監視と見積もりに潜むものと、発注側の初動や丸投げに関わるものに分かれます。
どれも事前に知っておけば避けられるものがほとんどです。全体像が分からない方は、まずITシステム原因調査の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視のブラックボックス化という落とし穴
近年もっとも増えている失敗が、クラウドやSaaS化に伴う監視のブラックボックス化です。基盤を外部に預けると内部で何が起きているかが見えにくくなり、障害が起きても調査の手がかりが得られません。その理由は、クラウド基盤そのものの見えなさと、自社側の自衛策の不足にあります。
クラウド基盤障害は手出しできないリスク
クラウドやSaaSでは、基盤そのものの障害を利用者側で調査することも対処することもできません。復旧はクラウド事業者を待つしかなく、補償もサービスクレジット止まりで、機会損失は補填されないのが通例です。さらに厄介なのは、基盤障害なのか自社アプリの問題なのかを切り分けること自体が難しくなる点です。
国内エンタープライズ市場のクラウド比率は2022年時点で約5割(IDC Japan)に達し、この「手出しできない領域」を抱える企業は急増しています。基盤障害のとき、自社では何も調べられないという無力感こそが、ブラックボックス化の本質的なリスクです。
可観測性が低いまま運用していると、「クラウドのせいだ」と思い込んで自社側の原因を見逃したり、逆に、自社の問題だと思い込んでクラウド側の原因を見逃したりします。加えて、切り分けが曖昧なままだと、調査の出発点が定まらず、復旧が遅れます。クラウド化は運用を楽にする一方で、調査の見通しを悪くするという副作用があるのです。
可観測性とアーキ設計による自衛策
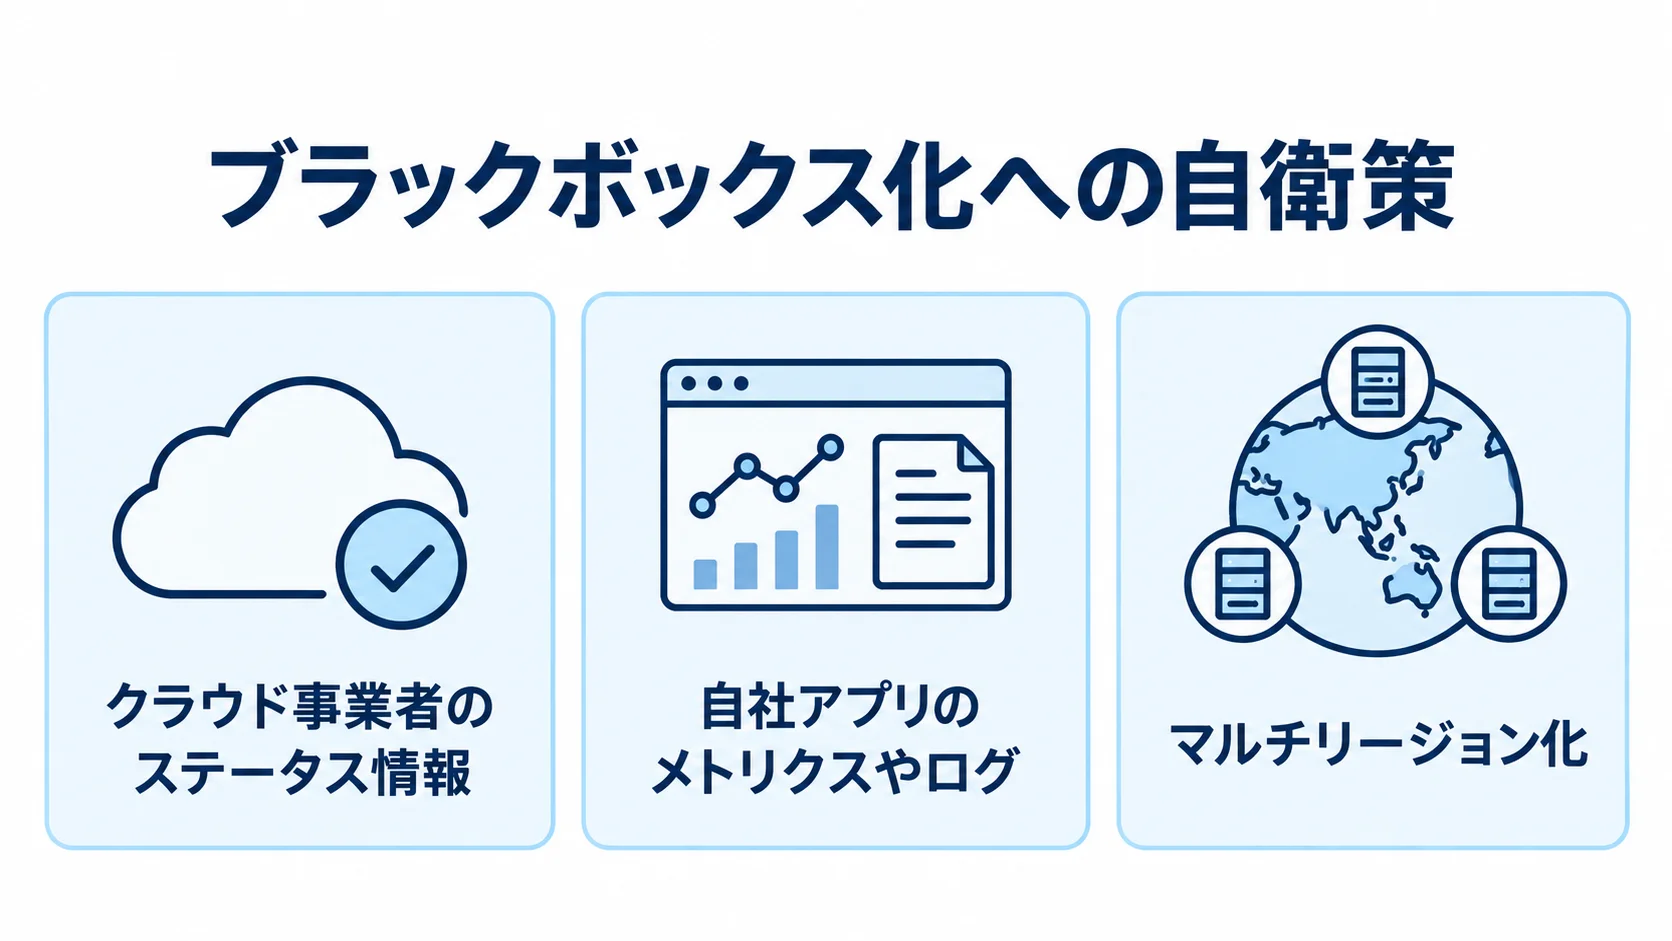
ブラックボックス化への自衛策は、自社側で取れる可観測性を最大限に確保することです。クラウド事業者のステータス情報と、自社アプリのメトリクスやログを平常時から集めておき、切り分けの手がかりを蓄えます。DatadogやNew Relicのような可観測性ツールで、クラウド基盤と自社アプリの両方を横断して見られるようにすることが、調査の見通しを取り戻す第一歩です。
アーキテクチャ面では、マルチリージョン化などで単一基盤障害の影響を減らす設計も有効です。一つのリージョンが落ちても別のリージョンで継続できれば、基盤障害を事業停止に直結させずに済みます。ただし、冗長化には隠れコストが伴うため、事業影響度に見合う範囲で選びます。
riplaはフルスクラッチ受託の立場から、可観測性を組み込んだ設計と過剰にならない冗長化のバランスを一緒に検討し、ブラックボックス化のリスクを抑える支援をします。見えないものは調査できないため、見える設計を最初から仕込むことが肝心です。
SaaS連携先の障害が連鎖するリスク
外部依存が増えるほど、このリスクは自社のクラウド基盤だけにとどまりません。決済や認証、メール配信、地図といった外部SaaSをAPIで連携している場合、連携先が障害を起こすと自社システムも巻き添えで止まります。連携先の内部は見えないため、調査では「自社が悪いのか、連携先が悪いのか」の切り分けに時間を取られます。
備えとして、連携先の障害を前提に、連携先ごとの「障害時の挙動」を設計しておきます。連携先が応答しないときはタイムアウトで安全に切り離し、一部機能を縮退させて主要業務だけは継続する、といったフォールバック(代替動作)を組み込めば、外部障害の影響を局所化できます。あわせて、各SaaSのステータス情報も監視に取り込み、切り分けを素早く行える体制を作っておきます。
外部依存は便利さと引き換えに見えない領域を増やします。そのため、連携先の障害を前提にした設計で、ブラックボックスの連鎖を断つことが肝心です。
安すぎる見積もりに潜むリスク
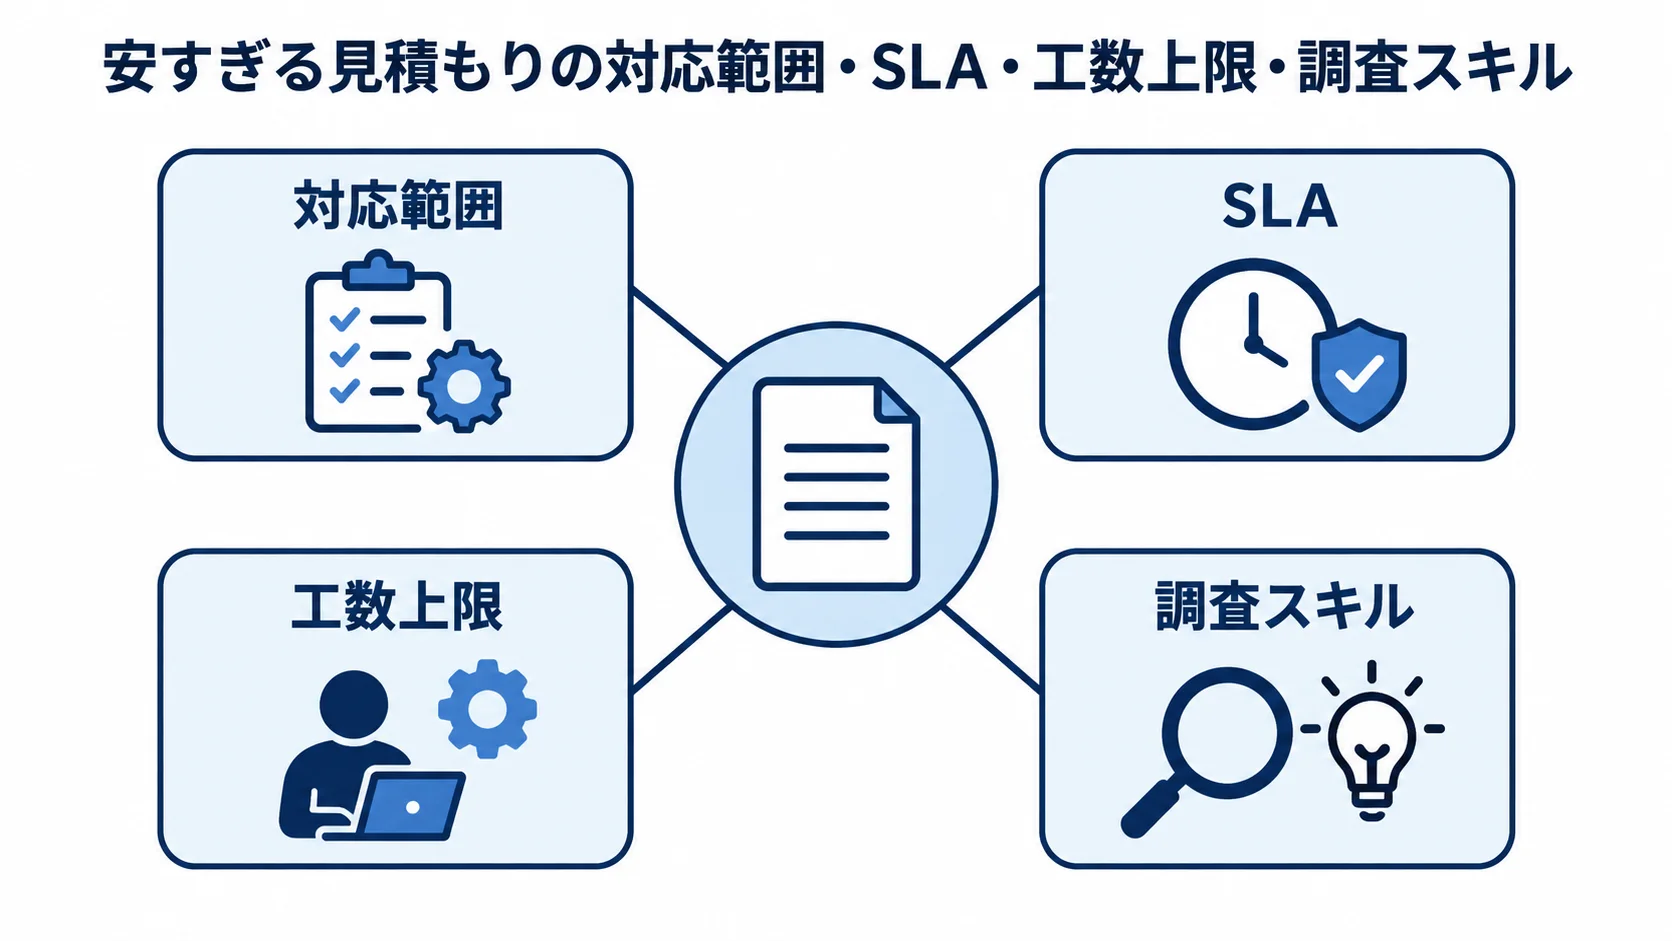
原因調査や監視を委託するとき、つい飛びつきたくなるのが、他社より大幅に安い見積もりです。安さの裏には対応範囲の狭さやSLAの欠如が潜んでいることが多く、いざというときに調査が機能しないリスクがあります。
対応範囲とSLAが欠けた見積もりの危うさ
安すぎる見積もりの典型は、監視だけを請け負い、障害が起きても原因調査や復旧は契約外というケースです。料金は次のとおり段階的に上がります。
- 監視のみ:1台あたり月5,000円程度から可能
- 障害対応込み:1台あたり月10,000円
- フルマネージド:月20,000円
極端に安い見積もりには、障害対応や調査が含まれていないことが珍しくありません。
「アラートは上げるが、原因は追わない」体制では、肝心の調査が空白になります。SLAが定められていないことも危険です。応答時間や復旧目標が契約にないと、障害時に「いつ動いてくれるのか」が保証されず、対応が後回しにされても文句が言えません。
ダウンタイムは1分あたり5,600米ドル(Gartner 2024)の損失とされるため、SLAなしの安価な契約は、節約した費用を上回る損失を招きかねません。見積もりの安さは、対応範囲とSLAの中身を確認してから評価すべきです。
工数上限超過と隠れコストの罠
もう一つの罠は、工数上限が極端に低く設定された見積もりです。基本料金は安くても、調査に少し時間がかかると上限を超え、人月単価(業界一般60万〜150万円)で高額な追加費用が発生します。原因調査は障害の難度で工数が読みにくいため、上限が低いと毎回のように超過し、結果的に固定費の高い契約より割高になることもあります。
隠れコストは、見積もりの表面的な金額ではなく、含まれる範囲と超過条件に潜んでいます。基本料金だけで安さを判断すると、これを見落とします。この罠を避けるには、見積もりを「基本料金+含まれる工数上限+超過単価」のセットで比較し、月の調査工数と超過時の単価を明示させることです。安さに飛びつく前に、自社の障害頻度で年間どれだけかかるかを試算してみてください。
安さの裏にある調査スキル不足のリスク
金額の安さには、担当者の調査スキルが見合っていないという落とし穴もあります。原因調査はログの読み解きやシステム全体の構造理解を要する高度な作業で、経験の差がそのまま調査時間に表れます。
極端に安い見積もりでは、単価の安い経験の浅い担当者を当てている場合があります。その場合、肝心の障害で原因にたどり着けず、いたずらに時間だけが過ぎます。人月単価の相場(運用設計・インシデント分析で80万〜120万円)を大きく下回る金額には、その理由を確認すべきです。
平常時の定型監視は安い体制でも回りますが、スキル不足が表面化するのは、決まって難度の高い障害のときです。複雑な障害ほど熟練者の有無が復旧時間を分けるため、見積もりでは価格だけでなく、担当者の経験やエスカレーション先の技術者まで確認します。安さに惹かれて調査力を犠牲にすると、最も損失が膨らむ局面で頼りにならない体制を抱えることになります。
発注者側の初動失敗というリスク
原因調査の失敗は、発注者側の初動でも起きます。発注者である情報システム部門の初動が拙いと、調査が遅れて被害が拡大するケースも多くあります。
報告遅延とエスカレーション不全のリスク
発注者側の初動で多いのが、経営層や業務部門への報告の遅れで、信頼を損なう失敗になります。調査に没頭して報告を後回しにすると、経営層は状況を把握できず、業務部門も顧客対応の判断ができません。たとえば、官公庁の仕様例でも「1時間以内に内容と予想作業時間を報告」と定められており、初報は調査と同じくらい重要な初動です。
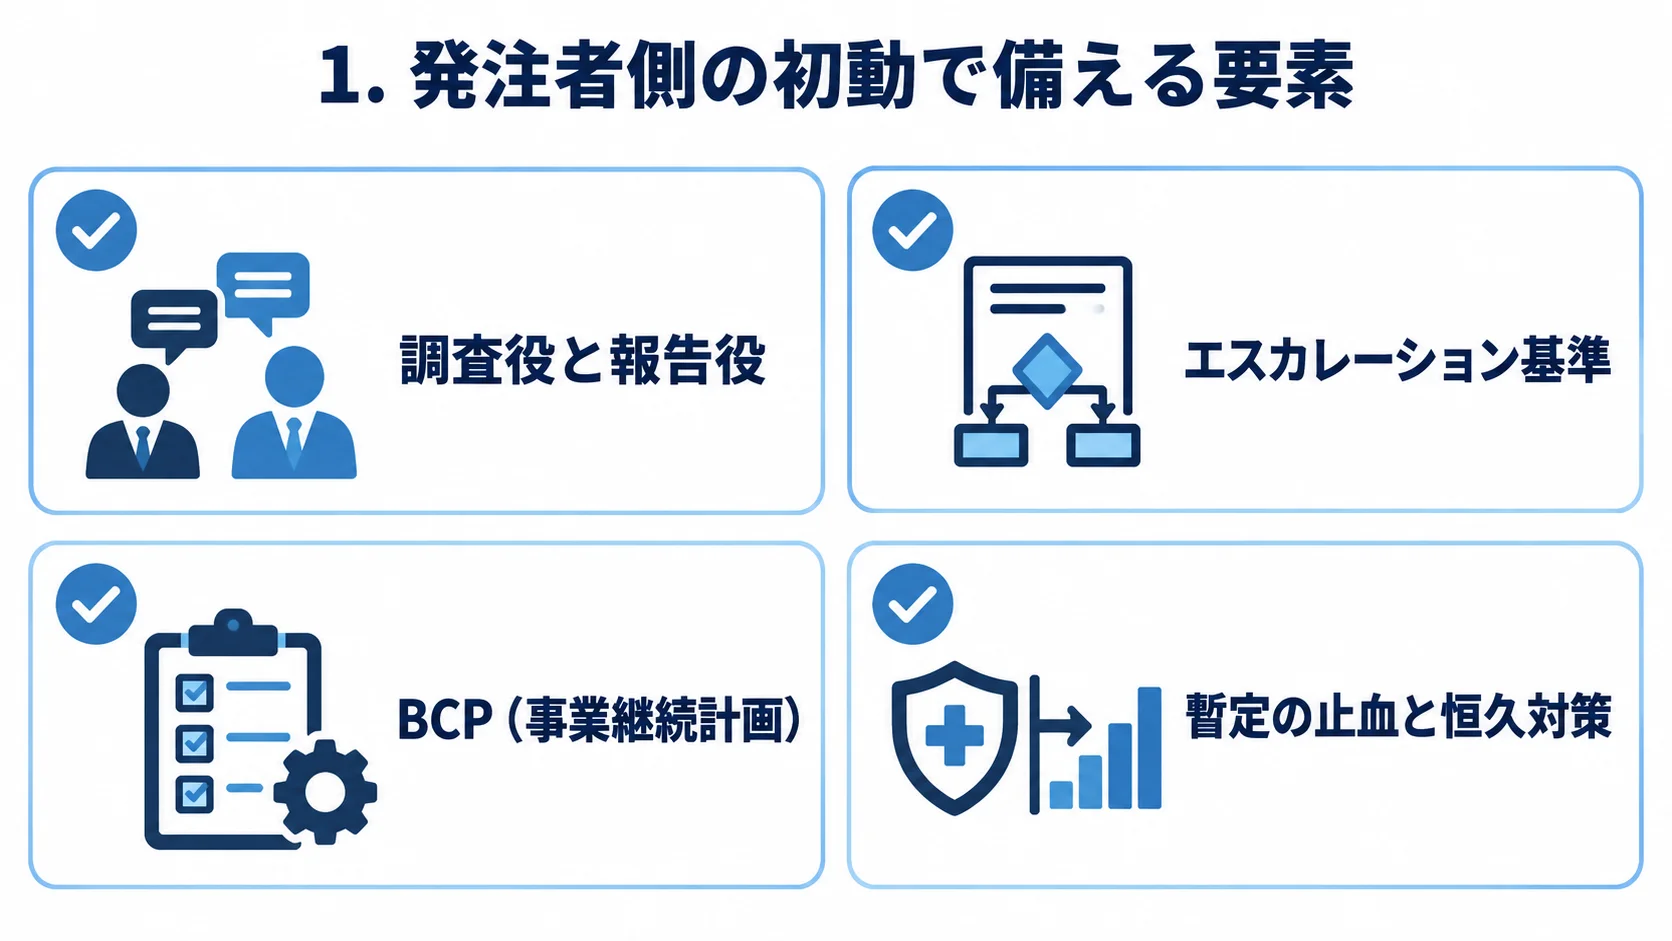
エスカレーションの基準が曖昧だと、どの障害を誰に上げるかが決まらず、現場が抱え込んで対応が遅れたり、些細な障害で経営層を巻き込みすぎたりします。そこで、調査役と報告役を分け、エスカレーション基準を事前に定めておくと、混乱を防げます。ベンダーに調査を任せても、社内への報告とエスカレーションは発注者の責任で、丸投げはできません。
BCP不在で復旧判断が混乱するリスク
BCP(事業継続計画)が整備されていないと、優先して復旧する業務や代替手段への切り替えを現場任せで判断することになり、混乱します。原因調査と並行して事業を続ける初動が描けないと、調査が終わるまで業務が止まり、損失が膨らみます。総務省の2025年版資料では、5分以上の停止1回あたり平均1,200万円の機会損失とされ、判断の遅れは金銭被害に直結します。
BCPと原因調査を連動させれば、調査で原因を追う間も、代替手段や縮退運転で業務を回し続けられます。「原因が分かるまで全停止」を避け、「止血しながら調査する」初動を平常時のBCPとして設計しておくのです。発注者側の初動の質はベンダーの調査力と同じくらい結果を左右するため、事前の役割分担とBCP整備で、初動失敗のリスクは大きく減らせます。
犯人捜しと拙速な対応で二次被害を招くリスク
発注者側の初動で陥りやすいのが、障害の最中に「誰のせいか」と犯人捜しに走ってしまうことです。原因が判明する前に責任を追及すると、現場は萎縮して情報を小出しにし、事実が集まりにくくなります。障害対応では、まず事実を率直に共有できる空気を保つことが原因究明の速さに直結します。
犯人捜しは収束後の振り返りで行うべきで、復旧の最中に持ち込むと調査そのものを妨げます。また、「とにかく早く直せ」という発注側の圧力が強すぎると、ベンダーが原因を十分に究明しないまま拙速に対応し、別の不具合を生む二次被害を招きます。
復旧の速さは確かに重要ですが、暫定の止血と恒久対策を分け、恒久対策はテストを通してから適用するという段取りを、発注側も理解しておく必要があります。焦りは調査の質を下げるため、速さだけを急かさず、「まず止血、原因は確実に」と臨めるかどうかが初動の分かれ目になります。
ベンダー丸投げの落とし穴
原因調査をベンダーに丸投げすることにも、リスクがあります。委託は有効な手段ですが、中身を一切把握しないまま任せきりにすると、ベンダーロックインや調査の停滞に陥ります。
ベンダー依存と社内知見喪失のリスク
調査を完全に丸投げすると、自社にノウハウが蓄積されず、システムの中身を理解する人が社内からいなくなります。そうなると、ベンダーの言うことを検証できず、提案が妥当かも判断できない依存状態に陥ります。過去には、現場の業務を起点に設計せず丸投げした結果、現場に合わないシステムができ、巨額の投資が無駄になった例もあります。
丸投げの本質的なリスクは、判断の主導権を失うことです。この依存を避けるには、調査結果を障害報告書として必ず受け取り、社内でレビューする習慣を持つことです。ベンダーが何を調べ、なぜその結論に至ったかを理解し続ければ、社内に最低限の知見が残ります。
委託しつつも当事者意識を保つことが、ベンダー依存のリスクを和らげる鍵です。任せることと放置は違います。
引き継ぎ困難でベンダーを変えられないリスク
丸投げが長期化すると、調査手順・監視設定・アカウント・ソースコードがすべてベンダー側に握られ、不満があっても切り替えられなくなります。引き継ぎ可能なドキュメントが残っていないと、別ベンダーへの移行は膨大な手間とリスクを伴い、結果として割高な現状維持を強いられます。解約予告期間や引き渡し条件を契約に入れていないと、この縛りはさらに強まります。
このリスクを避けるには、契約の段階で次の内容を明記しておくことです。
- 調査手順書の引き渡し
- 監視設定の引き渡し
- ソースコードの引き渡し
- 解約時の引き継ぎ義務
riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った当事者として透明性の高い調査と引き継ぎ可能なドキュメント整備を重視しており、ベンダー丸投げに陥らない伴走を心がけています。委託の利便性を享受しつつ、主導権と引き継ぎ可能性を手元に残すことが、原因調査の長期的なリスク管理の要諦です。
まとめ
ITシステム原因調査の失敗は、監視のブラックボックス化、安すぎる見積もりの罠、発注者側の初動失敗、ベンダー丸投げの落とし穴という四つの典型に集約されます。見えない領域は可観測性とアーキ設計で自衛し、見積もりは対応範囲・SLA・工数上限の中身で評価します。初動は報告・エスカレーション・BCPを事前に設計し、委託では主導権と引き継ぎ可能性を残して臨みます。
停止1回1,200万円、1分5,600米ドル、漏洩検知まで204日という統計が、これらの失敗が招く損失の大きさを物語っています。失敗から学ぶうえで大切なのは、これらのリスクはすべて事前の備えで回避できるという点です。見えない設計や安さへの飛びつき、報告の後回し、任せきりといった油断を避けるだけでも、原因調査の質は大きく変わります。
まずは、自社の監視に見えない領域がないか、契約にSLAと引き継ぎ条項があるかを点検してください。riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った当事者として透明性の高い調査と、リスクを抑えた伴走を一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。