
ITシステムの性能監視を強化したいと考えるときは、自社に近い事例を見るのが早道です。事例は、遅延の先回り解消、ひとり情シスの監視委託、監視の過不足の見直し、失敗からの立て直しの4つに分けて読むと分かりやすくなります。
本記事は、ITシステム性能監視の導入事例・開発事例・活用事例・成功事例を、発注企業(情シス)の視点から掘り下げる「事例特化」の解説です。性能監視の全体像をまだ把握していない方は、まずITシステム性能監視の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
レスポンス遅延を性能監視で先回り解消した事例
性能監視は、CPU使用率やメモリ、レスポンスタイムといった指標を継続的に見張り、ユーザーが体感する前に劣化の兆候を捉える取り組みです。何を、どの閾値で監視すれば成果につながるのかは、自社に近い導入事例を見ないと判断しにくいものです。
性能監視の効果がもっとも分かりやすく出るのは、「ユーザーが遅さを訴える前に劣化を検知し、先回りで手を打つ」という事例です。
多くの企業では、業務システムやECサイトのレスポンスが徐々に悪化していても気づかず、利用者からのクレームや問い合わせが増えて初めて事態を認識します。これは、性能を継続的に数値で監視できていないために起きる、典型的な後手の対応です。
レスポンスタイムの閾値検知でクレームをゼロにした事例
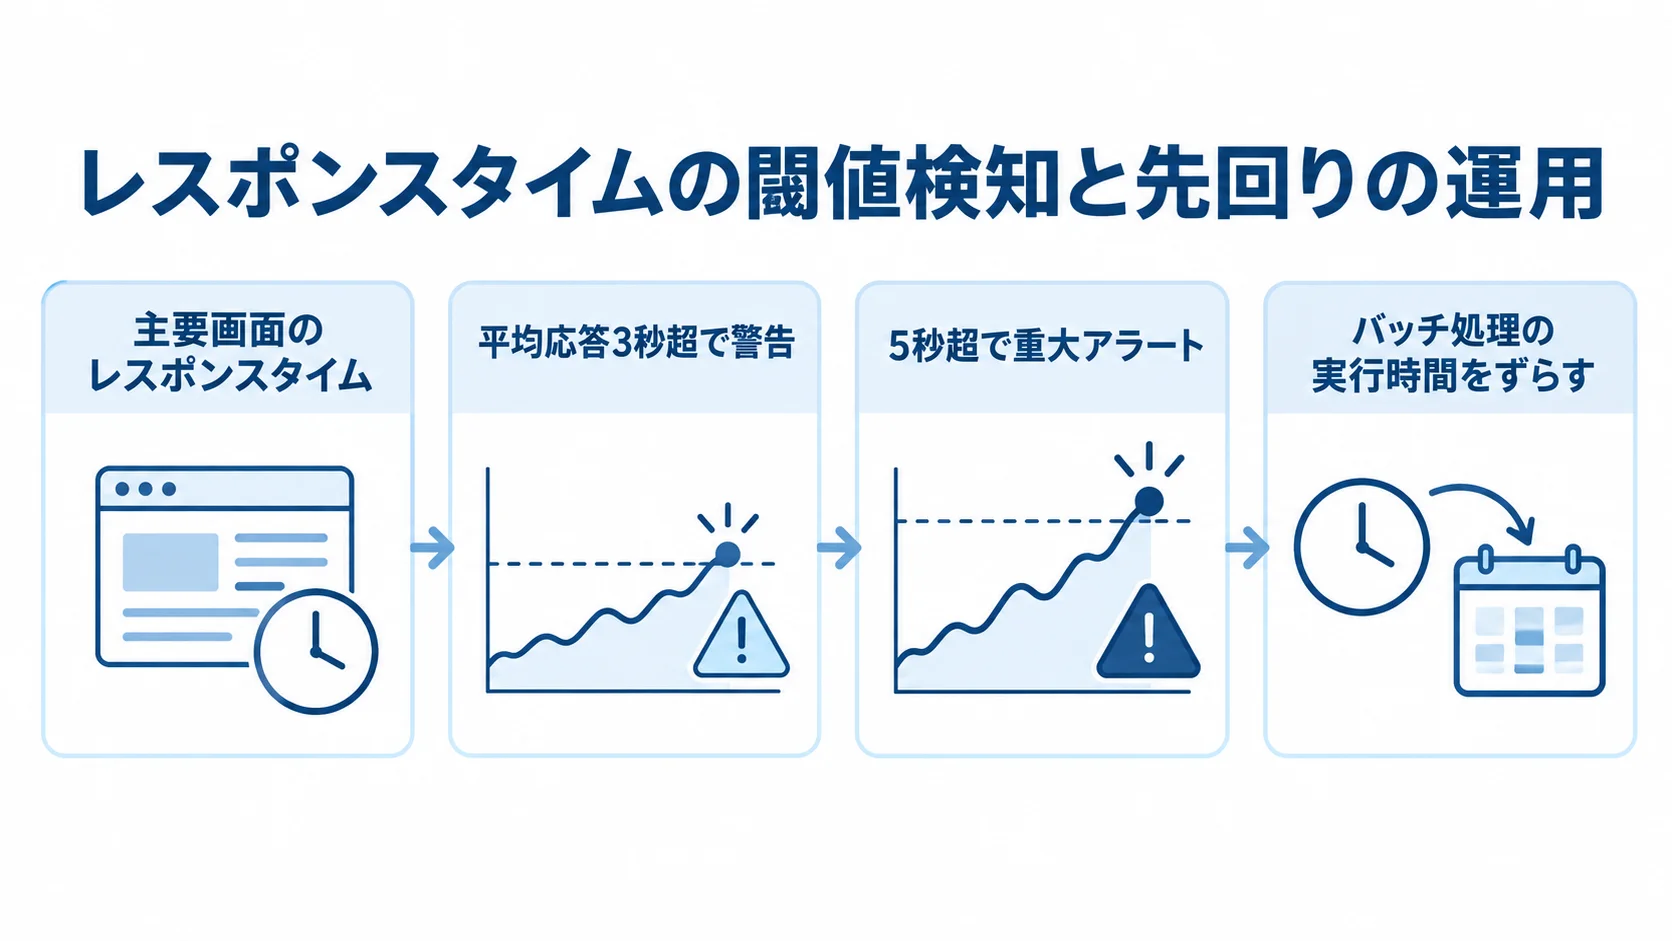
ある業務システムの事例では、ピーク時間帯に画面遷移が10秒以上かかるという利用者の不満が常態化していました。性能監視を導入して主要画面のレスポンスタイムを常時計測し、「平均応答3秒超で警告、5秒超で重大アラート」という閾値を設定しました。これにより、劣化の兆候を担当者がリアルタイムに把握できるようになりました。
閾値超過のアラートを受けると、ピーク前にバッチ処理の実行時間をずらす、不要なセッションを解放するといった先回りの運用を回せるようになりました。結果として、利用部門からの「重い」「固まる」という問い合わせは目に見えて減り、最終的にレスポンスに関するクレームはほぼゼロになりました。
性能監視の効果は、数値が一定を超えたら誰が何をするかまで決めて初めて現れます。監視で得た数値を放置せず、閾値を運用ルールと結びつけた点が、この事例の大きな違いです。この事例は、監視と運用の動きを一組で設計することの大切さを示しています。
成果につながったのは、計測と運用への接続の2つの要素です。
- 計測:主要画面の応答時間を、常時の数値として見える状態にする
- 運用への接続:アラートを合図に、ピーク前の処理や利用セッションを先回りで調整する
ボトルネックをリソース監視で特定し増設を最小化した事例
レスポンス遅延の原因は、サーバーの非力さ以外にも潜んでいます。ある事例では、性能劣化に対して当初「サーバーを増強すれば解決する」と考えていました。しかし、性能監視でCPU・メモリ・ディスクI/O・データベースのスロークエリを分解して見たところ、ボトルネックは特定のSQLクエリにあることが判明しました。リソース全体には余裕があるのに、一部の非効率なクエリが処理を詰まらせていたのです。
この事例では、闇雲なサーバー増設を避け、対象クエリのチューニングとインデックス追加だけで応答速度を大幅に改善できました。仮に原因を特定せずにハードウェアを増強していれば、年間で数十万円規模の余計なインフラ費用が発生していたはずです。
性能監視は、こうした「どこに本当のボトルネックがあるか」を数値で突き止め、過剰投資を防ぐ役割も果たします。リソースごとの内訳を並べて見ることで、的確で無駄のない改善につながります。
原因の見極めは、切り分けと増設の判断という2段階で進みます。
- 原因の切り分け:CPU、メモリ、ディスクI/O、スロークエリに分けて、原因を絞り込む
- 増設の判断:原因が特定のクエリにあるなら、サーバー増強より先にその改善を検討する
ひとり情シスが性能監視を委託しダウンタイムを減らした事例
中小企業では、情報システム部門が実質ひとりという「ひとり情シス」の体制がよく見られます。日中は社内のヘルプデスクや各種申請対応に追われ、夜間や休日にシステムの性能劣化が起きても気づけないという、構造的な弱さを抱えています。
この事例は、限られた人員で性能監視をどう成り立たせるかという、多くの企業に共通する悩みへの一つの答えを示しています。
24/365の性能監視を月額委託で実現した事例
この企業では、夜間バッチの遅延やメモリリークが原因で、明け方にサービスが止まることが月に数回ありました。出社してから障害に気づくという後手の対応が続いていました。そこで、24時間365日のリソース監視・死活監視・性能監視を、外部の運用保守サービスに委託しました。
一次データによれば、24/365の運用・監視(死活・リソース監視)の費用相場は月5万〜20万円程度です。たとえば、サーバー監視3万円に月次メンテナンス4時間で2万円を加えるといった構成が一般的です。
委託後は、明け方の障害がユーザーの始業前に解消されるようになり、ダウンタイムが大幅に縮小しました。
ひとり情シスが自社で24/365の当番体制を組むとすれば、監視オペレーターの人月単価60万〜80万円を複数名分抱える必要があります。そのため、この体制では現実的ではありません。月額数万円から十数万円で常時監視を確保できる委託は、費用対効果が極めて高いと言えます。
この体制は、夜間の一次対応と社内への連絡の2段階で組まれています。
- 夜間の一次対応:性能の閾値超過を、委託先のオペレーターが検知して一次対応を行う
- 社内への連絡:必要に応じて、ひとり情シスにエスカレーションする
属人化を解消し担当者の負担を軽減した事例
ひとり情シス体制のもう一つの大きなリスクが属人化です。閾値の設定やアラートの判断基準が担当者の頭の中にしかないと、その人が休んだり退職したりしたとき、誰もシステムの健全性を判断できなくなります。
この事例では、委託の際に運用の設計そのものを外部に引き継ぎました。このため、属人化のリスクを下げられました。
委託によって、担当者は本来注力すべきシステム改善やDX推進に時間を割けるようになっています。
委託は、貴重な社内人材を消耗から守り、より付加価値の高い業務へ振り向けるための投資でもあります。人手の限られた企業ほど、性能監視を自社だけで抱え込む前提を見直し、外部の運用力を組み合わせる選択肢を検討する価値があります。
引き継ぎは、何を外部に渡したかと、担当者の負担がどう変わったかの2点で見られます。
- 引き継ぐ内容:監視項目、閾値、エスカレーション手順を文書にまとめる
- 担当者の負担:夜間や休日の呼び出しへの備えを、外部の運用に任せる
過剰な監視・SLAを適正化しコストを削減した事例
性能監視は、手厚さよりも中身の釣り合いが問われます。事例の中には、必要以上に高い稼働率SLAや過密な監視項目を契約していたために、コストが膨らんでいたケースがあります。
重要なのは、システムごとの事業影響度に応じて監視の濃淡をつけ、過剰な部分を見直すことです。この事例は、監視の「足し算」だけでなく「引き算」にも成果があることを示しています。
稼働率99.99%から99.9%へ見直した事例
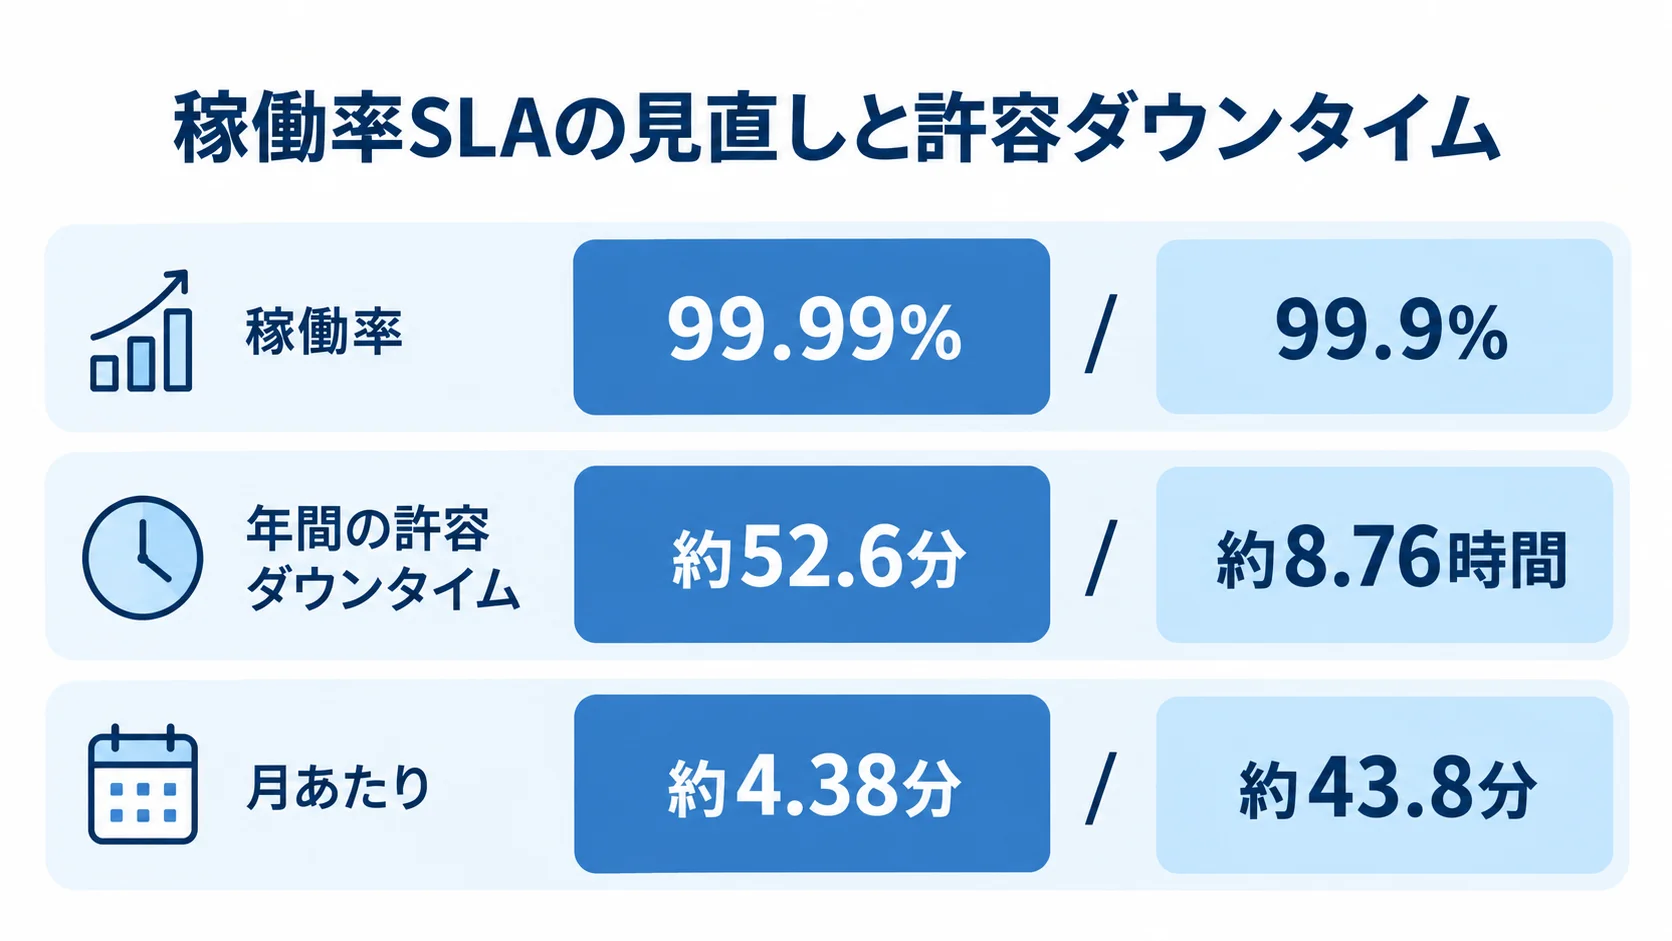
ある社内向けシステムでは、当初から稼働率99.99%を保証する手厚い監視契約を結んでいました。しかし、99.99%は年間の許容ダウンタイムが約52.6分、月あたり約4.38分という極めて厳しい水準です。達成には冗長構成と即応体制が必要になり、コストも跳ね上がります。一次データでも、稼働率の「9」が1つ増えるごとに、運用コストは段階的に跳ね上がるとされています。
この企業では、事業影響度アセスメントを行ったうえで、SLAを99.9%(年間許容約8.76時間、月約43.8分)へ見直しています。
これにより、監視や待機の体制を軽くでき、月額の運用費も相応に抑えられました。SLAは数値だけで決めず、事業影響度から逆算して選ぶと、無駄のない監視につながります。
見直しは、根拠の確認とビジネス部門との合意という2点で進められています。
- 見直しの根拠:対象が社内向けで、夜間の停止による業務影響が限られることを確認する
- 合意の中身:稼働率を下げる前に、停止時の困り方をビジネス部門と共有する
重要システムに監視リソースを集中させた事例
監視の適正化には、もう一つの事例があります。システムの重要度に応じて、監視リソースを配分し直したケースです。この企業では、すべてのシステムを一律に同じ密度で監視していたことが背景にあります。
本当に止められない基幹システムにも、停止しても影響の小さい補助的なシステムにも、同じコストをかけていました。限られた予算の使い方としては非効率です。
そこで、監視の強さをシステムごとに見直しました。
浮いた予算を重要システムの監視高度化に再投資した結果、トータルのコストを抑えながら、本当に守るべきシステムの可用性はむしろ向上しました。この事例が示すのは、性能監視の費用は一律に削るより、事業影響度に基づいて配分にメリハリをつけることで抑えられる、ということです。
配分は、システムが止まったときの影響の大きさで2つに分かれています。
- 重要システム:売上やサービス提供に直結するため、性能・死活・ログを含む監視を残す
- 影響の小さいシステム:死活監視を中心とした軽い監視に切り替える
性能監視の欠如による損失から立て直した事例
事例の価値は、成功談よりも、「なぜ損失が起きたか」「どう立て直したか」というリアルな経験にあります。性能監視が手薄だったためにサービスが止まり、大きな損害を被った事例からは教訓が得られます。その教訓は、これから監視を整える企業にとって、何よりの保険になります。
ピーク時の停止で機会損失を出した失敗の教訓
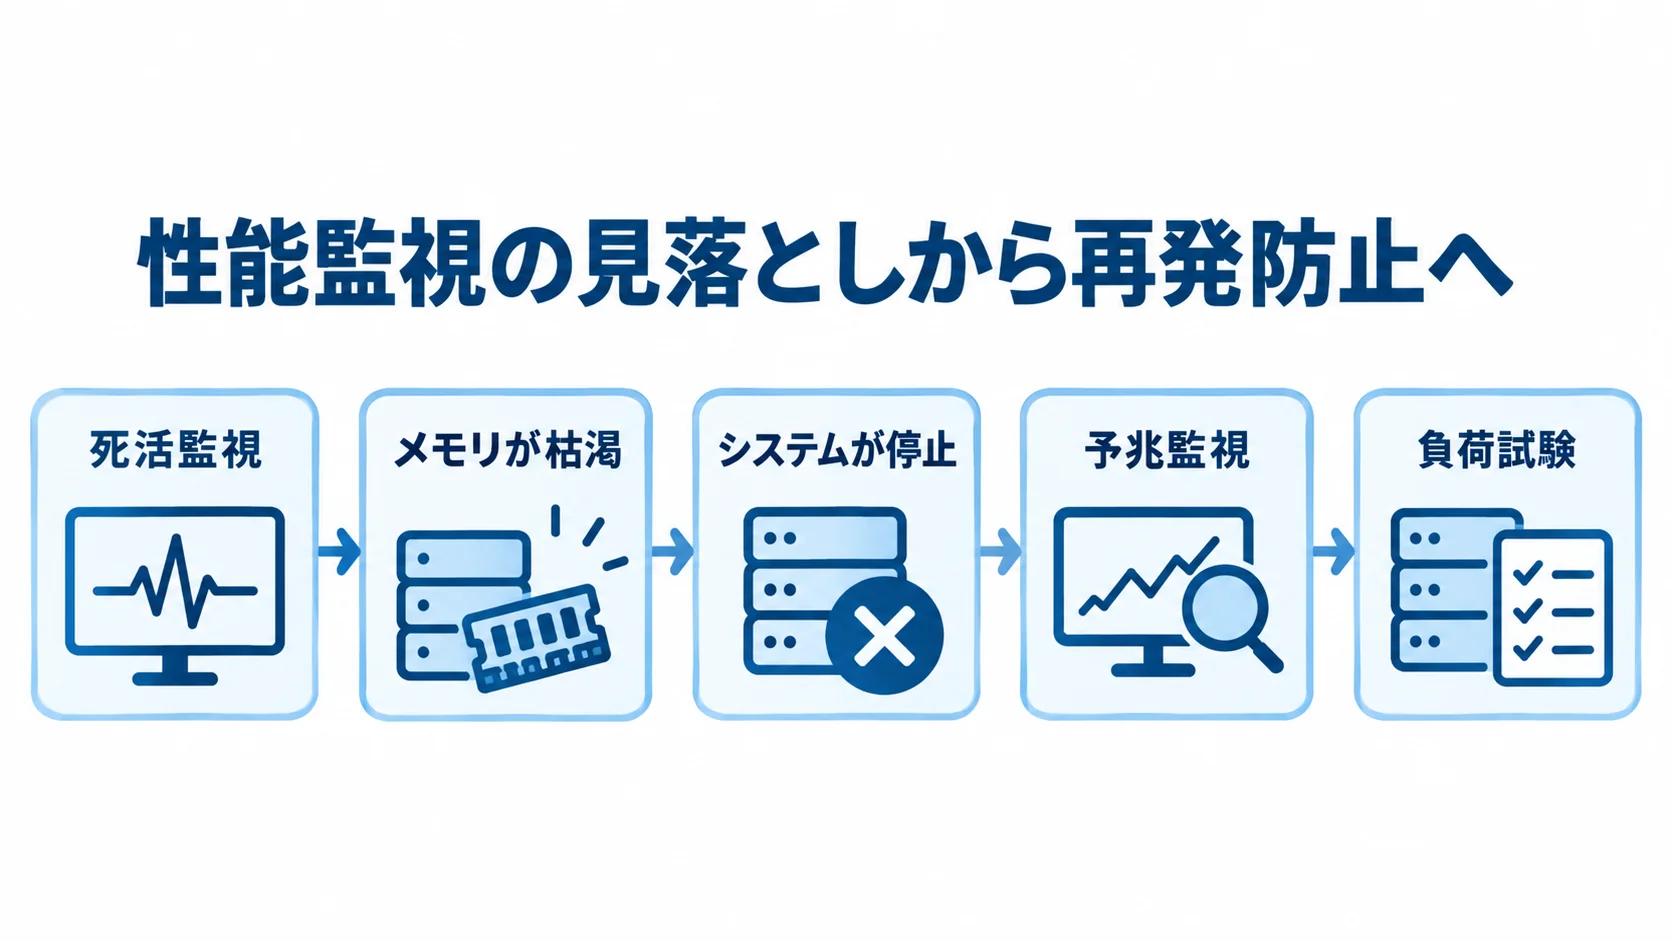
あるEC系のシステムでは、性能監視が死活監視の程度にとどまり、リソースの逼迫を事前に察知できていませんでした。販売のピーク時間帯にアクセスが集中した結果、メモリが枯渇してシステムが停止しました。
復旧までに時間がかかり、その間の受注機会を丸ごと失いました。一次データでは、総務省の2025年版資料として、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失が示されています。また、Gartnerの2024年調査では、ダウンタイム1分あたり約5,600米ドルとされています。短時間の停止であっても、ピーク時には甚大な損失につながります。
自社の性能監視が死活監視程度にとどまっていないかを確認しておくと、同じ失敗を避けやすくなります。予兆を捉えられていれば、停止そのものを回避できた可能性も高いと考えられます。
この事例は、性能監視を「事業継続の保険」と捉え直すべき理由を、損失額で示しています。
この失敗は、見落とした点と、予兆があった場合に打てた手の2つで整理できます。
- 見落とした点:停止してから気づく死活監視だけで、予兆を捉えていなかった
- 予兆があった場合:メモリ使用率やコネクション数の上昇から、増強を前倒しできた
予兆監視と負荷試験で再発を防いだ立て直し事例
この企業は失敗を機に、性能監視を抜本的に見直しました。危険水域に入る前にアラートが上がる予兆監視へ切り替えたうえで、負荷試験も定期的に行っています。
立て直しが成功した要因は、監視ツールを導入しただけでなく、「予兆を捉えたら誰が増強を判断するか」という運用と意思決定の流れまで整えた点にあります。
riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った後も「性能劣化の予兆を捉え、ピーク前に手を打つ」という伴走を重視しています。
事例は、華やかな成果よりも「なぜ損失が防げるようになったのか」という視点で読むと、同じ失敗を避ける最大の近道になります。性能監視を後回しにした代償は、復旧コストと機会損失の両面で跳ね返ってきます。
立て直しは、予兆の捉え方と再発の防止の2つの面から進められています。
- 予兆の捉え方:CPU、メモリ、コネクション数、レスポンスタイムに段階的な閾値を設ける
- 再発の防止:想定ピークの数倍の負荷試験で、限界に達するアクセス数を事前に把握する
まとめ
ITシステム性能監視の事例を振り返ると、成果を出している企業に共通しているのは、数値で劣化の予兆を捉え、閾値を運用の行動と結びつけたうえで、事業影響度に応じて監視の濃淡をつけている点です。
レスポンスタイムの閾値検知でクレームをゼロにした事例や、リソース監視でボトルネックを特定して過剰投資を避けた事例は、いずれも監視の本質が「数値に基づく先回りの判断」にあることを示しています。ひとり情シスが月5万〜20万円の委託で24/365の監視を確保した事例や、稼働率を99.99%から99.9%へ適正化してコストを削った事例も、この点を裏づけています。
一方で、性能監視を欠いた失敗からは、5分以上の停止で平均1,200万円規模の機会損失が出るとされる数字とともに、監視が「事業継続の保険」であることが読み取れます。事例を読むときは、「どんなツールを入れたか」より「予兆をどう運用判断につなげたか」に目を向けると役立ちます。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、システムを作った後も性能の予兆監視で事業を支える伴走を一貫して支援しています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。