
ITシステムの性能監視は、CPUやメモリ、ディスク、レスポンスタイムの状態を継続的に把握し、障害の予兆を早くつかむ取り組みです。死活監視が動いているか否かを見るのに対し、性能監視は余裕や負荷の偏りを捉えます。
全体像から進め方、費用、発注・外注までを概要で整理します。詳しくは下の関連記事で確認できます。
- ITシステム性能監視の進め方/やり方/流れや方法/手法/工程/手順
- ITシステム性能監視でおすすめの開発会社/ベンダー6選と選び方
- ITシステム性能監視の見積相場や費用/コスト/値段について
- ITシステム性能監視の発注/外注/依頼/委託方法について
目的に合う記事をご覧ください。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム性能監視の全体像
性能監視は、システム監視の3つの柱(死活監視・性能監視・ログ監視)のうち、リソースの使用状況を数値で把握する役割を担い、CPU使用率やメモリ消費量、ディスクの空き容量などを時系列で記録します。レスポンスタイムも含めて平常時との差分を見れば、異常の予兆を読み取れます。その最大の意義は、落ちていないかを確かめるだけでなく、性能の劣化傾向を早い段階で見つけられる点です。
性能監視で見るべき主な指標
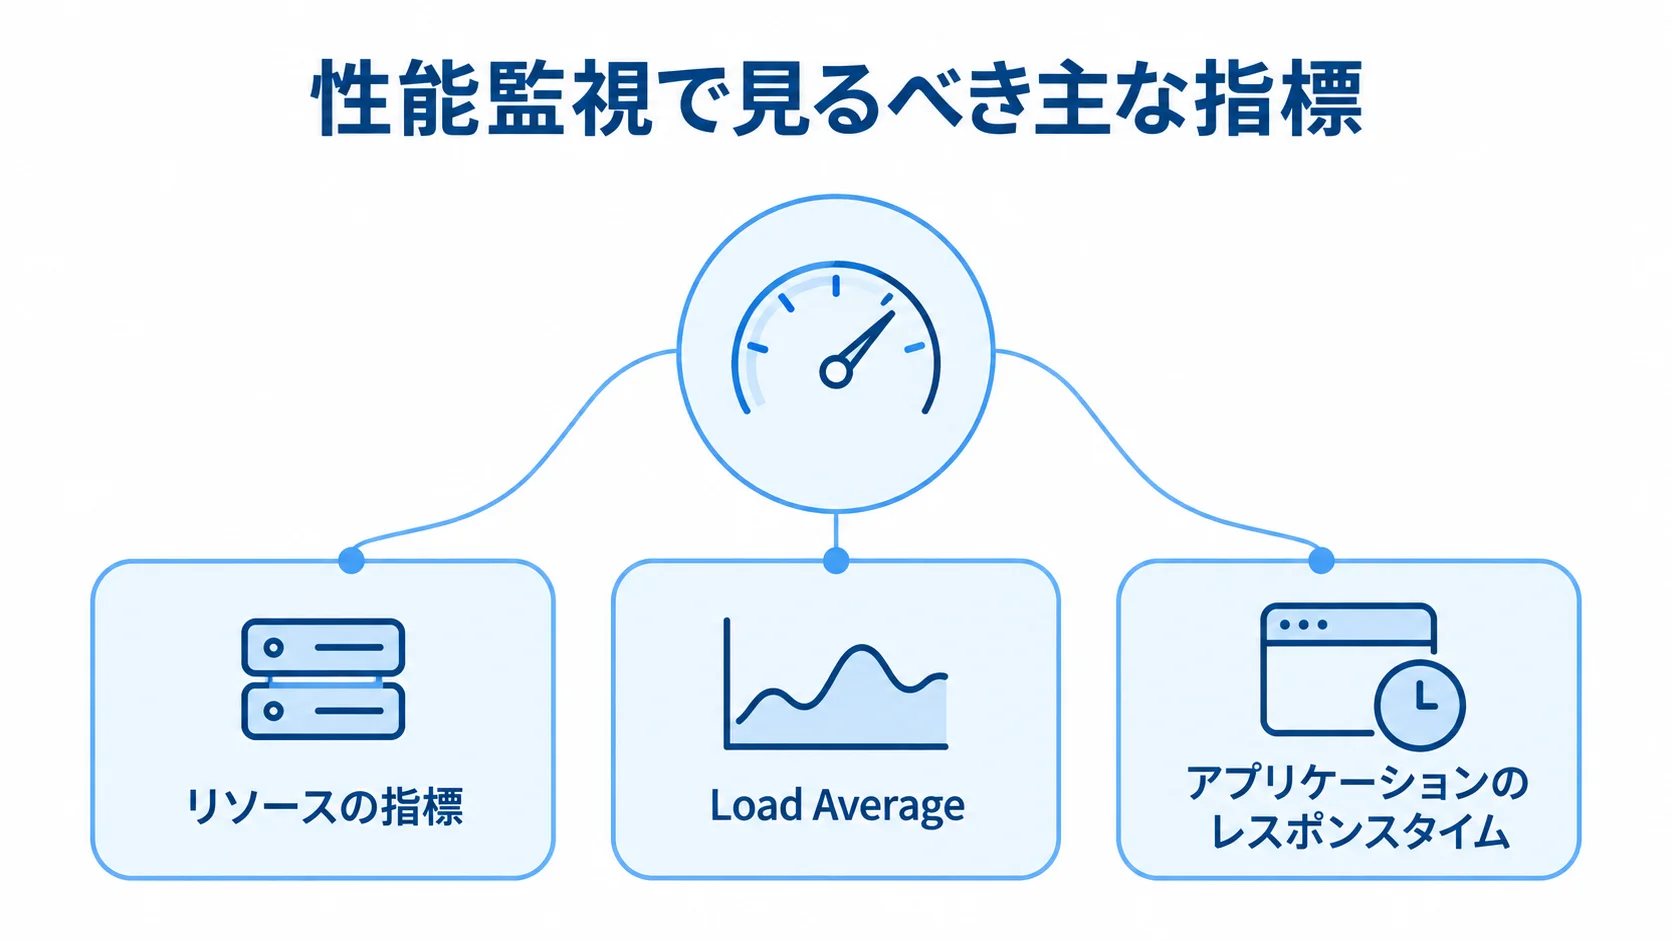
性能監視では、リソースの使用量、負荷、利用者から見た応答時間の3つを押さえると、システムの状態が見えてきます。
- リソースの指標:CPU使用率、メモリ使用量、ディスク使用量、ネットワークトラフィックなど
- Load Average:CPUの負荷を表す指標で、システムの混雑度を端的に示すものとして広く使われています
- アプリケーションのレスポンスタイム:Webサービスであれば、ユーザーがページを開いてから表示されるまでの応答時間も重要な監視対象となります
これらの指標は、組み合わせて相関を読み解くことが大切です。たとえばレスポンスが悪化したとき、原因がCPU不足なのか、メモリ枯渇によるスワップ発生なのか、ディスクI/Oの詰まりなのかを切り分けることで、的確な対処につながります。
予兆検知という考え方
性能監視の真価は、障害が表に出る前に手を打てる「予兆検知」にあります。ディスクやメモリは、使用量の推移を追うことで予兆をつかめます。
- ディスク使用量:毎週数パーセントずつ増えているなら、満杯になる時期を予測して、増設や不要データの削除を前もって計画できます
- メモリリーク:消費量が徐々に増えるアプリケーションも、傾向を追っていれば再起動のタイミングを見極められます
死活監視が「すでに起きた障害」を検知するのに対し、性能監視は「これから起きる障害」を未然に防ぐアプローチです。特に、サービスの可用性を高めたい組織ほど、性能監視への投資効果は大きくなります。
性能監視の具体的な進め方は、関連記事で詳しく解説しています。
進め方の詳細:ITシステム性能監視の進め方/やり方/流れや方法/手法/工程/手順をご覧ください。
性能監視の進め方としきい値設計
性能監視は、監視対象を洗い出し、指標ごとにしきい値を設定して、アラートの通知経路を整える順で進めます。なかでも難しいのが、どの値を超えたら警告を出すかを決める「しきい値設計」です。
しきい値の設定を誤ると、緩すぎれば障害を見逃し、厳しすぎれば過剰なアラートに埋もれて重要な通知を見落とす「アラート疲れ」を招きます。
すぐ使えるしきい値の目安
しきい値の出発点として参考になる数値は、指標ごとに運用例が知られています。
- Load Average(1CPU換算):4以上で警告、8以上で軽度障害、12以上で重度障害という3段階が運用例として知られています
- ディスク使用量・Inode使用量:80%超過で警告、90%超過で軽度障害、95%超過で重度障害という設定が一般的です
- メール処理を行うサーバーのメールキュー:500件を超えたら警告、1,000件超で軽度障害、2,000件超で重度障害という数値が参考になります
これらはあくまで出発点で、システムの特性やトラフィックの増減に合わせて、段階的に調整していく必要があります。詳しい数値の一覧は、しきい値設計を扱う個別記事で紹介しています。
シンプルなアラート設計
アラート設計では、複雑な条件分岐を避けて、シンプルに保つことが失敗を防ぐ近道です。たとえば、ある中規模企業では「特定キーワードを含む場合のみ通知」という凝った条件を設定しました。ところが設定ミスにより、重要なエラーが通知されず、障害の発見が3時間遅れた事例があります。
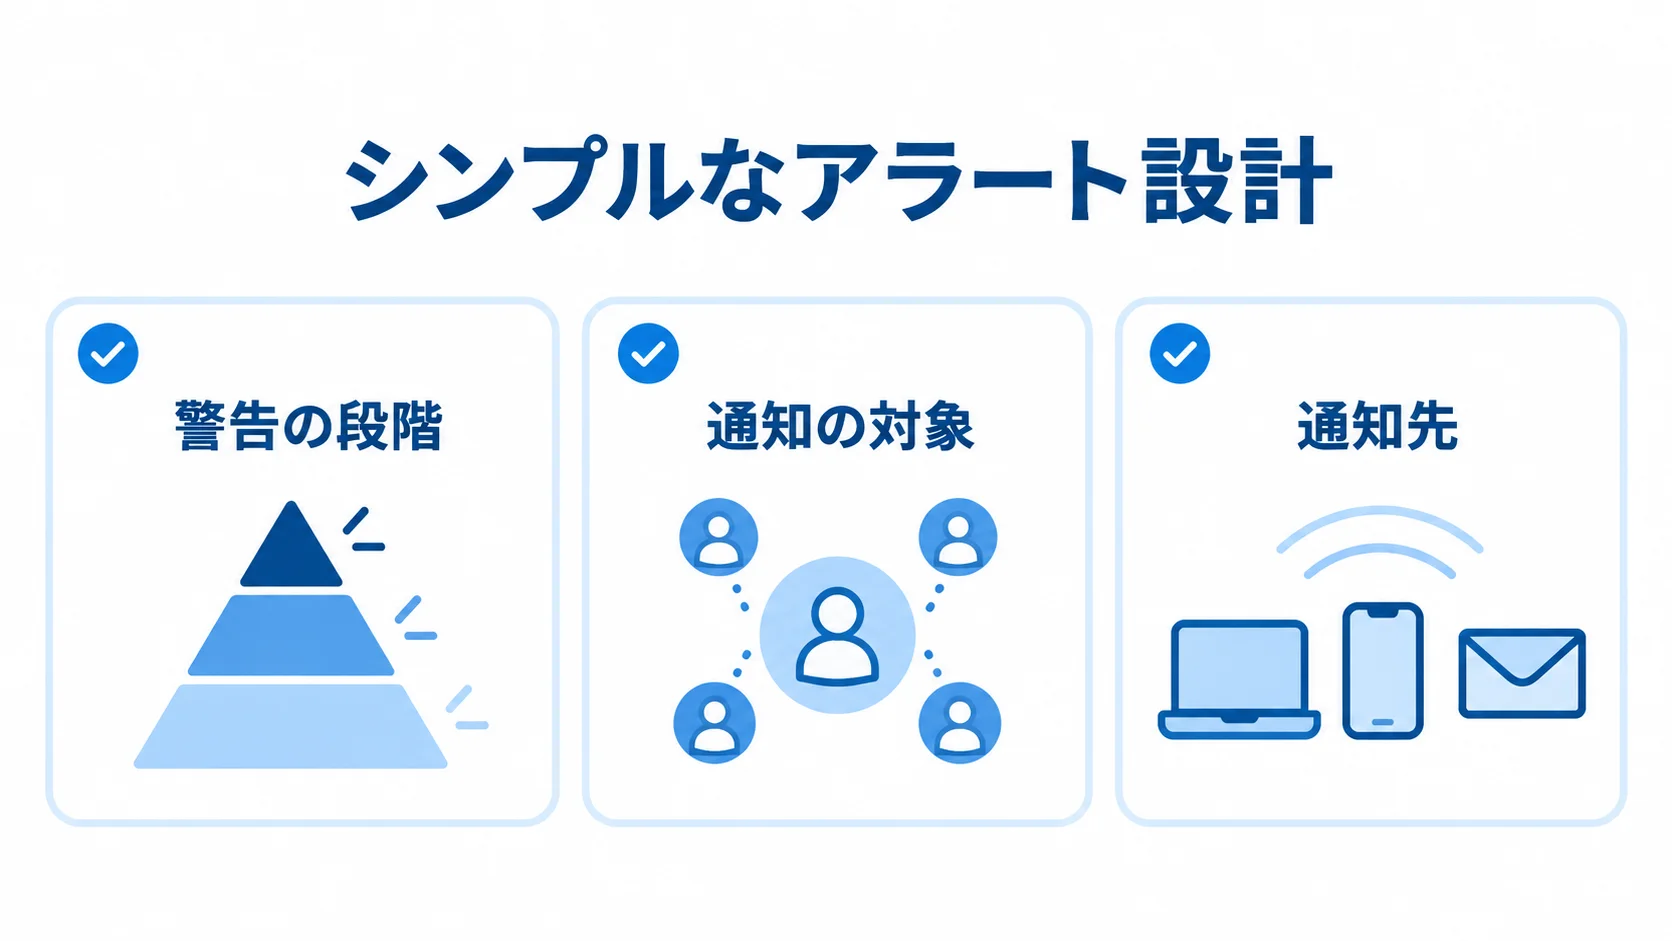
ツール選び以上に、アラート設計の分かりやすさが運用の質を左右します。通知の設計は、段階・対象・通知先の3つに分けて考えると整理できます。
- 警告の段階:警告と障害を段階的に分ける
- 通知の対象:人がすぐ対応すべき重大なアラートだけを、夜間や休日にも通知する
- 通知先:メールとSlackを重要度に応じて使い分け、見落としを防ぐ
通知をこのように絞ると、対応者の負担が大きく減ります。
進め方の全体フローは、関連記事で詳しく解説しています。運用設計の詳細:ITシステム性能監視の進め方/やり方/流れや方法/手法/工程/手順をご覧ください。
監視ツール・委託先の選び方
性能監視を支えるツールや委託先は、予算、監視対象の環境、運用チームの技術レベル、監視範囲、アラート通知の柔軟性という5つの基準で選ぶと整理しやすくなります。
自社の体制に合う選択肢を見極めることが、長く使える監視基盤を築く鍵になります。
予算別のツール選定の考え方
予算は、最も分かりやすい選び方の基準です。予算別に見ると、次のような候補があります。
- 月額5万円未満に抑えたい場合:初期コストゼロで導入できるOSSのZabbixが候補になります
- 月額5万〜20万円であれば:使った分だけ支払う従量課金のCloudWatchが現実的です
- 月額20万円以上の予算を確保できるなら:ホスト課金で多機能なDatadogも選択肢に入ります
ツール比較サイトの評価でも、Mackerelは機能への満足度が高く、DatadogやZabbixと並んで利用者から一定の支持を得ています。
OSSとSaaSでは、費用と運用の負担が次のように異なります。
- OSS:無料で始められる反面、運用にエンジニアの工数がかかる
- SaaS:費用がかさむ一方で、導入と運用が容易
自社の技術レベルとコストのバランスで判断することが大切です。
環境とチーム体制による見極め
監視対象がオンプレミスか、クラウドか、あるいはマルチクラウドかによって、適したツールは変わります。
- AWS中心の環境:CloudWatchとの相性が良い
- 複数のクラウドやオンプレミスをまたぐ監視:Datadogのような統合監視SaaSが力を発揮する
- チーム体制:導入後に誰が運用するかを、ツールのUIや学習コストと合わせて検討したい要素
具体的な比較やベンダー選定のポイントは、専用の関連記事にまとめています。詳細はこちら:ITシステム性能監視でおすすめの開発会社/ベンダー6選と選び方をご覧ください。
性能監視の費用相場とROIの考え方
性能監視の費用は、ツールのライセンス料と運用人件費、そして外部委託する場合の監視代行費で構成されます。
費用の絶対額だけで判断せず、ダウンタイムによってどれだけの損失を防げるかという投資対効果(ROI)の視点で考えることが、経営層の決裁を得るうえでも大切です。
ツール・代行サービスの費用目安
SaaS型ツールは従量課金が主流です。主なツールと監視代行の料金は、製品ごとに次のような目安があります。
- Datadog:ホスト課金で月額数千円規模から
- CloudWatch:取り込んだデータ量に応じた課金体系です
- Mackerel:1台あたり月額2,000円台のスタンダードプランがあり、台数規模に応じて総額が決まります
- 監視代行(MSP):24時間365日の監視と一次対応を含むパッケージで、1台あたり月額10,000〜30,000円が目安です
- オプション:個別サービスの監視は月額200円程度、Apacheなどの自動復旧監視は月額3,000円程度で、オプション料金が加算される構成が一般的です
ROIの数値による説明
監視への投資は、防げるダウンタイムの損失額と比較すると説得力が増します。たとえばECサイトで1時間の停止が100万円の売上機会を失うとします。性能監視で年間に数回の障害を未然に防げるなら、その効果は監視費用を大きく上回ります。
経営層に説明する筋道を立てるには、試算に次の2つを含めます。
- 機会損失の防止額:障害を未然に防ぐことで守られる売上の機会
- 人件費の削減:原因特定の時間短縮による人件費の削減
ある中規模SaaS企業では、APM、ログ、メトリクスを統合して見られるようにしたことで、障害の原因特定にかかる時間が従来の3分の1に短縮された事例もあります。
費用の内訳や規模別の相場については、費用に特化した関連記事で詳しく解説しています。
▶ 詳細はこちら:ITシステム性能監視の見積相場や費用/コスト/値段についてをご覧ください。
性能監視の発注・外注方法
24時間365日の体制を自社だけで維持するのは負担が大きいため、監視業務を外部のMSPに委託する企業は少なくありません。
発注にあたっては、契約形態と委託範囲を明確にし、丸投げによるブラックボックス化を避ける設計が欠かせません。
契約形態と偽装請負の注意点
監視業務を委託するときは、請負契約・準委任契約と労働者派遣の違いを正しく理解しておく必要があります。
請負や準委任では、発注者が委託先の作業者へ直接指揮命令を行うと、偽装請負(労働者派遣法違反)と判断されるリスクがあります。たとえば、発注者の事業所で請負労働者が1人だけで作業し、その作業者が管理責任者を兼任する状態は、注文が直接の指揮命令とみなされやすく注意が必要です。
注意したいのは、メールの宛先の扱いと、指示や返信の求め方の2点です。
- メールのCC:管理責任者宛のメールを作業担当者にCCで送ること自体は違法ではありません
- 指示や返信の求め方:実質的な作業手順の指示を含めたり、担当者に直接返信を求めたりすると、指揮命令とみなされる場合があります
Slackで常時つながる現代の開発現場では、こうした境界が曖昧になりがちです。そのため、契約上の役割分担を明確にしておくことが大切です。
ハイブリッド運用と手放さないスキル
一部を外注し、残りを内製する「ハイブリッド運用」は、現実的な選択肢の一つです。たとえば、夜間・休日の一次対応だけをMSPに任せ、日中の判断や改善は自社で担う分担が、その一例です。
将来的に内製へ移すことも、逆に委託範囲を広げることも視野に入れて、柔軟な設計を心がけるとよいでしょう。
外注する場合でも、発注側が手放してはいけないスキルがあります。委託先に頼らず自社で持つべき中核の能力は、次の2つです。
- SLAの定義:SLAを適切に定義する能力
- システム全体の把握:システムのアーキテクチャ全体を把握する力
これらを失うと、「丸投げで自社システムを理解できる社員がゼロになる」という構造的な失敗に陥りかねません。発注の具体的な手順は、関連記事で詳しく解説しています。
▶ 詳細はこちら:ITシステム性能監視の発注/外注/依頼/委託方法について
目的に合う記事をご覧ください。
キャパシティプランニングとオブザーバビリティ
性能監視を高度化する方向としては、リソースの推移から将来の増強を計画する「キャパシティプランニング」と、システム内部を深く理解する「オブザーバビリティ(可観測性)」への移行が挙げられます。
オブザーバビリティは、単なる監視から一歩踏み込み、なぜ問題が起きるのかを説明できる状態を目指す取り組みです。
リソース推移による増設の判断
キャパシティプランニングは、CPUやメモリ、ディスクの使用量の推移を長期で記録し、いつ頃に限界へ達するかを予測してリソースを計画的に増強する手法です。性能監視で蓄積したメトリクスがそのまま根拠データになるため、性能監視とは表裏一体の関係にあります。
蓄積したデータは、次のような判断に活かせます。
- スケールアップ・スケールアウト:繁忙期のトラフィック増加を見越した判断も、過去データの傾向分析から精度高く行えます
- サーバーの増設:データに基づいて投資のタイミングと規模を決めれば、場当たり的なサーバー増設を避け、過剰投資とリソース不足の両方を防げます
- クラウドの自動スケーリング:クラウド環境であれば、自動スケーリングのしきい値設計にも性能監視のデータが活きます
オブザーバビリティとAIOpsの実態
監視(モニタリング)が「どこに異常があるか」を示すのに対し、オブザーバビリティは「なぜその異常が起きたのか」を明らかにするアプローチです。具体的には、メトリクス・ログ・トレースという3つのデータを統合し、システム内部の状態を多角的に観察できるようにします。
AIOpsやセルフヒーリングといった技術も登場しています。前者は異常の予測、後者は障害時の自動復旧を受け持ちます。
- AIOps:AIでメトリクスから異常を予測する
- セルフヒーリング:障害時に自動で復旧する
技術の導入で注意したい点は、次の2つです。
- AIOpsの限界:精度の高い異常検知には十分な量の学習データが必要で、過去に例のないエッジケースには対応しきれません
- ベンダーロックイン:特定SaaSへの作り込みが進むと、移行コストが膨らむリスクがあります
ロックインを避けるには、OpenTelemetryのような標準仕様を活用して可搬性を確保する工夫が有効です。
性能監視の高度化については、進め方を扱う関連記事も併せてご参照ください。
高度化の詳細:ITシステム性能監視の進め方/やり方/流れや方法/手法/工程/手順をご覧ください。
性能監視で失敗しないためのポイント
性能監視の導入で見落とされがちなのは、ツールを入れたあとの運用と改善を続けることです。高機能なSaaSを契約しても、誰もダッシュボードを見なければ活かせません。
失敗のパターンを知っておき、振り返りの仕組みを組み込むことが、監視を形骸化させない秘訣です。
よくある構造的な失敗パターン
典型的な失敗は、次の2つです。
- ツールの形骸化:高価なSaaSを導入したものの、誰もダッシュボードを見ず、宝の持ち腐れになるケースがあります
- 運用の丸投げ:「MSPに丸投げした結果、自社システムを理解できる社員がいなくなった」という構造的な問題も少なくありません
失敗の原因は、個人の設定ミスではなく、組織としての運用設計の欠如にあります。
対策としては、ダッシュボードを定例会議で確認する習慣をつくり、委託しても自社にアーキテクチャを理解できる人を残すことが有効です。
アラート疲れを防ぐためのしきい値も、定期的に見直すことで形骸化を防げます。
ポストモーテムによる監視の改善
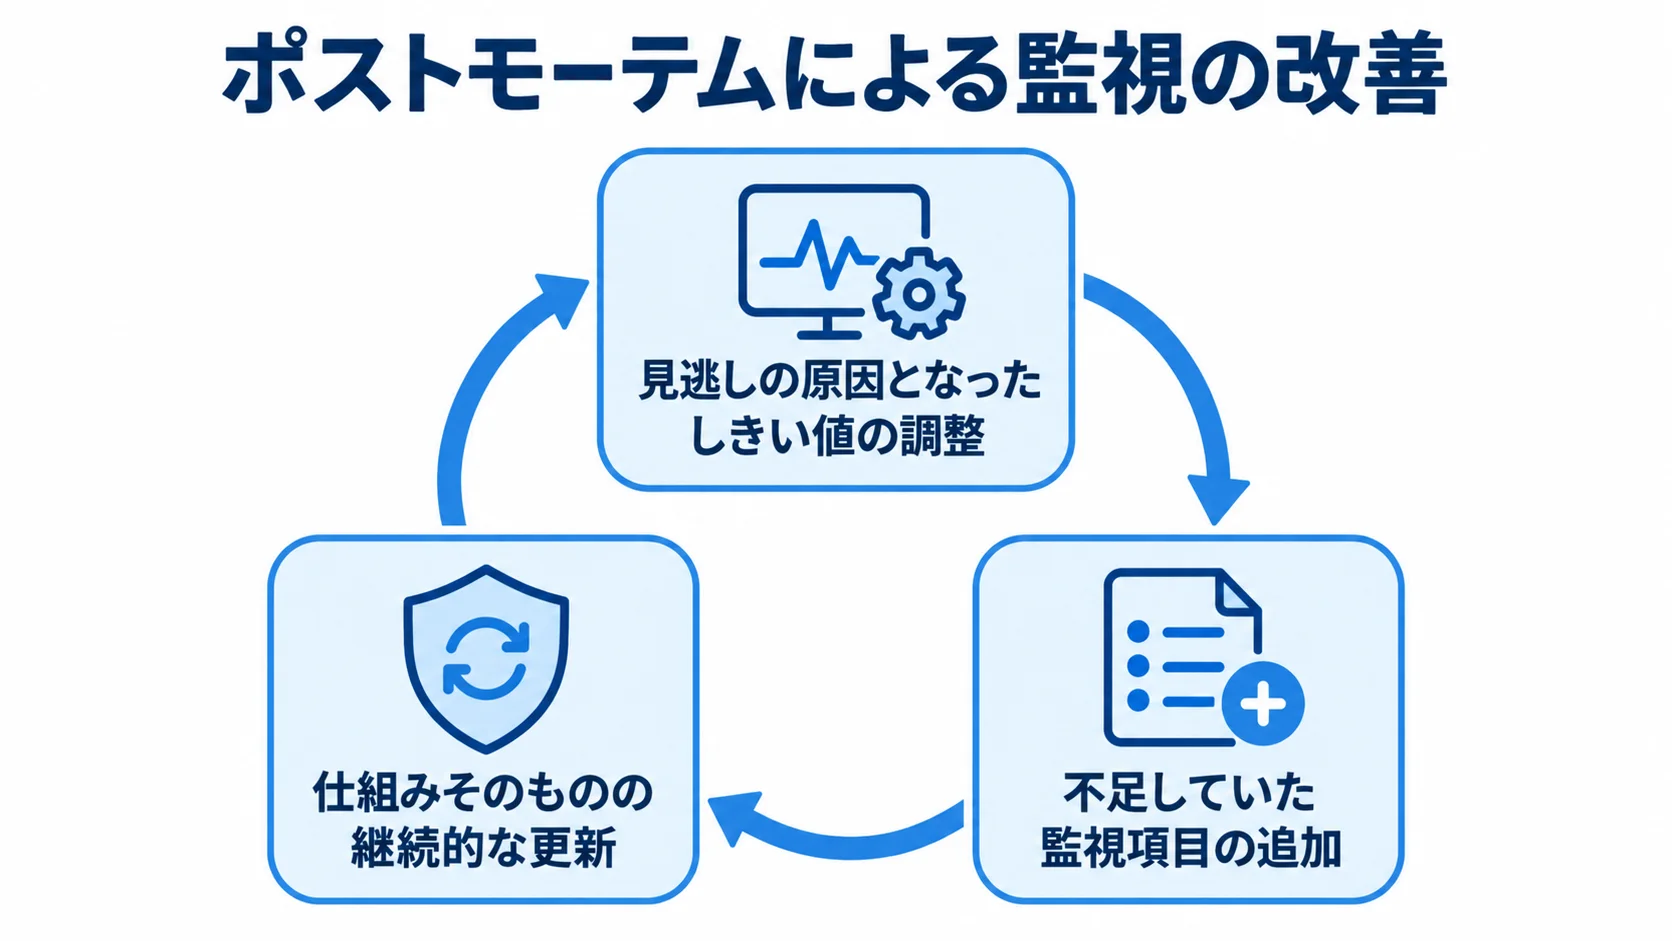
障害が発生したあとは、原因を特定して復旧するだけで終わらせず、「なぜ起きたのか」「アラートは適切に機能したのか」を振り返るポストモーテム(事後検証)を行うことが大切です。
振り返りを通じて、次の3点を継続的に見直せます。
- しきい値:見逃しの原因となったしきい値の調整
- 監視項目:不足していた監視項目の追加
- 監視の仕組み全体:仕組みそのものの継続的な更新
検知や通知、原因特定で完結させず、改善のサイクルを回し続けることで、監視の精度は着実に高まっていきます。
個人の責任を問うより、仕組みを改善する文化を根づかせることが、長期的に強いシステム運用につながります。
性能監視の各テーマをさらに深く知りたい方は、本記事末尾の関連記事一覧から目的に合った記事へお進みください。
まとめ
ITシステムの性能監視は、CPUやメモリ、ディスク、レスポンスタイムといったリソースの状態を数値で把握し、障害の予兆を捉えて未然に防ぐための重要な取り組みです。
ここまでは、全体像と進め方を確認したうえで、ツールや費用、発注・外注の考え方を整理しました。さらに、キャパシティプランニングと失敗を避けるポイントにも触れました。
性能監視は、しきい値の調整とポストモーテムによる改善を続けてこそ、本来の価値を発揮します。
自社の予算と体制に合う監視基盤を選び、外注する場合も中核のスキルは手放さず、データに基づく運用を積み重ねることが大切です。各テーマの詳細は、関連記事で深く掘り下げています。
▼関連記事一覧
ITシステム性能監視の進め方/やり方/流れや方法/手法/工程/手順
ITシステム性能監視でおすすめの開発会社/ベンダー6選と選び方
ITシステム性能監視の見積相場や費用/コスト/値段について
ITシステム性能監視の発注/外注/依頼/委託方法について
目的に合う記事をご覧ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。