
ITシステムの性能監視は、システムの状態を多面的に測る機能を組み合わせて成り立ちます。どの機能が要るかは、必要な指標を選び、測りたい対象を確実に監視できるかで決まります。
- リソース監視:CPUやメモリなど、サーバーの使用状況
- 応答・スループット:処理速度と処理量
- APM・ログ・トレース:アプリ内部の処理と、原因の追跡
- アラート・自動化:異常の通知と、対応の効率化
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
リソース監視機能(CPU・メモリ・ディスク・ネットワーク)
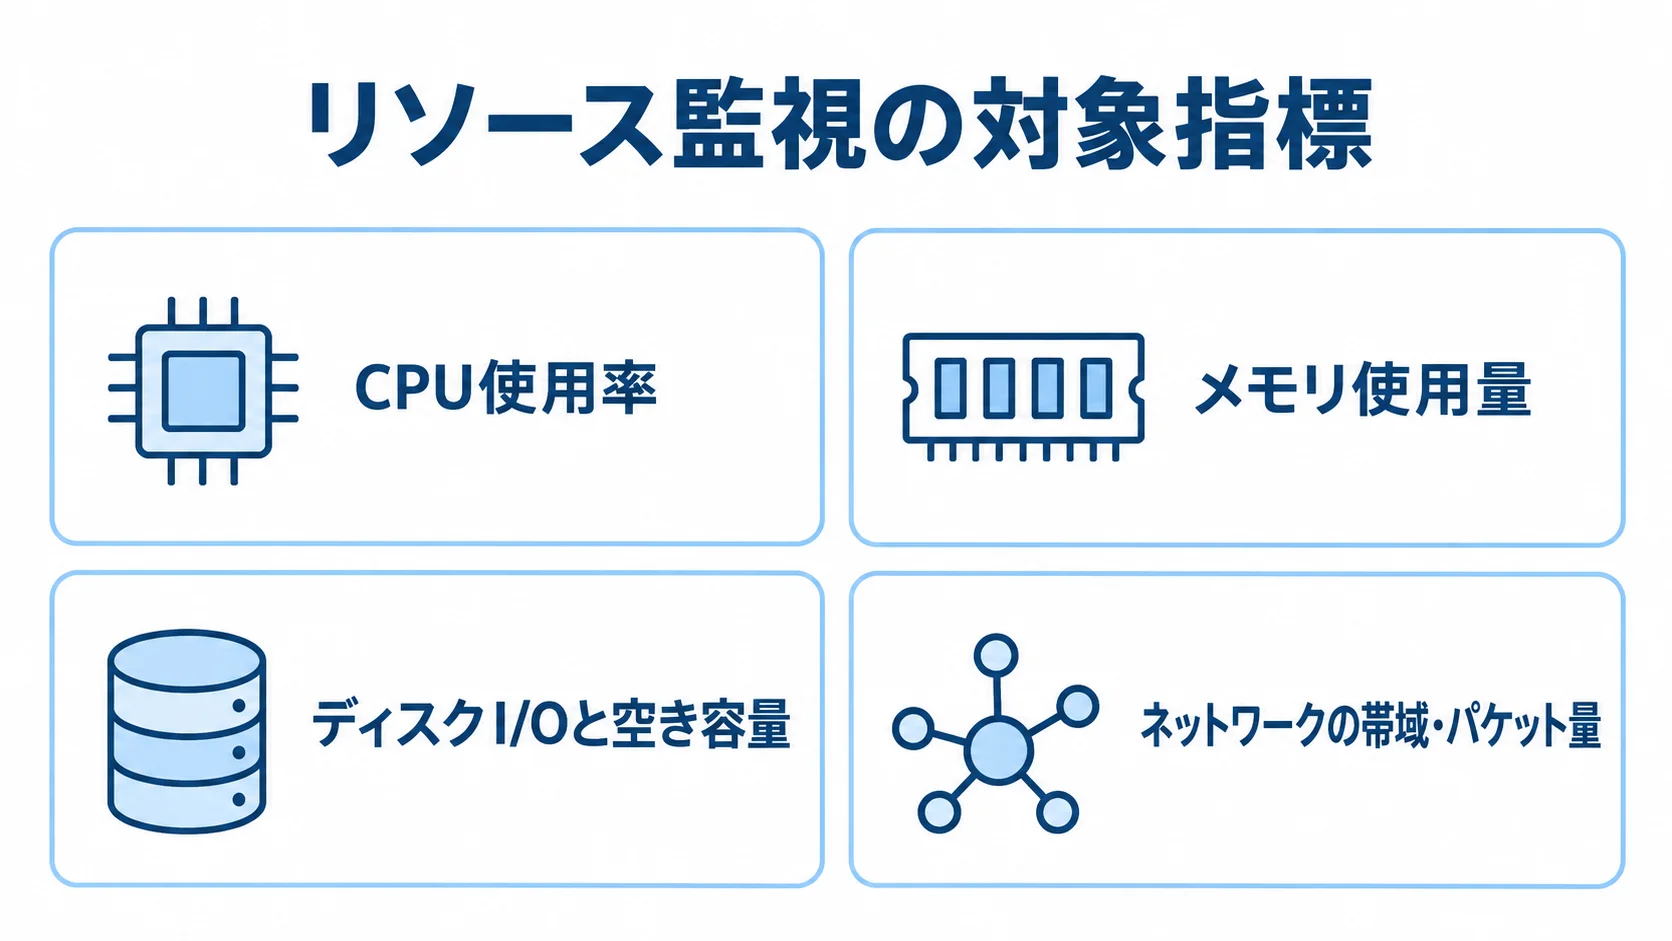
性能監視のもっとも基本となるのが、サーバーやインフラのリソース使用状況を監視する機能です。CPU使用率やメモリ使用量のほか、ディスクI/Oと空き容量、ネットワークの帯域・パケット量も、一定間隔で収集して時系列に記録します。
これらは性能劣化の「原因側」を示す指標で、レスポンス悪化や障害の根本要因を突き止める出発点になります。多くの監視ツールに標準機能として備わっており、性能監視の土台と言えます。
メトリクス収集と時系列データの蓄積機能
リソース監視の中核は、各指標(メトリクス)を定期的に収集し、時系列データベースに蓄積する機能です。1分間隔や5分間隔でCPUやメモリの値を取り続けると、「いつから劣化が始まったか」「特定の処理でリソースが跳ね上がるか」といった傾向を後から分析できます。
特に、瞬間値だけでは見えない、じわじわとした性能劣化やメモリリークを捉えるには、この継続的な蓄積が欠かせません。代表的なツールのうち、OSSのZabbixはライセンスが無料でメトリクス収集を担えますが、自社運用では構築・維持の工数が必要です。
一方、DatadogやNew Relicといったクラウド型は、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です。また、サーバー監視に特化したMackerelのようなサービスもあります。ただし、標準機能としてどの粒度・保持期間でメトリクスを蓄積できるかは、ツールやプランによって差があるため、選定時に必ず確認すべき点です。
閾値監視とキャパシティ予測の機能
収集したメトリクスを活かすには、閾値を設定して超過を検知する機能が欠かせません。たとえば、CPU使用率80%で警告、95%で重大、ディスク空き容量10%で警告といったルールを設定し、超えたら通知します。これにより、リソースが危険水域に入る前に手を打てます。
この閾値監視は、多くのツールで標準搭載されている基本機能です。ただし、閾値をどう設計するかは運用設計の領域で、ツール任せにはできません。
さらに高度な機能として、蓄積した時系列データから将来のリソース消費を予測するキャパシティプランニングがあります。具体的には、ディスク使用量の増加トレンドから「あと何か月で容量が逼迫するか」を見積もれば、緊急の増設に追われる事態を避け、計画的にインフラを拡張できます。リソース監視は、現状把握にとどまらず、将来の逼迫を先読みする機能まで含めて評価することが大切です。
レスポンス・スループット監視機能
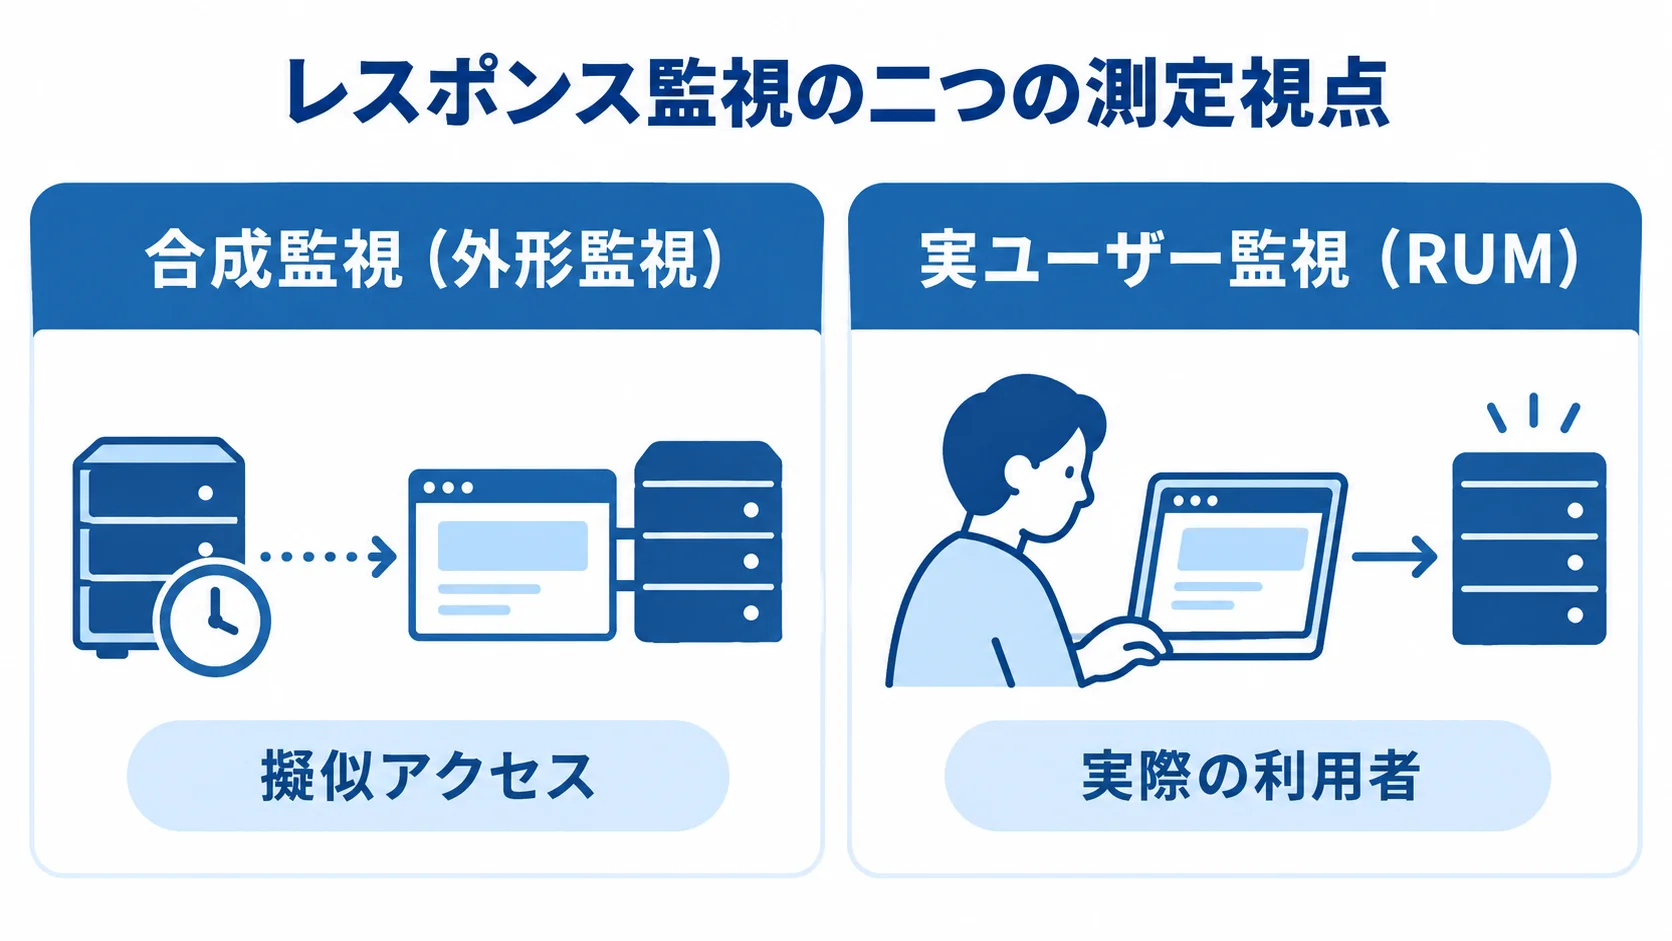
リソース監視が「原因側」だとすれば、レスポンス・スループット監視は「結果側」で、ユーザーが体感する性能を測る機能です。画面表示やAPI応答にかかる時間(レスポンスタイム)、単位時間あたりに処理できるリクエスト数(スループット)、エラー率などを監視します。
リソースに余裕があってもレスポンスが悪ければ意味がありません。そのため、利用者目線の性能を直接測るこの機能は、性能監視の目的そのものに直結します。
合成監視(外形監視)で応答時間を計測する機能
合成監視(外形監視・シンセティック監視)は、システムの外側から定期的に擬似的なアクセスを行い、その応答時間や成否を計測する機能です。たとえば、一定間隔でログイン画面にアクセスし、表示完了までの秒数を記録します。
実ユーザーがいない夜間でも、システムが正常な速度で応答できるかを能動的に確認でき、劣化を早期に発見できます。この機能の利点は、ユーザーからのクレームを待たずに、サービス提供者側が主体的に性能を担保できる点にあります。さらに、閾値を設けておけば、応答時間が一定を超えた瞬間にアラートを出せます。
一次データの一般目標としては、重大障害は2時間以内に対応を開始し、完全解決は24時間以内とする例があります。とはいえ、合成監視で予兆を早期に捉えられれば、こうした目標時間の中でも初動を大きく前倒しできます。いわば、サービスの入口の速度を常時見張る定点観測の機能です。
実ユーザー監視(RUM)で体感速度を測る機能
合成監視が「擬似アクセス」なのに対し、実ユーザー監視(RUM)は、実際の利用者のブラウザやアプリから性能データを収集する機能です。ページの読み込み時間や操作の応答性を、実際の回線・端末・地域ごとに把握できます。
そのため、「ある地域のユーザーだけ遅い」「特定の端末で重い」といった、合成監視では見えにくい現実の体感を捉えられます。RUMの価値は、性能を「平均値」ではなく「分布」で見られる点にあります。平均応答が速くても、一部のユーザーが極端に遅い体験をしているなら、それは見過ごせません。
標準機能としてRUMを備えるツールは、こうした実態に即した改善の優先順位づけを支えます。さらに、合成監視とRUMを組み合わせれば、「あるべき速度の担保」と「現実の体感の把握」を両面から押さえられ、レスポンス監視の精度が大きく高まります。
APM・ログ・トレースによる原因分析機能
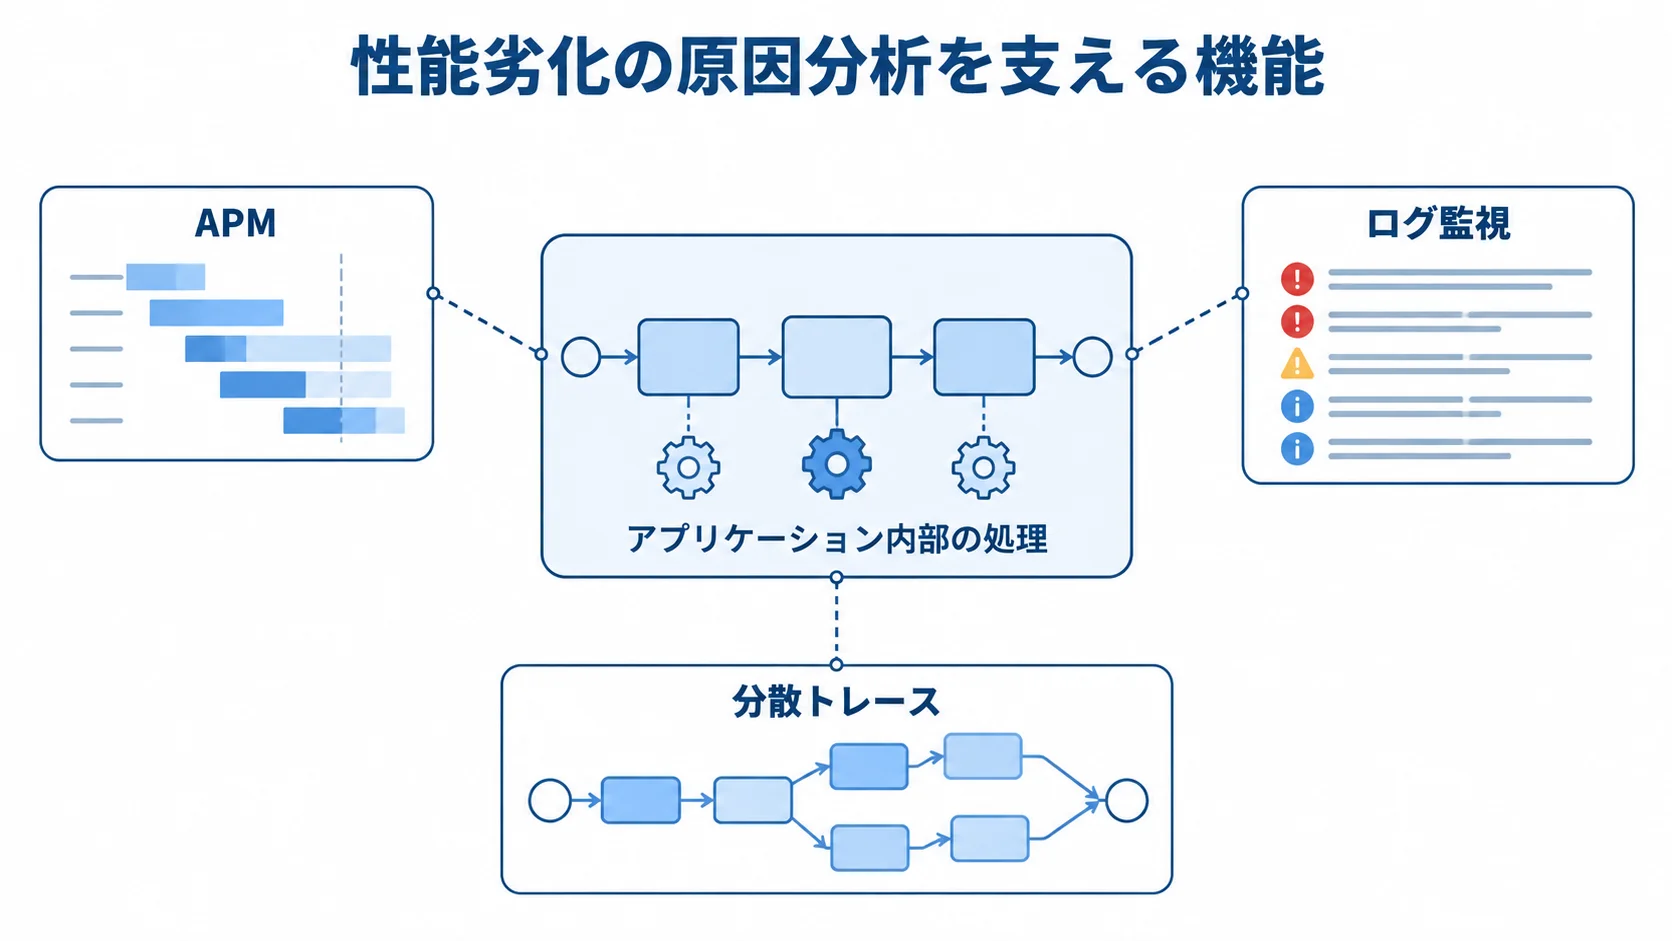
リソースやレスポンスの監視で「遅い」ことが分かっても、「なぜ遅いのか」を突き止めるには、より深い機能が必要です。それを担うのが、APM(アプリケーション性能監視)、ログ監視、分散トレースといった原因分析の機能群です。
原因分析の機能は、アプリケーション内部の処理を見える形にし、どの処理・どのクエリ・どのサービス間通信が遅延の元凶かを特定します。性能監視が「検知」で終わらず「解決」につながるかは、この層の機能にかかっています。
APMでアプリ内部の処理時間を分解する機能
APMは、アプリケーションの一つのリクエスト処理が、どの工程にどれだけ時間を費やしているかを分解して示す機能です。たとえば、1回の画面表示が3秒かかるとき、そのうちデータベースアクセスに2秒、外部API呼び出しに0.8秒、アプリ内処理に0.2秒というように内訳が分かります。
これにより、漠然と「遅い」という状態を「データベースが遅い」という具体的な原因に落とし込めます。とりわけ有効なのが、データベースのスロークエリを特定する機能です。実行に時間のかかるSQLを自動で検出し、頻度や所要時間とともに一覧化してくれるため、チューニングすべき対象が一目で分かります。
前提として、性能問題の多くはハードウェアではなく特定のクエリやコードに起因することが少なくありません。APMはその「真犯人」を数値で示すことで、無駄なサーバー増設を避け、的を射た改善を可能にします。
ログ監視と分散トレースで連鎖を追う機能
ログ監視は、アプリケーションやミドルウェアが出力するログを収集・解析し、エラーや警告の発生状況、性能に関わる出力を追えるようにする機能です。性能劣化の前後にどんなログが出ていたかを突き合わせることで、原因の手がかりを得られます。
さらに、エラーの急増を検知してアラートを出すといった使い方もでき、リソースやレスポンスの数値だけでは見えない文脈を補ってくれます。また、マイクロサービスやクラウド構成では、一つのリクエストが複数のサービスをまたいで処理されるため、分散トレースの機能が重要になります。
分散トレースでは、リクエストにIDを付与し、サービス間をどう流れ、どこで時間を要したかを追跡します。そのため、複雑な構成でも遅延の発生箇所を特定できます。ログ監視と分散トレースは、APMと組み合わせて「検知から原因特定、解決」までの一連の流れを支える機能群で、標準でどこまでカバーされるかは、ツール選定の核心と言えます。
アラート・ダッシュボード・AIOps自動検知機能
監視で集めたデータは、適切に通知され、人が読み取れる形で示されて初めて価値を生みます。アラート機能とダッシュボード機能は、その成果を運用の行動へつなぐ出口にあたります。
さらに近年は、AIOpsと呼ばれる機械学習を使った異常検知の機能が広がっています。人手では追いきれない大量のメトリクスから異常を自動で見つけ出す動きが進んでいます。
アラート通知とエスカレーションの機能
アラート機能は、閾値超過や異常を検知した際に、メール・チャット・電話などの手段で担当者へ通知する機能です。重要なのは、単に通知するだけでなく、重大度に応じて通知先や手段を切り替えるエスカレーション設計ができることです。
たとえば、軽微な警告はチャットへ、重大障害は担当者の電話と上長への同報へ振り分けると、対応の優先順位が明確になります。一次データでは、重大インシデントについて15分以内の一次対応を保証する例や、検知から60分以内に通知するといったサービス水準が示されています。
こうした応答目標を満たすには、アラートが確実に正しい相手へ届く通知設計が前提になります。一方で、アラートが多すぎて重要なものが埋もれる「アラート疲れ」も大きな課題です。だからこそ、通知を絞り込む、つまり鳴らすべきときだけ鳴らす設計まで含めて、アラート機能を評価する必要があります。
AIOpsによる異常検知と自動化の機能
AIOpsは、機械学習を用いて監視データから「普段と違う」状態を自動で検知する機能です。固定の閾値では捉えにくい、曜日や時間帯による変動を学習し、平常パターンから外れた異常を浮かび上がらせます。これにより、人が一つひとつ閾値を設定しきれない大規模・複雑なシステムでも、見逃しを減らせる可能性があります。
ダッシュボード機能と組み合わせれば、複数システムの健全性を俯瞰しつつ、異常の兆候を素早く把握できます。ただし、AIOpsは万能ではありません。JUAS調査では、AI活用について約78%が検討中または未検討という状況が示されており、本格導入はこれからという企業が大半です。
だからこそ、中小企業はレガシーを維持しながら、まず一部のシステムに部分導入してROIを確かめる「スモールスタート」が現実的です。AIOpsは、標準機能というより既存の監視を高度化する発展機能と捉え、自社の規模と成熟度に合わせて少しずつ取り入れるのが賢明です。riplaはフルスクラッチ受託と国内運用保守の立場から、こうした機能の段階的な組み合わせ方も含めて伴走します。
まとめ
ITシステム性能監視の機能を体系的に振り返ると、大きく4つの層で成り立っていることが分かります。リソース監視(CPU・メモリ・ディスク・ネットワーク)が原因側を、レスポンス・スループット監視が結果側を捉えます。APM・ログ・分散トレースは「なぜ遅いか」の原因分析を担い、アラート・ダッシュボード・AIOpsは検知を運用アクションへつなぎます。
機能を選ぶときは、全部入りを目指すより、「自社が測りたいものは何か」から逆算するのが大切です。リソースの逼迫を防ぎたいのか、ユーザーの体感を担保したいのか、原因特定を速めたいのかによって、優先すべき機能は変わります。
ZabbixのようなOSSは無料だが運用工数がかかり、Datadog・New Relic・Mackerelといったクラウド型は月数万〜数十万円の従量で手早く始められる、という選択肢の違いも押さえておきたいところです。また、AIOpsのような発展機能は、まずスモールスタートでROIを確かめてから広げるのが現実的です。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、自社に必要な監視機能の見極めから運用設計まで一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。