
ITシステムの性能監視を委託するときや、監視基盤を構築するときは、RFP(提案依頼書)や要件定義書に、何を・どの水準で監視するかを数値で書き込めるかが成否を分けます。
要件が曖昧なまま発注すると、運用後に監視の抜けや追加費用のトラブルが続出します。
たとえば、「測りたかった指標が監視されていない」「アラートの基準が決まっておらず誰も対応しない」「契約範囲外の作業に追加費用を請求された」といった事態が起きます。逆に、要件を数値で明文化できれば、相見積もりの比較も容易になり、隠れコストも潰せます。
RFPに盛り込む内容を、発注企業(情シス)の視点から、監視項目の決め方からツール選定まで順に解説します。なお、性能監視の全体像をまだ把握していない方は、まずITシステム性能監視の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視項目と閾値の数値要件
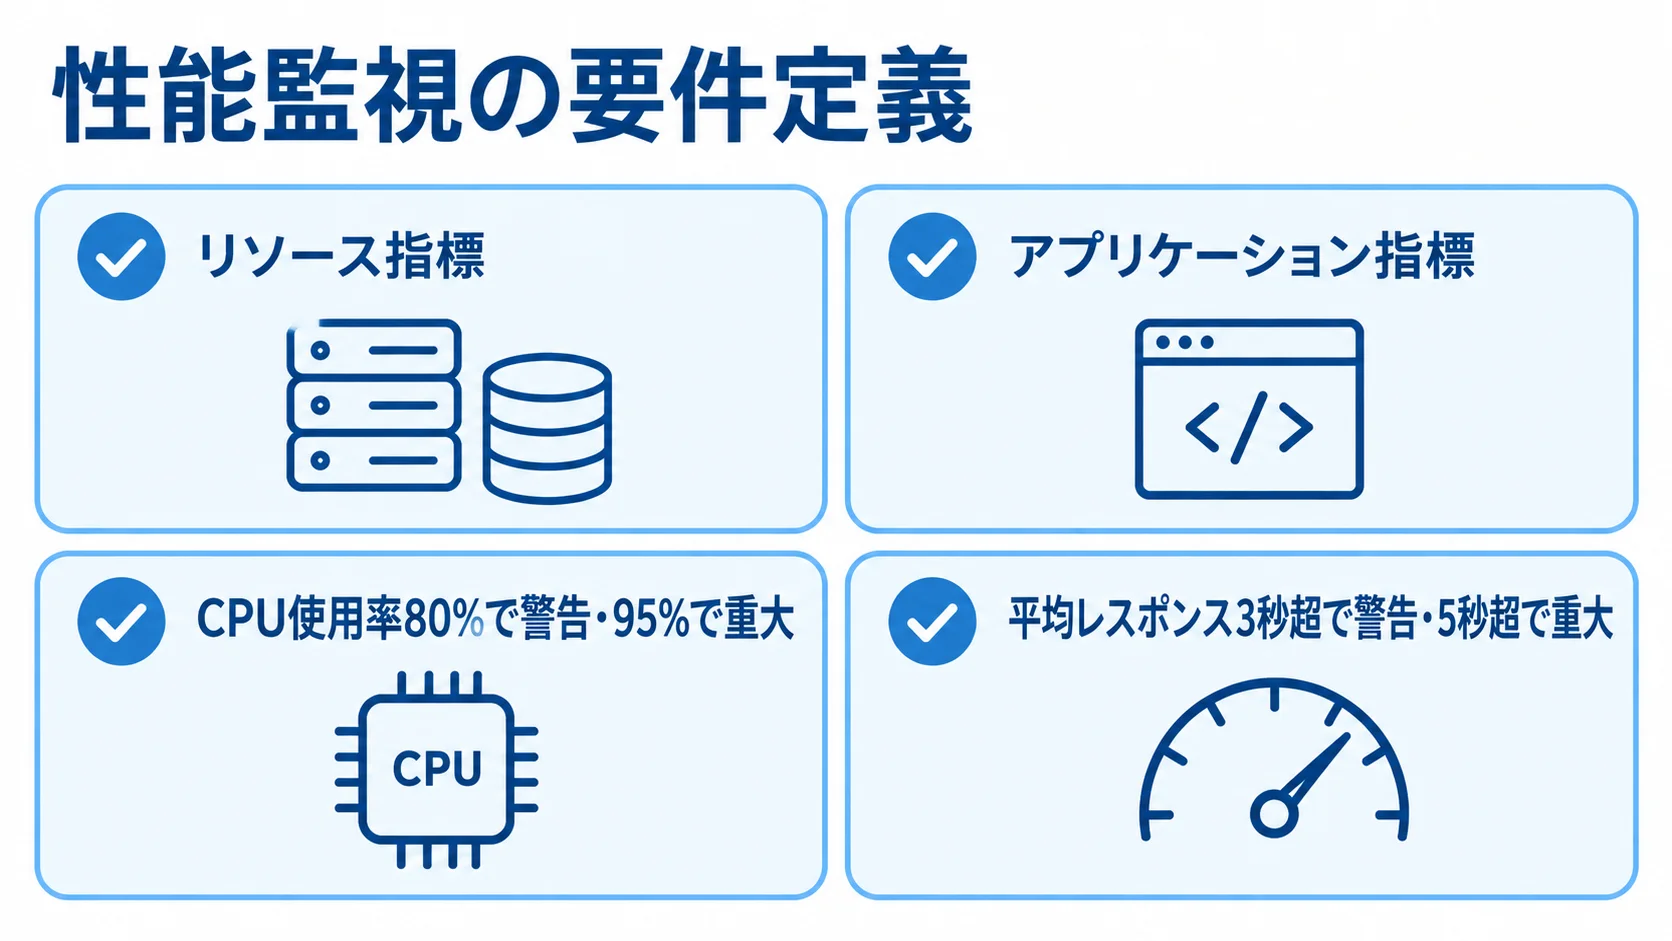
性能監視の要件定義で最初に固めるべきは、「何を監視するか(監視項目)」と「どの値で異常とみなすか(閾値)」です。
ここが曖昧なままだと、ベンダーは最低限の死活監視だけで「監視しています」と主張できてしまい、肝心の性能劣化を見逃す契約になりかねません。
RFPには、対象システムごとに監視すべきメトリクスと、警告・重大の二段階以上の閾値を、できる限り数値で書き込むことが大切です。
監視対象メトリクスと収集間隔
RFPには、サーバーなどの基盤を見るリソース指標と、アプリケーションの動きを見る指標の両方を、監視対象として列挙します。
あわせて、各指標の収集間隔(例:1分間隔か5分間隔か)と、データの保持期間も明記しておきます。収集間隔が粗いと短時間のスパイクを取り逃すため、システムの重要度に応じて要求水準を変えるとよいでしょう。
この監視項目の網羅性が、後の運用品質を左右します。たとえば、死活監視だけを依頼していると、「サーバーは生きているがレスポンスは極端に遅い」という劣化状態を検知できません。
要件定義の段階で、どの層まで多層の監視を求めるかを決めておくと、後から「見えていなかった」と悔やむ事態を防げます。範囲をどこまでとするかも、意識して決めておくことが大切です。
監視項目の表をRFPに添付し、ベンダーに対応可否を回答させると、提案同士の比較が明確になります。
- リソース指標:CPU使用率、メモリ使用量、ディスクI/Oと空き容量、ネットワーク帯域
- アプリケーション指標:レスポンスタイム、スループット、エラー率、データベースのスロークエリ
閾値とアラート時のアクション
監視項目を決めたら、各項目に警告・重大といった段階別の閾値を設定します。CPU使用率80%で警告・95%で重大、平均レスポンス3秒超で警告・5秒超で重大、といった具合です。
さらに重要なのは、閾値を超えたときに「誰が・何をするか」というアクションをセットで定義することです。アラートが鳴っても対応手順が決まっていなければ、監視は意味をなしません。
RFPには、閾値ごとの一次対応を書き出し、誰がそれを担うかを明記しておきます。
これを曖昧にすると、障害時に「それは契約範囲外です」と突き返され、対応が空白になりかねません。閾値とアクションを一体で要件化することが、検知を確実に解決へつなげる前提です。
閾値はシステム特性に応じて運用しながら調整するものなので、定期的な閾値見直しを契約に含めるかも検討しておきましょう。
- 一次対応の例:自動再起動、担当者通知、エスカレーションなど
- 担い手の区分:ベンダーが担う作業と、自社が担う作業
SLA(稼働率・初報応答・復旧時間)の数値定義
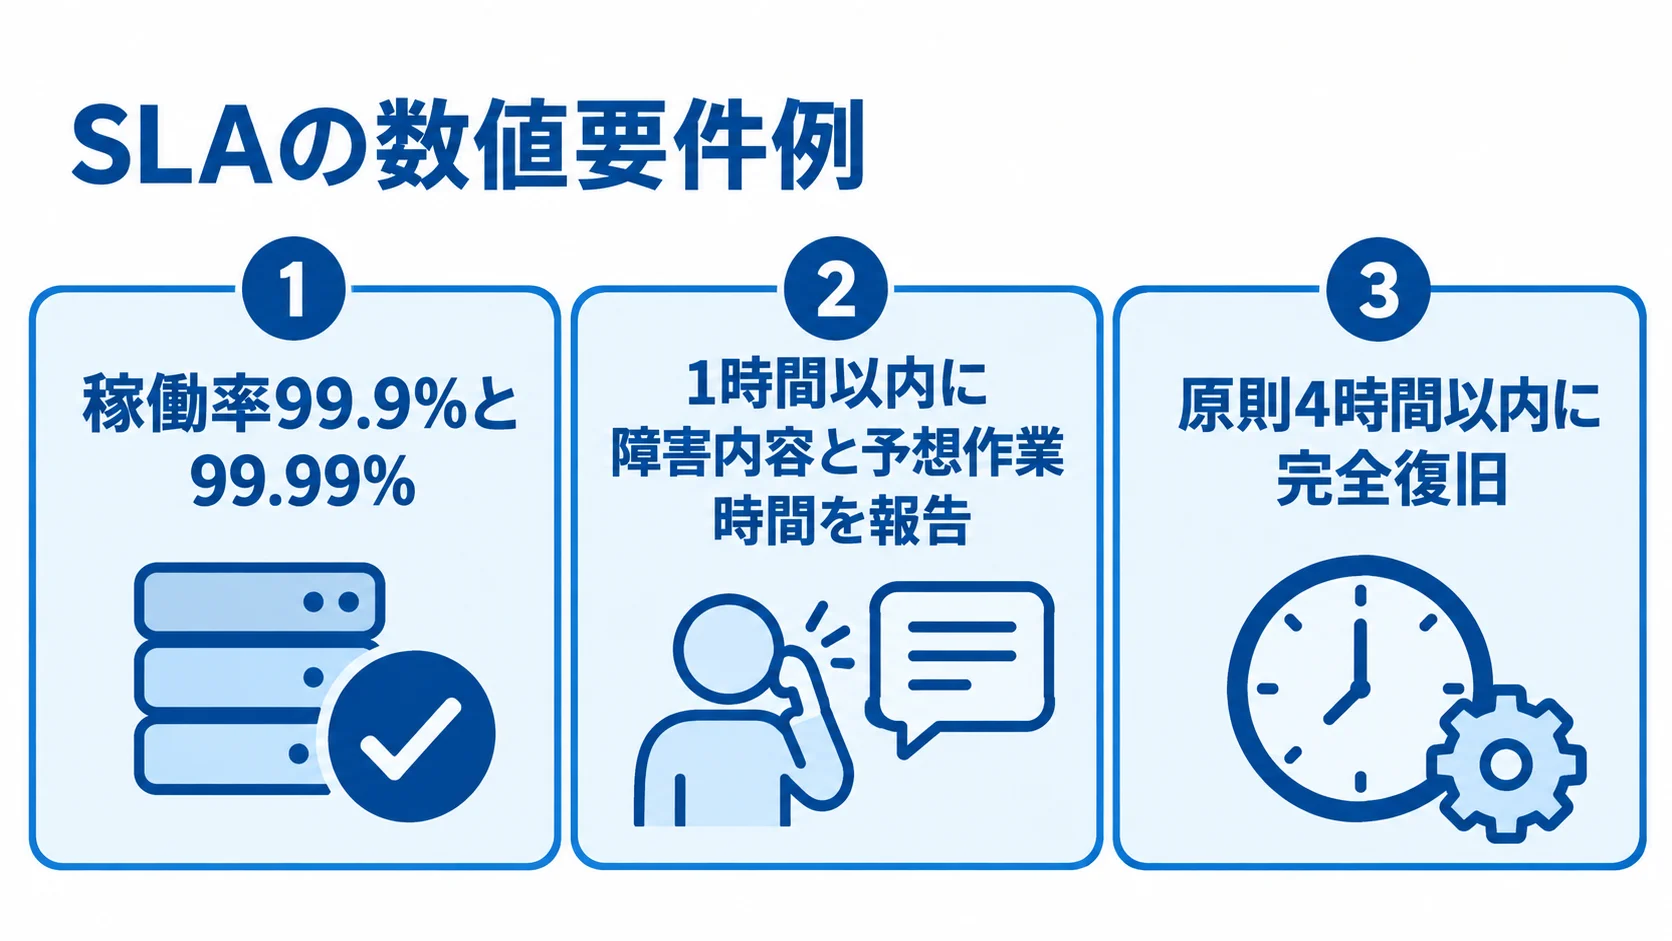
性能監視の要件定義では、監視項目と並んで重要なのがSLA(サービスレベル合意)です。
稼働率、障害発生時の初報応答時間、復旧目標時間を数値で定義することで、ベンダーに求める品質と、それに見合う費用が明確になります。
SLAは費用に直結するため、過剰にも過少にもならないよう、システムの事業影響度に見合った水準を要件に落とし込むことが肝心です。
稼働率99.9%と99.99%の違い
稼働率は「9」の数で許容ダウンタイムが変わります。一次データによれば、稼働率99.9%は年間約8.76時間・月約43.8分・日約7.3分の停止が許容範囲です。
また、99.99%は年間約52.6分・月約4.38分・日約4.4秒となります。この差は単なる数字の違いにとどまらず、「9」が1つ増えるごとに運用コストは段階的に跳ね上がります。99.99%を実現するには冗長構成や即応体制が必要になるため、費用も膨らみます。
だからこそ要件定義では、システムが止まったときの事業影響度から逆算して水準を決めることが大切です。「とりあえず高い稼働率」を求めると、必要以上の費用がかかりかねません。
基幹システムや顧客向けサービスは高い稼働率を、社内向けの補助システムは現実的な水準を、とメリハリをつけることが大切です。
- 要求稼働率:対象システムごとに明記し、根拠となる事業影響度の評価も共有すると、過不足のない提案を引き出せる
- 事前合意:過剰なSLAは無駄なコストを生むため、社内のビジネス部門と要求水準をあらかじめ合わせておく
初報応答時間と復旧目標時間
稼働率と並んで定義すべきなのが、障害発生時の応答・復旧に関する時間要件です。
一次データの官公庁仕様例では、1時間以内に現地到着・対処開始、1時間以内に障害内容と予想作業時間を報告、原則4時間以内に完全復旧、といった水準が示されています。
また、Cloud Naviでは重大インシデントについて15分以内の一次対応を保証しています。あるシーズホスティングでは、検知から60分以内に通知し、12時間で復旧する例もあります。
一般的な目標としては、重大障害で2時間以内に対応を開始し、24時間以内に完全解決することが一つの目安です。
RFPには、これらを参考に「初報(一次対応・状況報告)まで何分以内」「完全復旧まで何時間以内」を、重大度別に数値で要求します。
あわせて、SLA未達時のサービスクレジット(料金の一部返還)や、損害賠償の上限・免責条項についても確認しておくべきです。稼働率の数値だけでなく、未達時の扱いまで押さえることが、後のリスク管理につながります。
- 間接損害の扱い:機会損失など間接損害は、多くの契約で免責とされる
- 補償の線引き:未達時に何が補償され、何が補償されないかを明確にする
クラウド責任共有を前提とした責任分界
今や国内エンタープライズ・システムのクラウド比率は、2022年時点で約5割(IDC Japan)に達しています。
クラウド前提のシステムでは、性能監視の要件定義に「責任共有モデル」の視点が欠かせません。クラウド基盤側の障害は利用者が手出しできず、サービスクレジット以上の補償は受けられないことが多いためです。
要件定義では、どこまでが自社・ベンダーの責任で、どこからがクラウド事業者の領域かを明確に線引きする必要があります。
契約で定める監視の責任分界点
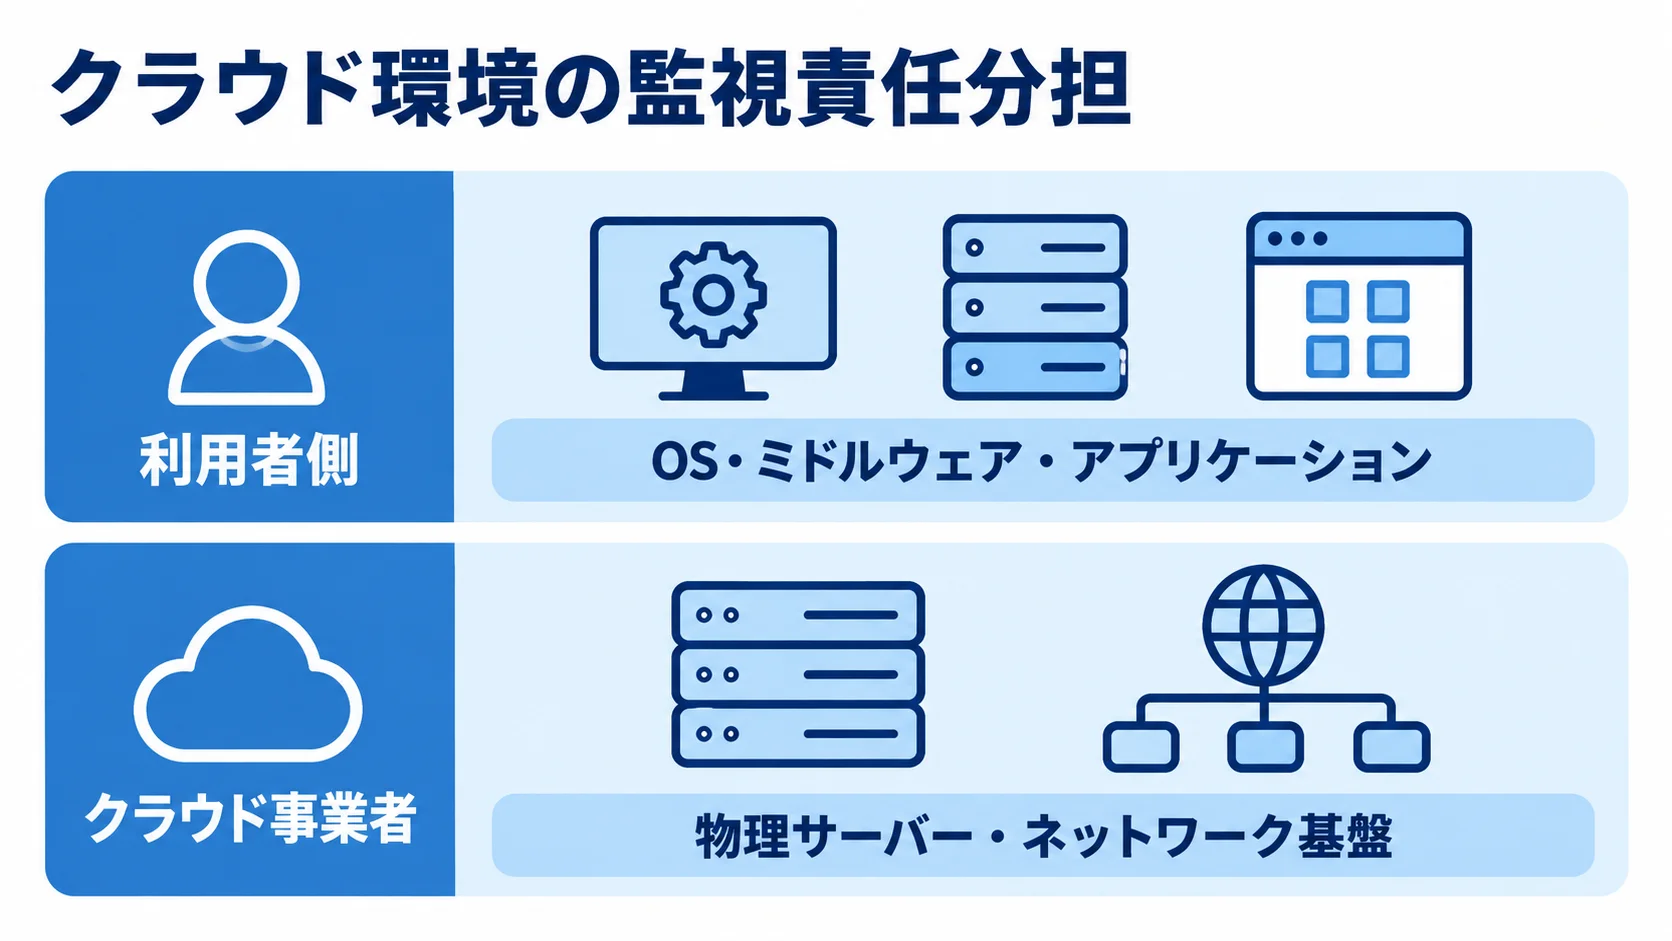
クラウド環境では、物理サーバーやネットワーク基盤はクラウド事業者が、その上で動くOS・ミドルウェア・アプリケーションは利用者側が責任を持つ、という分担が基本です。
性能監視の要件定義では、この分界点を踏まえて、監視の役割を文書で明文化します。
分界が曖昧だと、障害時に責任のなすり合いが起き、復旧が遅れます。
とくに注意したいのが、クラウド基盤の障害は利用者側で復旧できないという「監視のブラックボックス化」です。
基盤が落ちれば、いくら自社が監視していても手出しできず、サービスクレジットによる料金返還以上の補償は望めません。
要件定義では、マルチリージョン構成やフェイルオーバーといった自衛策を盛り込むか、どこまで許容するかを、事業影響度から判断します。
クラウドの便利さの裏にある「自分では直せない領域」を理解したうえで、要件を組むことが大切です。
- アプリケーション層:レスポンスの監視は委託先が担う
- クラウド基盤:障害情報は事業者のステータスページを参照する
発注者側の初動・報告フロー
性能監視の要件定義というと、ベンダーに求める監視内容ばかりに目が向きがちです。一方で、発注者(情シス)側の動きも要件に含めるべきです。
監視はベンダーに任せられても、社内への説明責任は自社に残ります。そのため、ベンダーから障害の初報を受けた後、社内の経営層や業務部門へどう状況を報告し、いつエスカレーションするかを決めておかないと、いざというとき情シスが立ち往生します。
発注者側の動きは、要件と運用設計の両方に盛り込んでおく必要があります。
性能劣化が事業に波及しそうなときに、誰が業務停止やサービス縮退の判断をするかまで決めておけば、混乱を最小化できます。
riplaは、フルスクラッチ受託と国内運用保守の立場から、ベンダー側の監視に加えて、発注者側の初動・報告フローまで含めた要件整理を支援しています。
監視の要件定義は、ベンダーと自社の両方の動きを一体で設計して初めて成り立ちます。
- 報告の流れ:障害レベルごとに、社内のどこへどの順で報告するか
- BCP(事業継続計画)との連動:重大障害時の意思決定者を、事業継続の計画とあわせて決める
監視ツール選定基準と対応範囲の明文化
性能監視のRFPでは、どの監視ツールを使うか、そして委託先の対応範囲がどこまでかを明文化することで、隠れコストを潰せます。
「安すぎる見積もり」の裏には、監視の欠如や対応範囲の狭さ、工数上限の設定が潜んでいることが少なくありません。ツールの選定基準と範囲定義を要件で固めることが、後の追加費用トラブルを防ぐ鍵になります。
OSS型とSaaS型の選定基準
監視ツールの選定では、OSS型とSaaS型のどちらを前提とするかを要件で示しておくと、提案の方向性が定まります。
OSSのZabbixはライセンスが無料ですが、自社運用では構築・維持の工数がかかります。一方、DatadogやNew Relicといったクラウド型SaaSは、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です。サーバー監視に強いMackerelのような選択肢もあります。
選定基準は要件に列挙し、ベンダーに適合性を回答させると、提案を並べて比べやすくなります。
ツールの機能だけでなく、それを使いこなす運用力までを含めて評価することが、見かけの安さに惑わされない選定につながります。
- 選定の観点:対応OS・ミドルウェア、クラウド環境への対応、APMやログ監視の有無、アラート連携先(チャット・電話)
- 見積もりの分け方:ツールのライセンス・利用料と運用人件費を分けて見積もらせる
対応範囲と工数上限による隠れコスト対策
要件定義でもっとも見落とされやすいのが、監視結果を受けた後の「対応範囲」の定義です。
性能劣化を検知した後、一次対応までを委託に含むのか、原因調査やチューニングまで含むのか、それとも検知して通知するだけなのかで、費用も価値も変わります。
一次データでは、運用・監視の費用相場は月5万〜20万円程度、障害対応は営業時間内で月3万〜8万円、24時間緊急対応で月10万〜20万円とされています。また、スポット1件で3万〜10万円という水準もあります。
作業区分ごとの費用の目安は、人月単価が業界一般で60万〜150万円、監視オペレーターは60万〜80万円、運用設計・インシデント分析は80万〜120万円です。
安すぎる見積もりは、対応範囲が「通知のみ」で実作業が別料金、というケースが典型です。対応範囲を要件で具体化し、見積もりを同じ土俵で比べることが、隠れコストを潰す最良の方法です。
- 月額に含む範囲:作業区分ごとに、どこまでを月額の対象とするかを明記させる
- 超過時の扱い:超えた場合の追加費用と、工数上限を超えたときの扱いを明確にさせる
まとめ
ITシステム性能監視のRFP・要件定義書では、押さえるべき柱は4つあります。
第一に、監視項目と段階別の閾値、そして閾値超過時のアクションを数値で定義することです。
第二に、SLA(稼働率99.9%か99.99%か、初報応答・復旧目標時間)を事業影響度から逆算して定めることです。
第三に、クラウドの責任共有を前提に、責任分界点と発注者側の初動・報告フローを明確にすることです。
第四に、監視ツールの選定基準と対応範囲を明文化し、安すぎる見積もりに潜む隠れコストを潰すことです。
要件定義で大切なのは、自社が守りたいものを数値と範囲で具体的に示し、ベンダーに任せきりにしないことです。
要件の数値と範囲を明確にできれば、相見積もりの比較も容易になり、運用開始後の「測れていなかった」「範囲外だった」というトラブルを未然に防げます。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、性能監視の要件整理から運用設計、発注者側のフロー作りまで一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。