
性能監視を入れても、いざというときに役立たなかったという声は少なくありません。その失敗や課題、リスクは、設計・契約・組織の備えという5つの観点で整理できます。
発注企業の情シスの視点から、各観点の失敗と注意点を解説します。全体像から知りたい方は、まずITシステム性能監視の完全ガイドをお読みください。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
クラウド監視のブラックボックス化というリスク
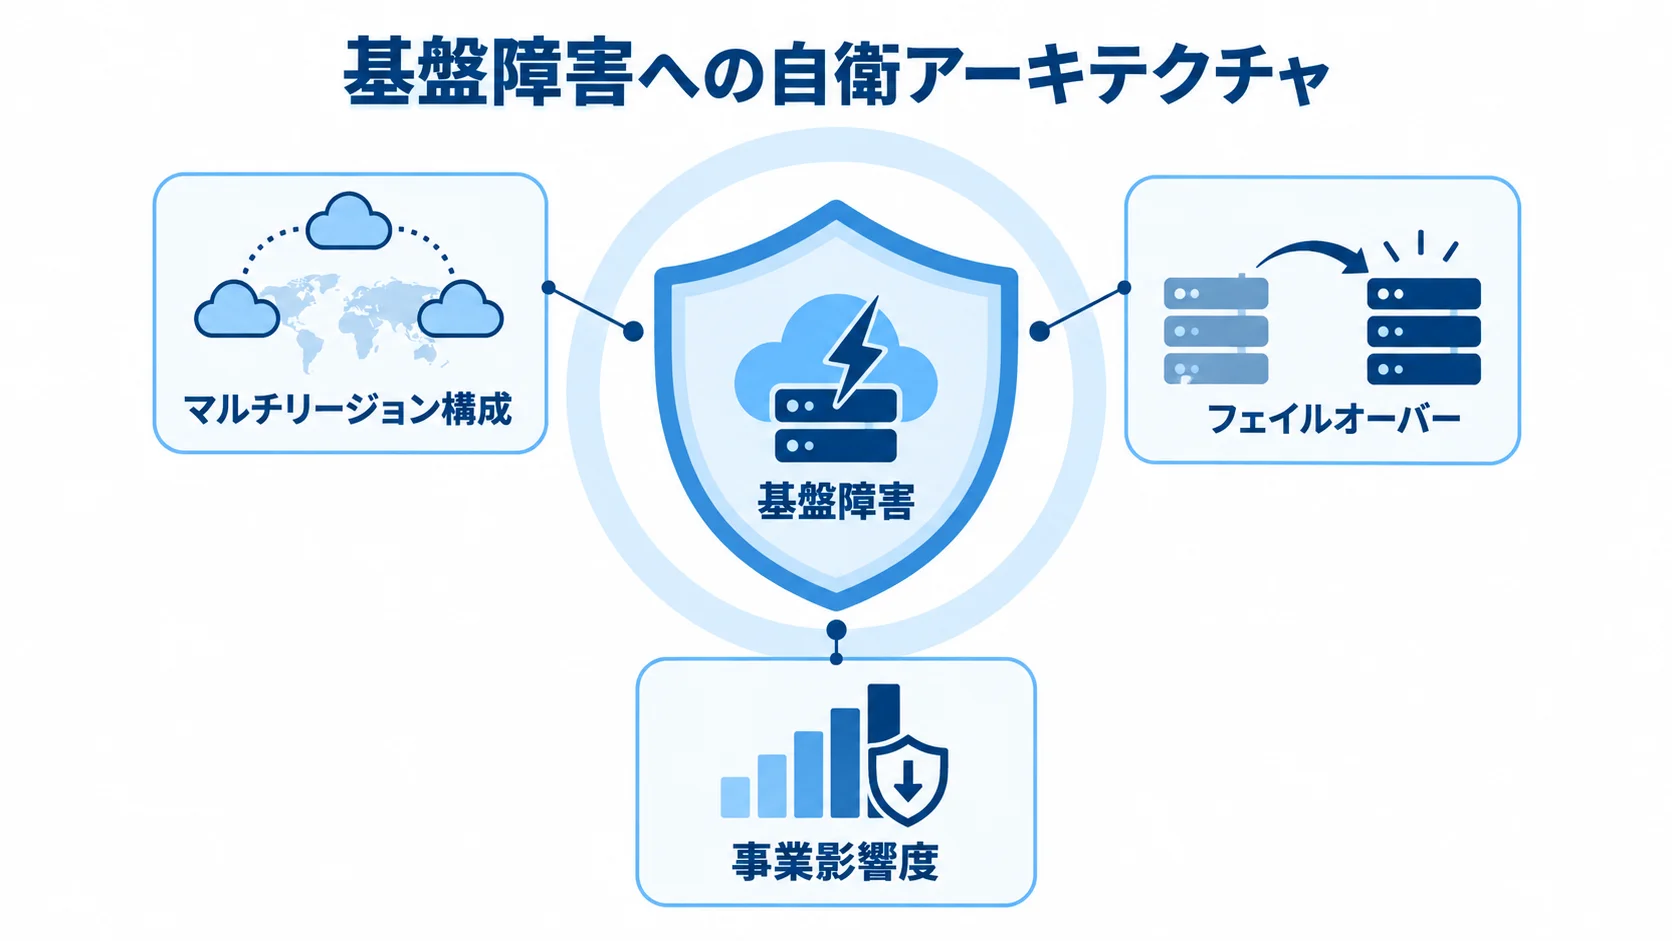
クラウドやSaaSへの移行が進むなかで、見落とされやすいのが「監視のブラックボックス化」というリスクです。国内エンタープライズ・システムのクラウド比率は2022年で約5割(IDC Japan)に達していますが、クラウド基盤の内部は利用者から見えず、基盤障害が起きても自社では手出しができません。便利さの裏にあるこの「自分では直せない領域」が、性能監視の盲点になります。
クラウド基盤障害はクレジット以上の補償がないリスク
クラウド基盤で障害が起きても、利用者にできることは限られ、復旧は基盤側の対応を待つしかありません。自社の監視で異常を早く検知しても、復旧の時期はクラウド事業者次第です。
さらに深刻なのは補償で、多くのクラウドサービスでは、SLA未達時の補償はサービスクレジット(料金の一部返還)にとどまり、それ以上の損害賠償は受けられません。基盤障害で大きな機会損失が出ても、返ってくるのは利用料の数パーセントということが珍しくありません。基盤障害の損失は、クレジットの返還額をはるかに上回ります。
このリスクを軽視すると、基盤障害時に「監視していたのに何もできなかった」「補償もほとんどなかった」という事態に陥ります。一次データでは、ダウンタイムは1分あたり約5,600米ドル(Gartner 2024)、5分以上の停止1回で平均1,200万円の機会損失(総務省2025年版)とされています。直せない領域のリスクを正しく見積もることが、対策の出発点です。
マルチリージョン等の自衛アーキテクチャ
ブラックボックス化への対策は、監視を増やすことよりも、基盤障害に耐えるアーキテクチャを設計することにあります。具体的には、マルチリージョン構成で一つの地域が落ちても別の地域でサービスを続ける、フェイルオーバーで自動的に切り替える、といった自衛策です。これらは初期設計で組み込まないと後から追加しにくいため、システム構築の段階でリスクを織り込んでおく必要があります。
ただし、自衛アーキテクチャには隠れコストが伴います。マルチリージョン化はインフラ費用が増え、構成も複雑になるぶん、運用負荷も上がります。そのため、すべてのシステムに一律に適用するよりも、止まると事業に致命傷を与える重要システムに絞って投資する判断が求められます。
事業影響度を評価し、どこまでの基盤障害を許容し、どこからは自衛するのかを決めておく必要があります。クラウドの監視は、アーキテクチャ設計で守るという発想に切り替えることが、ブラックボックス化リスクへの本質的な答えになります。
過剰SLAと過少SLAの両方が招く失敗
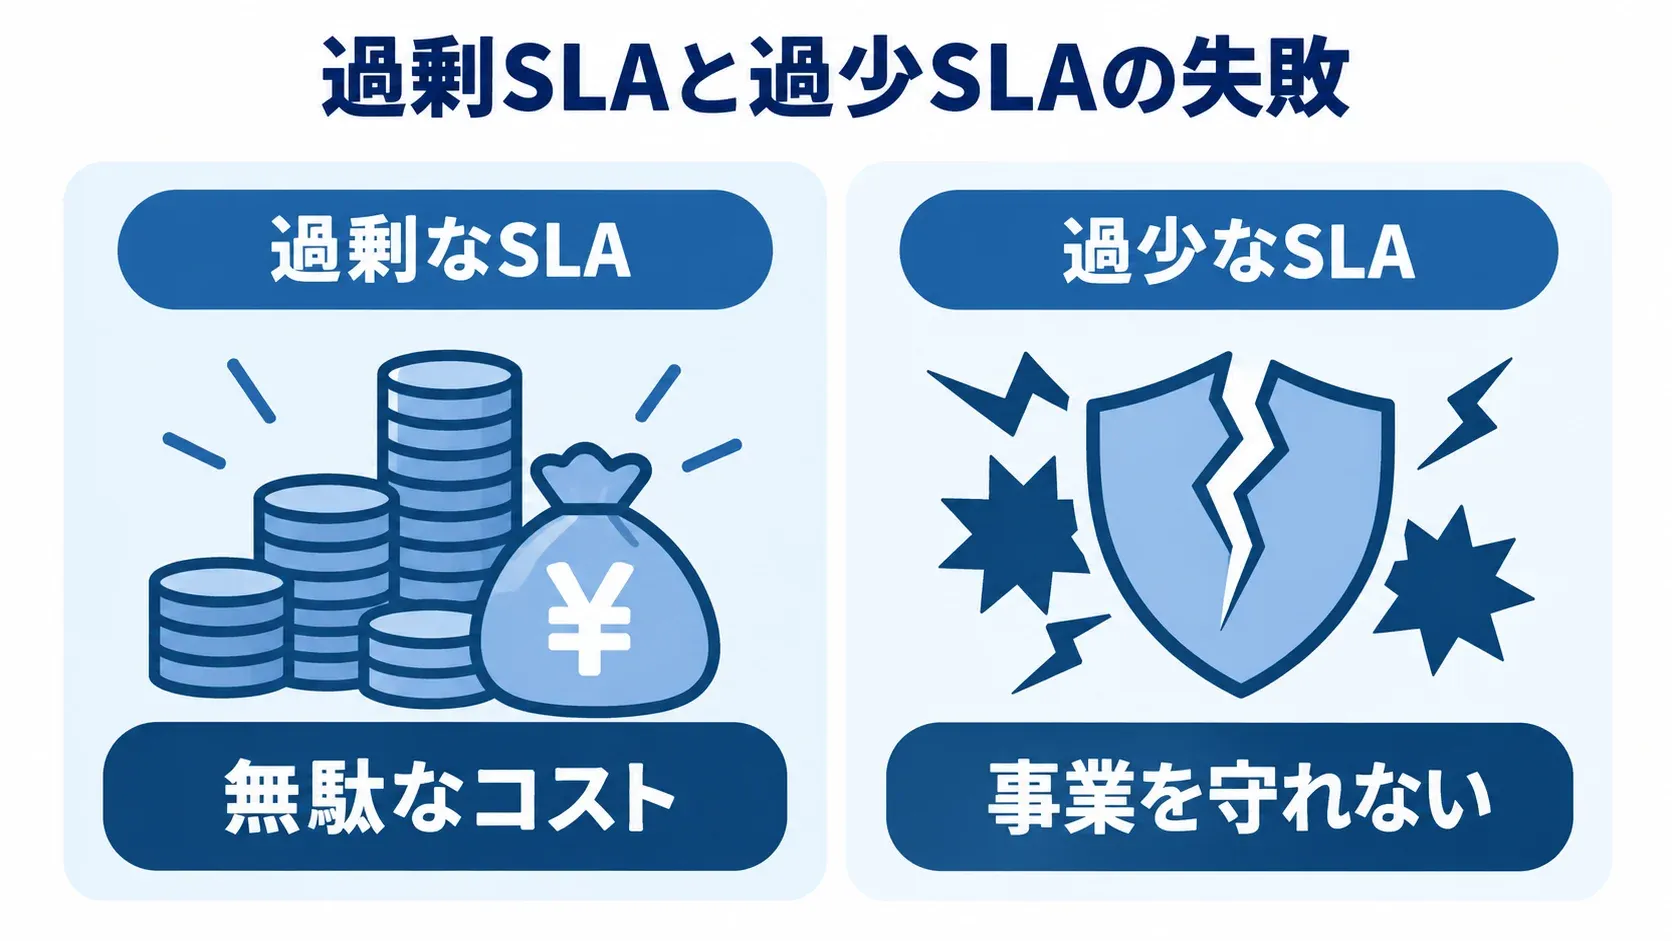
SLAは、高すぎても低すぎても失敗につながります。過剰なSLAは無駄なコストを生み、過少なSLAでは事業を守れません。
多くの企業は「とりあえず高い稼働率を」と過剰側に振れがちです。一方で、費用を削りすぎて必要な保証を欠くケースもあります。両方の失敗を避けるには、事業影響度から逆算して適正な水準を見極めることが鍵です。
過剰な稼働率SLAが招くコストの無駄
過剰SLAの典型は、影響度の低いシステムにまで99.99%を求めるケースです。一次データによれば、99.9%は年間約8.76時間の停止が許容範囲ですが、99.99%は年間約52.6分・月約4.38分と、桁違いに厳しくなります。「9」が1つ増えるごとに運用コストは段階的に跳ね上がり、冗長構成や即応体制が必要になります。
そのため、社内向けの補助システムにこの水準を求めると、得られる安心に対して費用が見合いません。過剰SLAが放置されやすい背景には、社内調整の難しさがあります。一度決めた高い水準を下げようとすると、ビジネス部門から「品質を落とすのか」と反発されやすく、情シスは言い出しにくいものです。
しかし、事業影響度アセスメントで「このシステムは夜間に多少止まっても業務影響は限定的」と客観的に示せば、説得は可能になります。過剰SLAの是正は、技術の問題というより社内合意の問題です。事業影響度という共通の言葉で部門を巻き込み、適正な水準へ落とすことが、無駄なコストを断つ方法です。
過少SLAと「努力目標止まり」のリスク
逆方向の失敗は、コストを削りすぎてSLAが過少になるケースです。重要システムなのに復旧時間の保証がなく、努力目標止まりの契約だと、いざ障害が起きたときに「いつ直るか分からない」状態に置かれます。一次データの一般目標では、重大障害に2時間以内に対応を開始し、24時間以内に完全解決する水準が示されています。
また、官公庁仕様の例では、原則4時間以内に完全復旧という水準もあります。こうした保証がなければ、ベンダーの対応は後回しにされかねません。さらに注意したいのは、SLAが保証型であっても、補償は多くがサービスクレジットにとどまり、間接損害(機会損失)は免責で、賠償の上限も設けられている点です。
つまり、過少SLAでは保証そのものが弱く、保証型でも実際の損害の全額は戻りません。重要システムには、事業影響度に見合った復旧時間の保証を確保しつつ、補償の限界も理解しておく必要があります。過少SLAの失敗を避けるには、削ってよいところと削ってはいけないところを、システムの重要度で見分けることが欠かせません。
安すぎる見積もりとベンダー丸投げの落とし穴
性能監視の委託先を選ぶとき、つい価格の安さに目が行きがちです。しかし、「安すぎる見積もり」には、対応範囲の狭さや監視の欠如、工数上限といった落とし穴が潜んでいることが少なくありません。
また、監視を委託したからと安心して丸投げすると、いざというときに自社が立ち往生します。価格だけで選ぶリスクと丸投げのリスクの両方を理解しておくことが、委託先選びの前提になります。
安さの裏にある監視欠如と隠れコスト
相場より極端に安い見積もりは、しばしば次のような条件を伴います。
- 「監視はするが対応は別料金」
- 「死活監視のみで性能監視は含まない」
- 「工数に上限があり超過分は追加請求」
一次データでは、運用・監視の相場は月5万〜20万円、障害対応は営業時間内で月3万〜8万円、24時間緊急対応で月10万〜20万円が目安です。相場を大きく下回る価格は、何かが含まれていない可能性を疑うべきです。
安さに飛びついた結果、障害の発生時に「それは契約範囲外です」と追加費用を請求され、トータルでは割高になることがあります。さらに、肝心の性能劣化を検知できていなかったという失敗も後を絶ちません。
見積もりは、価格より先に監視項目や対応範囲をそろえ、SLAや工数上限も同じ条件で比べることが大切です。安すぎる見積もりは、隠れコストや監視欠如のサインと捉えるべきです。そのうえで、「何が含まれ、何が含まれないか」を必ず確かめる慎重さが、失敗を避ける力になります。
ベンダー丸投げと切り替え困難のリスク
監視を委託すること自体は合理的ですが、すべてをベンダー任せにして自社に知見が残らないと、別のリスクが生まれます。一つは、ベンダーの対応品質を評価できなくなることです。監視レポートの意味も分からず、性能が本当に守られているか判断できないまま、形だけの委託が続きます。
もう一つは、ベンダーを切り替えにくくなることです。監視設定やノウハウがベンダーに閉じていると、別の委託先へ移す際に多大な手間がかかり、実質的に乗り換えられなくなります。riplaはフルスクラッチ受託と国内運用保守の立場から、委託であっても「設定とノウハウを発注者側に開示し、いつでも内製化や切り替えができる」透明な運用を重視しています。
このリスクを避けるには、委託しつつも、監視項目や閾値、運用手順を自社でも把握して文書に残すことが大切です。さらに、切り替えに備えて、解約予告の条件や、監視設定やアカウントの引き渡し範囲を契約段階で確認しておくべきです。要所を自社が握ったまま委託する姿勢が、ベンダーロックインの失敗を防ぎます。
発注者側の初動失敗(報告遅延・BCP不在)
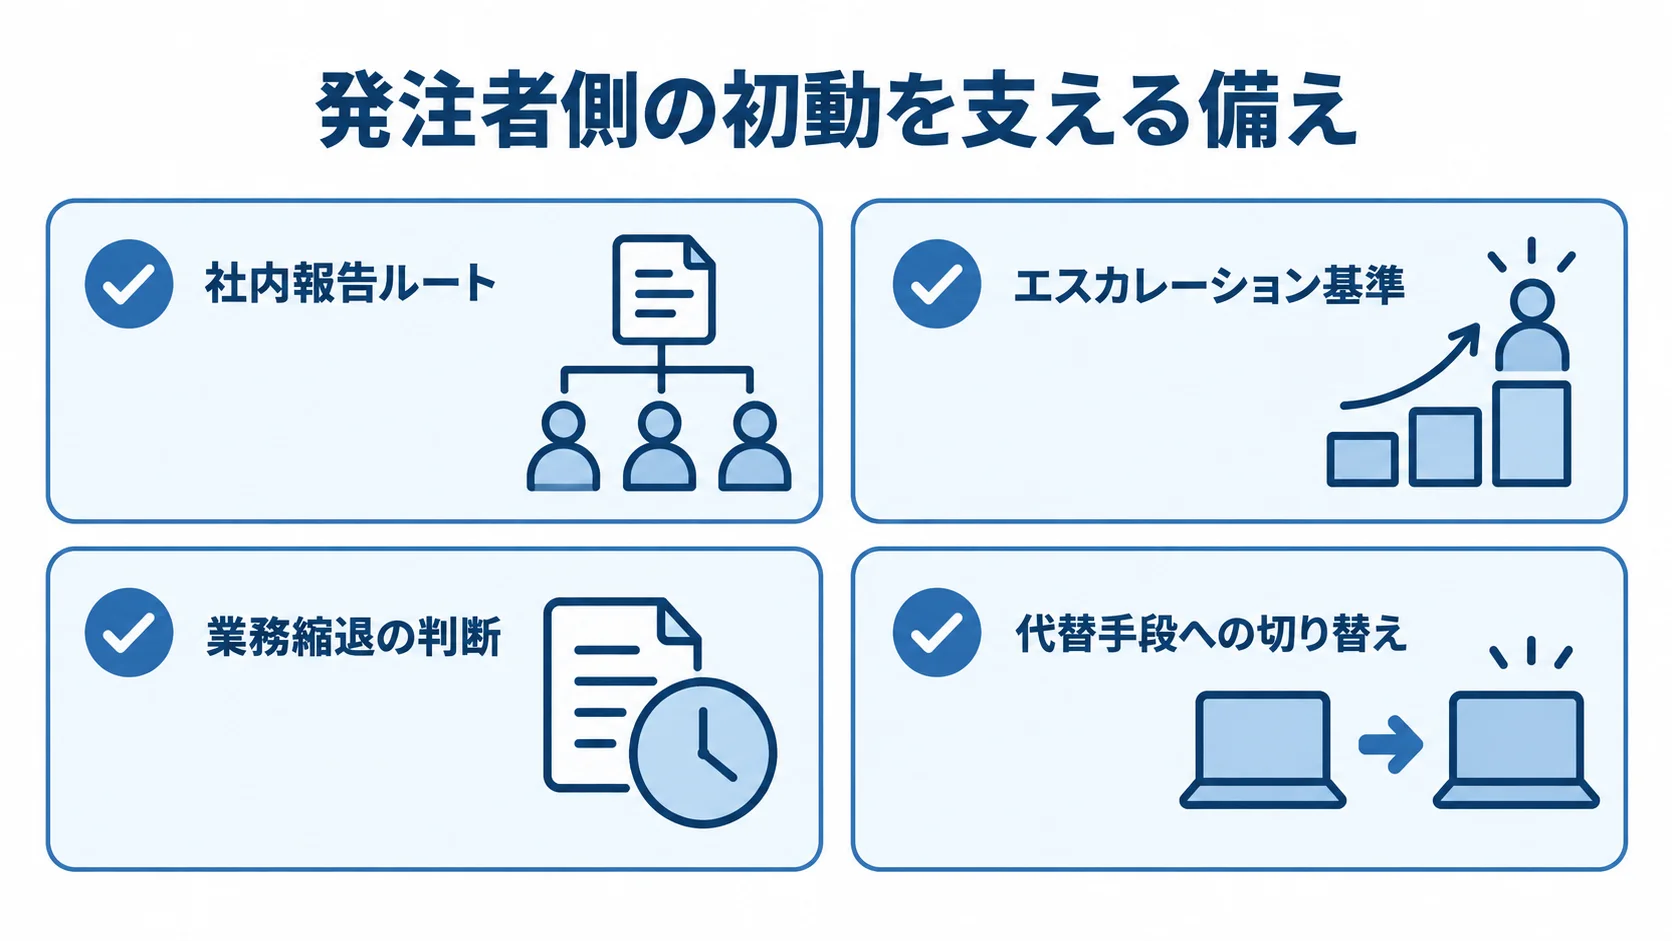
性能監視の失敗は、ベンダー側だけでなく発注者側でも起きます。むしろ語られにくいのが、発注者(情シス)側の初動の失敗です。
ベンダーから障害の初報を受けても、社内への報告が遅れ、業務部門や経営層への連絡が後手に回ると、技術的には対応していても、組織としては混乱します。監視はベンダーに委託できても、社内対応の責任は自社に残ります。
社内報告・エスカレーションの遅れという失敗
障害が起きたとき、情シスには技術対応に加えて社内の対応も求められます。経営層へ状況を報告し、業務部門へ影響範囲と復旧見込みを伝え、必要なら顧客対応の判断を仰ぐ必要があります。報告ルートが事前に決まっていないと、誰に何をいつ伝えるかで迷い、初動が遅れます。
技術的な復旧が進んでも、社内では「何が起きているか分からない」という混乱が広がります。この失敗を避けるには、障害レベルごとの社内報告ルートとエスカレーション基準を平時に決めておくことが欠かせません。一次データでは、ベンダー側の初報を1時間以内に障害内容と予想作業時間を報告する例や、検知から60分以内に通知する例があります。
ただし、その初報を受けた情シスが社内へどう展開するかまで設計されていなければ、対応の連鎖は途切れます。監視の出口は、ベンダーからの通知の先にある社内の意思決定です。報告フローの整備は、性能監視を組織として機能させる前提条件です。
BCP不在で初動が止まる失敗
もう一つの発注者側の失敗は、BCP(事業継続計画)の不在です。重大な性能障害でシステムが長時間使えなくなったとき、「業務をどう継続するか」「サービスを縮退するか停止するか」「代替手段に切り替えるか」という判断基準がなければ、現場は止まってしまいます。BCPがないと、技術的な復旧を待つ間、業務が完全に空白になるリスクを抱えることになります。
性能監視は、BCPと連動して初めて事業を守る力になります。監視で異常を検知したら、誰が業務縮退を判断し、どの代替手段に切り替えるかという初動を、BCPに組み込んでおくことが大切です。そうしておけば、システム障害が事業停止に直結する事態を防げます。
riplaはフルスクラッチ受託と国内運用保守の立場から、ベンダー側の監視だけでなく、発注者側の初動・報告フロー・BCP連動までを含めた「組織として機能する監視」を重視しています。性能監視の失敗の多くは、技術ではなく、発注者側の備えの欠如から生まれます。
まとめ
性能監視の失敗・課題・リスクを振り返ると、つまずきは5つに集約されます。一つ目は、クラウド監視のブラックボックス化で、基盤障害には手出しができず、補償もクレジット止まりです。二つ目は過剰SLAの無駄と過少SLAの保証不足、三つ目は安すぎる見積もりに潜む監視欠如と隠れコストです。
四つ目は、ベンダー丸投げによる評価不能と切り替え困難です。五つ目は、発注者側の報告遅延とBCP不在による初動の失敗です。いずれも技術力ではなく、設計・契約・組織の備えの問題だという点が共通しています。
これらの失敗を避けるには、性能監視を「ツールを入れれば終わり」と考えないことが出発点です。事業影響度から逆算してSLAと自衛アーキテクチャを設計し、対応範囲を明文化したうえで、発注者側の初動や報告、BCPまでを一体で整えることが求められます。
クラウドの直せない領域や安さの裏のリスク、丸投げの危うさを直視し、要所を握りながら委託する姿勢が、性能監視を本当に事業を守る仕組みに変えます。riplaはフルスクラッチ受託と国内運用保守を組み合わせ、こうした失敗を先回りで防ぐ監視設計を一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。