
死活監視の導入による成果は、停止に気づくまでの時間、復旧までの時間、担当者の負担、SLAの設定がどう変わったかに現れます。ツール名やpingの監視間隔といった技術論だけを並べた記事は多いです。一方、この記事は、ITシステム死活監視の導入・開発・活用・成功の事例に絞り、発注企業の情シスの視点から、自社に近い規模や体制でどんな成果が出たのかを掘り下げます。
なお、死活監視の全体像や費用相場をまだ把握していない方は、まずITシステム死活監視の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ダウンタイムを削減したBefore/After事例
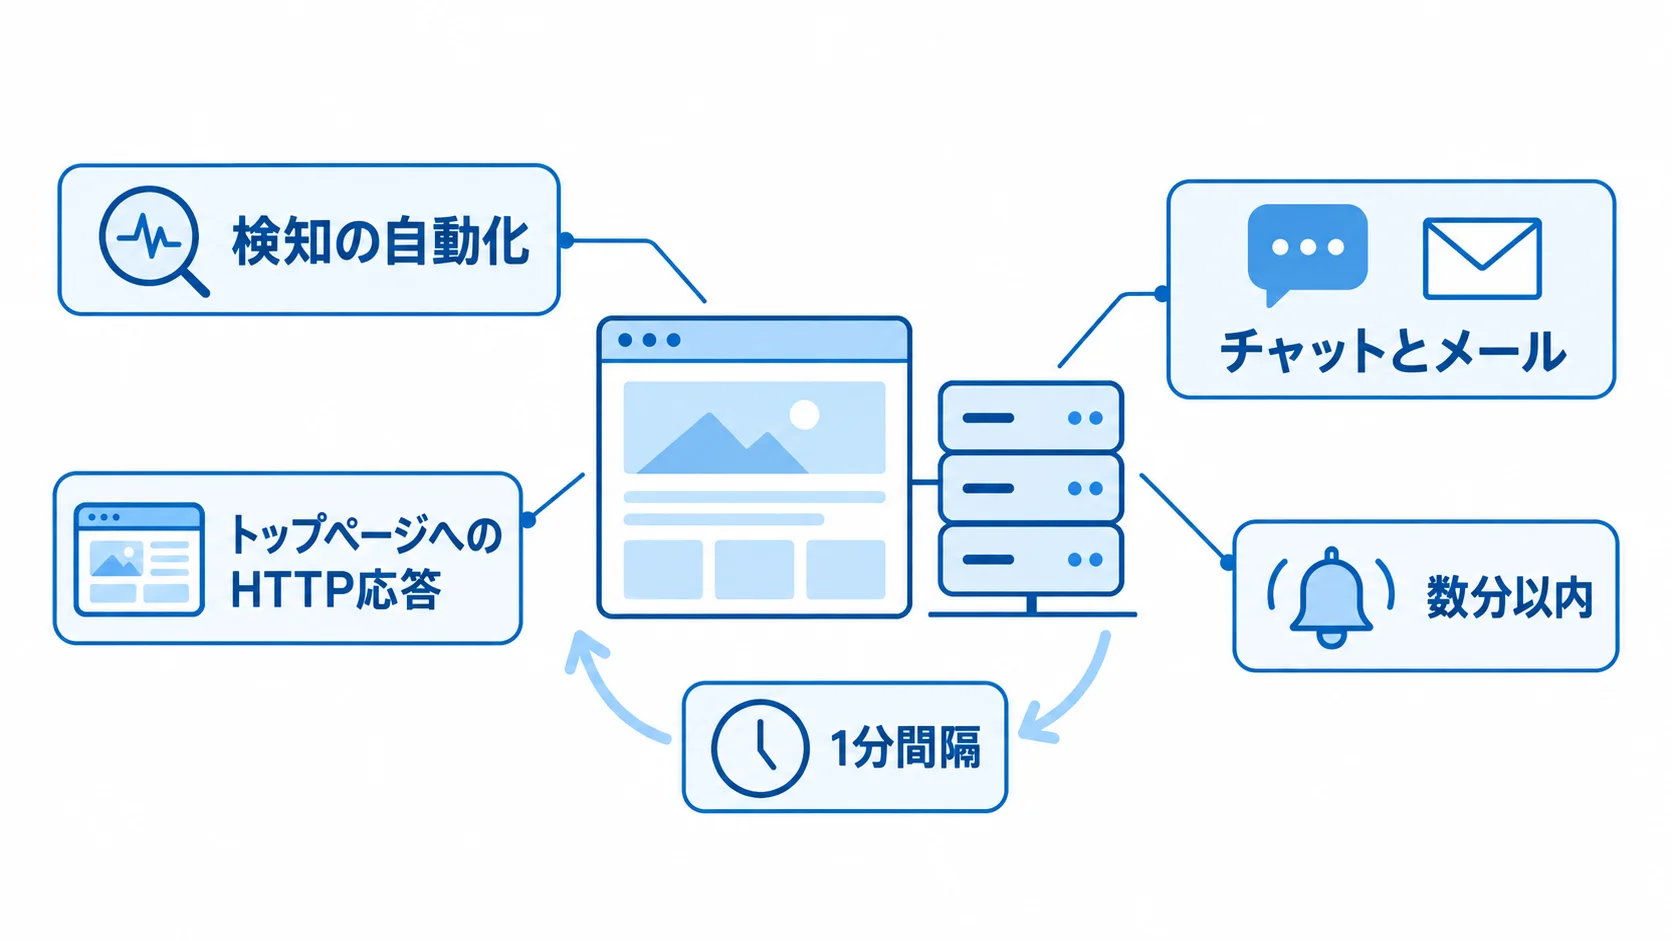
死活監視の事例で、もっとも価値が伝わりやすいのは、「停止が起きてから気づくまでの時間(検知時間)」と「復旧までの時間(MTTR)」の改善です。死活監視がない状態では、障害に気づくきっかけがお客様からの問い合わせ電話になりがちで、そのときにはすでに業務やビジネスに影響が出ています。導入前後の数字を並べると、死活監視がもたらす効果の本質が見えてきます。
検知が「客からの電話」から「数分で自動通知」に変わった事例
この事例は、「ダウンタイムを削減したBefore/After事例」で検知時間が改善した例です。あるBtoBサービスを運営する企業では、ECサイトの停止に最初に気づくのは、いつも得意先からの「サイトが開かない」という連絡でした。連絡を受けてから状況を確認し、原因を切り分けるまでに30分以上かかり、停止からの累計で1時間以上ダウンしている状態が常態化していたのです。
そこで、死活監視を導入し、サイトのトップページへのHTTP応答を1分間隔で確認する仕組みにしました。停止が起きると、数分以内にチャットとメールへ自動でアラートが届きます。この検知の自動化だけで、停止に気づくまでの時間は1時間から数分へと短くなりました。
総務省の2025年版の資料では、金融・医療・EC系の場合、5分以上の停止1回あたり平均1,200万円の機会損失が生じるとされています。さらに、検知が数十分早まることは、そのまま損失の圧縮につながります。
死活監視が果たすのは、障害に最速で気づき、対応を始められる状態をつくることです。障害そのものをゼロにはできなくても、気づきが早いほど影響範囲は小さく抑えられます。
自社の検知を見直すときは、停止にどこで気づいているかと、気づくまでにどれだけ時間がかかっているかを分けて確かめます。
- 気づくきっかけ:停止がお客様からの連絡で分かっていないか、自社の停止を一覧にして洗い出す
- 気づくまでの時間:連絡を受けてから原因を切り分けるまでの時間を、事前に把握しておく
MTTRを定量化して経営に説明できるようになった事例
この事例は、「ダウンタイムを削減したBefore/After事例」で、MTTRを経営に説明できるようになった例です。
死活監視の効果を経営層に説明するうえで強力なのが、MTTR(平均復旧時間)という指標です。導入前は「なんとなく時々止まる」という曖昧な認識でした。一方、死活監視のログによって、「先月は3回停止し、平均復旧時間は52分だった」というように、停止回数と復旧時間を数字で示せるようになりました。
数字になると、改善目標も「平均復旧時間を30分以内にする」のように具体的に定められ、投資の判断にも使えます。
ある中堅企業の事例では、死活監視の導入で停止の検知と記録が自動化された結果、四半期ごとに停止回数とMTTRを経営会議で報告できるようになりました。
死活監視は、「なんとなく安心のためのコスト」と見られる段階から、「ダウンタイムという経営リスクを数字で管理する仕組み」へと位置づけが変わりました。
Gartnerの2024年の調査では、ダウンタイムは1分あたり平均5,600米ドルのコストとされています。そのため、停止時間を数字で語れることは、追加投資の稟議を通すうえで有力な説得材料になります。
死活監視は、安心を得るための仕組みというより、数字を生む仕組みと捉えるのが、事例から学べる第一の教訓です。
経営層への報告は、死活監視のログを期間ごとに集計し、数字で示すところから始まります。
- 停止回数:死活監視のログから、停止した回数を期間ごとに集計する
- 平均復旧時間:停止ごとの復旧時間から平均を出し、報告の中心に置く
ひとり情シスが死活監視を委託した事例
中小企業に多い「ひとり情シス」「兼任情シス」にとって、死活監視はとくに切実なテーマです。社内のシステムを一人で見ている担当者が、24時間365日いつ止まるか分からないサーバーを監視し続けるのは、現実的ではありません。
夜間や休日に停止が起きても気づけない、あるいは私用スマホに通知が届いて実質的に24時間拘束される、という負荷が担当者にのしかかります。この負担を外部委託で解消した事例を紹介します。
夜間の私用スマホ監視から解放された事例
あるひとり情シスの担当者は、基幹サーバーの死活を自宅のPCと私用スマホで監視し、深夜でもアラートが鳴れば対応する生活を続けていました。これでは休暇も取りづらく、退職リスクも高まります。
そこで、サーバー単位で死活監視を外部のサービスに委託する形に切り替えました。一次データでは、サーバー監視は1台あたり月3,000円〜で、障害発生時の一次対応を含めても1台あたり月10,000円程度から委託できるサービスがあります。また、フルマネージドでも月20,000円程度が一つの相場です。
この企業では、数台のサーバーを月数万円で、死活監視から一次対応まで委託しました。その結果、担当者は夜間や休日に私用スマホを気にする必要がなくなりました。
外部に任せたのは、「一次検知と切り分けという属人的で時間に縛られる部分」です。情シスの仕事は残りますが、担当者は本来やるべきシステム企画や改善に時間を使えるようになりました。
この事例が示すのは、死活監視の委託が、コストの増加ではなく「担当者の時間とメンタルを守る投資」だということです。
委託を検討するときは、どこまでを外部に任せ、どこを社内に残すかを先に線引きしておく必要があります。
- 委託の範囲:死活監視だけにするか、障害発生時の一次対応まで含めるか
- 委託先との分担:検知と切り分けを任せる範囲と、社内で判断する範囲を分けて決める
属人化を解消し引き継ぎ可能にした事例
ひとり情シスのもう一つの問題が、監視の属人化です。「あのサーバーが止まったときは、あの担当者しか対応できない」という状態は、その人が休んだり退職したりした瞬間に、事業継続のリスクになります。
死活監視を外部に委託した事例では、運用の決まりごとがサービス側の運用設計として文書化されます。そのため、担当者個人の頭の中にしかなかった暗黙知が、引き継げる仕組みに変わりました。
文書があれば、担当者が代わっても監視の水準は維持され、採用や異動のたびに監視がリセットされる事態を防げます。
riplaのようにシステムを作った後の運用保守まで国内で伴走する立場から見ても、死活監視の委託は単なるアラートの転送ではなく、監視という業務そのものを属人化から救い出すことに価値があります。
文書には、監視の範囲と、アラートをどの順で誰に知らせるかを書いておきます。
- 監視の範囲:どのサーバーのどのポートを、何分間隔で監視するか
- アラートと通知順:何回連続で応答がなければ通知するか、誰にどの順で知らせるか(エスカレーション)
過剰SLAを適正化してコスト削減した事例
死活監視の事例で見落とされがちなのが、「監視と稼働率の目標(SLA)が過剰で、コストを払い過ぎていた」というケースです。
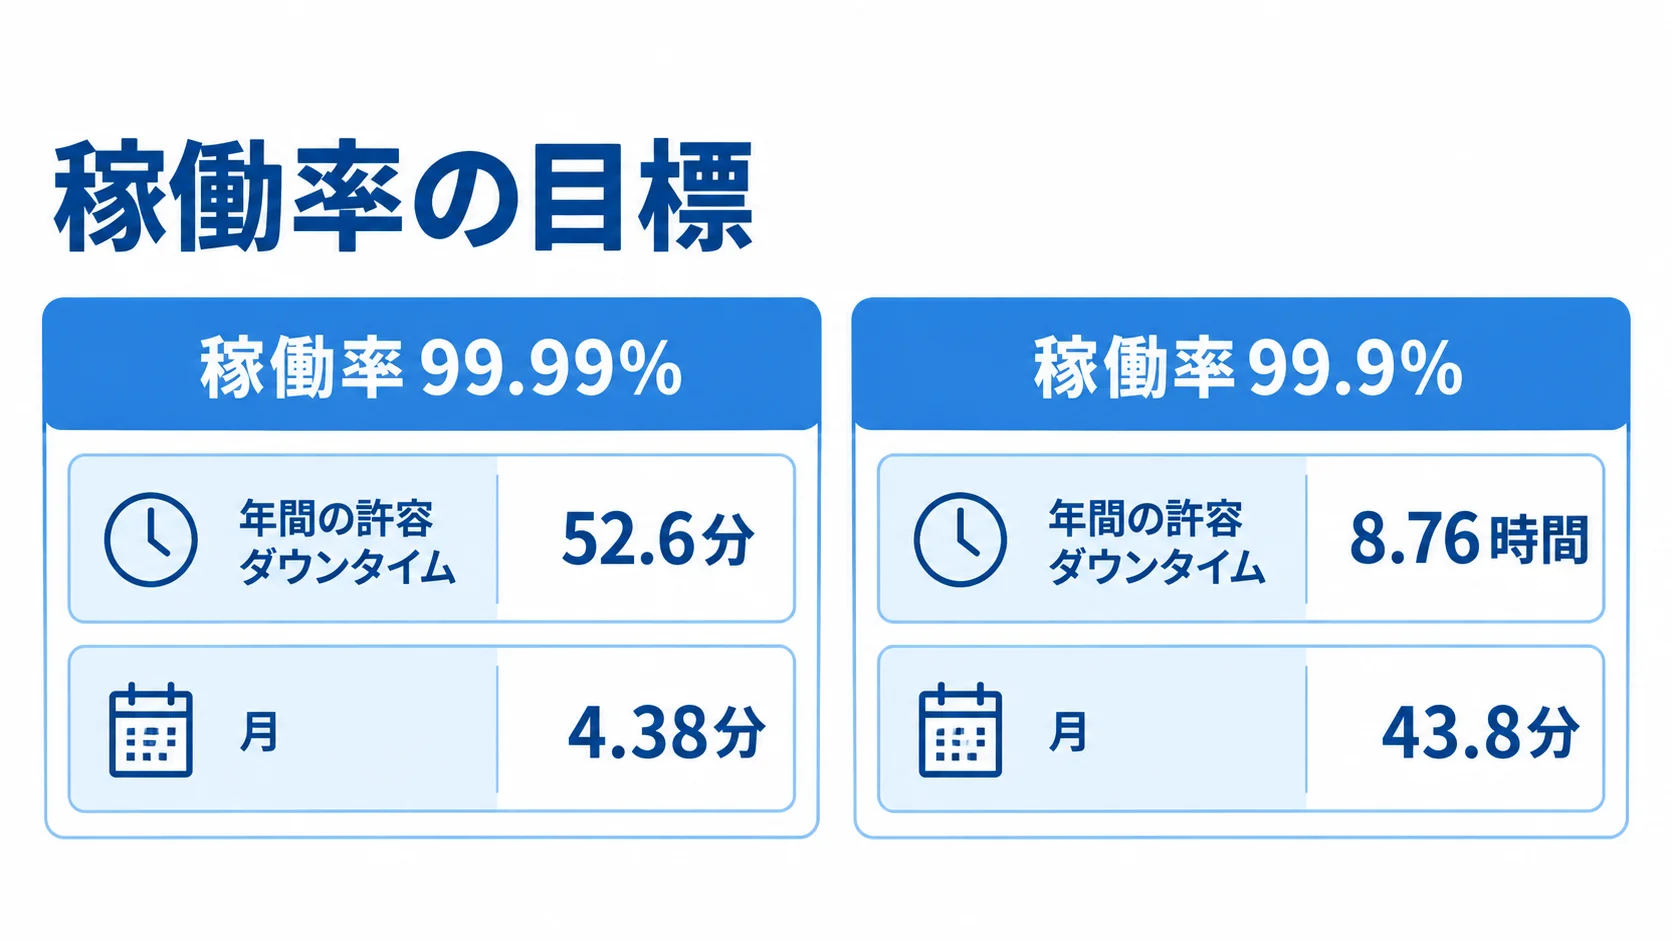
死活監視は、稼働率99.9%なのか99.99%なのかという目標水準と密接に結びついています。そのため、目標が1段階厳しくなるだけで、監視体制や対応費用が跳ね上がります。自社にとって本当に必要な水準を見極めることが、無駄なコストを削る鍵になります。
99.99%から99.9%へ目標を見直してコストを下げた事例
ある社内向け業務システムでは、当初「念のため」という理由で、稼働率99.99%を目標に掲げていました。そのため、24時間365日の即応死活監視体制を組んでいたのです。
稼働率99.99%は、年間の許容ダウンタイムが52.6分、月にすると4.38分しかありません。これを満たすには高頻度の監視と即応体制が必要で、相応の費用がかかります。
社内利用が中心の業務システムは、夜間や休日に止まっても翌営業日までに復旧すれば、実害がほとんどない性質でした。
そこで事業影響度を再評価し、稼働率の目標を99.9%(年間許容ダウンタイム8.76時間、月43.8分)へ引き下げました。あわせて、夜間の即応を「翌営業日対応」に切り替えています。
死活監視そのものは続けたまま、深夜の即応体制を外したことで、運用と障害対応の費用を圧縮できました。
リサーチでは、稼働率の「9」が1つ増えるごとに、運用コストが段階的に跳ね上がるとされています。逆に言えば、実態に合わせて1段階下げるだけで費用は下がります。
過剰なSLAは、見直すだけで効く削減策だと、この事例は教えています。
見直しは、今の目標が本当に必要な水準かを確かめるところから進めます。
- 見直しの起点:「念のため」の水準を、システムごとの事業影響度に置き換えて考える
- 費用との釣り合い:稼働率を1段階下げた場合の費用の変化を、業務部門と並べて比べる
業務部門を説得してSLAを下げた社内調整の事例
SLAの適正化で難しいのは、技術ではなく社内調整です。業務部門は「止まったら困る」という思いから、高い稼働率を求めがちです。そのため、情シスがそれを下げる提案をすると、「サービスを下げるのか」と反発されることがあります。
成功した事例では、システムごとに事業影響度を評価し、「このシステムが30分止まったら、いくらの損失や、どんな業務影響が出るか」を数字と業務フローで示しました。
そのうえで、システムごとにメリハリをつけてSLAを再設定しました。たとえば、「このシステムは社内利用が中心で、停止しても代替手段があるため99.9%で十分」や、「こちらの受注システムは止まると売上に直結するので99.99%を維持」といった具合です。
一律に高い水準をそろえるより、影響度に応じて監視と稼働率の目標を配分する考え方です。事業影響度に基づく社内の合意づくりこそが、死活監視の費用を抑える実務の肝になります。一般の解説ではあまり語られない、実践的な知見と言えます。
業務部門と話を進めるときは、伝え方と合意を取る単位を分けて考えます。
- 相手への伝え方:「下げる」という結論より先に、停止したときに困る場面を一緒に確かめる
- 合意の単位:全システムを同じ水準にそろえず、一つずつ目標を決めて合意を取る
夜間障害の検知体制を立て直した事例
死活監視の事例で最後に紹介したいのが、「アラートが多すぎて誰も見なくなった」「夜間の通知が機能していなかった」といった、検知体制そのものの立て直しです。
死活監視は、誰が、いつ、どう反応するかという運用とセットで初めて意味を持ちます。火消しに追われた現場が、どう検知体制を作り直したのかを紹介します。
アラート疲れを解消し本当に重要な通知に絞った事例
この事例は、「夜間障害の検知体制を立て直した事例」の中で、アラートを本当に重要な通知に絞った例です。ある運用チームでは、死活監視のアラートが1日に何十件も飛び、その大半が一時的な遅延や、自動で復旧する軽微なものでした。
結果として、担当者は通知に慣れきってしまい、本当に重大な停止のアラートも見逃すようになっていました。いわゆる「アラート疲れ」です。
立て直しでは、まずアラートを一覧にして、「即対応が必要な停止」と「翌営業日でよい軽微なもの」に分けました。死活監視で大切なのは、すべてを通知することより、対応すべきものだけを確実に届けることです。
そのうえで、通知のしきい値と経路を組み直しました。その結果、一件一件の重みを取り戻し、夜間の重大な停止にも確実に反応できる体制へ変わりました。具体的には、通知を出す条件と、軽微なものの扱いを変えました。
- 通知の条件:連続して数回応答がなければ、初めてアラートを上げる
- 軽微なものの扱い:日次サマリにまとめ、即時には通知しない
エスカレーション経路を整備し初動を早めた事例
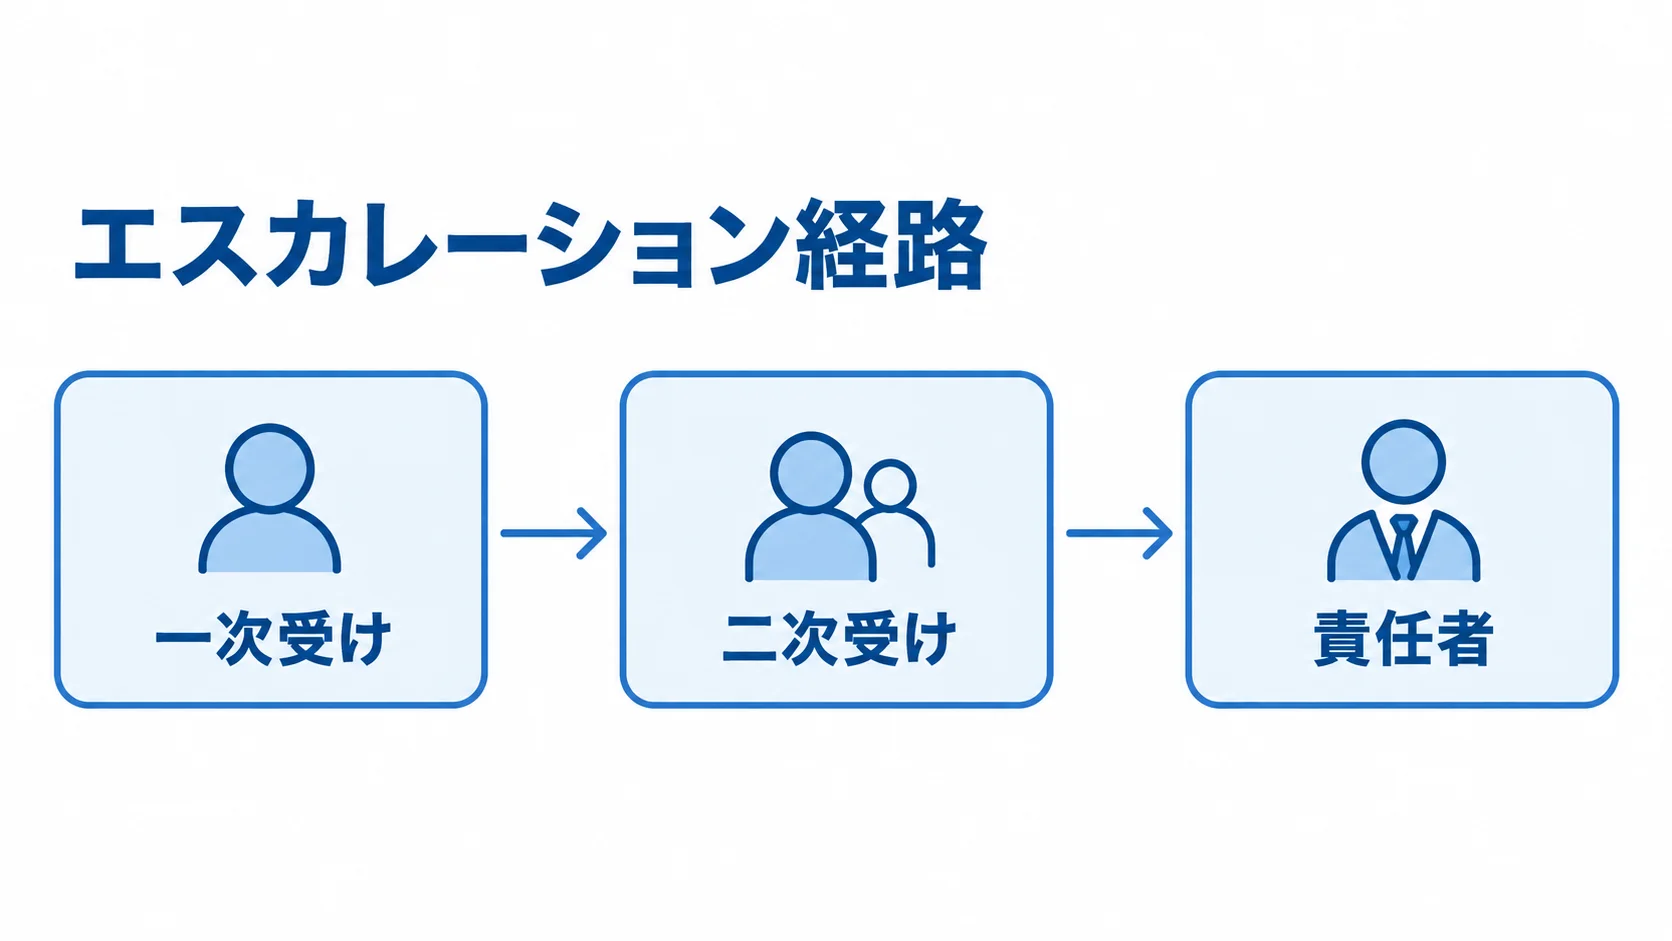
夜間障害の検知体制でもう一つ重要なのが、アラートが上がった後の連絡経路(エスカレーション)です。立て直しに成功した事例では、多段階の経路を明確に定めていました。一次受けが一定時間応答しなければ二次受けへ上げ、それでも対応できなければ責任者に連絡する流れです。
これにより、担当者一人が気づかなくても停止が放置されない仕組みになります。経路を自社の体制に落とし込み、「検知したら必ず誰かが動く」状態をつくることが、死活監視を機能させる事例の共通項でした。
検知の自動化と、その先の人の動きの設計は、セットで考える必要があります。
経路の組み立てで参考になるのは、応答と復旧の目安の決め方と、深夜帯を委託先に任せる考え方です。
- 応答と復旧の目安:官公庁の仕様例では、1時間以内に内容と予想作業時間を報告し、原則4時間以内に完全復旧
- 委託先の役割:自社の一次受けが反応できない深夜帯は、委託先が一次対応する
まとめ
ITシステム死活監視の事例を振り返ると、成功の鍵は「停止に最速で気づき、誰かが必ず動く体制を、自社の事業影響度に見合った水準で組む」という一点に集約されます。
検知が客からの電話から数分の自動通知に変われば、ダウンタイムと機会損失を圧縮できます。また、ひとり情シスは委託によって、夜間の拘束と属人化から解放されます。
過剰だったSLAは、事業影響度に応じて適正化すればコストが下がります。さらに、アラートを絞り、エスカレーションを整えることで、死活監視は初めて「本当に機能する仕組み」になります。
事例を読むときは、どんなツールを入れたかより、停止にどう気づき、どう動いたかという運用の視点を大切にしてください。
総務省の資料にある5分以上の停止1回あたり1,200万円や、Gartnerの1分あたり5,600米ドルといった損失の数字に照らすと、死活監視は単なるコストではなく、事業継続の保険だと分かります。
riplaは、フルスクラッチの受託と国内の運用保守を組み合わせ、システムを作った後の死活監視や障害対応まで一貫して伴走しています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。