
死活監視は、サーバーやネットワーク機器の稼働を定期的に確かめ、障害を早く知らせる運用の土台です。
Webサービスが突然止まり、問い合わせで初めて障害に気づく事態を防ぐには、Ping監視とポート監視を組み合わせた即時検知が欠かせません。仕組みの基礎から発注・外注までを、本ガイドで順に整理します。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
関連記事一覧(死活監視を深掘りする4記事)
各テーマを深く知りたいときは、以下の4記事が役立ちます。いずれも、本ガイドの論点を個別に掘り下げた内容です。
- 死活監視の進め方|Ping・ポート監視の設計と監視間隔の決め方
- 死活監視ツール比較6選|環境別おすすめと選定ポイント
- 死活監視の費用相場|ツール・監視代行のコスト内訳
- 死活監視の外注・発注ガイド|MSP委託と偽装請負の注意点
死活監視の全体像|Ping・ポート監視と即時検知の仕組み
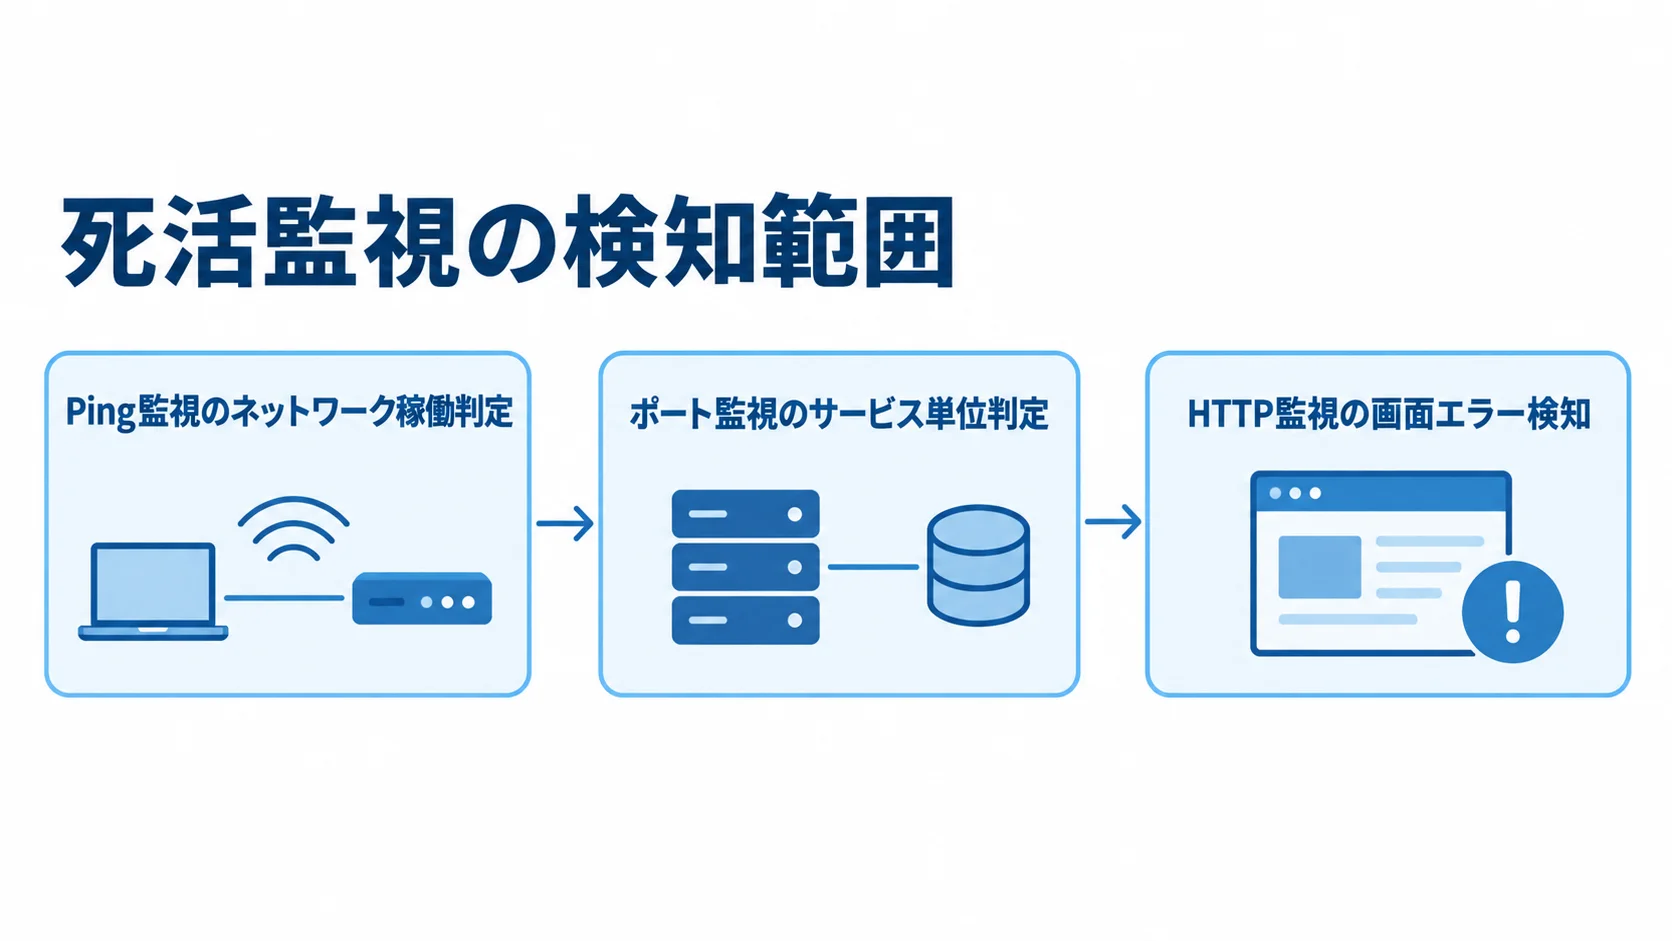
死活監視とは、監視対象のサーバーやネットワーク機器、サービスが正常に稼働しているかどうかを定期的に確認する監視手法です。システムが「生きているか(Alive)」「死んでいるか(Dead)」を判定することから、この名前が付いています。
性能監視やログ監視と並ぶシステム監視の三本柱のひとつであり、なかでも最も基礎的です。障害発生時に、最初に異常を知らせてくれる役割を担います。
死活監視が正しく機能していないと、サービスが停止していても気づくのが遅れ、ダウンタイムが長期化します。逆に、ここをしっかり押さえておけば、障害の早期検知が可能になり、ビジネスへの影響を最小限に抑えられます。まずは、代表的な方式と性能監視・ログ監視との違いを見ていきます。
Ping監視とポート監視という2つの代表的な方式
死活監視で最も広く使われるのがPing監視です。ICMPというプロトコルを使い、監視対象に「応答を返せますか」という小さなパケットを送って、返ってくるかどうかでサーバーがネットワーク上で生きているかを判定します。
設定がシンプルで負荷も小さいため、最初に導入される基本的な監視方式です。ただし、Pingが通っても、その上で動くWebサーバーやデータベースが正常とは限らない点に注意が必要です。そこで併用されるのがポート監視です。
具体的には、HTTPの80番、HTTPSの443番、データベースの3306番などの特定ポートへの接続を確認し、サービス単位で稼働状態を判定します。さらにHTTP監視では、特定の文字列が返るか、ステータスコードが200番台かまで確認し、「サーバーは生きているのに画面はエラー」という状態も検知します。Ping・ポート・HTTPを段階的に組み合わせると、検知の精度が高まります。
性能監視・ログ監視との違いと役割分担
システム監視は「死活監視」「性能監視」「ログ監視」の3つに大きく分けられます。死活監視が「動いているか、止まっているか」を即座に判定するのに対し、性能監視はCPU使用率やディスク使用量などを数値で追い、障害の予兆をつかみます。たとえば、ディスク使用量が80%を超えたら警告を出すといった具合に、止まる前に手を打つための監視です。
ログ監視は、エラーログやアクセスログを解析し、異常な挙動やセキュリティイベントを記録から追う手法です。これら3つは競合するものではなく、組み合わせて初めて意味を持ちます。死活監視で「止まった」ことを即座に知り、性能監視で「なぜ止まりそうか」を予測し、ログ監視で「何が起きたか」を後から追う、という役割分担です。
▶ 死活監視の方式や監視間隔の設計をより詳しく知りたい方は、死活監視の進め方|Ping・ポート監視の設計と監視間隔の決め方をご覧ください。
死活監視の進め方|設計から運用までのステップ
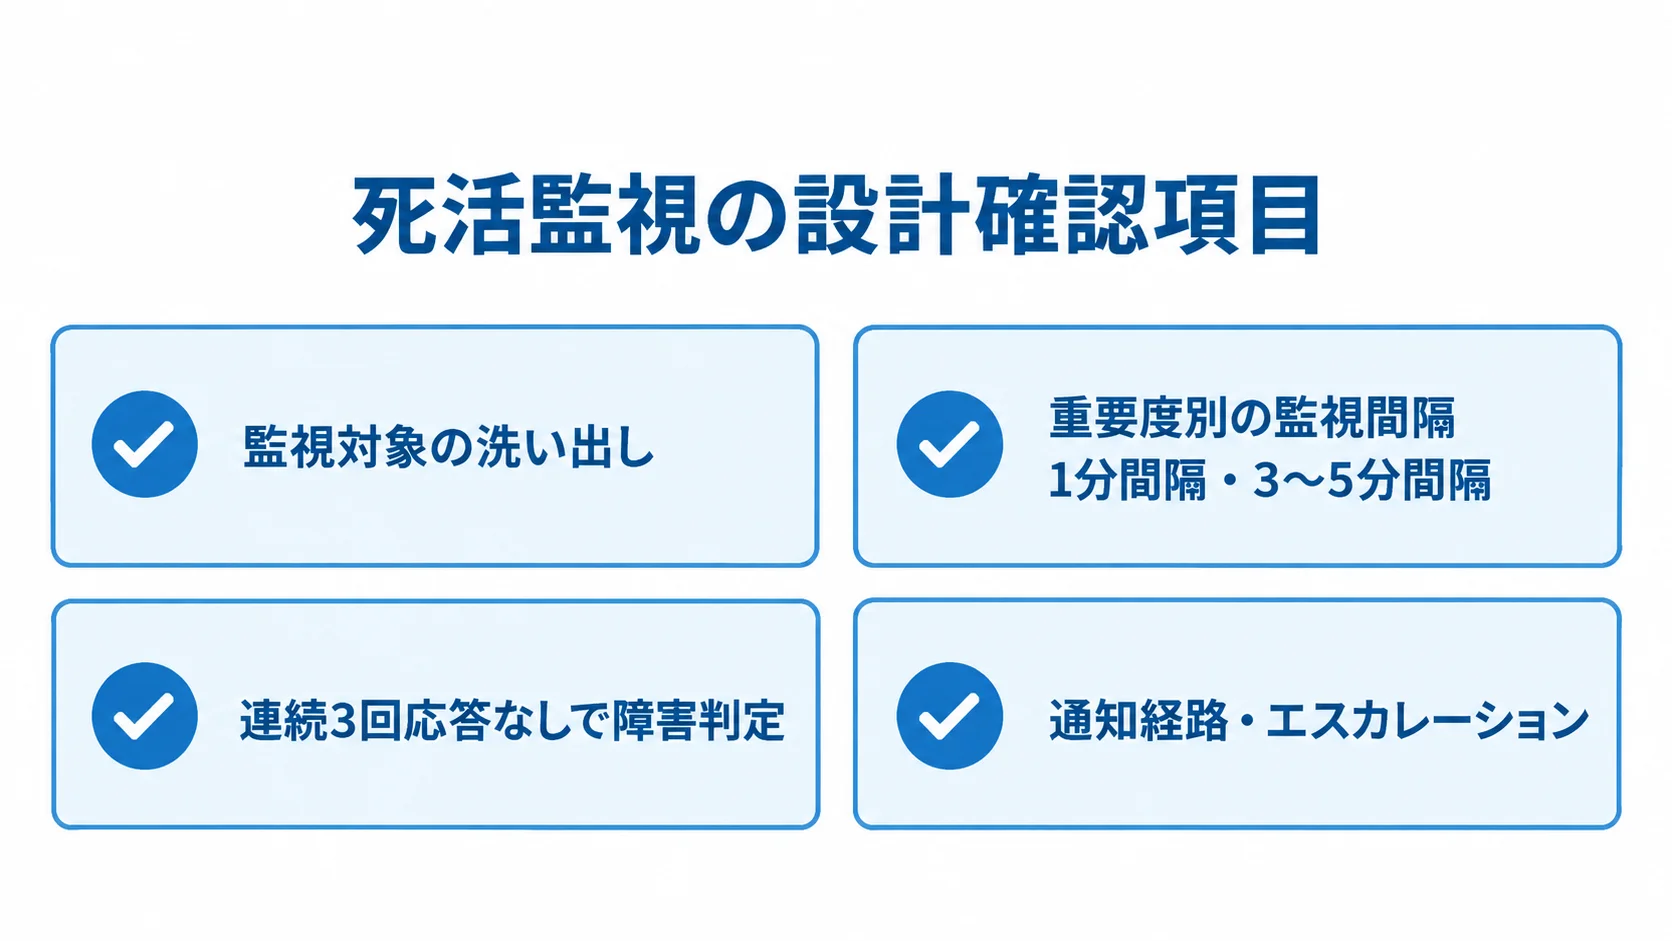
死活監視を導入するときは、ツールを先に入れるより、まず「何を、どの間隔で、誰に通知するか」を設計することが成功の鍵です。監視対象の洗い出し、監視間隔の設定、アラート通知経路の設計という順で進めると、過検知や見落としを防げます。
監視対象の洗い出しと監視間隔の設計
最初のステップは監視対象の洗い出しです。Webサーバーやデータベースなど、サービスを構成する要素を漏れなく一覧にします。ロードバランサーやネットワーク機器も対象に含めます。
このとき、決済や認証など利用者から見て致命的な機能に直結する要素を、優先して手厚く監視します。一方で、すべてを同じ密度で監視すると、運用負荷とコストが膨らみます。監視間隔は、1分間隔で監視すれば検知は早くなりますが、その分、監視サーバーや対象への負荷が増え、SaaS型ツールでは課金も増えます。
そのため、重要度の高いサービスは1分間隔、それ以外は3〜5分間隔といった具合に濃淡をつけるのが一般的です。また、1回応答がなかっただけでアラートを出すと、一時的なネットワークの揺らぎで誤検知が増えます。そこで、「連続3回応答なしで障害判定」のように再試行回数を設定し、ノイズを減らす工夫が現場では欠かせません。
アラート通知設計とアラート疲れの回避
死活監視で異常を検知しても、適切な担当者に確実に通知が届かなければ意味がありません。通知の設計では、次の3点を押さえておきます。
- 通知経路:メールやSlack、電話やSMSなどを重要度別に使い分けるのが理想です(深夜の重大障害は電話、軽度な警告はSlack)。
- エスカレーション:一次対応者が反応しない場合に、誰へ通知を上げるかを決めておきます。
- アラート疲れ:閾値設定がシビアすぎたり、条件分岐を複雑にしすぎたりすると、通知が大量に飛び、本当に重要なアラートが埋もれてしまいます。
実際に、「特定キーワードを含むログだけをSlack通知する」という複雑な条件を設定したつもりが、設定ミスにより重要なエラー通知が飛ばず、障害の発見が3時間遅れた事例もあります。このように、ツール選び以上に、アラート設計をシンプルに保つことが、結果として障害対応力を左右します。
▶ 監視間隔の決め方やアラート通知の具体的な設計手順は、死活監視の進め方|Ping・ポート監視の設計と監視間隔の決め方で詳しく解説しています。
死活監視ツールの選び方|環境と予算による見極め
死活監視ツールは、ZabbixやMackerel、Amazon CloudWatch、Datadog、OpManagerなど数多くあり、それぞれ得意な環境や料金体系が異なります。「機能が豊富だから」という理由だけで選ぶと、運用しきれず形骸化することも少なくありません。そこで、個別のツール名を並べるのではなく、自社に合うツールを見極める選定基準から見ていきます。
監視環境とチームの技術レベルによる選定
選定の第一の基準は、監視対象の環境です。オンプレミス中心であれば、自由に作り込めるOSS(オープンソース)のZabbixが有力な選択肢になります。環境とツールの相性を無視すると、連携のための作り込みコストがかさみます。
たとえば、AWS環境であればCloudWatchがネイティブに統合でき、マルチクラウドや複数環境をまたぐ場合はDatadogのようなSaaS型の統合監視が向いています。第二の基準は運用チームの技術レベルです。OSSは初期コストが無料でも、構築・運用に相応のスキルと工数が必要です。
一方、SaaS型はエージェントを入れるだけで使い始められ、直感的なGUIで初心者でも扱いやすい反面、月額費用が発生します。専任の運用エンジニアがいるか、少人数で兼任しているかによって、最適な選択は変わります。アラート通知の柔軟性や監視範囲の広さも、あわせて比較したい点です。
ベンダーロックインの回避
ツール選定で見落とされがちなのが、将来の乗り換えやすさです。SaaS型ツールは導入が容易な反面、独自のダッシュボードやアラート設定を作り込むほど、別のツールへ移行する際のスイッチングコストが大きくなります。数年運用した後で「使いこなせていないのに高額で、しかも他社に移れない」という状態に陥るのは、典型的な失敗です。
この対策として、近年はOpenTelemetryのような標準仕様を活用し、監視データの収集部分を特定ベンダーに依存させない設計が注目されています。データ収集の規格を標準化しておけば、可視化や分析のツールだけを後から差し替えやすくなります。導入時の使いやすさだけでなく、3年後・5年後の出口戦略まで見据えてツールを選ぶ視点が、長期的なコストを抑えることにつながります。
▶ 各ツールの機能・価格・対応環境を具体的に比較したい方は、死活監視ツール比較6選|環境別おすすめと選定ポイントをご覧ください。
死活監視の費用相場|ツールと監視代行のコスト
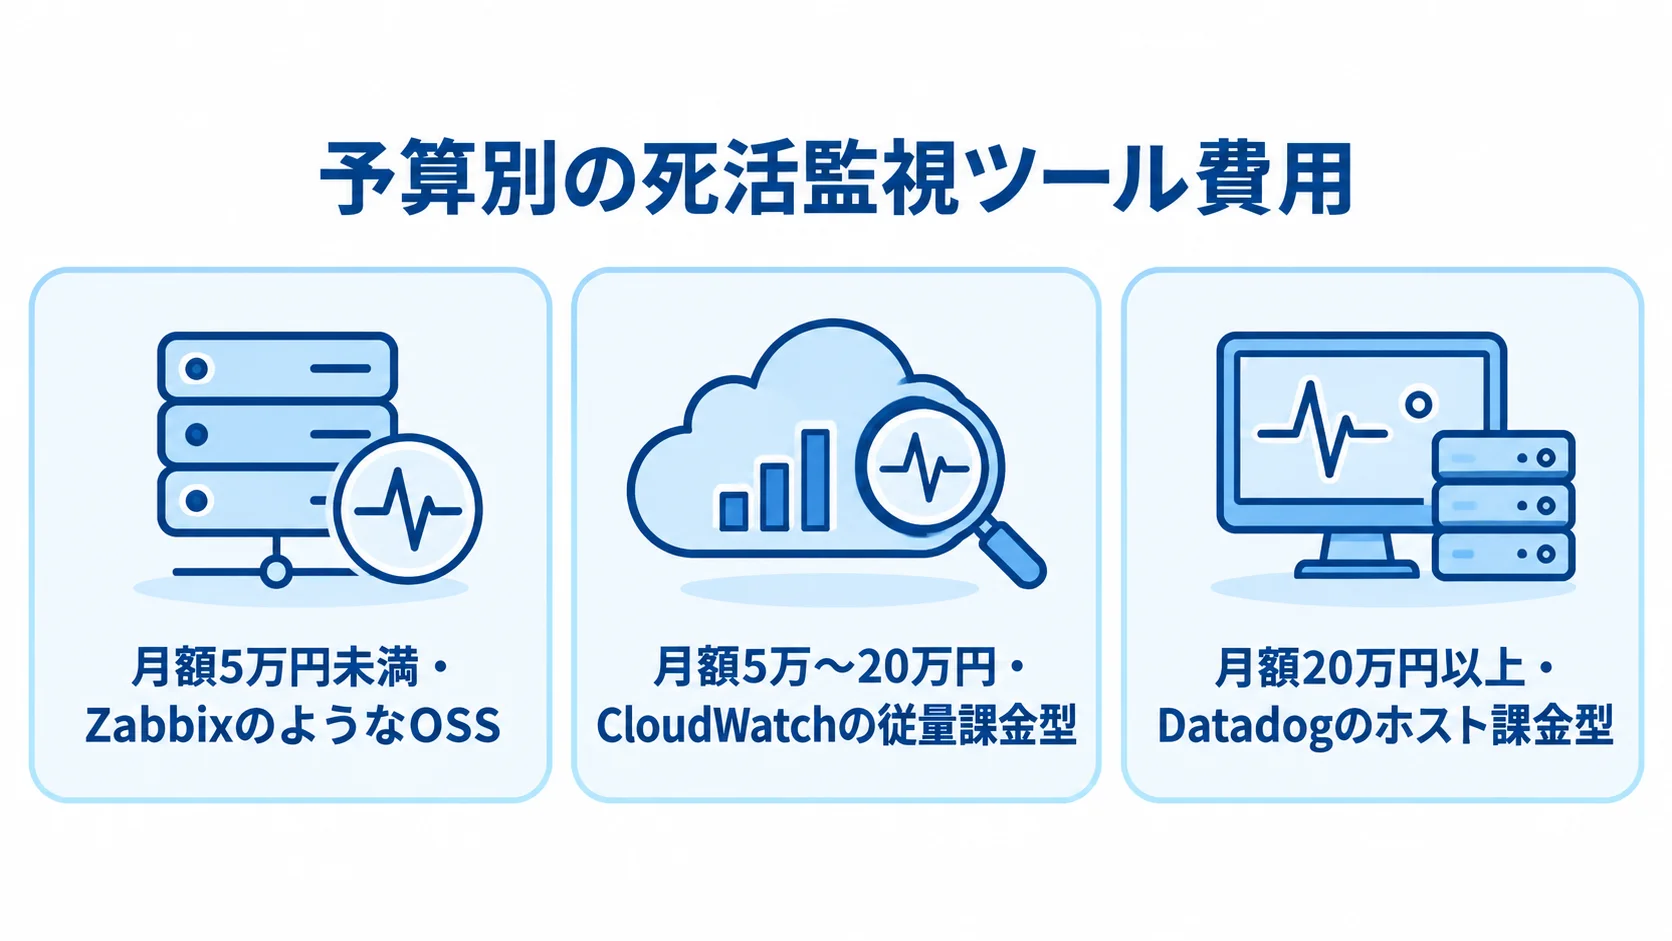
死活監視のコストは、自社で運用する場合のツール費用と、監視そのものを外部に委託する場合の代行費用に大別されます。さらにツール費用も、無料のOSSから従量課金、ホスト課金まで料金体系が異なります。ここでは、予算規模ごとの目安と監視代行の料金相場を順に見ていきます。
予算別のツール費用の目安
ツール費用は、予算規模で目安を整理できます。
- 月額5万円未満で抑えたい場合:初期コストがゼロのZabbixのようなOSSが現実的です。
- 月額5万〜20万円の規模:使った分だけ支払う従量課金型のCloudWatch(ログ取込でおよそ$0.76/GBなど)が候補になります。
- 月額20万円以上:Datadog(月額$15程度〜/ホスト)のようなホスト課金型。死活監視だけでなく、性能やログも統合的に可視化できる点が特徴です。
個別ツールの参考価格を見ると、Mackerelのスタンダードプランは月額2,180円/台です。Datadogは月額1,650円程度から、Zabbixは0円からといった水準が公開情報として確認できます(2026年時点の参考値)。
ただし、OSSは「無料」でも、構築・運用の人件費という見えないコストが乗る点を忘れてはいけません。表面的な月額だけでなく、運用にかかる工数まで含めた総保有コストで比較することが大切です。
監視代行の料金とROIの考え方
24時間365日の監視を自社だけで賄うのは負担が大きいため、監視代行(MSP)の利用も選択肢になります。一次対応まで含めた24時間365日の監視パッケージでは、1台あたり月額10,000〜30,000円が相場です。これに加えて、個別サービスの監視オプションは月額200円/1サービス、Apacheなどの自動復旧監視は月額3,000円で、必要に応じてオプションを積み上げる体系が一般的です。
費用を判断する際は、コストだけでなくROI(投資対効果)の視点が欠かせません。たとえばECサイトでは、1時間のダウンタイムが平均売上の何割の損失につながるかを試算し、監視で障害検知が早まればその損失をどれだけ防げるかを数値化します。そのうえで、「監視に月3万円かけることで、年に数回起きうる長時間障害による数百万円規模の機会損失を回避できる」という形で示せれば、経営層の決裁も得やすくなります。
▶ ツール費用と監視代行のコスト内訳をさらに詳しく知りたい方は、死活監視の費用相場|ツール・監視代行のコスト内訳をご覧ください。
死活監視の外注・発注方法|MSP委託の進め方
監視運用を外部に委託するときは、どの範囲を任せ、どこを自社で持ち続けるかを線引きすることが大切です。すべてを丸投げすると、運用がブラックボックス化します。さらに、契約形態を誤ると偽装請負のリスクも生じます。
ハイブリッド運用と手放してはいけないスキル
外注は、全部任せるか全部自社でやるかの中間を取ることもできます。現実的には、夜間・休日の一次対応だけをMSPに委託し、日中の運用や改善は自社で行うハイブリッドな運用設計が有効です。たとえば、時間帯指定オプションを使えば、最も負荷の大きい夜間だけを外部に任せ、コストを抑えながら24時間体制を実現できます。
ただし、外注しても情報システム部門が手放してはいけないスキルがあります。それはSLA(サービス品質保証)を定義する力と、システムアーキテクチャ全体を把握しておく力です。
実際に、「MSPに丸投げした結果、自社システムを理解できる社員がゼロになり、いざという時に判断ができなくなった」という構造的な失敗は珍しくありません。そのため、委託先と対等に会話し、適切に評価・指示できる最低限のスキルは社内に残す前提で、外注範囲を設計すべきです。
契約形態と偽装請負の注意点
監視業務の委託では、請負契約・準委任契約・派遣契約のどれを選ぶかで、指揮命令の所在が変わります。請負や準委任で発注したつもりでも、実態として発注者が委託先の作業者へ直接指示を出していると、偽装請負(労働者派遣法違反)と判断されるリスクがあります。これは、現代の開発現場でも見落とされやすいグレーゾーンです。
特に注意が必要なのは、次の場面です。
- 1人常駐の兼任体制:発注者の事業所で、管理責任者を兼ねる請負労働者が1人だけで業務を行うと、発注者の注文が直接の指揮命令とみなされやすくなります。
- 作業担当者へのCC:管理責任者宛のメールをCCで送ること自体は問題ありませんが、実質的な作業手順の指示が含まれると、指揮命令と判断されかねません。
- 担当者への直接の返信要求:作業担当者に直接の返信を求めると、指揮命令と判断されるおそれがあります。
Slackで常時つながる現代の運用では、こうした線引きが一層あいまいになります。そのため、契約形態に応じた適正な運用ルールを定めておくことが欠かせません。
▶ MSP委託の進め方や契約・偽装請負の注意点は、死活監視の外注・発注ガイド|MSP委託と偽装請負の注意点で詳しく解説しています。
死活監視で失敗しないためのポイント
死活監視は、導入して終わりではなく、運用を通じて継続的に磨き上げていくものです。ツールを入れただけで満足してしまうと、いざというときに役立たない監視になりかねません。
よくある失敗パターンと対策
代表的な失敗のひとつは、「高価なSaaSを導入したのに、誰もダッシュボードを見ていなかった」というケースです。高機能なツールほど情報量が多く、見る習慣と運用フローが定着していなければ、宝の持ち腐れになります。
これを防ぐには、最初から多機能を求めず、自社にとって本当に必要な監視項目に絞り、運用に乗せてから段階的に拡張する姿勢が有効です。もうひとつは、前述したアラート疲れと、その裏返しである見落としです。
通知が多すぎても少なすぎても問題で、重要度に応じた通知経路の分離と、再試行回数によるノイズ除去が対策の基本になります。死活監視は「動いているか」を二択で判定するシンプルな仕組みだからこそ、誰が見ても判断できる明快なアラート設計を保つことが、組織としての障害対応力を底上げします。
ポストモーテムによる監視の継続的な改善
障害が起きた後に振り返り、いわゆるポストモーテムを実施して、監視システム自体を更新していく文化が、長期的な運用品質を左右します。「なぜ障害が起きたのか」「検知は適切なタイミングだったか」「アラートは正しく届いたか」を、個人を責めずに事実ベースで振り返ります。そのうえで、その学びを監視設定や運用フローに反映します。
この改善サイクルを回すことで、同じ障害を二度と見逃さない監視へと育っていきます。さらに視野を広げると、近年は「監視(モニタリング)」から「オブザーバビリティ(可観測性)」への移行も進んでいます。死活監視や性能監視が「どこに異常があるか」を示すのに対し、オブザーバビリティは、ログ・メトリクス・トレースを統合して「なぜその異常が起きたのか」を解き明かすアプローチです。
また、AIで異常を予測するAIOpsなどの技術も登場していますが、十分な学習データが必要であったり、想定外のエッジケースには対応しきれないといった限界もあります。そのため、まずは死活監視という土台を固めたうえで、段階的に高度化を検討するのが現実的です。
まとめ
ITシステムの死活監視は、Ping監視やポート監視によってサーバーやサービスの稼働状態を即座に把握し、障害を早く検知するための運用の土台です。本ガイドでは、死活監視の仕組みと性能・ログ監視との役割分担を整理しました。進め方では、監視対象の洗い出しから監視間隔とアラート通知の設計までを取り上げ、ツール選び、費用相場、MSP委託と偽装請負の注意点へと広げました。
重要なのは、ツールを導入することそのものではなく、自社の環境・体制・予算に合った監視を設計し、ポストモーテムを通じて改善し続けることです。アラート設計はシンプルに保ち、外注する場合も社内に最低限のスキルを残します。そうすれば、死活監視は単なるコストではなく、ビジネスの安定稼働を支える投資になります。
各テーマをさらに深掘りしたい方は、以下の関連記事もあわせてご活用ください。
- 死活監視の進め方|Ping・ポート監視の設計と監視間隔の決め方
- 死活監視ツール比較6選|環境別おすすめと選定ポイント
- 死活監視の費用相場|ツール・監視代行のコスト内訳
- 死活監視の外注・発注ガイド|MSP委託と偽装請負の注意点
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。