
ITシステム死活監視で標準として備えたいのは、監視・通知・記録の基本機能です。
基本機能を揃えたうえで、自動復旧やAIOpsといった高度な機能は、必要性に応じて段階的に加えるのが現実的です。
- 監視機能:ping・ポート・プロセス・HTTP応答による死活の判定
- 通知機能:検知を担当者への通知とエスカレーションにつなげる仕組み
- レポート機能:停止履歴や稼働率の記録と、状態の分析
- 高度な機能:自動復旧やAIOpsによる運用の拡張
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
死活を判定する監視機能の基本
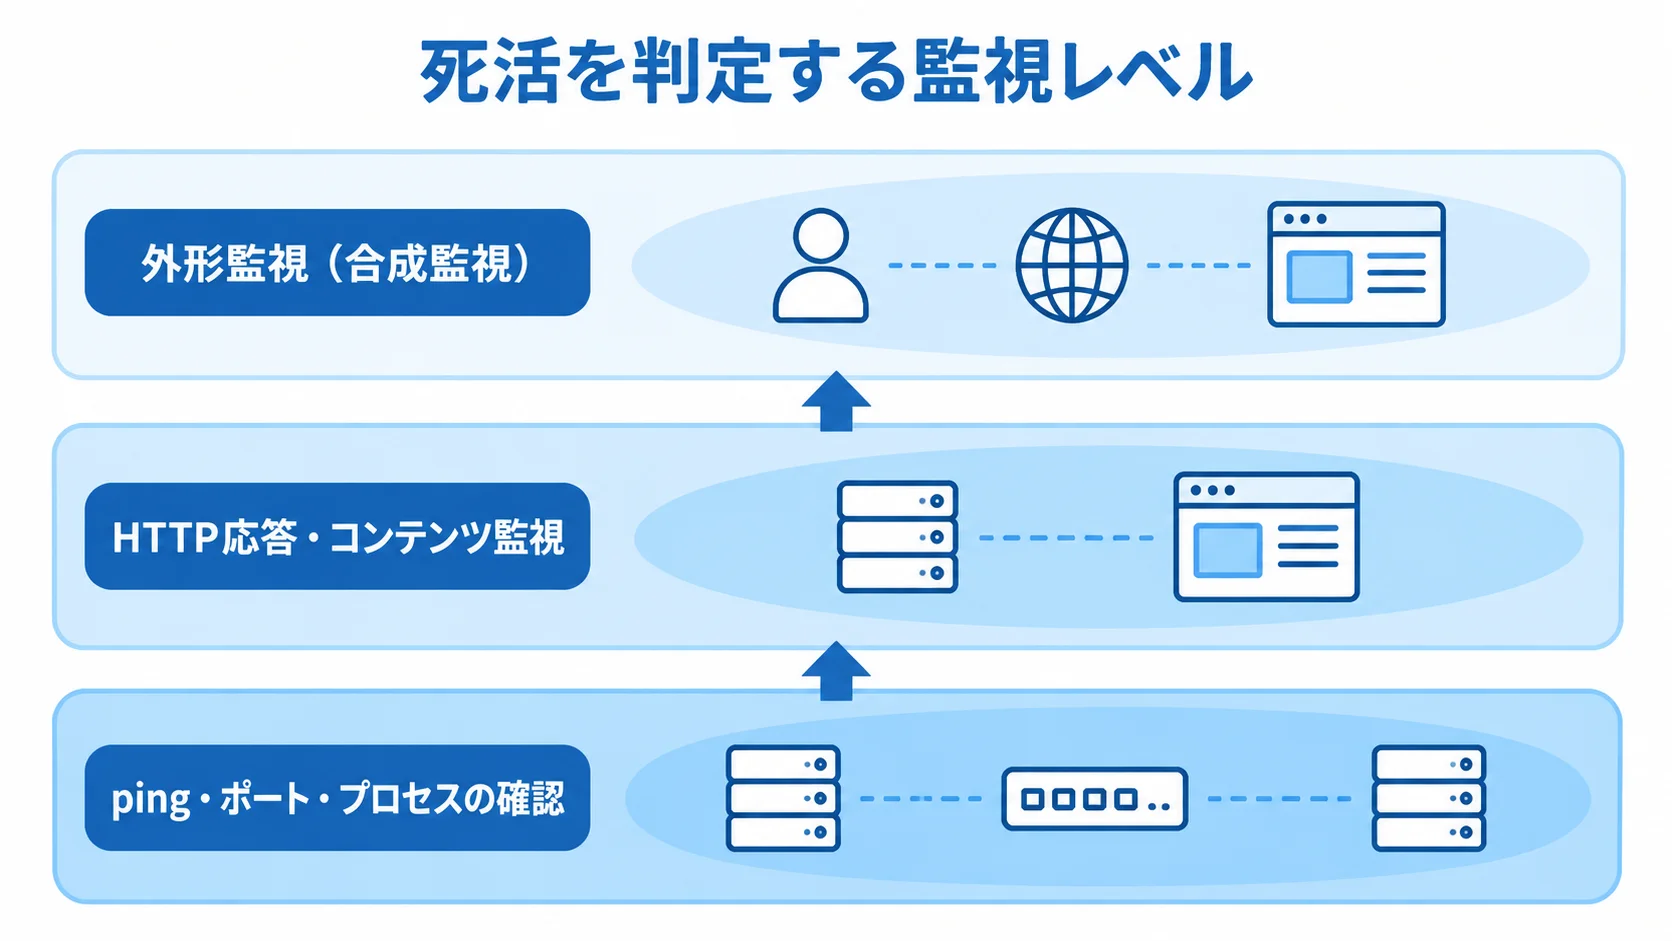
死活監視の中核は、対象が「生きているか・死んでいるか」を判定する機能です。ただし、ひとくちに死活といっても、何をもって「生きている」とみなすかには複数のレベルがあります。
たとえば、サーバーが電源として応答するか、ネットワーク的に到達できるか、サービスとして正しく応答を返すかは、それぞれ別の確認です。このレベルの違いを理解することが、必要な監視機能を選ぶ出発点になります。
ping・ポート・プロセスを確認する基本機能
もっとも基本的な死活判定は、pingによる疎通確認です。対象サーバーへ一定間隔でICMPの問い合わせを送り、応答が返るかで生死を判断します。ただし、サーバー自体は応答していても、その上で動くサービスが止まっていることはよくあります。
そこで必要になるのが、特定のポートが開いて応答するかを見るポート監視と、特定のプロセスが起動し続けているかを見るプロセス監視です。ポートは、Webなら80番・443番、データベースなら指定のポートが対象になります。標準的な死活監視では、ping・ポート・プロセスの確認を対象ごとに間隔と閾値を調整できることが、最低限の要件になります。
これらの基本機能で重要なのは、「監視間隔」と「判定の閾値」です。たとえば1分間隔で監視し、何回連続で応答がなければ「停止」と判定するかといった設定が、死活監視の精度を左右します。間隔が長すぎると検知が遅れ、短すぎたり閾値が甘すぎたりすると、一時的なネットワークの揺らぎで誤検知が増えます。
HTTP応答・コンテンツを確認するサービス監視機能
サーバーやプロセスが生きていても、利用者から見て「サービスが使える」とは限りません。そのため、サービスとして正しく応答しているかを見るサービスレベルの死活監視が必要になります。Webサービスであれば、特定のURLにアクセスしてHTTPのステータスコードが200(正常)を返すか、ページ内に想定した文字列が含まれているか(コンテンツ監視)まで確認します。
これにより、「サーバーは動いているがアプリケーションがエラー画面を返している」という状態も停止として検知できます。さらに高度な機能として、ログインから検索、決済直前までの一連の操作を模擬的に実行し、ユーザー体験として正常かを確認する外形監視(合成監視)もあります。
外形監視は、利用者と同じ目線で「本当に使えるか」を継続的に確かめる機能で、ECサイトのように停止が売上に直結するシステムでは特に有効です。機能を選ぶときは、自社にとっての「生きている」が、サーバーの応答・サービスの正常応答・ユーザー体験の成立のどれを指すかを定義し、それに合う監視レベルを備えているかを確かめます。
検知を行動に変える通知・エスカレーション機能
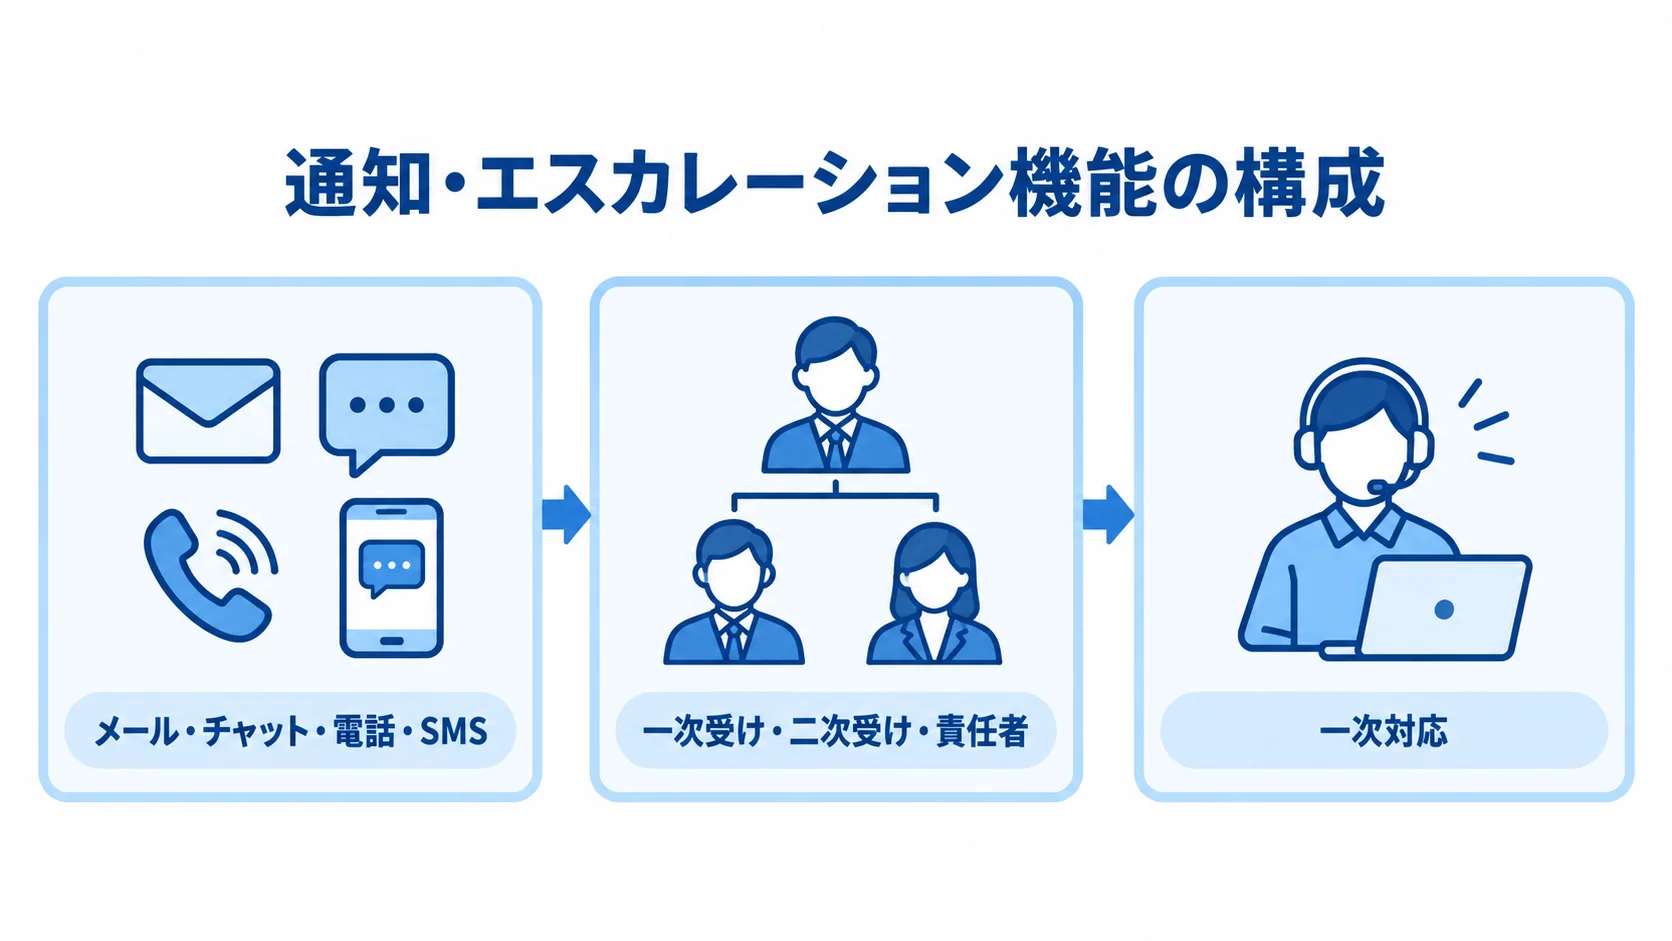
死活を検知しても、それが担当者に届かなければ意味がありません。死活監視のもう一つの柱が、検知を確実に人の行動へ変える通知・エスカレーション機能です。その中身は、誰に、どの経路で、どんな順番で知らせるかという設計です。
この設計の質が、停止に気づいてから対応を始めるまでの時間を決めます。
メール・チャット・電話など多経路の通知機能
標準的な死活監視では、検知時にメールやチャット(Slack・Teams等)へ自動で通知を飛ばす機能が備わっています。重要なのは、通知の経路を停止の重大度に応じて選べることです。軽微なものはチャットへ、業務に直結する重大停止は電話やSMSへと経路を分けられると、本当に緊急なものだけが確実に担当者の目と耳に届きます。
深夜帯は、チャットの通知に気づきにくいため、電話通知の有無は委託・構築時に必ず確認したい点です。また、通知に含める情報の質も、機能の差として現れます。「サーバーAが停止しました」だけでなく、いつから・どの監視項目で・直前の状態はどうだったかといった一次切り分けに役立つ情報が通知に含まれていると、初動が速くなります。
死活監視の目的は、通知を鳴らすことではなく、担当者が最短で正しく動けるようにすることです。そのため、通知の経路と中身の両方を機能として評価する視点が欠かせません。
多段階のエスカレーションと一次対応機能
通知が一人に届いても、その人が反応できなければ停止は放置されます。これを防ぐのが、エスカレーション機能です。連絡先は、次の三段階で自動的に切り替わります。
- 一次受け:最初に通知を受ける担当者。一定時間応答がなければ、次は二次受けへ回る
- 二次受け:一次受けが反応しなかった場合に、次に通知を受ける担当者
- 責任者:二次受けでも反応がなければ、連絡が向かう担当者
当番表(オンコール)と連動し、時間帯ごとに通知先を自動で切り替える機能を持つものもあります。これにより、特定の個人への依存を避け、必ず誰かに届く状態をつくれます。なお、委託型のサービスでは、通知に加えて「一次対応」まで機能として提供されることがあります。
リサーチでは、次のような料金例があります。
- サーバー監視:1台あたり月3,000円程度
- 障害時の一次対応を含む場合:1台あたり月10,000円程度
- フルマネージド:月20,000円程度
- SOC運用支援:月9万円程度から
- 重大インシデントへの一次対応:15分以内に対応を保証するサービスもある
死活監視を委託する場合は、「検知だけなのか」「一次対応まで含むのか」を機能として明確に切り分けて契約することが、後の費用と責任のトラブルを防ぎます。
停止を記録・分析するレポート機能
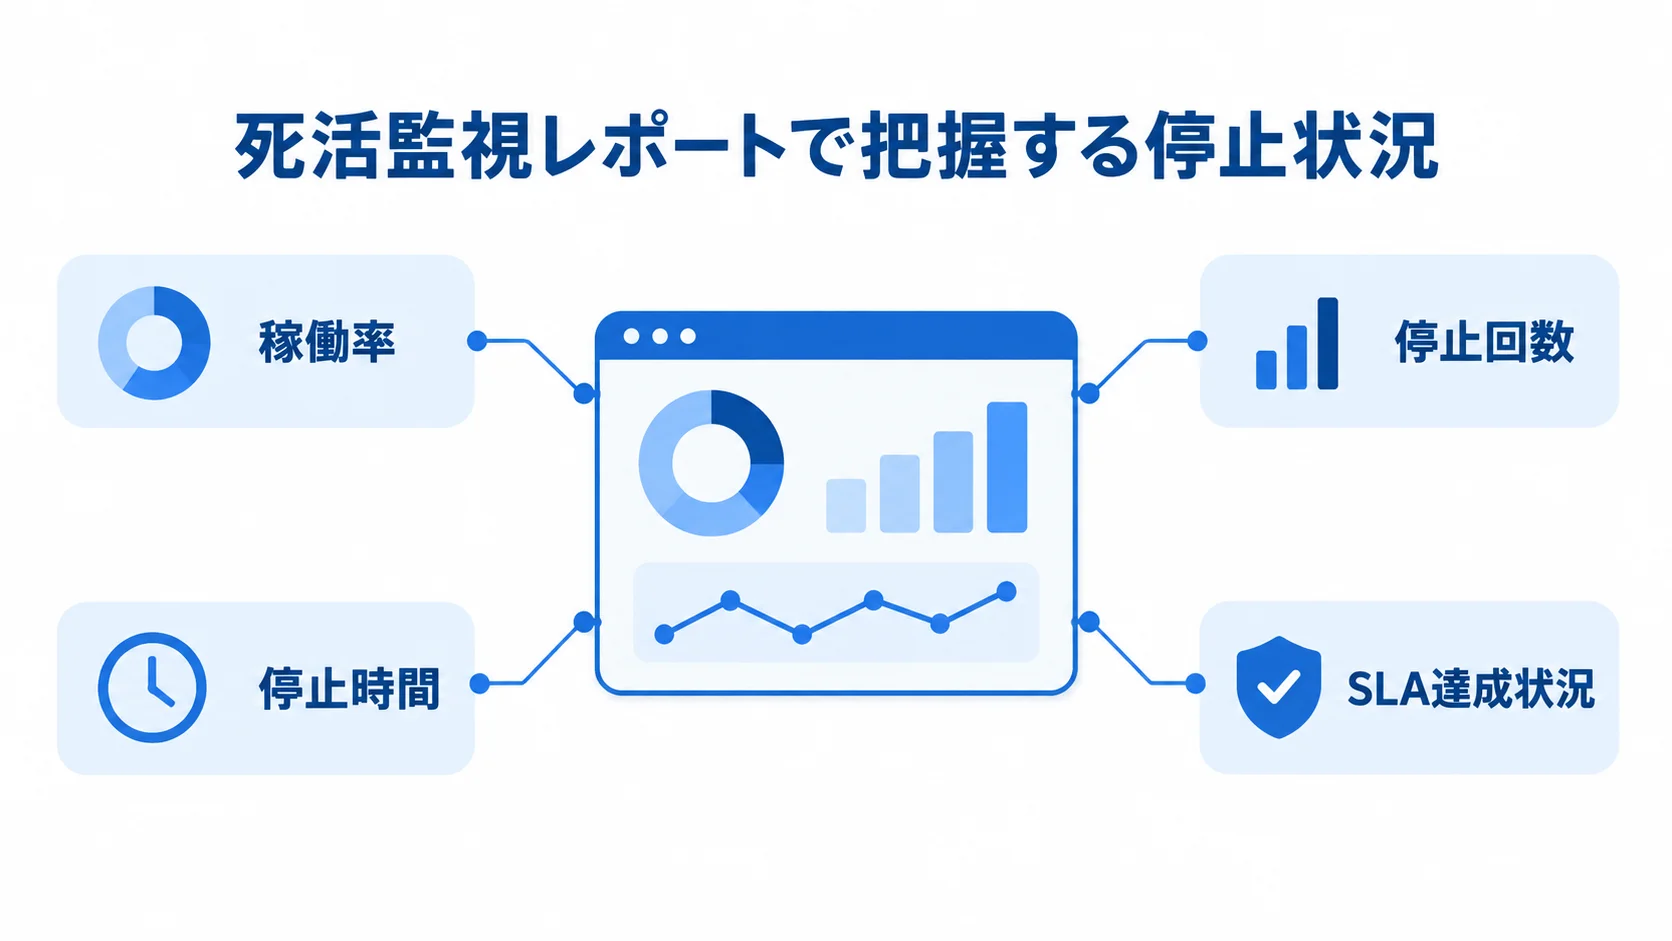
死活監視は、その場の検知だけでなく「過去にどれだけ止まったか」を記録・分析する機能を持つと、改善のサイクルを回せるようになります。停止の履歴がデータとして残れば、稼働率の実績やMTTR(平均復旧時間)を可視化でき、SLAの達成状況も客観的に評価できます。
また、検知して終わりにせず、記録を経営や改善に活かす機能が標準で備わっているかを見ることが大切です。
稼働率・ダウンタイムを集計するレポート機能
標準的な死活監視には、月次や週次で稼働率・停止回数・停止時間を集計するレポート機能があります。これにより、「先月の稼働率は99.92%で、SLA目標の99.9%を満たした」というように、約束した水準を守れているかを定量的に示せます。
さらに、稼働率99.9%の許容ダウンタイムは年間8.76時間・月43.8分、99.99%は年52.6分・月4.38分です。レポートは、この基準に対する実績を可視化してくれます。このレポート機能は、SLAを契約している場合の達成証跡としても、社内への説明資料としても重要です。
たとえば、停止が起きたときに「なんとなく止まった」ではなく「今月は2回・合計18分停止し、稼働率は99.95%だった」と数字で語れることが、監視を投資として正当化する材料になります。死活監視を導入する際は、検知機能だけでなく、稼働率・ダウンタイムの集計とレポート出力が標準で備わっているかを確認しておくと、後の運用がぐっと楽になります。
ダッシュボードで全体状態を俯瞰する機能
監視対象が増えてくると、個々のアラートだけでなく「いま全体としてどこが正常で、どこに問題があるか」を一目で把握できるダッシュボード機能が役立ちます。たとえば、サーバーやサービスの一覧が緑・黄・赤といった状態色で表示され、異常箇所がすぐ分かる画面です。複数のシステムをまとめて見られることで、運用担当者の負荷が下がり、状況把握のスピードが上がります。
主要な監視ツールでは、こうしたダッシュボードが標準機能として提供されています。OSSのZabbixはライセンス無料で柔軟なダッシュボードを構築できますが、自社で構築・維持する工数がかかります。
一方、Datadog・New Relic・Mackerelといったクラウド型は、ホスト数やメトリクス量に応じた従量課金で、中規模だと月数万〜数十万円が目安ですが、ダッシュボードや運用機能が最初から整っています。死活監視のレポート機能は、こうしたツールの選定とも密接に関わるため、自社が何をどこまで俯瞰したいかを基準に、ツールを選ぶとよいでしょう。
自動復旧・AIOpsなど一歩進んだ機能
死活監視の機能は、検知・通知・記録の先に、停止を自動で復旧したり、異常の予兆を捉えたりする一歩進んだ領域へと広がっています。すべての企業に必要なわけではありませんが、運用負荷をさらに下げる機能として理解しておくと、将来の拡張を見据えた選択ができます。中小企業でも部分的に取り入れられるので、スモールスタートの考え方が役立ちます。
検知をトリガーに自動でアクションを実行する機能
一歩進んだ死活監視には、停止を検知したらあらかじめ定めた処理を自動で実行する機能があります。たとえば、特定のプロセスが落ちたら自動で再起動を試みる、サービスが応答しなくなったらフェイルオーバー(待機系への切り替え)を実行する、といった対応です。これにより、人が動く前に軽微な障害が自動で復旧し、夜間でも一次対応の手数を減らせます。
ただし、自動復旧は万能ではなく、根本原因が解消されていないまま再起動を繰り返すと、問題を覆い隠してしまう危険もあります。そのため、自動復旧を導入する場合も、「自動で復旧を試みた事実は必ず通知し、記録する」という設計が前提になります。
検知・通知・記録という基本機能の上に自動復旧を載せる順序を守ることが、機能を安全に使ううえで大切です。自社のシステムのどこに自動復旧が向くかを見極め、まずは影響の小さい範囲から試すのが堅実です。
AIOpsによる予兆検知と中小のスモールスタート
近年注目されるのが、AIを活用して異常の予兆を捉えたり、大量のアラートを束ねて本当に重要なものを抽出したりするAIOpsです。死活監視のログやメトリクスをAIが学習し、「いつもと違う挙動」を検知して停止に至る前に知らせるといった機能が期待されています。ただし、JUASの調査ではAI活用について約78%が「検討中・未検討」とされており、多くの企業にとってはまだこれからの領域です。
中小企業にとって現実的なのは、いきなり全面的なAIOpsを目指すのではなく、まず死活監視の基本機能を固め、そこに溜まったデータを土台に部分的なAI活用へ広げていく進め方です。たとえば、レガシーなシステムを維持しつつ、影響の大きい一部のサービスから予兆検知を試し、ROIを確認しながら範囲を広げます。
riplaはフルスクラッチ受託と国内運用保守の立場から、「いまある監視を活かしながら段階的に高度化する」考え方を重視しています。死活監視の機能は、必要十分なところから始めて、少しずつ育てていく運用が適しています。
まとめ
ITシステム死活監視の機能は、基本機能と一歩進んだ機能に分けて整理できます。基本機能の中心となるのは、死活を判定する監視機能、検知を人の行動に変える通知・エスカレーション機能、停止を集計して俯瞰するレポート機能です。
一歩進んだ機能としては、自動復旧やAIOpsがあります。標準として最低限備えるべきは基本機能で、自動復旧やAIOpsは、自社の規模と必要性に応じて段階的に取り入れる領域です。
機能を選ぶときは、流行のキーワードに飛びつくことよりも、自社にとっての「生きている」を定義し、停止時に「誰がどう動くか」から必要機能を逆算することが大切です。そのうえで、稼働率99.9%か99.99%かといったSLAの目標に対して、検知・通知・記録の機能がその水準を支えられるかを確認してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、自社のシステムに必要十分な死活監視機能の設計から運用までを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。