
ITシステムの死活監視を外部に委託するなら、RFP(提案依頼書)と要件定義で、監視の対象や閾値、SLAなどを具体的に示すことが欠かせません。この記事は、要件定義書や提案依頼書を発注企業の情シスの視点から、要件定義に特化して解説します。
費用相場やSLAの全体像をまだ把握していない方は、まずITシステム死活監視の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視対象と監視項目を定義する要件
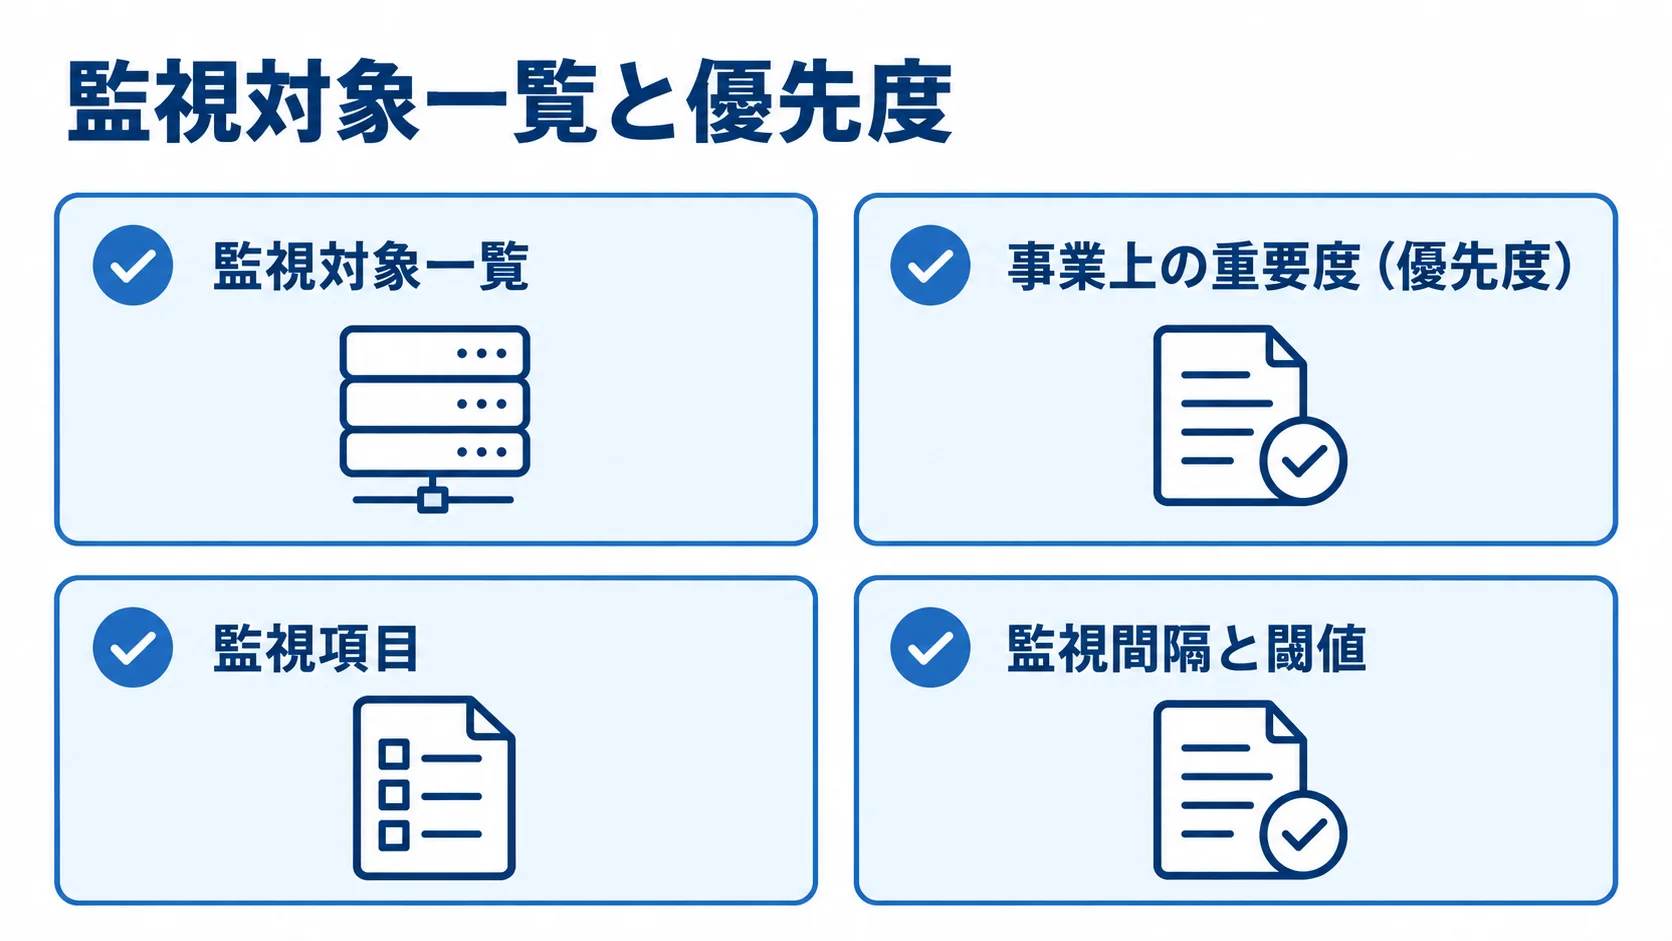
RFPの出発点は、何を、どこまで、どの粒度で監視してほしいかを明確に定めることです。ここが曖昧だと、ベンダーは自社に都合のよい範囲で見積もるため、提案を横並びで比べられなくなります。そこで、発注側が監視対象の一覧と、対象ごとの監視項目・間隔・閾値を先に整理しておくと、適正な提案を引き出せます。
監視対象一覧と優先度の明記
まず、監視対象となるサーバー、サービス、ネットワーク機器を一覧にします。Webサーバーやアプリケーションサーバー、データベース、外形監視するURLといった単位で列挙し、それぞれの台数や構成を明記します。あわせて、各対象に「事業上の重要度(優先度)」を付けておきます。
たとえば、止まるとすぐに売上へ響く受注系は最優先、社内向けの参照系は中優先、といった区分です。優先度を付ける理由は、監視間隔やSLAの強弱が、そのまま費用に直結するからです。すべてを最優先・即応で監視すれば費用は跳ね上がりますし、逆に全部を低優先にすると、重要なシステムの停止に気づけません。
リサーチでも、稼働率の「9」が1つ増えるごとに運用コストは段階的に跳ね上がるとされています。このため、対象ごとに優先度を付けて監視の水準にメリハリをつけることが、費用をどう抑えるかの前提になります。RFPの冒頭に、この監視対象一覧と優先度を発注者の意思として示しておくとよいでしょう。
監視項目・間隔・閾値の数値要件
対象ごとに、どの項目を、どの間隔で、どの閾値で見るかを数値で定めます。死活監視であれば、ping応答、指定ポートの応答、HTTPステータス200の確認といった項目が挙げられます。監視間隔(例:1分間隔)と、何回連続で異常なら停止と判定するか(例:3回連続)を明記します。
この数値があるかないかで、提案の精度と比較のしやすさが大きく変わります。注意したいのは、死活監視と性能監視、ログ監視の線引きです。RFPでは「死活(生死の判定)」を主としたうえで、CPUやメモリ使用率のような閾値監視を含めるのか、ログの異常検知まで求めるのかを切り分けて書きます。
範囲を曖昧にすると、安いベンダーは死活だけ、高いベンダーはすべて込みといった形で、比較できなくなります。だからこそ、発注者が「死活はここまで、性能監視は別オプション」と線引きして示す必要があります。そうすると、各社が同じ条件で見積もれ、安すぎる見積もりが何を省いているかも見抜けます。
SLAの数値要件の定義
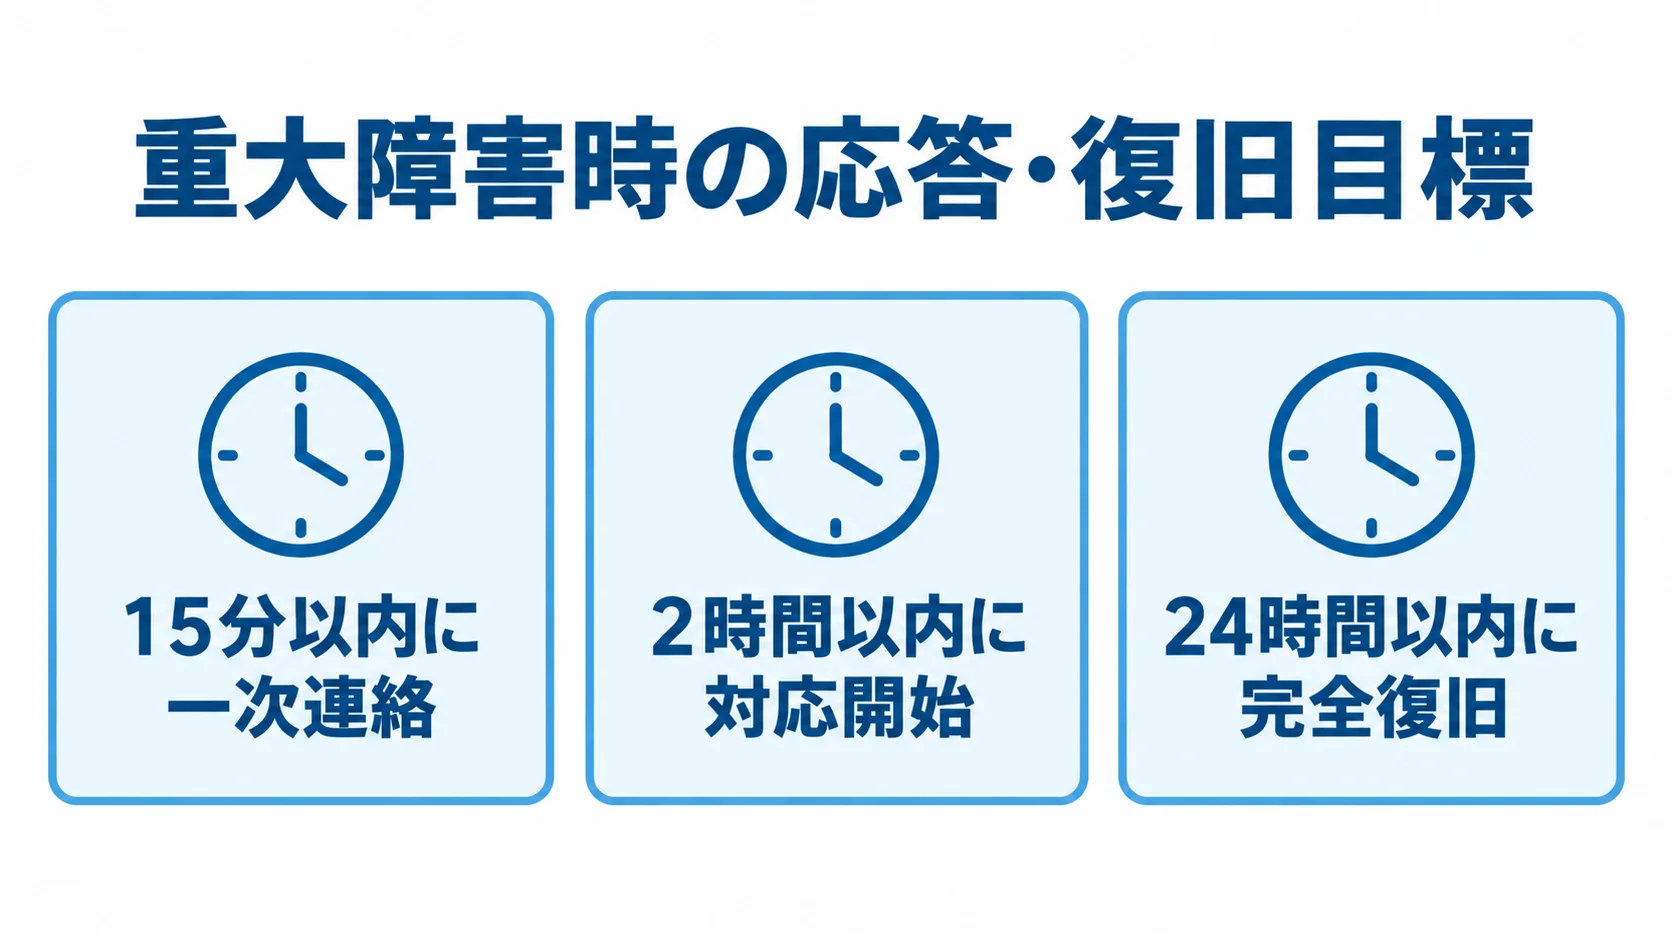
RFPで最も曖昧になりやすく、費用と法的リスクの両方を左右するのが、SLA(サービスレベル合意)です。稼働率、初報の応答時間、復旧目標時間という3つの数値を、対象の優先度に応じて定めることが、死活監視の要件定義の核心になります。ここを甘く書くと、停止したときに「努力目標だったので責任は負えません」と言われかねません。
対象別の稼働率と許容ダウンタイム
稼働率は、許容できるダウンタイムから逆算して定めます。たとえば、稼働率99.9%なら年間8.76時間、月43.8分、日7.3分の停止が許容され、99.99%なら年52.6分、月4.38分、日4.4秒までとなります。「9」が1つ増えるごとに必要な監視と即応の体制は重くなり、運用コストは段階的に跳ね上がります。
そのため、対象の事業影響度に応じて稼働率を割り当てることが、要件定義の肝になります。RFPには、「受注系サーバーは99.99%、社内参照系は99.9%」のように、対象別の稼働率目標を書きます。あわせて、その稼働率を月次と年次のどの期間で測るのか、計画停止(メンテナンス)を分母から除くかどうかも定めます。
測定方法が曖昧だと、達成と未達の判断でもめるおそれがあります。発注者が定義と測定方法まで踏み込んで書くと、過剰な水準を避けつつ、必要な水準は確実に約束させられます。
初報応答時間と復旧目標時間の明記
稼働率と並んで大切なのが、停止を検知してからの連絡と復旧の時間です。リサーチの官公庁仕様例では、「1時間以内に現地到着・対処開始」「1時間以内に内容と予想作業時間を報告」「原則4時間以内に完全復旧」といった目標があります。Cloud Naviは重大インシデントに15分以内の一次対応を保証し、別のサービスには検知から60分以内の通知と12時間での復旧という例もあります。
RFPには、これらを参考に、「重大障害は検知後15分以内に一次連絡、2時間以内に対応開始、24時間以内に完全復旧」のように、重大度別の応答時間と復旧時間を書きます。そして、これらが保証型(未達時にサービスクレジットなどのペナルティがある)なのか、努力目標型(最善を尽くすが責任は負わない)なのかを問う項目も入れます。
安すぎる見積もりは、たいていSLAが努力目標型であるか、そもそもSLA自体がありません。応答・復旧の数値とその保証区分をRFPで問うことが、見積もりの質を見抜く決め手になります。
クラウド責任共有を前提にした要件
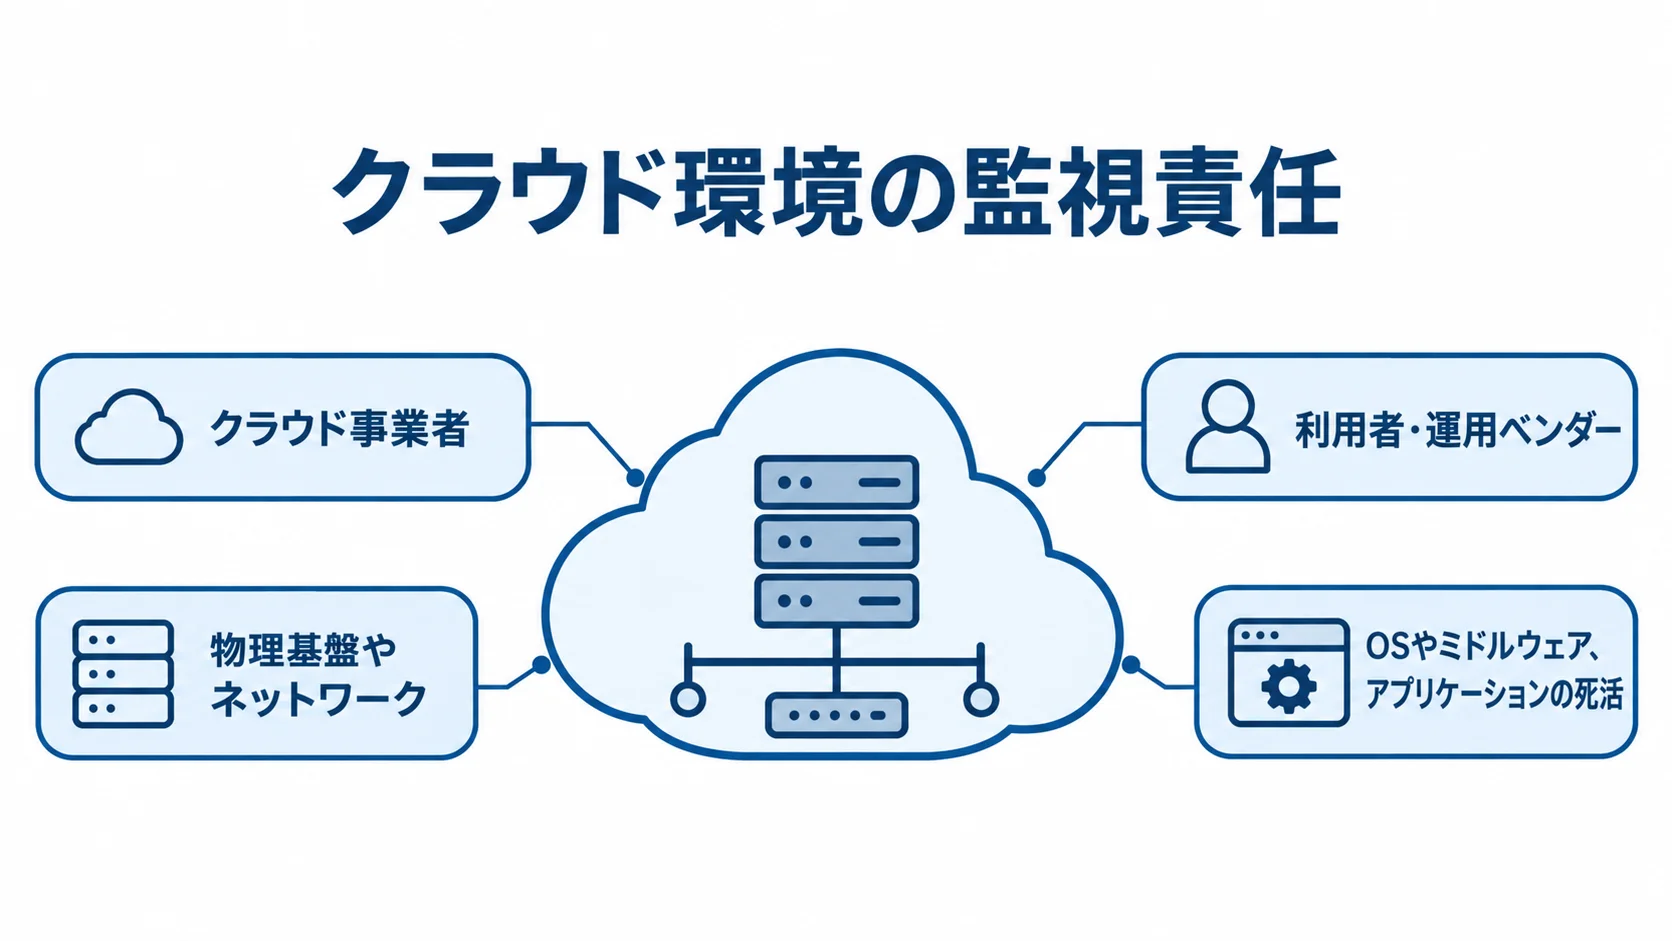
現在のシステムはクラウド基盤で動くものが多く、死活監視のRFPでも、責任共有モデルを前提にした要件定義が欠かせません。国内エンタープライズ・システム市場のクラウド比率は、2022年時点で約5割(IDC Japan)とされ、もはや前提条件です。クラウドでは、どこまでがクラウド事業者の責任で、どこからが利用者・運用ベンダーの責任かが分かれており、ここを要件で整理しないと監視の穴が生まれます。
クラウド層ごとの監視責任の切り分け
クラウド環境では、物理基盤やネットワークはクラウド事業者が監視し、維持します。一方で、その上で動くOSやミドルウェア、アプリケーションの死活は、利用者側の責任になることが一般的です。RFPでは、どの層を監視ベンダーが見るのかを明確に定めます。
クラウド基盤そのものの障害は、利用者側で手出しできず、サービスクレジット以上の補償も基本的に受けられません。そのため、利用者が監視して自衛すべきは、アプリケーション層やサービス応答の死活だと整理しておく必要があります。
この切り分けを怠ると、「クラウドが落ちたのにベンダーは何もしてくれなかった」「アプリのエラーをクラウドのせいにされた」といった押し付け合いが起こります。そこで、RFPには三者の監視責任を表で示し、「クラウド基盤の障害時に、ベンダーは何を検知し、どう連絡し、どう代替するか」を問う項目を入れます。クラウドの監視は見えにくいため、要件で可視化することが自衛の第一歩です。
監視ツールの選定基準
RFPでは、どの監視ツールを使うかの選定基準も要件として示すか、ベンダーに提案させます。OSSのZabbixはライセンス費が無料ですが、自社環境に構築して維持する工数がかかります。一方で、クラウド型のDatadog・New Relic・Mackerelは、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です。
どちらが適するかは、監視対象の数、将来の拡張性、社内の運用力によって変わります。そのため、要件定義の段階で、ツールのライセンス費は誰が負担するのか、従量課金なら対象が増えたときの費用はどう変わるのかを明確にしておく必要があります。
ツールの選定をベンダー任せにすると、契約後に「監視対象を増やすたびにツール費用が上がる」という隠れコストが表面化することがあります。RFPでツールの選定基準と費用負担、変動条件まで問えば、総額で比較できるようになります。
隠れコストを潰す対応範囲の定義
死活監視のRFPで最後に詰めるべきは、異常を検知したあと、どこまで対応してくれるのかという対応範囲です。ここが曖昧だと、障害時に「契約範囲外です」と言われたり、基本料金に含まれると思っていた対応が追加費用になったりして、見積もりは安く見えても支払いは膨らみます。そのため、隠れコストを潰すには、対応範囲を工程ごとに線引きしておくことが欠かせません。
基本料金に含む範囲と追加費用の線引き
RFPには、検知から恒久対策までの工程ごとに、どこまでが月額の基本料金に含まれ、どこからが追加費用になるのかを問う項目を設けます。リサーチでは、運用・監視(24/365の死活・リソース監視)が月5万〜20万円とされています。このうち障害対応は、営業時間内で月3万〜8万円、24時間緊急対応で月10万〜20万円、スポット対応は1件3万〜10万円といった相場です。
これらが基本料金に込みなのか別建てなのかで、総額は大きく変わります。たとえば、「死活監視と一次連絡までは月額に含むが、原因調査と復旧作業は1件ごとのスポット費用」という契約は珍しくありません。これ自体は妥当ですが、それを知らずに「監視を頼めば直してくれる」と思い込むと、障害のたびに想定外の請求が来ます。
RFPで工程別に範囲と単価を問い、月に障害が一定回数を超えた場合の費用の上限や見込みも確認しておくと、年間の総コストを現実的に見積もれます。安すぎる見積もりは、たいてい対応範囲が極端に狭いものです。線引きを問う質問で、それを見抜けます。
契約形態と契約上のリスク条項
対応範囲と並んで、契約形態の選択もRFPで示すべき要件です。代表的な型は次の2つで、それぞれ向き不向きがあります。
- 月額固定型:待機費を含むため安定して即応してもらえる一方、障害が少ない月は割高に感じられます。
- 実働・従量課金型:稼働量に増減がある中小企業に向きますが、繁忙時は費用が読みにくくなります。
そこで、自社の停止傾向を踏まえ、どちらの契約形態を希望するか、あるいは両方の提案を求めるかを示します。さらに、契約上のリスク条項として、SLA未達時のサービスクレジット(料金減額)、損害賠償の上限、間接損害(機会損失など)の免責の有無を問う項目を入れます。多くの契約では、賠償は支払い済み料金の範囲に上限が設けられ、間接損害は免責とされます。
ダウンタイムの損失は、総務省の例で5分以上の停止1回あたり平均1,200万円、Gartnerで1分あたり5,600米ドルとされますが、こうした機会損失は通常ベンダーから補償されません。だからこそ、補償に頼りすぎず、自社のBCP(事業継続計画)と組み合わせて備える前提でRFPを設計することが、発注者の賢明な姿勢です。
riplaはフルスクラッチ受託と国内運用保守の立場から、要件整理から契約設計まで伴走します。
まとめ
ITシステム死活監視のRFPと要件定義では、監視対象の一覧と優先度、監視項目・間隔・閾値を定めることが出発点です。そのうえで、対象別のSLAの数値と保証区分、クラウドの監視責任の切り分け、工程別の対応範囲と契約条件まで書けば、比較できて穴の少ない提案を引き出せます。
発注者が数値で要件を示すほど、各社は同じ条件で見積もれ、安すぎる見積もりが何を省いているかも見抜けます。要件定義では、すべてを最高水準で求めるより、事業影響度に応じて監視とSLAにメリハリをつけ、対応範囲とリスク条項を明文化することが大切です。
ダウンタイム損失や機会損失は基本的にベンダーから補償されないため、SLAとBCPを組み合わせて備える前提でRFPを設計しましょう。riplaはフルスクラッチ受託と国内運用保守を組み合わせ、死活監視の要件整理から契約設計、運用までを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。