
死活監視を導入するとき、失敗の多くは、ツールや委託先の選定より、設定・体制・契約の見落としや発注者側の初動の遅れから生まれます。代表的なのは、監視のブラックボックス化、過剰・過少なSLA、安すぎる見積もりです。
費用相場やSLAの全体像をまだ把握していない方は、まずITシステム死活監視の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
クラウド監視のブラックボックス化リスク
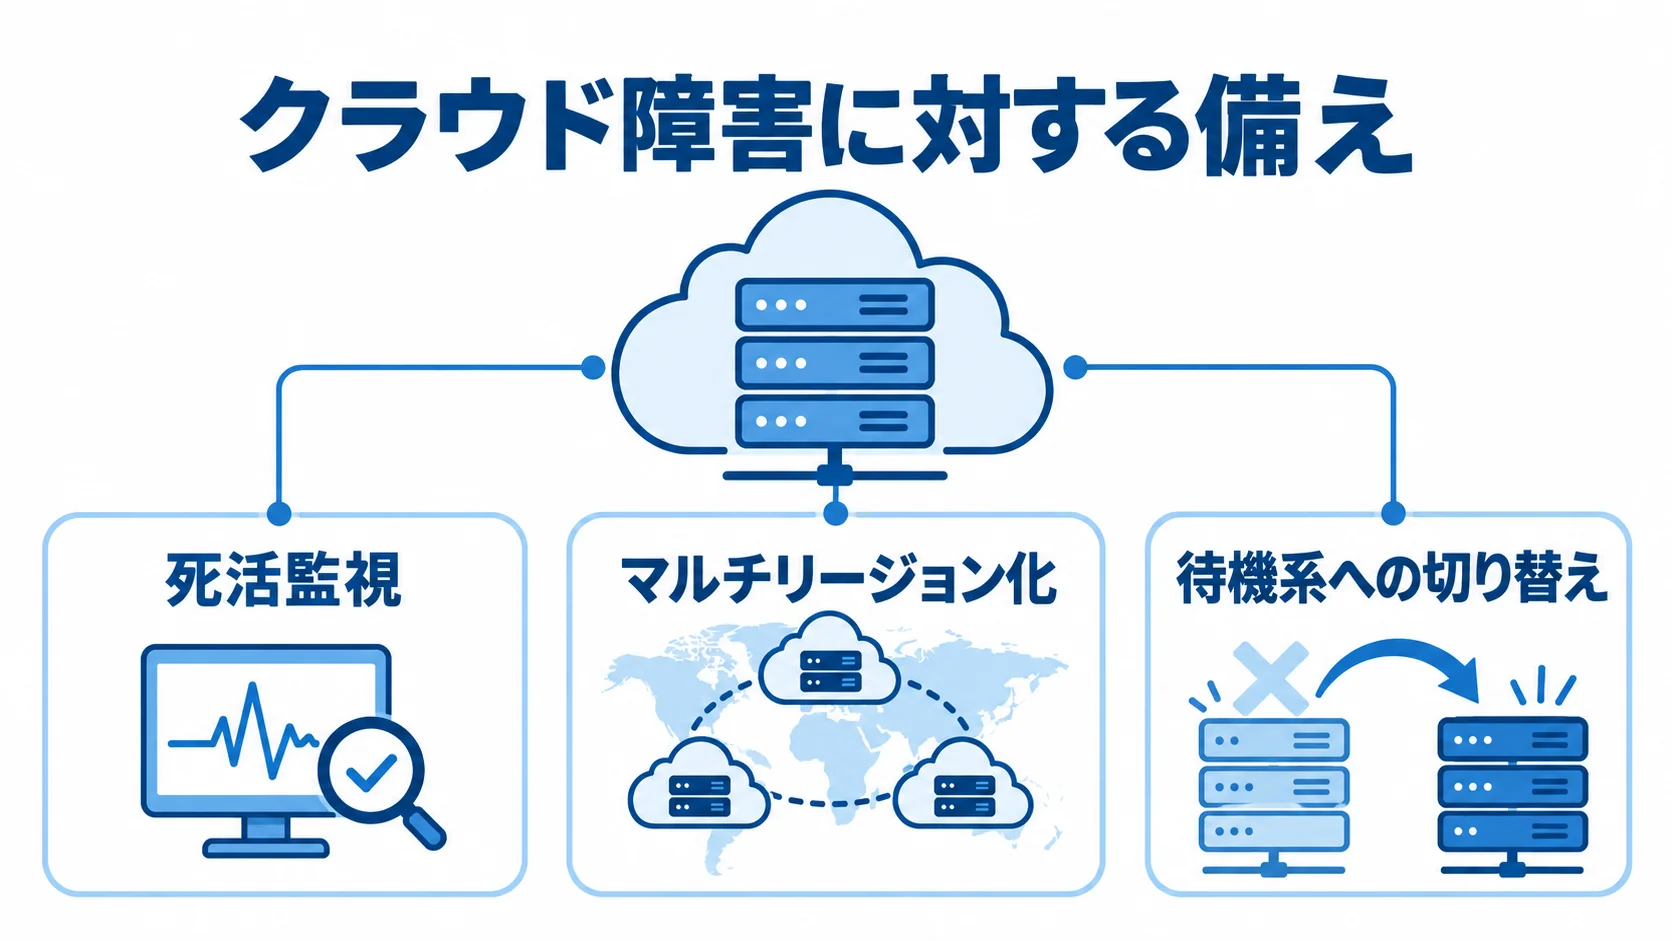
クラウド化が進むほど深刻になるのが、死活監視のブラックボックス化です。
国内エンタープライズ・システム市場のクラウド比率は2022年で約5割(IDC Japan)に達しており、多くのシステムがクラウド基盤の上で動いています。
クラウドは便利な反面、基盤の内部はユーザーから見えず、障害が起きても手出しできない領域が広がります。この見えなさが、思わぬ失敗を招きます。
クラウド基盤障害には手出しできないリスク
クラウド基盤そのものが障害を起こすと、利用者側は復旧を待つしかありません。自社の死活監視で「サービスが落ちた」と検知できても、原因がクラウド事業者側にあれば、ユーザーにできるのは状況把握と顧客への連絡だけです。
この「手出しできない」リスクを軽視すると、いざクラウドが落ちたときに備えのないまま事態を見守るしかなくなります。総務省の例では、5分以上の停止1回あたり平均1,200万円の機会損失とされています。
クラウドだから安心、監視は事業者任せでよい、という思い込みこそが、最初の落とし穴です。
- 補償の範囲:サービスクレジットを超える補償を事業者から受けられるか
- 停止時の連絡体制:状況把握と顧客への連絡を誰が担うか
サービスクレジットは、料金の一部返金のことです。さらに、機会損失や信頼の毀損は、利用者が自分で負うことになります。
マルチリージョン化など自衛アーキの検討不足
ブラックボックス化への自衛策は、アーキテクチャの工夫です。単一のリージョン(地域)にすべてを置くと、そのリージョンが落ちればサービス全体が止まります。
一方で、複数リージョンに分散させるマルチリージョン化や、待機系への切り替え(フェイルオーバー)を設計しておけば、片方が落ちてもサービスを続けられます。死活監視は、こうした自衛アーキと組み合わせて初めて、クラウド障害に対する備えになります。
ここで失敗しやすいのは、自衛アーキを検討せず、監視だけ入れて「これで安心」と考えてしまうケースです。監視は停止を「知る」ための仕組みで、停止を「防ぐ・回避する」のはアーキテクチャの役割です。
マルチリージョン化は隠れコストも伴うため、すべてのシステムに必要なわけではありません。
死活監視を入れる際は、検知の先にある「停止したらどう継続するか」までセットで設計しないと、見えない基盤障害に足をすくわれます。
- 自衛アーキの対象:止まってはいけないシステムの範囲
- 停止後の継続方法:待機系への切り替えや、複数リージョンへの分散
対象は、自社の事業影響度に照らして決めます。
過剰・過少なSLAの落とし穴
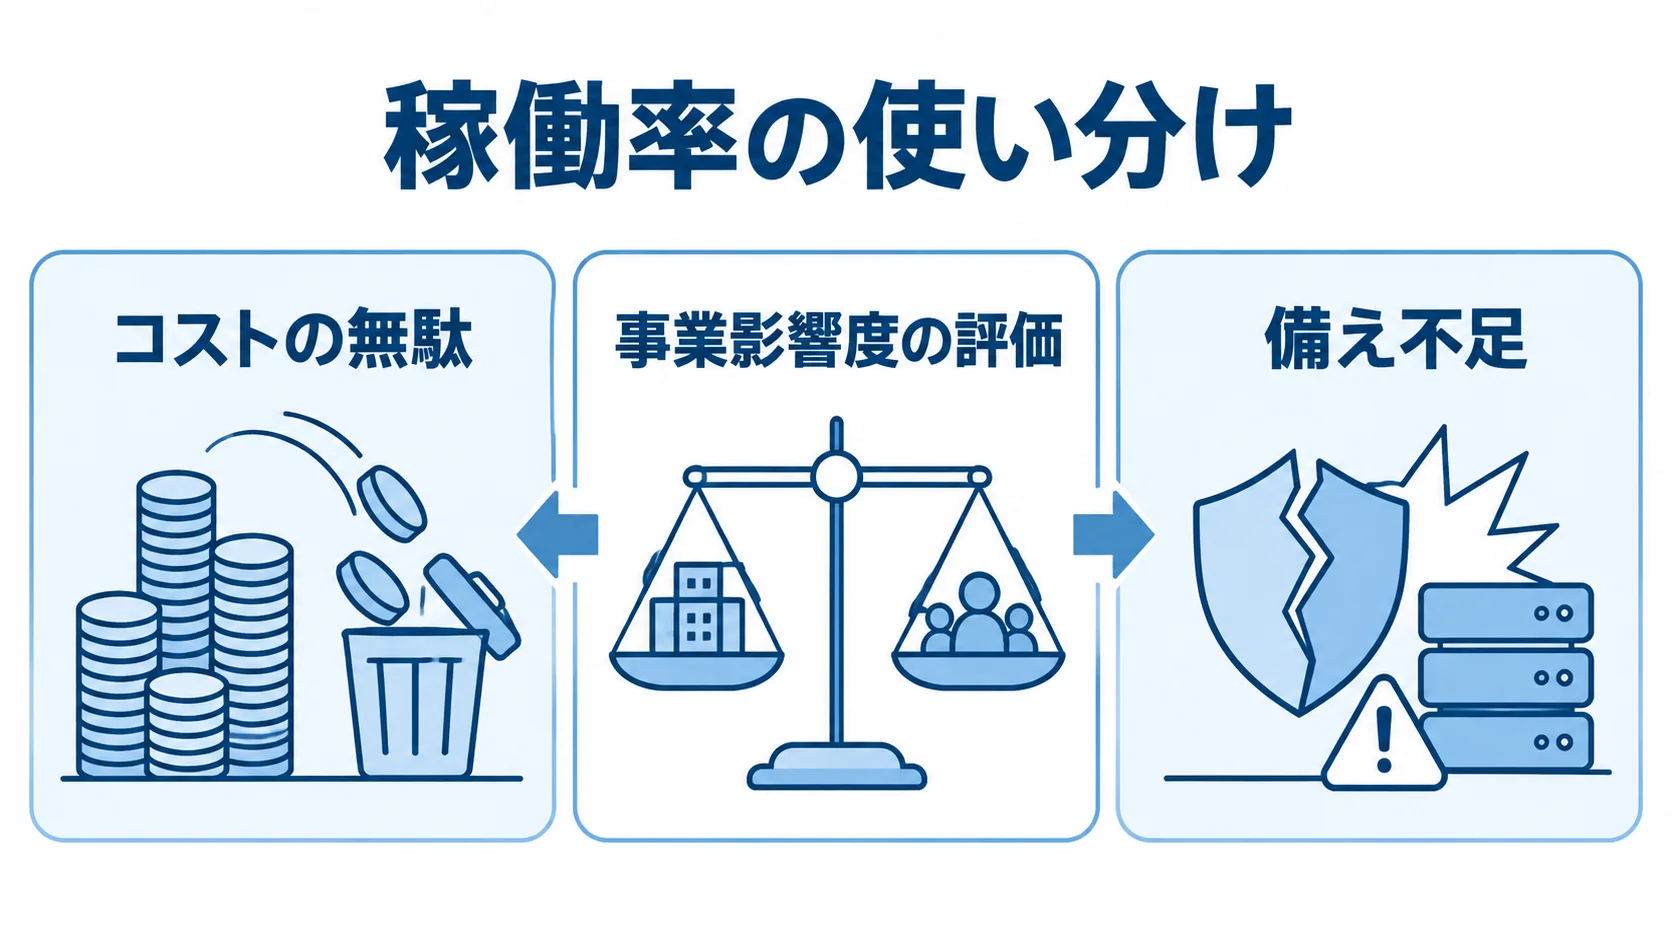
死活監視のSLA(稼働率や復旧時間の約束)は、高すぎても低すぎても失敗につながります。過剰なSLAはコストの無駄を生み、過少なSLAはいざというときの備え不足を招きます。
どちらも、自社の事業影響度を見極めずに「念のため高く」あるいは「とりあえず安く」と決めてしまうことから起こる落とし穴です。
過剰SLAでコストを払い過ぎる失敗
「止まったら困るから、とにかく高い稼働率を」と過剰なSLAを設定すると、コストを払い過ぎる失敗に陥ります。
稼働率99.9%は年間許容ダウンタイム8.76時間ですが、99.99%にすると年52.6分しか許されません。
さらに、これを満たすには高頻度の監視と24/365の即応体制が必要になります。
リサーチでも、稼働率の「9」が1つ増えるごとに運用コストは段階的に跳ね上がるとされています。
問題は、社内向けの参照システムのように、夜間や休日に止まっても翌営業日までに直れば実害がほとんどないシステムにまで、一律で高い稼働率を求めてしまうことです。
これは保険を掛け過ぎている状態です。そのため、毎月の運用費が事業価値に見合わない負担になります。
失敗を避けるには、システムごとに「30分止まったらいくらの損失・どんな業務影響か」を評価し、影響度に応じてSLAにメリハリをつけることです。
過剰SLAは、見直すだけでコストが下がる、もったいない失敗だと言えます。
- 評価の単位:システムごとの、停止1回あたりの損失と業務影響
- 稼働率の使い分け:影響度に応じた、高い稼働率と通常水準の使い分け
過少SLA・努力目標型で備え不足になる失敗
逆に、コストを惜しんでSLAを低く設定したり、努力目標型(未達でもペナルティなし)で済ませたりすると、いざというときに備え不足が露呈します。
基幹システムのように、止まると売上や信頼に直結するものを努力目標型SLAで契約していると、停止しても「最善は尽くしました」で終わります。さらに、復旧が後回しにされかねません。
安心して任せられるはずの監視が、実は何も保証していなかった、という失敗です。
とくに見落とされがちなのが、復旧目標時間が定められていない、あるいは曖昧な契約です。たとえば「できるだけ早く対応します」では、何時間止まっても契約違反にならず、発注者は手も足も出せません。
失敗を避けるには、重大なシステムについて保証型SLAとすることです。そのうえで、初報の応答時間(例:検知後15分以内に連絡)と復旧目標時間(例:重大障害は2時間以内に対応開始・24時間以内に完全復旧)を数値で約束させます。
SLAの過剰と過少は、どちらも事業影響度の評価を飛ばしたことが原因であり、影響度に応じた設計こそが両方の失敗を防ぎます。
- 初報の応答時間:検知から最初の連絡までの時間の約束
- 復旧目標時間:重大障害ごとの対応開始と完全復旧までの時間
安すぎる見積もりが招くトラブル
死活監視の委託先を選ぶとき、複数社から見積もりを取ると、極端に安い提案に目を奪われがちです。しかし、安すぎる見積もりには、たいてい理由があります。
その理由は、対応範囲が極端に狭い、SLAがない、隠れコストが後から発生する、といった落とし穴です。
値段だけで選ぶと、結局は高くつくトラブルに直面します。
対応範囲外・SLA欠如という安さの正体
安い見積もりの正体は、多くの場合「監視はするが、対応はしない」という範囲の狭さです。死活を検知して通知するところまでは安くできても、原因調査や復旧作業は含まれません。そのため、いざ障害が起きると「それは別料金です」とスポット費用を請求されることになります。
リサーチでは、スポット対応は1件3万〜10万円、24時間緊急対応は月10万〜20万円が相場です。これらが基本料金に含まれていなければ、その分が別途かかることになります。また、安く見えた月額はあっという間に膨らみます。
安い見積もりは、SLA自体がないか、あっても努力目標型であることが多く、停止しても責任を問えません。
失敗を避けるには、見積もりの金額だけで判断せず、契約内容まで確認することです。
安さの裏で何が省かれているかを見抜けば、表面的な金額に惑わされずに済みます。監視は安心を買う行為であるのに、安さを優先して安心が買えていなかった、という失敗は最も避けたいものです。
- 月額の対象範囲:検知から復旧までのどこまでが含まれるか
- SLAの種類:保証型か、努力目標型か
賠償上限・間接損害免責という契約リスク
もう一つの見落としが、契約上の賠償リスクです。多くの監視・運用契約では、損害賠償の上限が「支払い済み料金の範囲」に設定され、機会損失などの間接損害は免責とされています。
つまり、監視ベンダーのミスで停止が長引いても、補償されるのはせいぜい月額数万〜数十万円の範囲で、ダウンタイムによる売上損失は補填されません。
Gartnerの調査では、ダウンタイムは1分あたり平均5,600米ドルとされています。総務省の例では、5分以上の停止1回あたり平均1,200万円の機会損失とされており、これらはまず補償の対象外です。
「監視を委託したから損失も補償される」という思い込みは危険です。SLAのサービスクレジットも、損失全額の補填ではありません。
失敗を避けるには、補償に過度に依存せず、SLAと自社のBCP(事業継続計画)を組み合わせて備える前提で契約することです。
契約書の賠償条項を読まずにサインするのは、静かに大きなリスクを抱え込む失敗です。
- 賠償の上限:支払い済み料金の範囲に収まっているか
- 間接損害の扱い:機会損失などが免責に含まれているか
発注者側の初動失敗とBCP不在
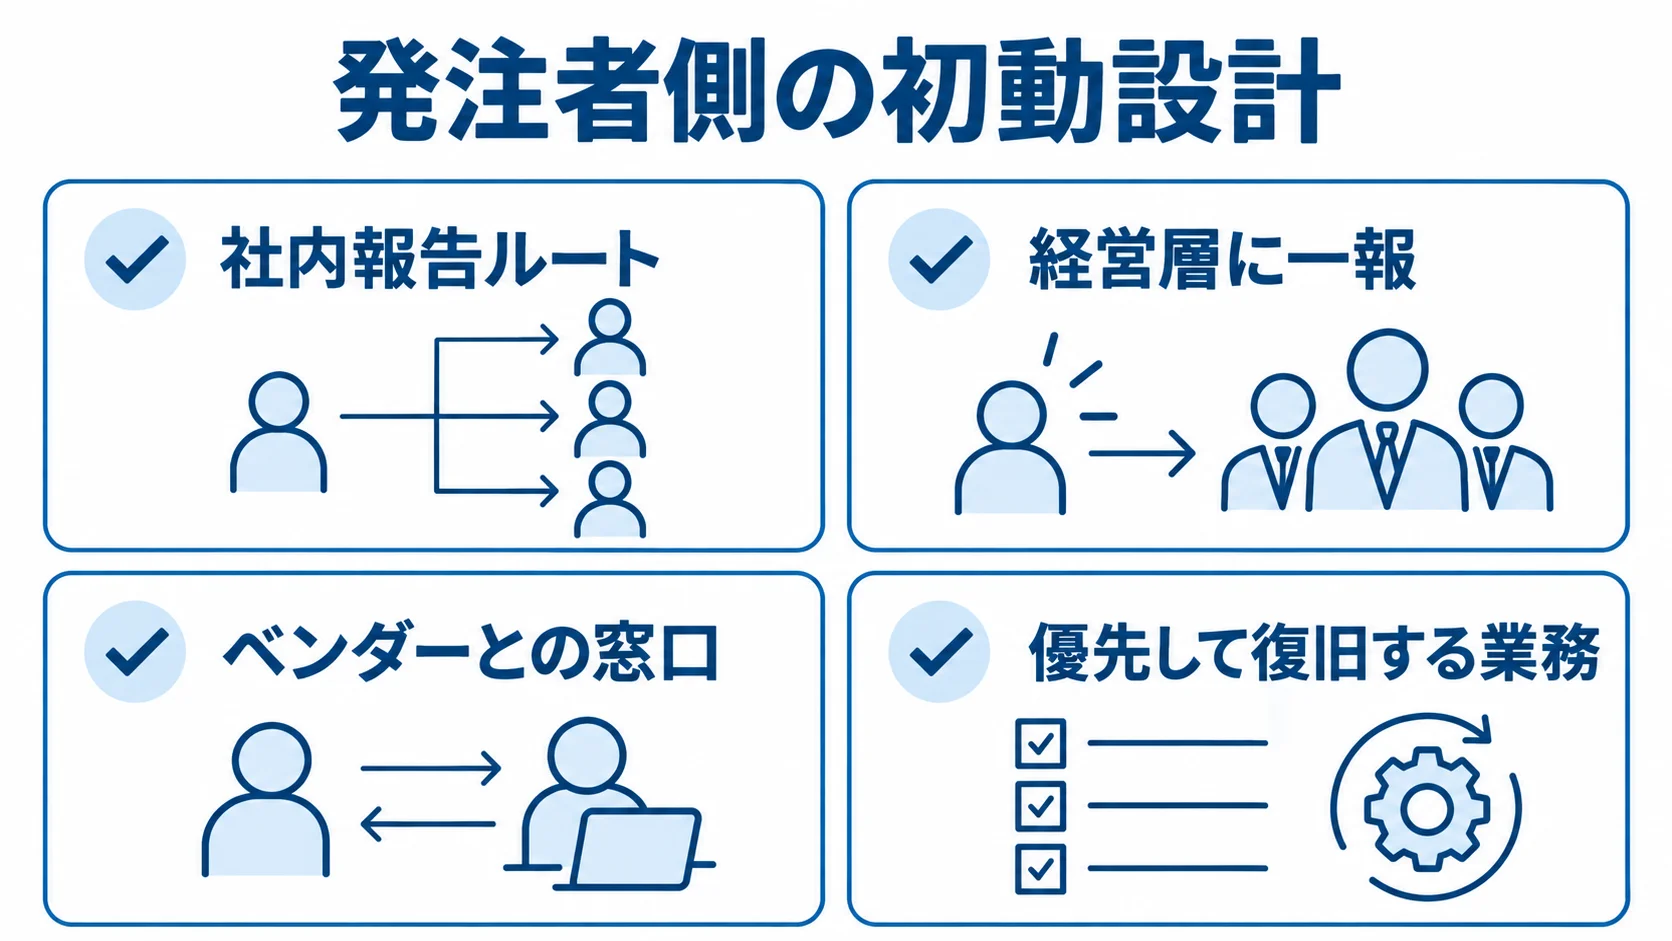
死活監視の失敗は、ベンダー側だけの問題ではありません。むしろ見落とされがちなのが、発注者(情シス)側の初動の失敗です。
監視を委託しても、すべてをベンダーに任せきりにはできません。
停止が起きたときに社内で何をするかは発注者の責任で、ここが整っていないと、せっかくの検知が活かされません。
経営・業務部門への報告遅延という失敗
停止が検知されても、発注者側で経営層や業務部門への状況報告・エスカレーションが滞ると、組織としての対応が後手に回ります。
技術的な復旧をベンダーが進めている間に、情シスは「いつ復旧するのか」「顧客にどう案内するか」を経営や現場と調整しなければなりません。この報告と調整が遅れると、復旧そのものが順調でも、対外的な信頼を損ないます。
失敗を避けるには、停止時の社内報告ルートをあらかじめ決めておくことです。具体的には、誰が経営層に一報を入れ、誰が業務部門と顧客対応を調整し、誰がベンダーとの窓口になるかを、役割ごとに決めておきます。
この役割分担が決まっていないと、停止のたびに混乱が生じます。ベンダーに監視を任せても、社内の初動だけは発注者が設計しておく必要があります。これは委託では肩代わりできない、発注者固有の責任です。
- 経営層への一報:報告する担当者と、入れる時点
- ベンダーとの窓口:発注側で窓口を担う人と、連絡の経路
ベンダー丸投げとBCP不在のリスク
最も根深い失敗が、「監視を委託したのだから、あとはベンダーがすべてやってくれる」という丸投げの姿勢です。
監視ベンダーは、技術的な検知と一次対応はできても、その停止が自社のどの業務に、どれだけ影響するかや、どう事業を継続するかまでは判断できません。
停止時にどの業務を優先して復旧し、復旧までの間どう業務を代替するかは、発注者がBCP(事業継続計画)として持っておくべきものです。
BCPが不在のまま監視だけ委託すると、停止を検知できても「で、どうするのか」を誰も決められず、現場が混乱します。
死活監視は、停止を知らせる入り口にすぎず、その先の業務継続の判断は発注者の領域です。
riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った後も伴走し、死活監視・障害対応を「コスト」ではなく「事業継続の保険+投資」として位置づけています。
また、発注者側の初動設計やBCP連動まで一緒に整えることを重視しています。監視を入れて終わりにせず、停止したときに組織がどう動くかまで描くことが、死活監視を本当に意味あるものにします。
- 優先して復旧する業務:停止時にどの業務から戻すか
- 復旧までの業務の代替:復旧を待つ間、業務をどう回すか
まとめ
ITシステム死活監視の失敗は、4つに整理できます。(1)クラウド基盤障害に手出しできず、ブラックボックス化するリスクがあります。
(2)過剰SLAでコストを払い過ぎ、過少SLAで備え不足になる落とし穴です。
(3)対応範囲外やSLA欠如、賠償上限といった、安すぎる見積もりの罠。(4)発注者側の報告遅延、ベンダー丸投げ、BCP不在という初動の失敗です。
これらは、事業影響度の評価不足や契約・運用の見落としから生まれる、防げる失敗です。
失敗を避ける共通原則は、死活監視を「入れれば安心」と考えないことです。クラウドの限界を踏まえた自衛アーキと事業影響度に応じたSLAを組み合わせ、契約では対応範囲と賠償を見抜き、発注者側の初動設計とBCPまで整えます。
これらをセットで備えてはじめて、損失(1回1,200万円・1分5,600ドル)に対する本当の備えになります。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、死活監視のリスクを抑えて、事業継続の保険+投資として機能させる支援を一貫して行っています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。