
監視は導入して終わりではなく、アラートの運用と障害の収束の速さで価値が決まります。
自社に近い規模・体制の導入事例や成功事例を見ると、投資判断の精度を高められます。全体像をまだ把握していない方は、まずITシステム監視対応の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム監視対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ダウンタイムを削減したBefore/After事例
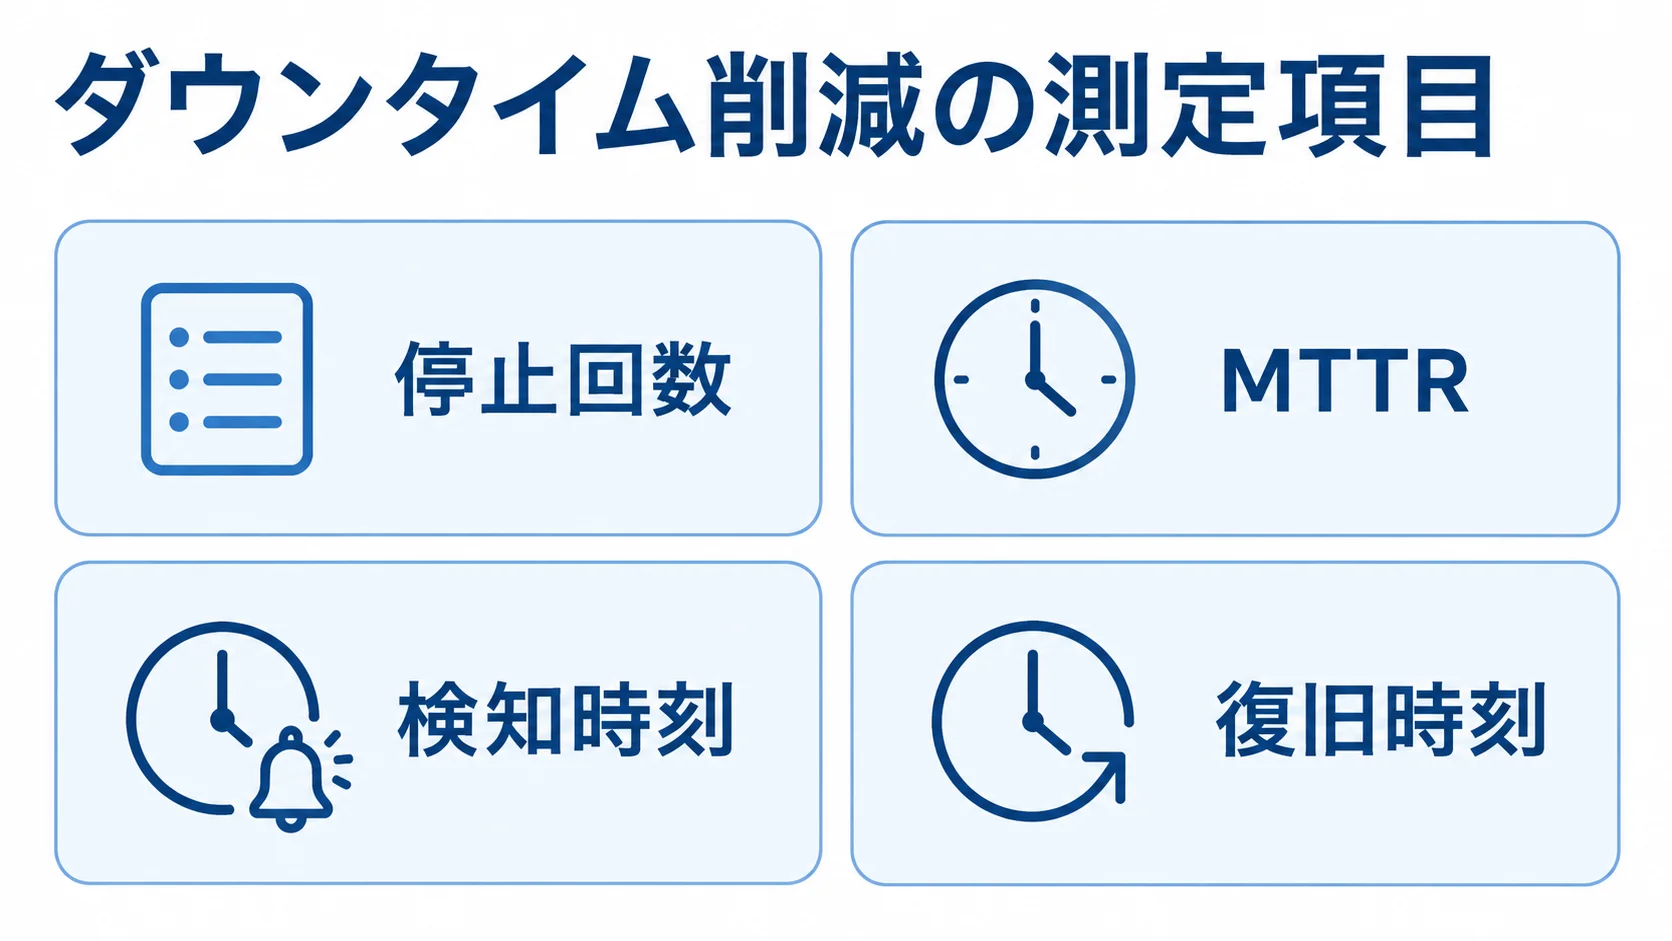
監視対応の成果がもっとも分かりやすく表れるのが、ダウンタイム(システム停止時間)の削減です。監視が手薄な状態では、障害が起きてもユーザーからの問い合わせで初めて気づき、原因の切り分けにも時間がかかります。
これに対し、適切な監視と一次対応の体制を入れると、検知から復旧までの時間が短くなり、停止回数そのものも減っていきます。事例を読むときは、「Before/Afterで何がどれだけ変わったか」を数字で押さえることが重要です。
停止回数とMTTRを可視化して改善した事例
まず取り組むべきは、現状の停止回数とMTTR(平均復旧時間)を測ることです。ある事例では、監視導入前は「月に何回止まったか」「平均何時間で直ったか」を誰も正確に把握しておらず、障害対応が場当たり的になっていました。
そこで、死活監視とリソース監視を入れて検知を自動化し、障害ごとに検知時刻・一次対応時刻・復旧時刻を記録するようにしたところ、はじめてMTTRが数字で見えるようになりました。
改善の効果は、ダウンタイムを損失額に換算すると経営層にも伝わりやすくなります。たとえば、総務省の2025年版の資料では、金融・医療・EC系で5分以上の停止が1回あたり平均1,200万円の機会損失につながるとされています。
また、Gartnerの2024年の試算では、ダウンタイム1分あたり5,600米ドルの損失とされています。これらの数字を自社の停止時間に掛け合わせれば、監視投資の回収ロジックが描けます。停止回数を月数回から数えるほどに減らせれば、年間で数千万円規模の損失回避につながるという説明が、稟議でも通りやすくなります。
改善の効果を追うときに見る数字は、回数と復旧時間の2つです。
- 停止回数:月ごとの回数を、改善の前後で比べられる形にしておく
- MTTR:平均復旧時間を工程ごとに分け、時間のかかる箇所を探す
性能監視で予兆検知し障害を未然に防いだ事例
ダウンタイム削減のもう一段上の成果は、障害を「起こさない」ことです。事例の中には、死活監視だけでなく性能監視(CPU・メモリ・ディスク・レスポンスタイムの監視)を組み合わせたものがあります。
また、閾値を超える予兆の段階でアラートを上げる仕組みを整えた企業があります。ディスク使用率が90%を超えた段階で通知が届けば、満杯になってサービスが止まる前に手を打てます。これは「落ちてから直す」運用から「落ちる前に防ぐ」運用への転換であり、ダウンタイムをゼロに近づける効果があります。
予兆検知を機能させるには、何をどの閾値で監視するかを設計しておくことが欠かせません。閾値が緩すぎると手遅れになり、厳しすぎるとアラートが鳴りやまず形骸化します。
成功事例では、過去の障害履歴を振り返り、「あの障害の前にどんな兆候が出ていたか」を分析して閾値を決めています。さらに、リソースの傾向をグラフにして、増設や設定変更の時期を前もって判断できるようにしています。性能監視は単なる監視項目の追加ではなく、障害を未然に防ぐ攻めの運用への入り口だと言えます。
予兆検知を運用に根づかせるうえで、特に手をかけたいのは閾値と、増設や設定変更の判断時期です。
- 閾値:一度決めて終わりにせず、後から見直せるようにしておく
- 増設や設定変更の時期:リソース傾向のグラフをもとにした、前もっての判断
夜間障害の火消し体制を立て直した事例
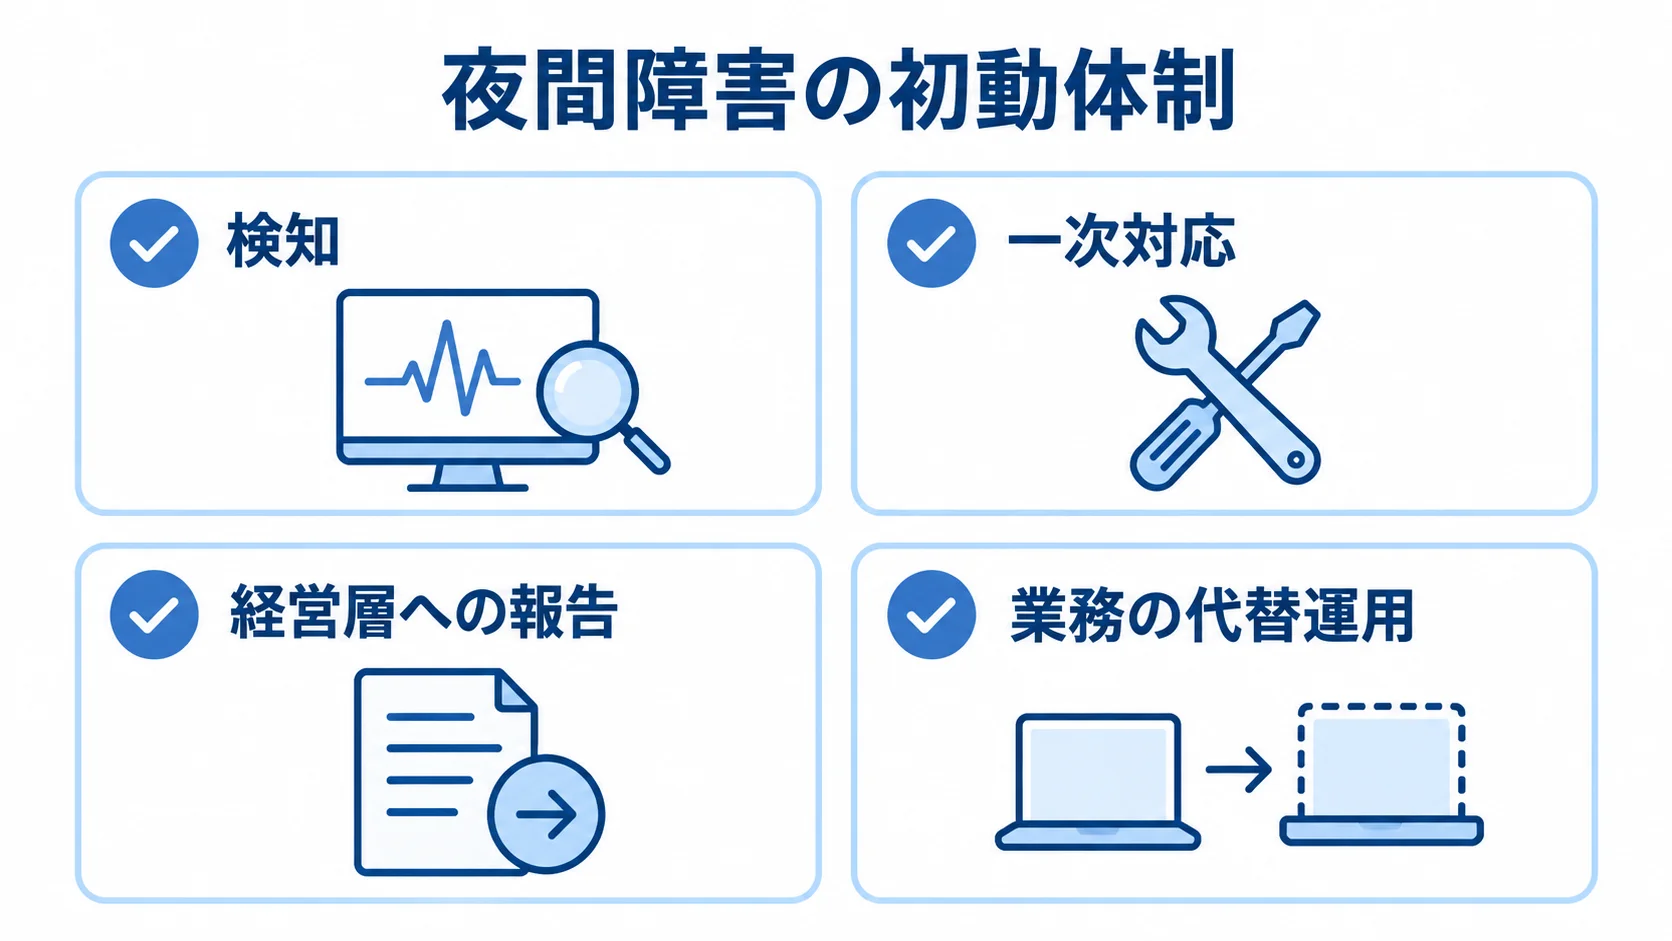
監視対応で多くの企業がつまずくのが、夜間・休日の障害対応です。日中は人がいても、深夜や週末に障害が起きたとき、誰がどう動くかが決まっていないと、復旧が翌朝までずれ込みます。
この「夜間の火消し」をどう立て直したかは、事例のなかでも特に参考になります。属人的な携帯電話の呼び出しから、体制とエスカレーションルールを整えた運用へ転換できるかどうかが、その鍵になります。
24/365の一次対応を外部委託で確立した事例
夜間障害を立て直した事例で多いのが、24時間365日の死活監視と一次対応を外部に委託するパターンです。自社で24/365の当直体制を組もうとすると、最低でも交代要員が複数名必要になり、人件費が膨らみます。
一次データでは、監視オペレーターの人月単価は60万〜80万円が目安とされています。そのため、24時間体制を内製で組むのは、中小企業には現実的ではありません。これに対し、24時間の緊急障害対応を外部委託すると、月10万〜20万円程度から始められるため、コストを抑えながら夜間の穴を埋められます。
外部委託で重要なのは、委託先に「どこまでやってもらうか」を明確にすることです。検知と一報だけなのか、定型手順による一次復旧まで含むのかを曖昧なままにすると、夜間に検知されても誰も手を動かさない事態になります。成功事例では、監視・一次対応・原因調査・復旧の各工程について、委託先が担う範囲と自社が担う範囲を文書で定義しています。
シーズホスティングの例では、検知から60分以内の通知・12時間での復旧を提示しています。こうしたSLAを契約に落とし込めば、夜間でも一定時間内に状況が動く体制になります。
委託先との契約で中身を決めるのは、料金の決まり方と、通知や復旧までの時間の約束です。
- 委託料:検知だけか、一次対応まで含むかで、金額の出方が変わる
- SLA:通知と復旧の時間を、契約書の条件として書き込む
エスカレーションとBCP連動の初動を整えた事例
夜間障害の立て直しには、外部委託に加えて、発注側の初動も欠かせません。委託先が検知と一次対応を担っても、重大障害では発注者である情報システム部門が経営層や業務部門へ報告し、判断を仰ぐ必要があります。
この発注側の初動を整えた事例では、レベルごとに「誰に・いつまでに・何を報告するか」を決めています。そのため、深夜の重大障害でも、エスカレーションのルートがあらかじめ決まっていれば、現場が迷わず動けます。
さらに進んだ事例では、障害対応をBCP(事業継続計画)と連動させています。基幹システムが長時間止まったとき、手作業の代替運用に切り替える基準や、顧客への告知文の雛形をあらかじめ用意しておくことで、復旧を待つ間も事業を止めずに済みます。
ベンダーに任せきれない部分だからこそ、発注側がこの初動を設計しておくことで、夜間障害を「混乱」から「想定内の対応」へと変えられます。火消し体制の立て直しは、外部委託とエスカレーション設計がそろって初めて成り立つものです。
発注側が初動で先に決めておくのは、障害の重さの区分と、基幹システムごとの代替運用の切り替え基準です。
- レベル分け:軽微、中、重大の区分を、業務側と合意しておく
- 業務の代替運用:基幹システムごとの切り替え基準
ひとり情シスが監視と一次対応を委託した事例
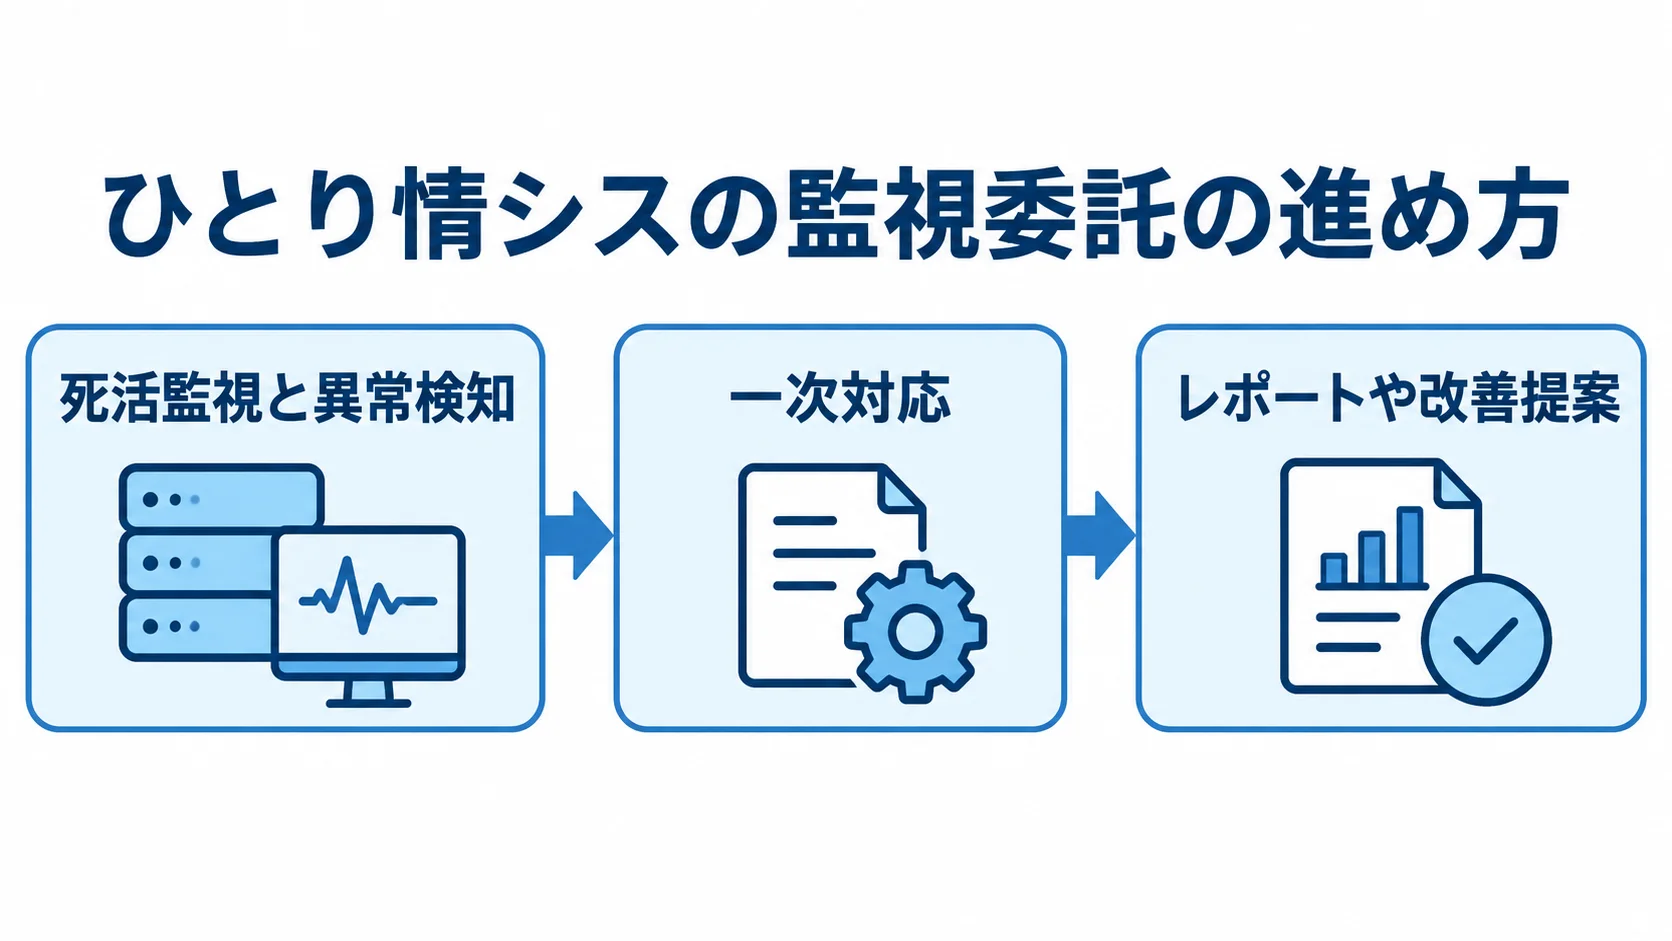
中小企業に多い「ひとり情シス」では、監視対応がもっとも切実な課題になります。担当者が一人で社内システム全般を見ている状態では、24時間の監視はもちろん、日中の障害対応すら本来業務を圧迫します。
この状況をどう打開したかは、リソースの限られた企業にとって極めて実践的な事例です。委託範囲の決め方と、自分にしか分からない知識を外に出すことが、その分かれ目になります。
低コストの監視サービスからスモールスタートした事例
ひとり情シスの事例で堅実なのは、いきなり高額なフルマネージドを契約せず、低コストの監視サービスから段階的に始める進め方です。一次データでは、サーバー監視は1台5,000円、障害対応を含めても1台10,000円程度です。また、フルマネージドでも1台20,000円程度(いずれも月額)という料金例があります。
まず死活監視と異常検知だけを委託し、アラートを担当者の携帯に飛ばす最小構成から始めれば、月数万円の負担で「気づけない」という最大のリスクを解消できます。スモールスタートの利点は、効果を見ながら委託範囲を広げられることです。
最初は検知だけを委託し、運用に慣れたら一次対応を、さらにレポートや改善提案へと、段階的に範囲を広げていきます。この進め方なら、担当者が委託先との連携の勘所をつかみながら、無理のないペースで運用を移管できます。
SHIFTのSOC運用支援のように、月9万円(シルバープラン)から提供されている例もあります。入り口の敷居が低いサービスを選べば、ひとり情シスでも監視対応の第一歩を踏み出せます。
委託先を比べるなら、1台あたりの月額の差と、契約期間や解約の条件を並べて見ることになります。
- 料金:検知のみか、障害対応まで含むかによる、1台あたりの月額の差
- 契約の条件:入り口の料金の低さだけでなく、最低契約期間や解約条件も確認する
属人化を解消して引き継ぎ可能にした事例
ひとり情シスの最大のリスクは、その人が休んだり辞めたりした瞬間に運用が止まることです。事例では、外部委託を機に、これまで担当者の頭の中だけにあった運用知識を文書化しています。
サーバーの構成、監視項目と閾値、障害時の連絡先と対応手順を運用手順書にまとめ、委託先と共有することで、特定個人に依存しない運用へと移行しました。
委託は、業務を丸ごと預けることにとどまらず、属人化した知識を外に出して標準化する好機でもあります。標準化が進むと、担当者は日常の障害対応から解放され、本来やるべき社内DXの企画や業務改善に時間を割けるようになります。これはコスト削減以上の価値です。
事例の担当者は「監視と一次対応を任せたことで、初めて前向きな仕事に着手できた」と語っています。委託は単なる省力化にとどまらず、情報システム部門の役割を後ろ向きの保守から前向きの企画へ引き上げる手段にもなり得ます。ひとり情シスの監視委託は、リスク解消と役割転換を実現する一手だと言えます。
手順書を外に出したあとは、委託先と共有し続ける仕組みと、担当者の空いた時間の使い道が課題になります。
- 委託先との共有:手順書を渡すだけでなく、更新の担当も決めておく
- 空いた時間の使い道:社内DXの企画や業務改善への振り向け
過剰SLAを適正化してコスト削減した事例
監視対応の事例では、コストを「増やす」話だけでなく「減らす」話も重要です。中でも見落とされがちなのが、必要以上に高いSLA(サービス品質保証)を契約していたために、過剰なコストを払い続けていたケースです。
稼働率や復旧時間の目標を一段下げるだけで、運用コストを圧縮できることがあります。事例から学べるのは、SLAを高ければ良いとするのではなく、事業影響度に見合った水準に合わせるという視点です。
稼働率99.99%から99.9%へ見直してコストを下げた事例
稼働率の「9」が一つ増えるごとに、運用コストは段階的に跳ね上がります。一次データによれば、稼働率99.9%なら年間で許容される停止時間は約8.76時間(月43.8分)ですが、99.99%にすると年間52.6分(月4.38分)まで厳しくなります。
この差を埋めるには、冗長構成・即時切替・24時間の即応体制が必要になり、コストが大幅に増えます。事例では、社内システムに99.99%を求めていた企業が、実際の事業影響を見直して99.9%へ引き下げ、運用コストを圧縮しました。
ポイントは、稼働率を下げる前に「数分の停止が本当に致命的か」を業務ごとに検証することです。基幹の決済システムなら高い稼働率が必要ですが、社内の情報共有ツールであれば、月に数十分の停止が許容できる場合も少なくありません。
この事例の企業は、システムを重要度でランク分けし、最重要のものだけ高SLAを維持し、それ以外を緩和することで、全体のコストを抑えました。過剰コストの削減につながるのは、一律に高いSLAをかけず、業務ごとにメリハリをつける判断です。
見直しで判断するのは、停止をどこまで許せるかと、どのシステムに高いSLAを残すかの2点です。
- 停止の許容時間:年間と月ごとの数字を並べて、業務側と確認する
- システムの重要度:ランク分けによる、高いSLAを残す対象の絞り込み
充填型保守で待機費を新機能開発に振り替えた事例
SLA適正化のもう一つの形が、保守費の「投資化」です。障害が起きなかった月の待機費を「無駄」と感じる方も少なくありません。
事例の中には、月額固定の保守契約のなかで、障害対応に使わなかった余剰工数を新機能開発や改善作業へ振り替える「充填型保守」を採用した企業もあります。これにより、同じ保守費を払いながら、障害ゼロの月でもシステムが少しずつ良くなっていく状態を作りました。
riplaはフルスクラッチ受託と国内運用保守の立場から、こうした「保守をコストでなく投資に変える」契約設計を重視しています。過剰SLAの適正化と充填型保守は、監視・障害対応のコストを単なる出費から、事業継続の保険と改善の原資へと転換する有効な打ち手です。
充填型保守では、余った工数の使い道と、充てる改善タスクの大きさを契約の段階で決めておきます。
- 余剰工数の扱い:障害対応に使わなかった分の使い道を、事前に決めておく
- 改善タスクの規模:小規模な作業を中心にした、翌月への振り替え
事例では、月の工数枠のうち障害対応で使わなかった分を、翌月に充てる運用ルールを定めています。
まとめ
ITシステム監視対応の事例を振り返ると、成果は「停止回数とMTTRを数字で見えるようにし、夜間の火消し体制を整え、自社のリソースに合った委託範囲を設計する」という流れに集約されます。そこに、SLAを事業影響度に見合った水準へ最適化するという視点が加わります。
損失額の目安として、金融・医療・EC系では5分以上の停止が1回あたり平均1,200万円とされ、Gartnerの試算では1分あたり5,600米ドルです。性能監視による予兆検知は、障害そのものを未然に防ぎます。
ひとり情シスは、低コストの監視サービスからスモールスタートし、過剰なSLAを適正化すれば、充填型保守で待機費を改善投資へ振り替えることもできます。
事例を読むときに大切なのは、「いくらかけたか」ではなく「事業がどれだけ止まらなくなり、何を改善できたか」という視点です。まずは自社の停止回数とMTTRを測ることから、監視対応の改善を始めてください。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、事業継続の保険として効く監視・障害対応の体制づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。