
ITシステム監視対応は、障害の検知から復旧までの流れを設計し、役割分担を明確にする取り組みです。24時間365日の障害対応を仕組み化すると、障害の影響と現場の疲弊を抑えられます。
階層体制から発注のポイントまで、全体像を順に整理しました。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム監視対応の関連記事一覧
テーマごとの詳細は、関連記事にまとめています。全体像をつかんだあと、必要な領域の記事から読み進めてください。
- ITシステム監視対応の進め方|L1/L2/L3の役割設計とインシデント対応フロー
- ITシステム監視対応のおすすめ会社|階層体制・MTTR実績で比較
- ITシステム監視対応の費用相場|対応レベル別の料金と24/365コスト
- ITシステム監視対応の発注・外注方法|SLA設定とマルチベンダー調停
ITシステム監視対応の全体像
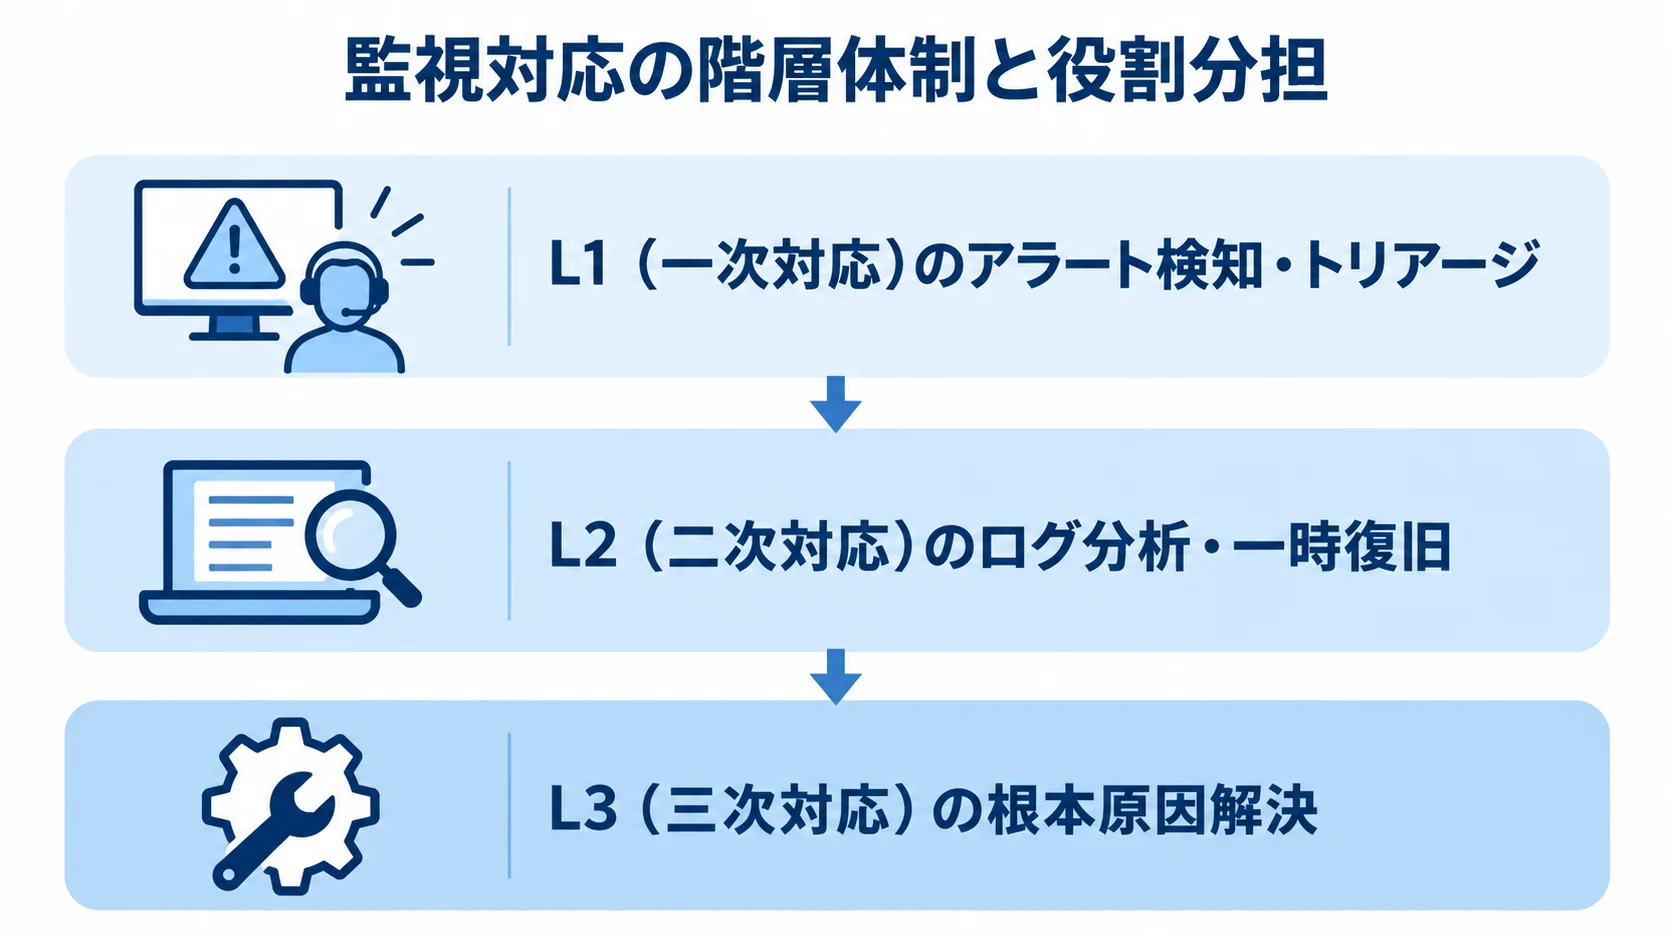
ITシステム監視対応とは、サーバーやネットワーク、アプリケーションから上がってくるアラートを検知し、切り分け・一時復旧・根本解決へとつなげる一連の運用作業を指します。
重要なのは、誰が、どこまで、どの順番で対応するかという役割分担です。これが曖昧だと、軽微なアラートに専門家が振り回されることもあれば、逆に重大な障害が放置されることもあります。
監視対応の現場では、対応を3つの階層に分けて設計するのが一般的です。一次対応(L1)、二次対応(L2)、三次対応(L3)と段階を踏むことで、各担当者は自分の専門性に集中でき、対応の速さと品質を両立できます。
監視対応を仕組みとして組み立てるには、まずこの基本構造の理解が出発点になります。
L1/L2/L3の階層体制と役割分担
L1(一次対応)は、アラートの検知とプレイブックに基づくトリアージを行い、パスワードリセットなどの定型作業を担います。L2(二次対応)は、詳細なログ分析や一時復旧、監視ルールのチューニングを担当します。
L3(三次対応)は、アーキテクチャ変更やデバッグ、根本原因の解決といった高度な技術対応を担います。専門性に応じて層を分けると、限られた人員をそれぞれの役割に合わせて配置できます。
現場で語られる「80/20ルール」も理解しておくと役立ちます。問題の約80%は特権アクセスを必要としないL1で処理でき、残りの80%をL2が解決し、最終的に20%以下の難しい問題だけをL3の専門家が扱うという考え方です。この分担が機能すれば、貴重なエンジニアの工数を本当に必要な場面に集中させられます。
内製と外部委託(MSP)の選択肢
監視対応の体制は、自社で運用する「内製」と、MSP(マネージドサービスプロバイダー)などへ委託する「外部委託」に大きく分かれます。外部委託の最大のメリットは、夜間・休日の対応による担当者の疲弊を防ぎ、24時間365日の安定稼働を確保しながら、社内のITリソースをDXや企画といった「攻めのIT」へ振り向けられる点です。
経済産業省はIT人材が2030年に最大約79万人不足すると試算しており、運用保守に人を割き続けることには限界があります。一方で、外部に丸投げすると、運用がブラックボックス化したり、社内ノウハウを失ったり、ベンダーロックインに陥ったりする恐れがあります。
そのため、一次対応だけを委託するのか、二次対応まで任せるのかといった「対応レベル」を見極め、部分的に委託する判断が欠かせません。役割設計やインシデント対応フローの具体的な作り方は、進め方の記事で詳しく解説しています。
▶ 詳細はこちら:ITシステム監視対応の進め方|L1/L2/L3の役割設計とインシデント対応フローをご覧ください。
ITシステム監視対応の進め方とインシデント対応フロー
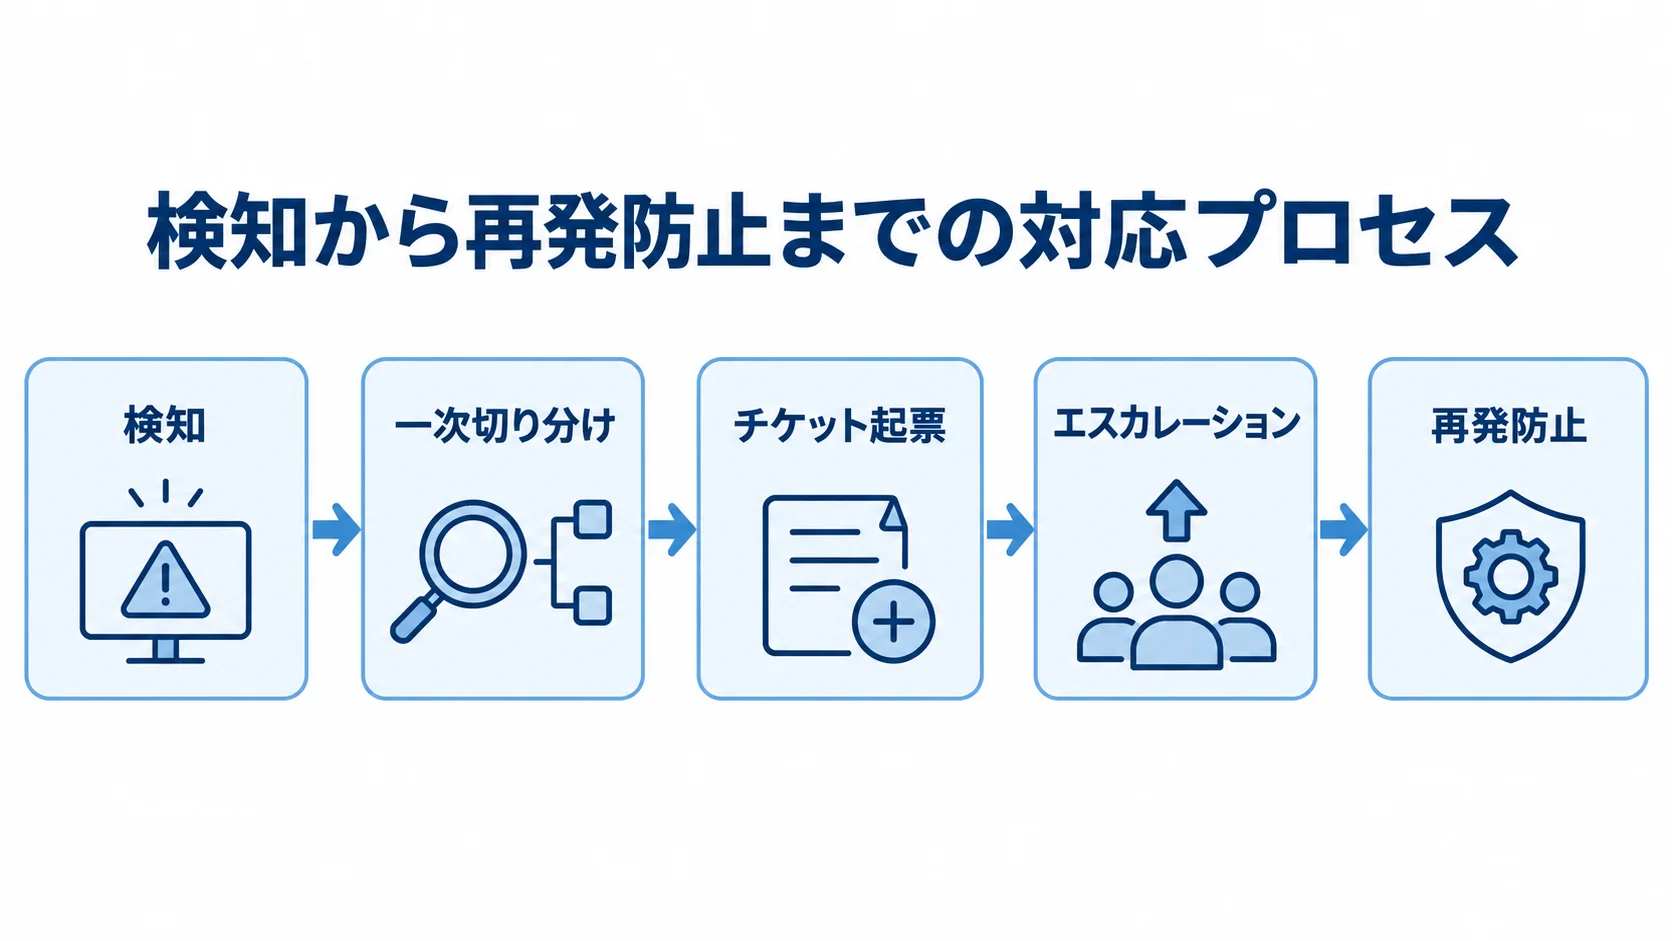
監視対応を機能させるには、アラートが上がってから復旧するまでの流れを「インシデント対応フロー」として、あらかじめ定めておく必要があります。
たとえば、トリアージや一次切り分け、エスカレーションを含め、検知から再発防止までの一連の流れを標準化しておくと、誰が対応しても一定の品質を保てます。
このフロー設計の要は、エスカレーションルールと責任分界点を文書に明記することです。重要度ごとに、どの層へ何分以内に引き継ぐかを決めておかないと、対応が滞ったり、責任の押し付け合いが起きたりします。
エスカレーションルールとRACIによる責任分界
エスカレーションルールとは、L1で解決できない問題をL2やL3へ引き継ぐ基準とタイミングを定めたものです。たとえば「一次対応で30分以内に復旧の見込みが立たない場合は二次対応へ」といった具体的な条件を設けることで、対応の停滞を防げます。
あわせて、実行責任、説明責任、相談先・報告先を整理したRACIマトリクスを用意しておくと、意思決定権が明確になり、混乱を避けられます。特にマルチベンダー環境では、責任分界を事前に取り決めておくことが欠かせません。
クラウド基盤やSaaS、MSPが複数絡む障害では、「基盤の問題か、設定ミスか、不具合か」の切り分けで責任の押し付け合いが起きがちです。そのため、RACIとSLAのグレーゾーンを事前に取り決めておくことが、迅速な復旧につながります。
MTTRを短縮する対応プロセスの設計
監視対応の質を測る代表的な指標がMTTR(平均修復時間)です。障害発生から復旧までの平均時間を短くすることが、ビジネスへの影響を抑える直接的な目標になります。
MTTRを縮めるには、検知から一次切り分け、チケット起票、エスカレーションまでの工程を自動化し、無駄な待ち時間をなくすことが鍵です。たとえば、ネットワーク監視ツールの導入と異常検知・原因切り分けの自動化により、トラブル対応工数を最大約8割削減した中小企業の事例もあります。
再発防止フローを徹底し、二次運用チームが恒久的な改善を積み重ねることで、アラート正常対応率99.99%を達成した事例も報告されています。具体的な手順は、進め方の記事で詳しく解説しています。
監視対応を委託する会社の選び方
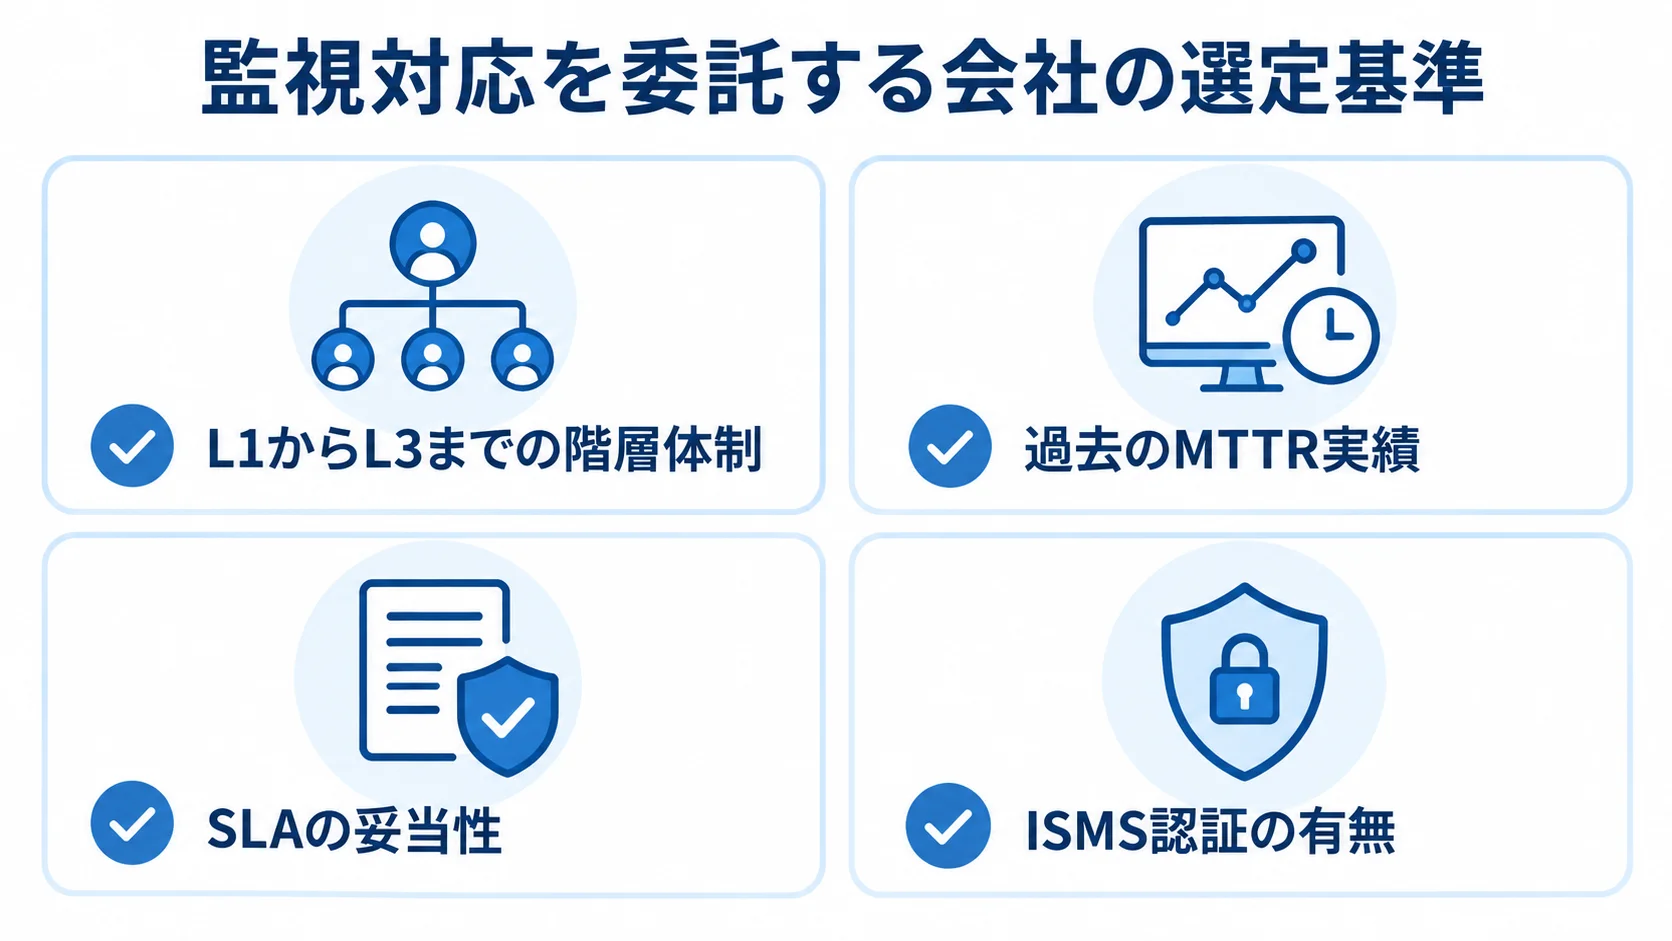
監視対応を外部に委託する場合、どの会社を選ぶかで運用の質は大きく変わります。個別の会社名ではなく、選定の基準に絞って押さえどころを示します。
評価では、階層体制とMTTRなどの実績を確認すると、会社同士を比べられます。夜間・休日を含む対応時間がニーズに合うか、SLAが妥当かも確かめたいところです。
階層体制とMTTR実績の確認ポイント
まず確かめたいのは、委託先がL1からL3までの階層体制を組めるかどうかです。一次対応だけを担う会社か、根本解決まで一貫して対応できる会社かによって、任せられる範囲が変わります。
あわせて、過去のMTTR実績やアラートの自動処理率といった定量データを開示してもらうと、対応力を客観的に見極められます。
業界では、アラート全体の約80%を社内システムで自動処理し、人間の対応を残り20%に絞っているサービスや、アラートの80%をフィルタリングして本当に重要な通知だけを扱う仕組みを持つ会社が高く評価されています。こうした自動化率の高さは、夜間対応の負荷軽減と見落とし防止に直結する指標といえます。
SLAの妥当性とセキュリティ体制の評価
SLA(サービス品質保証)は、応答時間や稼働率を数値で約束するものです。「インシデント応答30分以内」「稼働率99.9%以上」といった水準が自社の要求に見合うかを確かめます。過度に高いSLAは料金を押し上げるため、自社に本当に必要な水準かを見極めることも大切です。
セキュリティ面では、ISMS(情報セキュリティマネジメントシステム)認証の有無や、情報漏洩を防ぐ運用体制を確認しましょう。監視対応は本番システムへ深くアクセスする業務のため、委託先のセキュリティ水準は妥協できません。具体的な比較軸や各社の特徴は、おすすめ会社の記事で整理しています。
▶ 詳細はこちら:ITシステム監視対応のおすすめ会社|階層体制・MTTR実績で比較をご覧ください。
ITシステム監視対応の費用相場
監視対応の費用は、どこまでの対応を任せるかという「対応レベル」と、24時間365日体制を求めるかどうかで大きく変動します。
一次対応のみか、二次対応まで含むか、復旧まで担うかで料金体系が異なるため、必要な範囲を先に決めておくことが見積もりの第一歩になります。
対応レベル別・体制別の料金目安
料金は大きく「月額固定型」と「従量型」に分かれます。月額固定型は対応範囲があらかじめ決まっているため予算を立てやすい一方、従量型はアラート件数や対応工数に応じて変動します。
一次対応のみであれば比較的安価ですが、二次対応や復旧対応まで含むほど、また24時間365日の有人監視を求めるほど、料金は上がります。
監視対象のサーバー台数やシステム規模も料金を左右します。たとえば中堅製造業が50台規模のクラウド環境を委託する場合と、数台のオンプレ環境を委託する場合では、必要な体制も費用も大きく異なります。規模感に応じた具体的な目安は、費用相場の記事で整理しています。
内製の隠れコストと委託コストの比較
費用を検討する際は、委託料金だけでなく、内製時の「隠れコスト」も天秤にかける必要があります。たとえば自社で24時間365日対応すると、次のようなコストが積み上がります。
- 夜勤やオンコールを担う人員の人件費
- 採用・教育コスト
- 担当者の疲弊による離職リスク
これらを洗い出して比べると、委託のほうが結果的に割安になるケースは少なくありません。また、監視ツールの自動化により対応工数を約8割削減できれば、その分の人件費削減効果も投資判断の材料になります。
稟議で経営層を説得するには、こうしたROI(投資対効果)を具体的な数値で示すことが有効です。算出の考え方は、費用相場の記事で解説しています。
▶ 詳細はこちら:ITシステム監視対応の費用相場|対応レベル別の料金と24/365コストをご覧ください。
監視対応の発注・外注方法
監視対応の発注では、SLAやKPIをどう設定するか、契約形態をどう選ぶか、そしてマルチベンダー環境での責任をどう取り決めるかが成否を分けます。
曖昧な要件のまま発注すると、後から追加費用が発生したり、障害時に責任の所在が定まらなかったりします。
SLA・KPIの設定と契約形態の選び方
発注時には、応答時間や稼働率といったKPIを契約に明記し、SLAとして合意しておくことが基本です。たとえば「重大障害は30分以内に一次対応」「稼働率99.9%以上」といった客観的な指標を定めると、定期レポートやレビュー会でPDCAを回せます。これにより、対応品質を継続して管理できます。
契約形態は、準委任契約と請負契約の違いを理解して選ぶことが大切です。監視対応のように継続的な役務提供が中心の業務には準委任が向き、成果物が明確な構築作業には請負が適します。
発注側は、どの業務にどの契約を結ぶかを整理しておくと、後のトラブルを避けられます。
マルチベンダー環境での責任調停の取り決め
クラウド基盤やSaaS、MSPなど複数の事業者が関わる環境では、障害発生時に「どこの責任か」を巡って対応が遅れがちです。そのため、発注の段階で障害切り分けの手順や調停の進め方、SLAのグレーゾーンの扱いを取り決めておくことが、迅速な復旧の前提になります。
あわせて、一度委託した運用を将来的に自社へ引き戻す「内製化巻き戻し」を見据え、ナレッジの逆移管や並走期間を契約に織り込んでおくと、ベンダーロックインを避けられます。発注書やRFPの作り方を含めた具体的な進め方は、発注・外注方法の記事で詳しく解説しています。
▶ 詳細はこちら:ITシステム監視対応の発注・外注方法|SLA設定とマルチベンダー調停をご覧ください。
監視対応で失敗しないためのポイント
監視対応の現場では、アラートの設計ミスやAI活用の落とし穴によって、かえって障害対応の質が下がることがあります。仕組みを導入すること自体が目的化しないよう、よくある失敗パターンを理解し、対策を講じておくことが大切です。
アラート疲労を避ける閾値チューニング
監視対象を増やしすぎたり、しきい値が不適切だったりすると、重要でないアラートが大量に発生し、「アラート疲労」に陥ります。これが続くと現場が通知を軽視するようになり、重大障害を見落とす「オオカミ少年化」を招きます。
重要度レベルを定義し、影響範囲に応じて優先順位を付けることが、見落とし防止の基本です。たとえば、デフォルト設定の「CPU使用率80%で通知」をそのまま使わず、「一瞬のスパイクは無視し、5分間継続したら通知する」というように、継続時間を条件に加える工夫が有効です。
閾値チューニングを行えば、本当に対応が必要なアラートだけを上げる運用が実現できます。
AIOps活用の光と影・誤検知時の責任所在
近年はAIOps(機械学習による異常検知・予測)や生成AIによる原因分析が普及し、アラートの自動処理率を高める効果が期待できます。一方で、AIにはハルシネーション(誤検知・過剰検知)のリスクがあり、運用ルールを学習させるためのデータ整備にも地道な手間がかかります。
自動化を過信しないバランス感覚が求められます。特に問われるのが、自動化システムが未知の障害を正常と誤認し、重大障害を見落とした場合の責任の所在です。ツールベンダー、MSP、自社のどこが責任を負うのかは、契約段階で明確にしておく必要があります。
AIに任せきりにせず、人による最終確認の仕組みを残すことが、失敗を防ぐ現実的な対策となります。
まとめ
ITシステム監視対応は、L1/L2/L3の階層体制とインシデント対応フローを含めた「対応プロセス」の設計が成否を分けます。
エスカレーションルールとRACIで責任分界を明確にし、MTTRやSLAで品質を管理すれば、24時間365日の安定稼働と現場の負荷軽減を両立できます。
アラート疲労の回避やAIOps活用の注意点まで押さえれば、見落としのない堅実な運用が実現します。
進め方から発注方法まで、それぞれの記事に実務に踏み込んだ詳細があります。自社の状況に合わせて、下の関連記事から必要なテーマを深掘りしてください。
監視対応の仕組み化は、ひとり情シスや属人化からの脱却、そしてDX推進へリソースを振り向ける第一歩になります。
- ITシステム監視対応の進め方|L1/L2/L3の役割設計とインシデント対応フロー
- ITシステム監視対応のおすすめ会社|階層体制・MTTR実績で比較
- ITシステム監視対応の費用相場|対応レベル別の料金と24/365コスト
- ITシステム監視対応の発注・外注方法|SLA設定とマルチベンダー調停
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。