
ITシステムの監視対応は、異常に気づく検知系、異常を収束させる対応系、それらを補う高度化の機能で成り立っています。本記事は、発注企業の視点から、必要機能と標準機能に絞って一覧で解説します。
監視対応の全体像は、ITシステム監視対応の完全ガイドで先に確かめられます。ここでは、3つの役割が受け持つ機能を示します。
- 検知系:死活・性能・ログ監視で、異常を捉える役割です。
- 対応系:一次対応、原因調査、復旧を進め、異常を収束させます。
- 高度化:AIOpsと運用自動化で、検知と対応を補います。
▼全体ガイドの記事
・ITシステム監視対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
検知系の標準機能(死活・性能・サーバー監視)
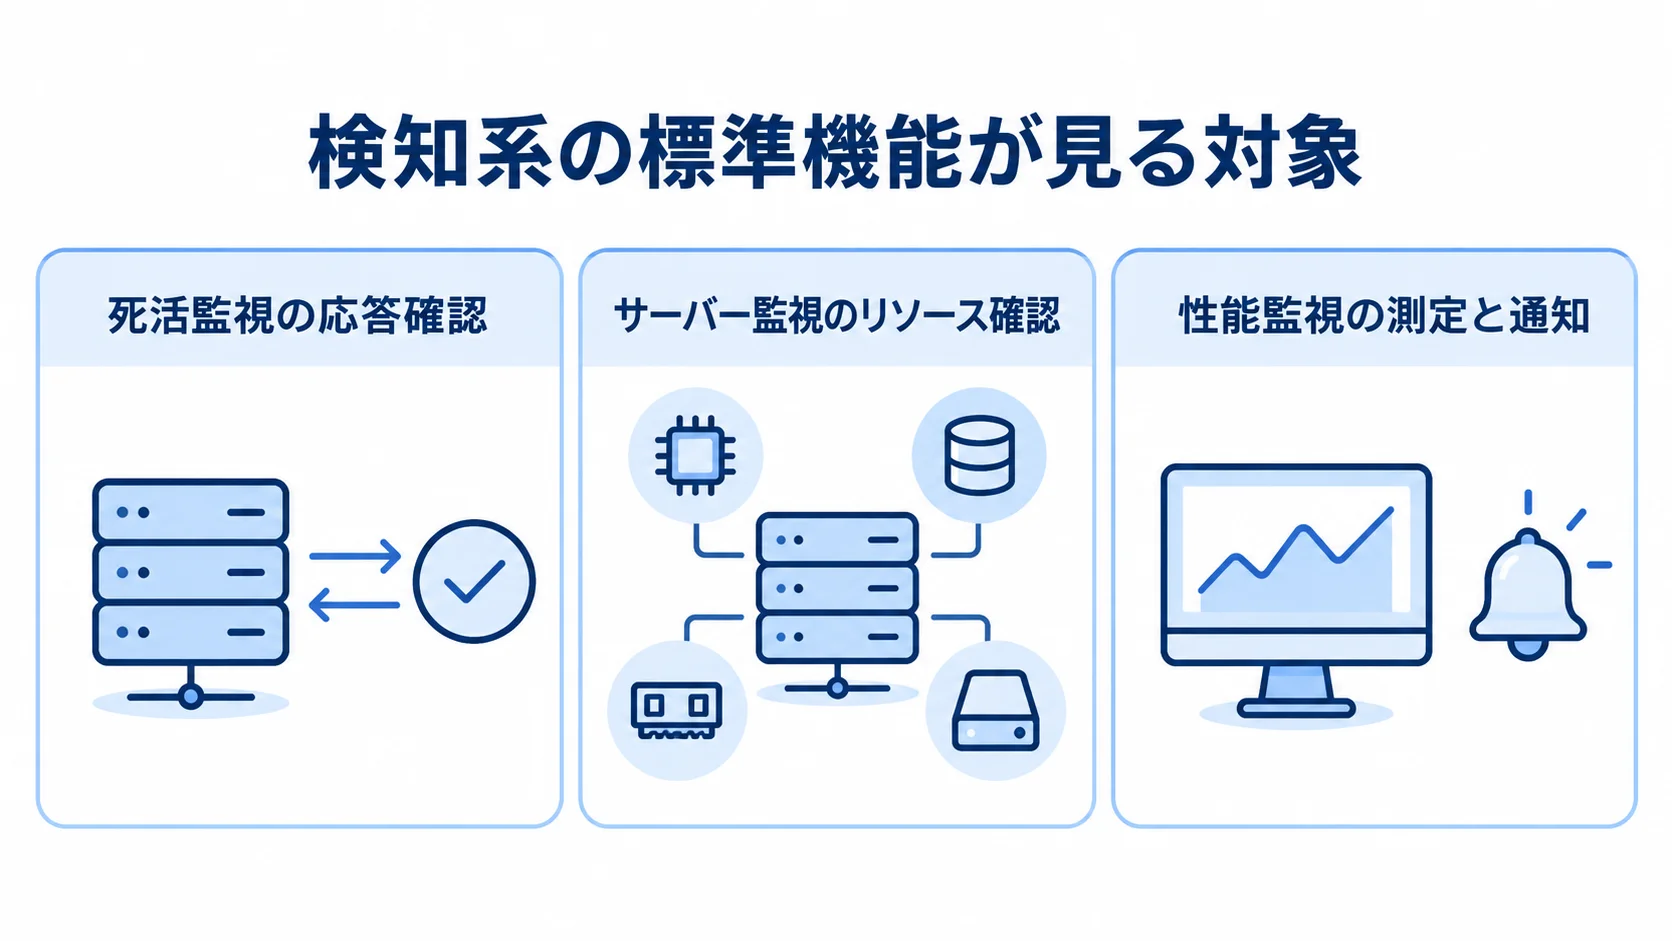
監視対応の前提になるのが、異常を「検知する」機能群です。システムの状態を常時観測し、異常があれば知らせるのが役割で、直す作業は対応系が受け持ちます。
検知が欠けると、対応はすべて後手に回ります。死活監視、性能監視、サーバー監視は見る対象がそれぞれ異なるため、組み合わせて初めて、システム全体の健康状態を把握できます。そこで、まずこの検知系の標準機能を押さえることが、監視設計の出発点になります。
死活監視とサーバー監視がカバーする範囲
死活監視はサービスが応答するかを確かめ、サーバー監視は稼働中のリソースの状態まで観測します。
- 応答確認:ping、ポート接続、HTTP応答コードを定期的に確かめ、応答がなければ通知します。
- リソース確認:CPU、メモリ、ディスク、ネットワークの状態を継続して見守ります。
- 料金の目安:一次データでは、サーバー監視が1台あたり月5,000円の例として挙がっています。
- 対象範囲:Webサーバーのほか、DB、ロードバランサー、外部API、クラウド資源も含めて洗い出します。監視漏れは障害の長期化を招きます。
性能監視で逼迫を捉える機能
性能監視は、リソースが枯渇する前の兆しを捉えます。死活監視では分からない停止前の変化も、ここで知らせてくれます。
- 測定と通知:CPU使用率、メモリ、ディスク残量、応答時間を測り、閾値を超えたときに通知します。
- 傾向分析:推移をグラフにして、消費量の増加から増設や設定の見直しを判断します。ディスク満杯やメモリ不足による停止を、事前に防げる可能性があります。
- Zabbix:ライセンスは無料ですが、構築と維持に工数がかかります。
- クラウド型ツール:DatadogやNew Relicは、ホスト数とメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です。
実装方法は、機能の有無に加えて、閾値の設計や運用工数、課金方式まで含めて検討します。
ログ監視とアラート対応の機能
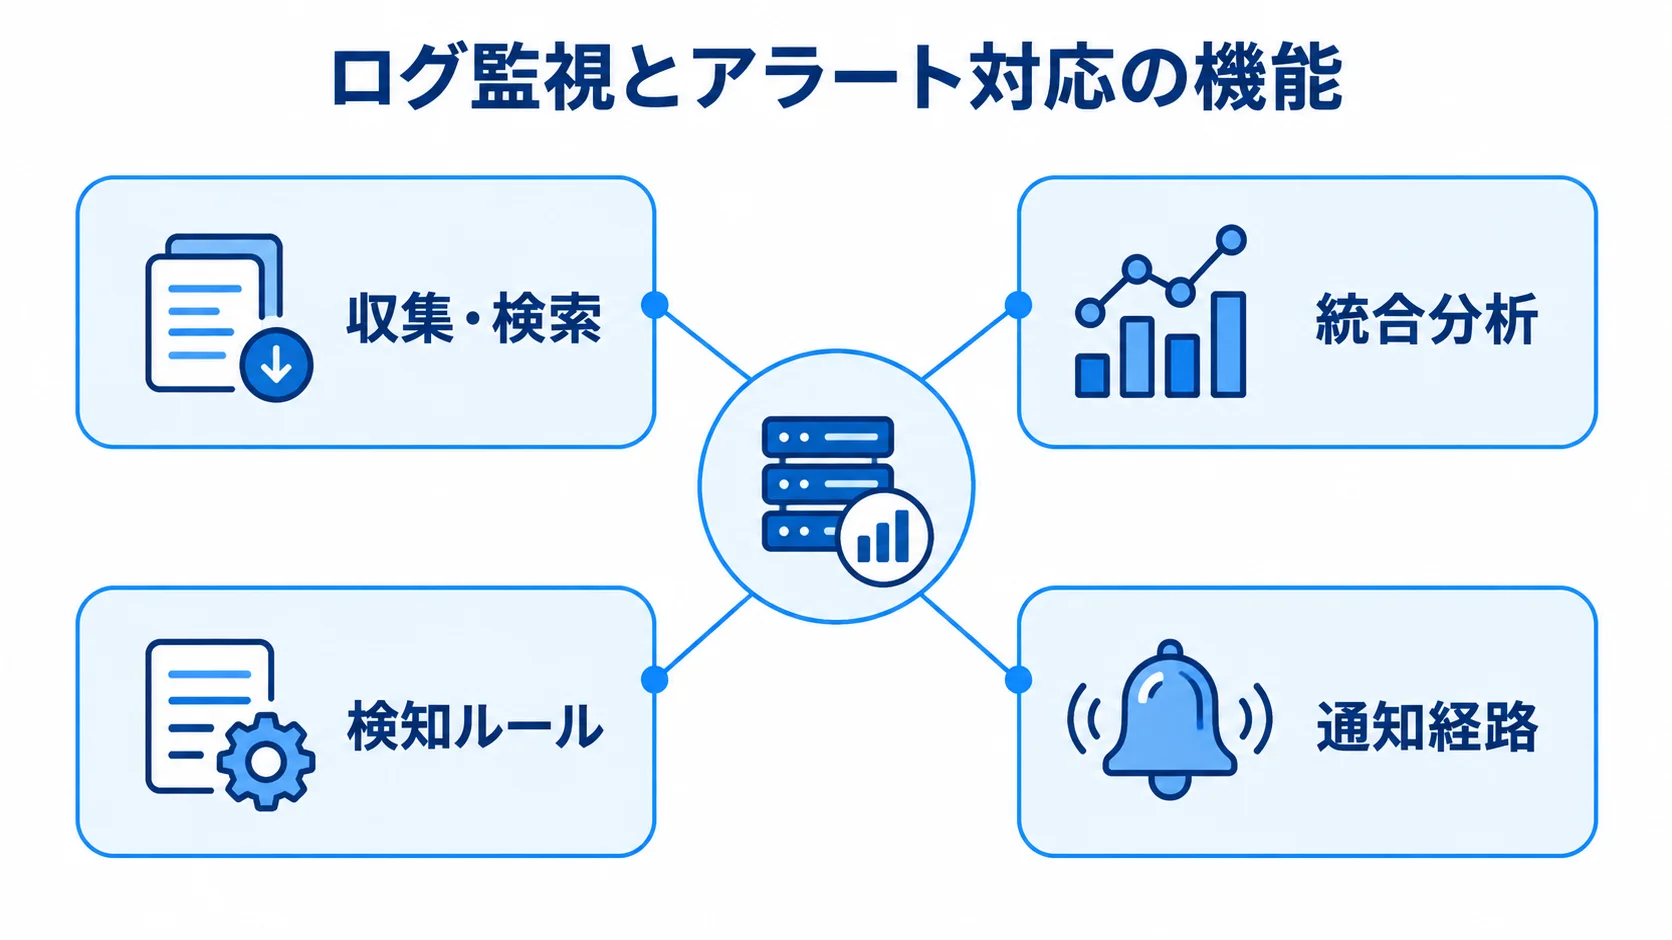
検知系にはもう一つ、ログ監視があります。サーバーやアプリケーションが出力するログには、エラーや異常の前兆が記録されています。その記録を見張り、特定のエラーパターンや異常な頻度を検知する働きを担います。
また、検知された異常を適切な相手へ確実に届けるのが、アラート対応の機能です。ログ監視とアラート対応がかみ合って初めて、「異常に気づき、人が動き出す」までの流れが成り立ちます。
ログ収集・集約と異常検知の機能
ログ監視では、分散したログを一か所に集めて横断検索できるようにし、どんなログを異常とみなすかも適切に定めます。
- 収集・検索:複数のサーバーやコンテナのログを一か所にまとめ、障害時にエラーや急増を探しやすくします。
- 統合分析:セキュリティでは、Splunk CloudなどのSIEMが複数のログを合わせて見たうえで、脅威を検知します。
- 検知ルール:過去の障害パターンをもとに、対応が必要なログを選びます。広すぎると通知が埋もれ、絞りすぎると重要な異常を見逃します。
アラート通知とノイズ抑制の機能
アラート通知は、誰にどう届けるかを決めておき、異常の重大度に応じて通知の相手と連絡手段を変えることで、対応開始までの時間を短縮する機能です。
- 通知経路:メール、チャット、電話を使い分けます。たとえば、深夜の重大障害は電話、軽微な通知はチャットに回す例があります。
- 重複の集約:同じ障害から届く大量の通知を、一定時間内にまとめます。
- 関連付けと抑制:関連するアラートを束ね、一時的な揺らぎによる通知を抑えます。通知が多すぎて起きるアラート疲れも防ぎます。
必要な通知を届ける設定と、鳴らしすぎない設定の両方がそろって、運用が回ります。
対応系の機能(一次対応・原因調査・復旧)
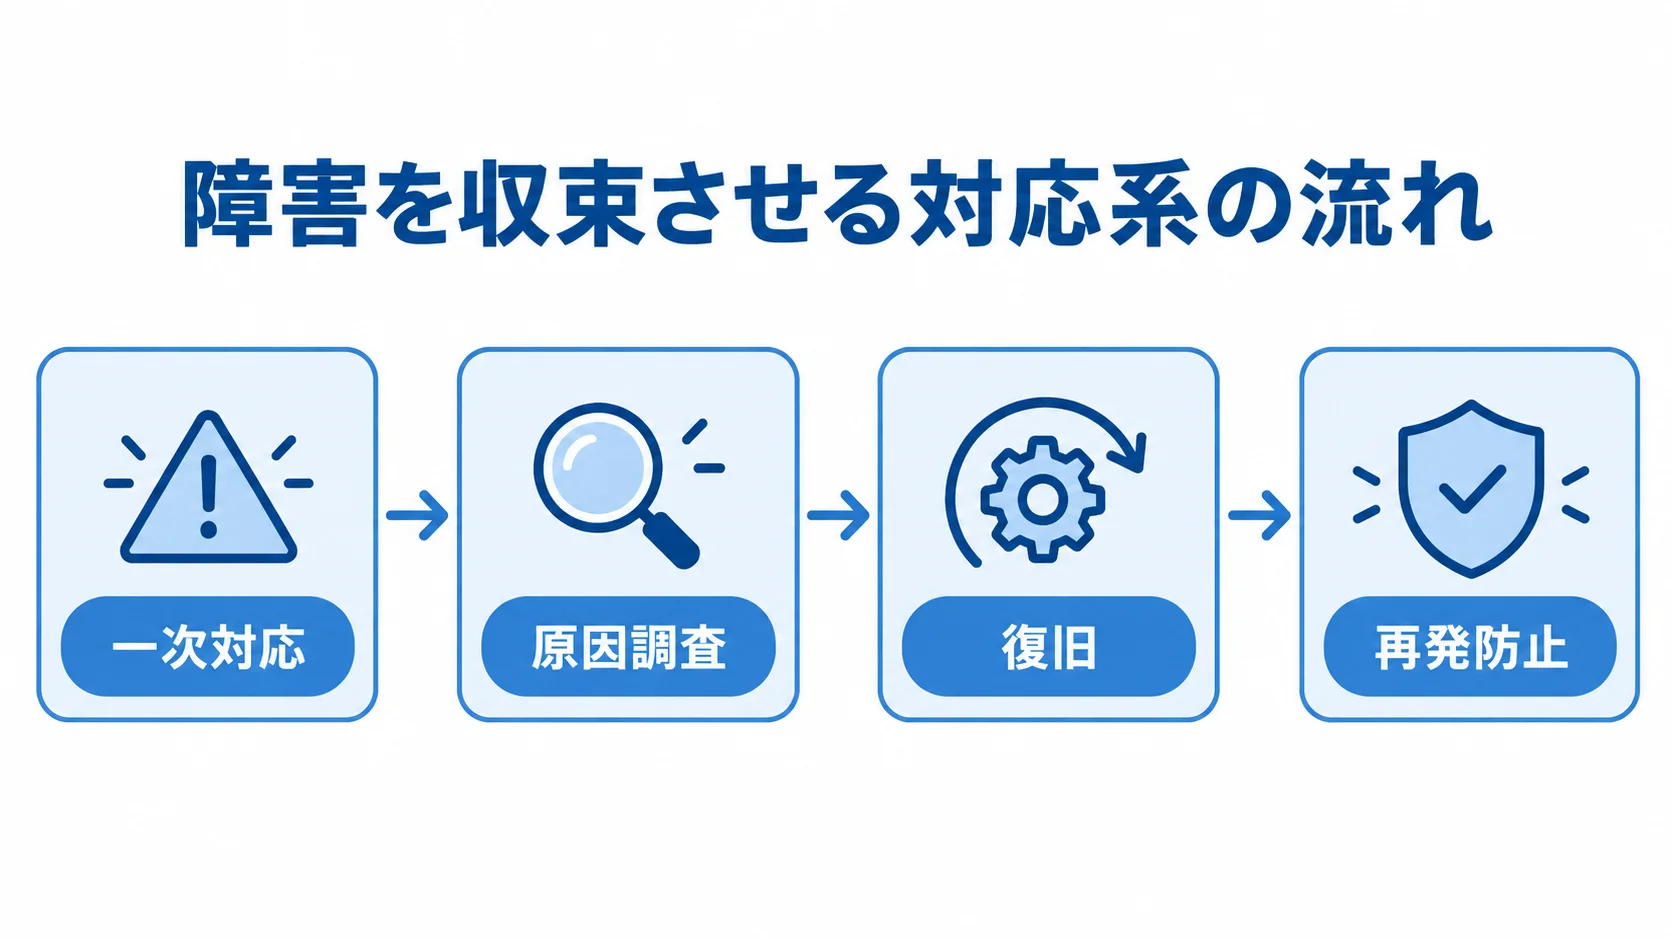
検知系が「気づく」機能なのに対し、対応系は「収束させる」機能です。アラートを受けてからの一次対応、根本原因を突き止める原因調査、サービスを元に戻す復旧という一連の流れが、監視対応の締めくくりを担います。
検知だけ整っていても、対応の機能が伴わなければ障害は収まりません。対応系の各機能が基本料金にどこまで含まれ、どこから追加費用になるのかを理解すると、見積もりの妥当性の判断に直結します。
一次対応と原因調査の機能
対応は、一次対応から原因調査へと順に進みます。
- 一次対応:再起動や切り離し、定型手順で復旧を試し、被害の拡大を防ぎます。
- 原因調査:一次対応のあと、ログの精査、再現試験、変更履歴から根本原因を特定します。
一次対応の費用例は、営業時間内で月3万〜8万円、24時間緊急対応で月10万〜20万円、スポット1件で3万〜10万円です。一方で、原因調査を担う人材は専門性が高く、運用設計・インシデント分析の人月単価は一次データで80万〜120万円です。
一次対応が委託料金に含まれていても、深い原因調査は別費用になる場合があります。そのため、契約前に対応範囲を確認しておくことが欠かせません。
復旧と再発防止の機能
復旧のあとは、障害の記録を残し、次の運用へつなげる段階に入ります。
- 復旧:原因に応じて、バックアップの復元やパッチ適用、設定の修正を行います。
- 再発防止:原因と対策を記録し、恒久対策を監視の閾値や手順に組み込みます。
目標例として、重大障害では2時間以内の対応開始と、24時間以内の完全解決が挙げられています。また、官公庁仕様の例では、1時間以内の現地到着と対処開始、1時間以内の予想作業時間の報告、原則4時間以内の完全復旧を示しています。
riplaはフルスクラッチ受託と国内運用保守の立場から、復旧後の再発防止まで含めた運用を重視しています。こうした流れをつなぐことで、障害を収束へ導きます。
AIOpsと運用自動化の機能
近年、監視対応の機能に新しく加わってきたのが、AIOps(AIを活用したIT運用)と運用自動化です。
AIOpsでは、膨大なアラートやログをAIが分析し、異常の予兆を検知したり、ノイズを自動で絞り込んだりします。人の手では追いきれない量の監視データを、機械の力で扱いやすくする発想です。
ただし、これは大企業向けの先進事例が中心で、中小企業がどう取り入れるかは、別に考える必要があります。
AIOpsによる自動検知と相関分析の機能
AIOpsは、通常時のデータを基準に異常を捉えます。加えて、複数の通知をひとまとめにするため、ノイズと原因調査時間の削減につながります。
- 予兆検知:通常時のパターンから外れた挙動を見つけ、固定の閾値では捉えにくい複合的な異常も拾います。
- 相関分析:同時に起きたアラートを関連付け、共通の原因と考えられる通知を示します。
- 導入の前提:学習に足るデータ量と調整が必要です。JUAS調査では、IT運用へのAI活用の約78%が検討中か未検討で、本格活用はこれからの段階です。
- 段階導入:まず既存の監視でデータをためてから、AIOpsを取り入れます。AIOpsは、検知と対応の機能を残したまま、それらを補強する役割を担います。
定型対応の自動化(自動復旧)機能
定型対応の自動化は、手順が決まった処理を機械に任せ、夜間対応の負荷や復旧時間を抑えます。
- 対象を決める:特定のアラートが出たときのサービス再起動や、ディスク逼迫時の不要ファイル削除など、手順が明確な対応を選びます。
- 影響の小さい処理から試す:誤実行は二次障害につながるため、人の判断が要る処理と分けて小さく始めます。自動化でMTTRの短縮と人的負荷の軽減を狙います。
- 実績を見て広げる:検知と対応の標準機能、文書化された手順を基にし、安全性を確かめながら対象を増やします。
運用自動化は、ここまでの機能がそろった後に加える仕上げの役割です。
まとめ
ITシステム監視対応の機能は、異常を「検知する」検知系(死活・サーバー・性能・ログ監視)と、異常を「収束させる」対応系(アラート対応・一次対応・原因調査・復旧・再発防止)に分かれます。さらに、それらを補強するAIOpsと運用自動化が加わる形で整理できます。
死活監視は1台月5,000円から、24時間緊急対応は月10万〜20万円といった料金の水準があります。その水準を踏まえ、自社にどの機能が必要かを過不足なく見極めることが、適正なコストの監視体制づくりにつながります。
機能を検討するときは、「全部入り」を目指すより、自社のシステムの重要度と障害許容度に応じて必要な機能を選ぶことが基本です。まずは検知系の標準機能で「気づける」状態を作り、次に対応系で「収束させられる」体制を整えます。そのうえで、自動化を段階的に取り入れていきます。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、機能単位で要件を整理して、過不足のない監視対応を設計する支援を一貫して行っています。全体像を確かめるには、あらためて完全ガイドが役立ちます。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。